कोर्स
Claude मॉडलों का परिचय
3 घंटा
14.9K
GPT-6 Astra, OpenAI का फ्रंटियर फ्लैगशिप है जो GPT-5.6 Sol का उत्तराधिकारी है, और यह चैट के बजाय एजेंटिक एक्जीक्यूशन के इर्द-गिर्द बनाया गया है। OpenAI ने इसे कंप्यूटर उपयोग, प्रोफेशनल काम, और सॉफ्टवेयर इंजीनियरिंग के लिए पोजिशन किया है, और यह कंपनी के Preparedness Framework में "Critical" साइबरसिक्योरिटी थ्रेशहोल्ड पार करने वाला पहला OpenAI मॉडल है। यह 1,050,000-टोकन कॉन्टेक्स्ट विंडो पर चलता है, 128K मैक्स आउटपुट के साथ, और 30 अप्रैल, 2026 का नॉलेज कटऑफ है।
घोषणा में दो बातें सबसे अलग दिखती हैं। Codex में, Astra कॉन्टेक्स्ट विंडो के बीच नोट्स को समरी में समेटने के बजाय सुरक्षित रखता है, जिससे पहले की विंडोज़ खोजने योग्य रहती हैं, और यह हमेशा अनुमान लगाने या हमेशा पूछने के बजाय यह तय करता है कि कब स्पष्टीकरण वाला सवाल करना है।
पूरी फीचर सूची, बेंचमार्क तालिकाएँ, और एक्सेस विवरण के लिए हमारा GPT-6 Astra गाइड देखें। इसे इसके पूर्ववर्ती के कवरेज GPT-5.6 Sol, Terra, और Luna के साथ पढ़ना भी उपयोगी है।
Claude Fable 5.1, Anthropic का सामान्य उपलब्ध फ्रंटियर मॉडल है जो मांग वाले तर्क-वितर्क और लंबी-अवधि वाले एजेंटिक कार्य के लिए है। इसमें 1M टोकन कॉन्टेक्स्ट विंडो, 128K मैक्स आउटपुट, हमेशा-ऑन एडैप्टिव थिंकिंग, और जून 2026 का नॉलेज कटऑफ है। Anthropic के डॉक्युमेंट्स इसकी लेटेंसी को Claude Opus 5 और Claude Sonnet 5 से धीमा रेट करते हैं, जो दोनों कीमत में इससे नीचे हैं।
Claude Mythos 5.1 वही मॉडल है जिसमें अलग सेफगार्ड हैं, जो Project Glasswing के जरिए निमंत्रण पर उपलब्ध है। बाकी सभी के लिए सुर्खी वाला बदलाव कैश रीड प्राइस है, जिसे 75% घटाकर $0.25 प्रति मिलियन टोकन कर दिया गया, जबकि सूची दरें जस की तस रहीं।
हमारे Claude Fable 5.1 गाइड में पूरा बेंचमार्क ब्रेकडाउन है, और हमारा Claude Fable 5.1 API ट्यूटोरियल इससे एक रिपॉजिटरी-अवेयर डेवलपर एजेंट बनाता है, जिसमें विभिन्न प्रयास स्तरों पर वास्तविक लागत ब्रेकडाउन भी शामिल है।
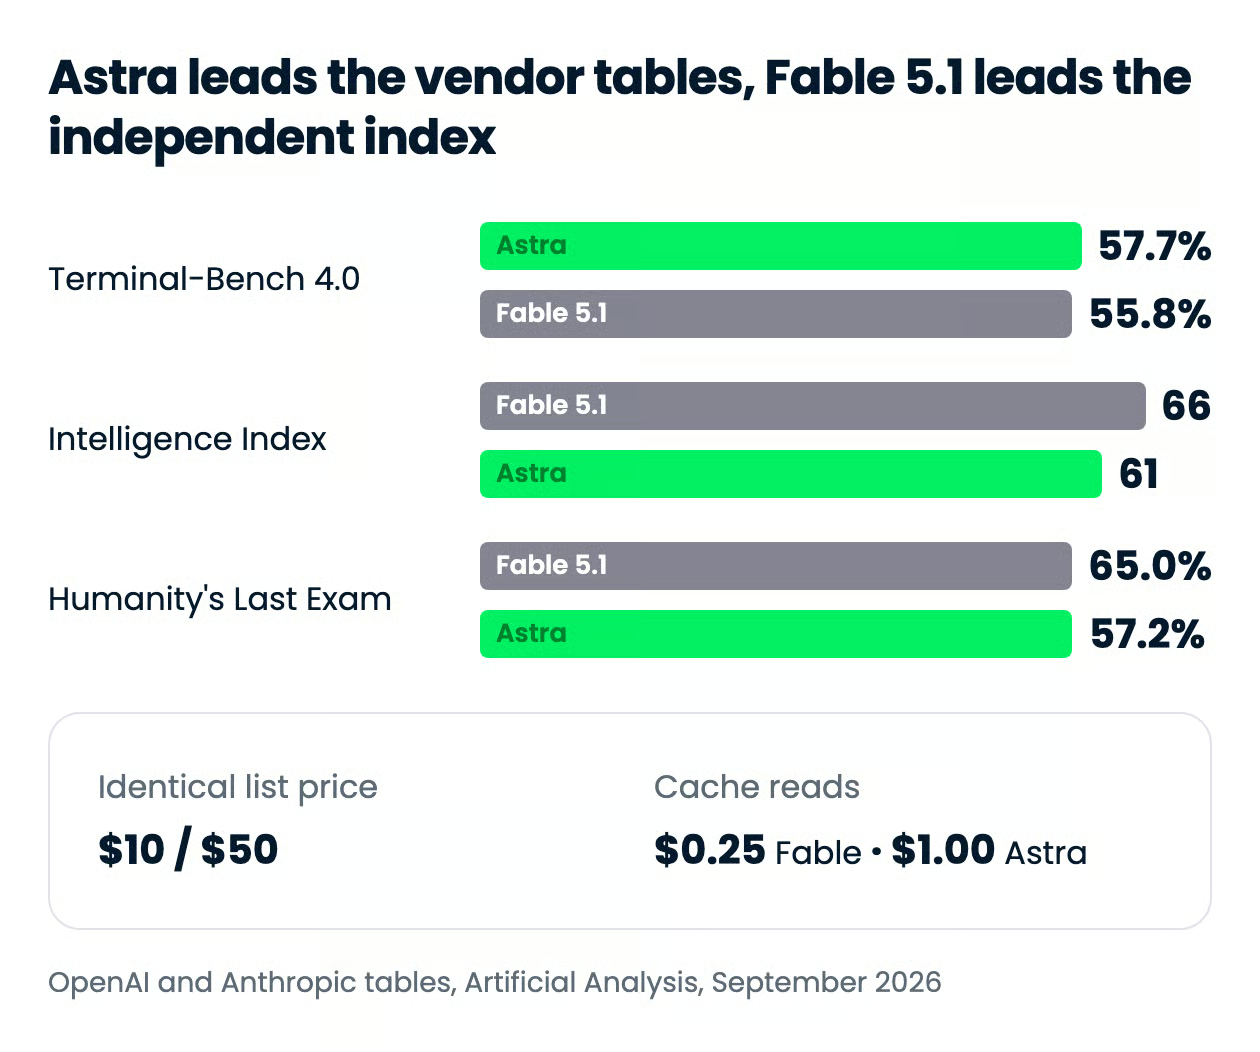
संक्षेप संस्करण: OpenAI की तुलना तालिका में Astra लगभग हर प्रकाशित पंक्ति पर Fable 5.1 से आगे दिखता है, और Artificial Analysis अपनी दोनों सूचकों पर उलटा दिखाता है। आप किस पर भरोसा करते हैं, यह इस पर निर्भर करता है कि किसी वेंडर द्वारा अपने प्रतिद्वंद्वी की रेटिंग को आप कितना वज़न देते हैं।
| विशेषता | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| रिलीज़ तिथि | 3 सितंबर, 2026 | 1 सितंबर, 2026 |
| API मॉडल ID | gpt-6-astra |
claude-fable-5-1 |
| कॉन्टेक्स्ट विंडो | 1.05M टोकन | 1M टोकन |
| मैक्स आउटपुट | 128K टोकन | 128K टोकन |
| नॉलेज कटऑफ | 30 अप्रैल, 2026 | जून 2026 |
| प्रति 1M टोकन सूची मूल्य | $10 इन / $50 आउट | $10 इन / $50 आउट |
| प्रति 1M कैश्ड इनपुट रीड | $1.00 (272K से ऊपर $2.00) | $0.25 |
| 272K इनपुट टोकन से ऊपर की दरें | इनपुट और कैश 2x, आउटपुट 1.5x | कोई सरचार्ज नहीं |
| FrontierMath Tier 4 (v2) | 97.6% | 87.8% |
| Humanity's Last Exam, टूल्स के साथ | 57.2% | 65.0% |
| ScreenSpot-Pro (नो टूल्स) | 92.7% | 87.3% (Fable 5, Mythos से) |
| AutomationBench | 41.4% | 31.4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (मैक्स प्रयास) | 61 | 66 |
| AA प्रति Intelligence Index टास्क लागत (मैक्स) | $1.67 | $3.76 |
| सबसे मजबूत क्षेत्र | कंप्यूटर उपयोग, गणित, साइबरसिक्योरिटी, प्रति-टास्क लागत | तर्क की गहराई, कैश-प्रधान एजेंट लूप्स |
OpenAI द्वारा प्रकाशित कोडिंग बेंचमार्क्स पर Astra आगे है, लेकिन मार्जिन पतले हैं और स्वतंत्र इंडेक्स असहमत है। Terminal-Bench 4.0 पर, जो टर्मिनल में सॉफ्टवेयर इंजीनियरिंग, सिस्टम कॉन्फ़िगरेशन, और डेटा विश्लेषण की परख करता है, OpenAI Astra के लिए 57.7% और Fable 5.1 के लिए 55.8% रिपोर्ट करता है। Anthropic भी वही 55.8% आंकड़ा प्रकाशित करता है, इसलिए कम से कम वह पंक्ति निर्विवाद है।
DeepSWE v1.1 पर अंतर बढ़ता है, जहाँ Astra 74.1% तक पहुँचता है और Fable 5.1 67.4% पर रहता है, और FrontierCode 1.1 Main पर लगभग पूरी तरह सिमट जाता है, जहाँ 53.3% बनाम 50.9% पहले से ही Claude Fable 5 (53.5%) और Claude Opus 5 (53.4%) की रेंज के भीतर बैठता है।
| बेंचमार्क | GPT-6 Astra | Claude Fable 5.1 | टिप्पणी |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.7% | 55.8% | OpenAI की तालिका 57.7% कहती है जबकि उसका अपना चार्ट कैप्शन 57.9% कहता है |
| DeepSWE v1.1 | 74.1% | 67.4% | OpenAI-रिपोर्टेड |
| FrontierCode 1.1 Main | 53.3% | 50.9% | वास्तव में Fable 5 के 53.5% और Opus 5 के 53.4% के साथ टाई |
| आंतरिक डेटाबेस माइग्रेशन | 63.9% | 57.8% | OpenAI का आंतरिक इवैल, कोई बाहरी प्रतिलिपि नहीं |
| CursorBench 3.2.0 | प्रकाशित नहीं | 73.4% | Anthropic-रिपोर्टेड; SpaceXAI ने मैक्स प्रयास पर 73.4% कंफर्म किया |
| AA Coding Agent Index | Codex में 67 | Claude Code में 70 | स्वतंत्र, लेकिन अलग हार्नेस |
आखिरी पंक्ति बार-बार ध्यान खींचती है। Artificial Analysis, Claude Code में Fable 5.1 को अपने Coding Agent Index पर 70 पर रखता है, जो उसका सबसे ऊँचा स्कोर है, और Codex में Astra को 67 पर, लगभग Claude Opus 5 और Claude Fable 5 के बराबर। यहाँ दो नमक डालने लायक चेतावनियाँ हैं:
प्रकाशित कोडिंग पंक्तियों में बाल बराबर के फर्क से Astra आगे रहता है और दक्षता में साफ़ जीतता है, जबकि Fable 5.1 के पास एकमात्र स्वतंत्र कोडिंग-एजेंट स्कोर है जो दोनों से ऊपर है।
पूरी तुलना में यह सबसे साफ़ बँटवारा है, और दोनों दिशाओं में जाता है। Astra गणित और विज्ञान की पंक्तियाँ लेता है: FrontierMath Tier 4 v2 पर 97.6% बनाम 87.8%, GPQA Diamond पर 96.0% बनाम 93.7%, और Terminal-Bench Science 0.1 पर 64.6% बनाम 52.6%, जो एजेंटिक रिसर्च बेंचमार्क है जिस पर Anthropic ने अपना लॉन्च टिका रखा था।
Fable 5.1 Humanity's Last Exam टूल्स के साथ लेता है, 65.0% बनाम 57.2%, और यह पास का मुकाबला नहीं है। Artificial Analysis स्वतंत्र रूप से उसी दिशा का समर्थन करता है, Fable 5.1 को अपने Intelligence Index पर 66 और Astra को 61 देता है—अब तक का उसका सबसे ऊँचा स्कोर।
उस 66 पर एक चेतावनी। Artificial Analysis ने Fable 5.1 को Anthropic के डिफ़ॉल्ट सर्वर-साइड फॉलबैक के साथ चलाया, जो सेफ्टी-फ़्लैग्ड अनुरोधों को Claude Opus 4.8 या Claude Opus 5 पर रूट करता है, और फॉलबैक ने इंडेक्स पर लगभग 4% आउटपुट टोकन सर्व किए। स्कोर वही है जैसा ज़्यादातर लोग हकीकत में Fable 5.1 को कॉल करेंगे, न कि मॉडल का अलग-थलग कच्चा रूप।
यदि आपका काम ग्रेजुएट-स्तर का गणित या विज्ञान है, तो Astra। यदि यह व्यापक, कठिन तर्क-वितर्क है जिसे Humanity's Last Exam परखा है, तो Fable 5.1।
यह आयाम Astra के पास है, मुख्यतः क्योंकि Anthropic ने तुलनीय संख्याएँ प्रकाशित नहीं कीं। OpenAI OSWorld 2.0 के ऑफ़लाइन सेट पर Astra के लिए 72.6% रिपोर्ट करता है, Claude Opus 5 के 70.2% के मुकाबले, और ScreenSpot-Pro पर 92.7% बनाम Claude Fable 5 के 87.3%। Anthropic के अपने Fable 5.1 आँकड़े—77.9% पार्टियल और 41.7% स्ट्रिक्ट—एक अलग टास्क रिलीज़ और ग्रेडिंग सेटअप से आते हैं।
आर्टिफैक्ट संख्या कम दुविधा वाली हैं: BenchCAD पर 95.9% बनाम 84.3%, और AutomationBench पर 41.4% बनाम 31.4%।
ऐसे एजेंट्स के लिए जो वास्तविक सॉफ्टवेयर पर क्लिक करते हैं और स्लाइड्स या CAD आउटपुट बनाते हैं, Astra अधिक मज़बूत विकल्प है।
Astra के एलाइनमेंट नंबर उसके लॉन्च का सबसे कम-चर्चित हिस्सा हैं। OpenAI के आंतरिक कंप्यूटर-यूज सेफ्टी बेंचमार्क पर, जहाँ कम स्कोर बेहतर है, यह 2.4% स्कोर करता है जबकि Fable 5.1 9.5% पर है।
साइबरसिक्योरिटी पर, यह एक अलग ब्रैकेट में है: ExploitBench पर 100%, और Irregular के स्वतंत्र परीक्षण में FrontierCyber की 226 चुनौतियों में से 86 हल, जबकि GPT-5.6 Sol ने 34 हल कीं। Anthropic ने Fable 5.1 को इतना ढीला रखा कि वह कमजोरियाँ खोज सके, पर उन्हें एक्सप्लॉइट न कर सके।
दो चेतावनियाँ, दोनों नमक के काबिल:
Astra एक तरफ़ सुरक्षित एजेंट भी है और दूसरी तरफ़ अधिक सक्षम अटैकर भी, इसी कारण गेटिंग है।
सूची दरें समान हैं, इसलिए रेट कार्ड पर, इन दोनों मॉडलों के बीच एकमात्र फर्क कैशिंग और लंबा कॉन्टेक्स्ट है। यह फ्रेमिंग तभी टिकती है जब दोनों मॉडल एक ही टास्क पर समान संख्या में टोकन खर्च करें—और वे नहीं करते—इसीलिए नीचे दिए गए मापे गए प्रति-टास्क आँकड़े रेट कार्ड से ज़्यादा मायने रखते हैं।
| दर | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| इनपुट, प्रति 1M टोकन | $10.00 | $10.00 |
| आउटपुट, प्रति 1M टोकन | $50.00 | $50.00 |
| कैश्ड इनपुट रीड, प्रति 1M टोकन | $1.00 | $0.25 |
| कैश राइट (5 मिनट), प्रति 1M टोकन | $12.50 | $12.50 |
| बैच डिस्काउंट | 50% | 50% |
| 272K इनपुट टोकन से ऊपर दरें | $20.00 इन / $2.00 कैश्ड / $75.00 आउट | कोई सरचार्ज नहीं |
इनपुट, आउटपुट, कैश राइट्स, और बैच डिस्काउंट—सब कुछ सेंट तक मैच करता है। अपवाद कैश रीड लाइन है, और यह 4x का गैप है: Anthropic ने Fable 5.1 की कैश रीड्स $0.25 पर घटा दी हैं, जबकि OpenAI ने Astra की $1.00 रखी है—इसके इनपुट रेट पर 90% की छूट।
272K इनपुट टोकन से ऊपर, गैप 8x तक बढ़ता है, क्योंकि OpenAI का सरचार्ज इनपुट के साथ कैश रीड्स को भी दोगुना करके $2.00 कर देता है, जबकि Anthropic की प्राइसिंग डॉक पूरी 1M-टोकन कॉन्टेक्स्ट विंडो को स्टैंडर्ड रेट्स पर रखती हैं। ध्यान दें कि यह थ्रेशहोल्ड Astra के विज्ञापित कॉन्टेक्स्ट के सापेक्ष कितना कम है: 272K उसकी 1.05M विंडो का लगभग एक चौथाई है, इसलिए अपनी शिप की हुई कॉन्टेक्स्ट का एक-चौथाई से ज़्यादा उपयोग करने वाला कोई भी अनुरोध हाईयर टियर पर बिल होगा।
कैश रीड्स वह दर हैं जो लंबे लूप में कंपाउंड होती हैं, क्योंकि एक एजेंट हर टर्न पर वही सिस्टम प्रॉम्प्ट, टूल परिभाषाएँ, और रिपॉजिटरी कॉन्टेक्स्ट फिर से भेजता है। अगर यह फर्क आपके लिए नया है, तो हमारे प्रॉम्प्ट कैशिंग गाइड में कैश राइट बनाम कैश रीड की यांत्रिकी समझाई गई है।
इस तालिका की हर चीज एक तय टोकन आकार पर सूची-दर गणित है, कोई मापा गया परिणाम नहीं। यह सवाल का जवाब देती है: "यदि दोनों मॉडल एक समान टोकन खर्च करें, तो रेट कार्ड क्या चार्ज करेगा?" अगला खंड बताता है कि वे हकीकत में क्या खर्च करते हैं।
| वर्कलोड | GPT-6 Astra | Claude Fable 5.1 | फर्क |
|---|---|---|---|
| बैलेंस्ड असिस्टेंट: 1M इन / 250K आउट | $22.50 | $22.50 | $0, 0% |
| रीट्रिवल, थ्रेशहोल्ड से कम: 10M इन / 1M आउट | $150 | $150 | $0, 0% |
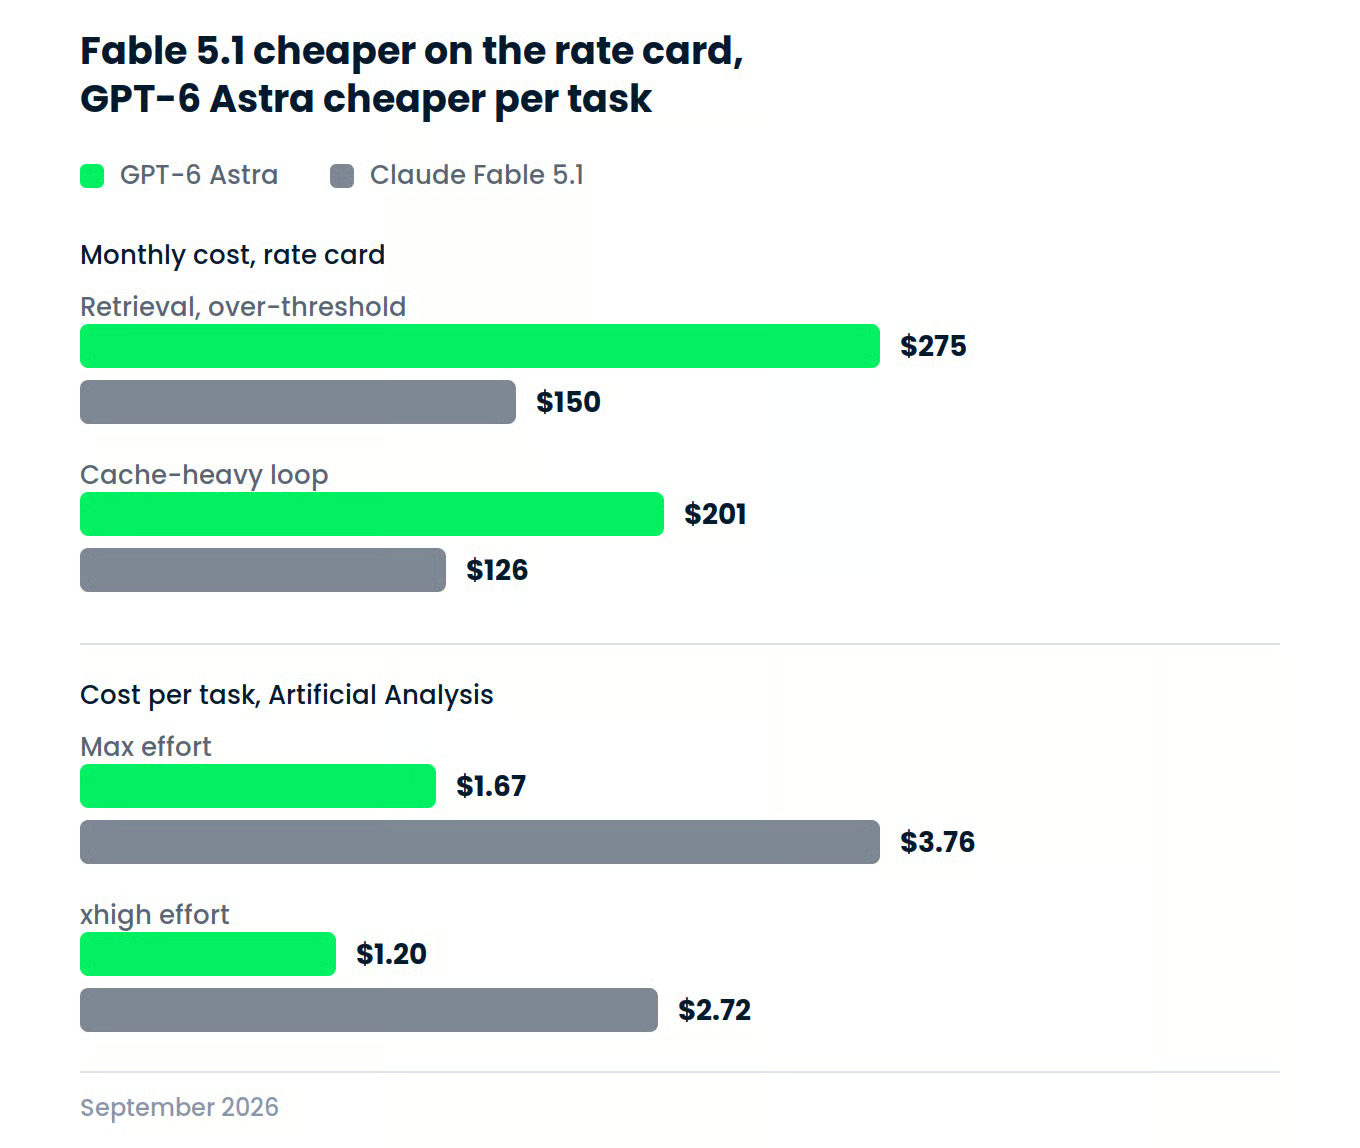
| रीट्रिवल, थ्रेशहोल्ड से ऊपर: 10M इन / 1M आउट | $275 | $150 | $125, Astra के लिए 83% अधिक |
| कैश-प्रधान लूप: 100K प्रीफ़िक्स, 1,000 रीड्स | $201 | $126 | $75, Astra के लिए 59% अधिक |
हर पंक्ति का फ़ॉर्मूला एक जैसा है: (वॉल्यूम ÷ 1M) × दर, जिसे फ्रेश इनपुट, कैश रीड्स, कैश राइट्स, और आउटपुट पर जोड़ दिया जाता है। कैश-प्रधान पंक्ति 100K प्रीफ़िक्स को मानती है जिसे एक बार लिखा गया और 1,000 बार वापस पढ़ा गया, साथ ही प्रति रिक्वेस्ट 5K फ्रेश इनपुट और 1K आउटपुट।
थ्रेशहोल्ड-से-ऊपर रीट्रिवल पंक्ति सुर्खी वाली है। हर रिक्वेस्ट को 272K इनपुट टोकन से नीचे रखें, और दोनों मॉडल बिल्कुल एक जैसे $150 पर आते हैं। वही 10M टोकन ऐसे रिक्वेस्ट्स में धकेलें जो हर एक 272K से ऊपर जाते हैं, और Astra $275 पर कूद जाता है जबकि Fable 5.1 $150 पर रहता है, क्योंकि Anthropic 1M-टोकन कॉन्टेक्स्ट विंडो को स्टैंडर्ड रेट्स पर रखता है।
कैश-प्रधान लूप वह है जिससे अधिकतर पाठक टकराएँगे। 100K प्रीफ़िक्स की 1,000 कैश्ड रीड्स पर, प्रति मिलियन कैश्ड टोकन $0.75 का गैप एक अन्यथा समान वर्कलोड पर $75 के फर्क में बदल जाता है। हालांकि उस वर्कलोड के आकार पर ध्यान दें: इसे जानबूझकर आउटपुट-हल्का रखा गया है—प्रति रिक्वेस्ट 1K आउटपुट टोकन बनाम 100K कैश रीड्स। यही वह आकार है जहाँ Fable 5.1 का कैश लाभ बिल तय करता है।
एक बार जब आप मान लेने के बजाय वास्तविक टोकन खपत को मापते हैं, तो तस्वीर पलट जाती है। Artificial Analysis हर मॉडल की Intelligence Index टास्क पर कीमत निकालता है, और उसकी विधि में पहले से इनपुट, कैश हिट, कैश राइट, थिंकिंग, और जवाब टोकन शामिल हैं, इसलिए Fable 5.1 का सस्ता कैश पहले से ही संख्या में झलकता है।
| प्रयास स्तर | GPT-6 Astra: स्कोर/प्रति-टास्क लागत | Claude Fable 5.1: स्कोर/प्रति-टास्क लागत |
|---|---|---|
| max | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
मैक्स प्रयास पर, समान सूची कीमत के बावजूद, वही टास्क सेट करने के लिए Fable 5.1 की लागत Astra की तुलना में 2.25 गुना है। Artificial Analysis अपने कोडिंग इंडेक्स पर भी यही निष्कर्ष निकालता है, जहाँ Astra Fable 5 के बराबर आता है "आधे से भी कम खर्च पर, महत्वपूर्ण टोकन दक्षता सुधारों के चलते"। Astra का रेंज लो प्रयास पर $0.46 प्रति टास्क तक जाता है।
यहाँ Fable 5.1 को उसके रेट कार्ड से नहीं, बल्कि उसके आउटपुट वॉल्यूम से दंडित किया जा रहा है। Artificial Analysis ने मापा कि यह मैक्स प्रयास पर Fable 5 के आउटपुट टोकन का लगभग 1.7x उपयोग करता है, इसलिए कैश कट के बावजूद यह अपने पूर्ववर्ती से प्रति टास्क 20% महँगा है। कट को हटा दें, तो आंकड़ा लगभग $5.16 होता, तो छूट वास्तविक काम कर रही है—बस पर्याप्त नहीं।
आप यह प्रीमियम किसी चीज़ के लिए दे रहे हैं। Fable 5.1 उसी इंडेक्स पर 5 प्वाइंट ऊँचा स्कोर करता है, और xhigh पर 4 प्वाइंट ऊँचा। 5 प्वाइंट 2.25x के काबिल हैं या नहीं—यह आपका निर्णय है, मेरा नहीं; लेकिन यह धारणा कि एक जैसी सूची कीमतें एक जैसे बिल बनाती हैं, मापों के सामने टिकती नहीं।
OpenAI के अपने कैप्शंस भी इसी दिशा की ओर इशारा करते हैं, जितनी किसी वेंडर के आत्म-रिपोर्ट की क़ीमत हो। यह Astra की अनुमानित API प्रति-टास्क लागत को Terminal-Bench Science 0.1 पर Fable 5.1 से लगभग 31% कम, Terminal-Bench 4.0 पर लगभग 63% कम, और BenchCAD पर लगभग 86% कम बताता है—उन प्रयास सेटिंग्स पर जो OpenAI ने प्रत्येक मॉडल के लिए चुनीं।
समग्र रूप से हमारी टेस्ट में Astra थोड़ा आगे रहा, हालांकि दोनों मॉडलों ने पहले ही प्रयास में एक काम करती हुई सिमुलेशन शिप की।
मैंने कई सतही टेस्ट के बजाय दोनों मॉडलों के खिलाफ एक कठिन टास्क एक जैसे हालात में चलाया। इस तुलना के लिए चुना गया टेस्ट एक सिंगल HTML फाइल के रूप में शून्य से बना फिज़िक्स सिमुलेशन है, जिसे इसलिए चुना गया क्योंकि यह ठीक वही चीज़ परखता है जिसे दोनों वेंडर्स ने बेहतर बताया है: लंबे बिल्ड में लगातार शुद्धता, बिना किसी लाइब्रेरी के सहारे।
यह इंस्टेंस उस टेस्ट का एक ताज़ा संस्करण है। प्रकाशित वैरिएंट में एक घूमता हुआ चौकोर कंटेनर था, तो इस रन में एक घूमता हुआ हेक्सागन, विपरीत दिशा में घूमता केंद्रीय अवरोध, और आकार-आनुपातिक द्रव्यमान जोड़ा गया है—जो कठिनाई बढ़ाता है, जबकि कंटेनमेंट को बिना दुविधा पास/फेल रखता है। यह रहा प्रॉम्प्ट, हर मॉडल के लिए नई चैट में ज्यों का त्यों चिपकाया गया:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
दोनों मॉडल हाई रीजनिंग प्रयास पर चले, बिना रीट्राइ के एक-एक प्रयास, उसी कोडिंग एजेंट और उसी टूलिंग के साथ। स्कोरिंग क्रमशः रननेबिलिटी की पास/फेल जाँच, फिर फिज़िक्स करेक्टनेस, 30 सेकंड पर स्थिरता, और विज़ुअल क्वालिटी पर 1 से 5 का रूब्रिक था।
Astra रननेबिलिटी चेक पास कर गया और तीनों रूब्रिक अक्षों पर 5/5 स्कोर किया। यह 6 टर्न और 9 टूल कॉल में पहुँचा, और टूल मिक्स दिलचस्प है: इसने फाइल लिखी, उसे 5 बार पढ़ा, दो बार grep किया, और दो बार पैच किया, फिर डन घोषित किया।
सिमुलेशन सही है। 44 बॉल्स, क्षेत्र के अनुपात में द्रव्यमान स्केलिंग, हेक्सागन के घूमते रहने के दौरान पूरे 30 सेकंड कंटेनमेंट कायम। Astra ने अंदरूनी अवरोध को चेंबर के सापेक्ष बड़ा रखा, जिससे बॉल्स उसके साथ टकराती रहती हैं, बजाय इसके कि कहीं ऐसी जगह टिकें जहाँ वह नहीं पहुँचता।
इसने सिमुलेशन के चारों ओर पूरा एडिटोरियल पेज भी बनाया—सेरिफ हेडलाइन, लेटरस्पेस्ड मोनोस्पेस लेबल, और एक टेलीमेट्री पैनल जो लाइव रोटेशन रेट्स रिपोर्ट करता है। किसी ने यह नहीं माँगा था, लेकिन मेरी राय में यह काफ़ी अच्छा दिखता है। इसने पॉज़ और रिस्टार्ट कंट्रोल भी शिप किए, जिनकी प्रॉम्प्ट ने माँग नहीं की थी, पर आर्टिफैक्ट को जाँचना आसान बना दिया।
Astra चेंबर को 0.09 rad/s और अवरोध को -0.16 rad/s पर घुमाता है—Fable की तुलना में बाहरी दीवार पर लगभग 3 गुना और अवरोध पर 5 गुना धीमा। देखने में आसान, और तेज़ घुमाव की तुलना में मूविंग बाउंड्री का नरम टेस्ट। चूँकि प्रॉम्प्ट ने धीमे घूमते कंटेनर की माँग की थी, यह ठीक है।
| माप | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| टर्न्स | 6 | 2 |
| टूल कॉल्स | 9 | 1 |
| रननेबिलिटी | पास | पास |
| फिज़िक्स करेक्टनेस | 5 | 4 |
| समय के साथ स्थिरता | 5 | 5 |
| विज़ुअल क्वालिटी | 5 | 4 |
| रूब्रिक स्कोर | 5.0 | 4.3 |
गुणवत्ता में Astra यह राउंड लेता है, और मार्जिन प्रस्तुति पर फिज़िक्स से ज़्यादा चौड़ा है। जहाँ वे अलग होते हैं, वह है—प्रत्येक मॉडल ने काम को क्या समझा। Astra ने प्रॉम्प्ट को एक ब्रीफ़ की तरह पढ़ा—कंट्रोल्स जोड़ना, पूरा एडिटोरियल लेआउट, और देखने लायक धीमा घुमाव। Fable ने इसे एक स्पेक की तरह पढ़ा—एक राइट में पूरा किया—और बाकी मेहनत डायग्नोस्टिक HUD पर लगाई।
यह प्रति मॉडल एक ही रन है, इसलिए इसे बेंचमार्क की बजाय एक डेटा पॉइंट की तरह लें। यह टोकन या लागत के बजाय टर्न्स रिपोर्ट करता है, और ऊपर कवर किए गए कंप्यूटर उपयोग या तर्क आयामों को नहीं, बल्कि केवल शून्य से सिमुलेशन कोड को परखता है।
क्योंकि सूची दरें मेल खाती हैं, निर्णय वर्कलोड के आकार, मापी गई टोकन खपत, और आपके मौजूदा कोडिंग एजेंट पर निर्भर करता है। तीन नंबर जो आपका फैसला बदलने चाहिए, वे हैं 4x कैश रीड गैप, 272K सरचार्ज थ्रेशहोल्ड, और 2.25x मापी गई प्रति-टास्क लागत।
| सरफेस | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| कंज़्यूमर ऐप | ChatGPT Plus, Pro, Business, Enterprise | Claude वेब, मोबाइल, डेस्कटॉप (Pro, Max, Team, Enterprise) |
| फ़र्स्ट-पार्टी API | OpenAI API | Claude API |
| क्लाउड प्लेटफॉर्म | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| कोडिंग एजेंट्स | Codex | Claude Code, Cursor |
| थर्ड-पार्टी राउटर्स | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API मॉडल ID | gpt-6-astra |
claude-fable-5-1 |
दो एक्सेस विवरण आपकी पहली कॉल से पहले ही रोकेंगे। एंटरप्राइज़ वर्कस्पेस के लिए Astra डिफ़ॉल्ट रूप से ऑफ़ रहता है जब तक कोई एडमिनिस्ट्रेटर इसे ऑन न करे, और Fable 5.1 के लिए 30-दिन डेटा रिटेंशन आवश्यक है और यह Priority Tier पर सपोर्टेड नहीं है। क्लाउड पहुँच दोनों के बीच क़रीब-क़रीब बराबर है—फिलहाल Google Cloud एकमात्र प्लेटफॉर्म है जिस पर Fable 5.1 है और GPT-6 Astra नहीं।
हर मॉडल अपने-अपने हार्नेस में नेटिव है—Astra Codex में और Fable 5.1 Claude Code में—जहाँ आप /model claude-fable-5-1 या --model फ़्लैग से स्विच करते हैं। API के जरिए यह एक स्ट्रिंग का स्वैप है, हालाँकि SDK अलग हैं।
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Fable 5.1 के तीन बदलाव Fable 5 पर लिखे कोड को तोड़ देंगे: फोर्स्ड टूल सिलेक्शन अब 400 लौटाता है, पहले के मॉडल उसके थिंकिंग ब्लॉक्स नहीं पढ़ सकते, और थिंकिंग ब्लॉक्स अपने ठीक पहले के इतिहास से बंधे होते हैं। हमारा Claude Fable 5.1 API ट्यूटोरियल इन तीनों पर काम करता है, और OpenAI API के लिए शुरुआती गाइड दूसरी तरफ का बराबरी सेटअप कवर करता है।
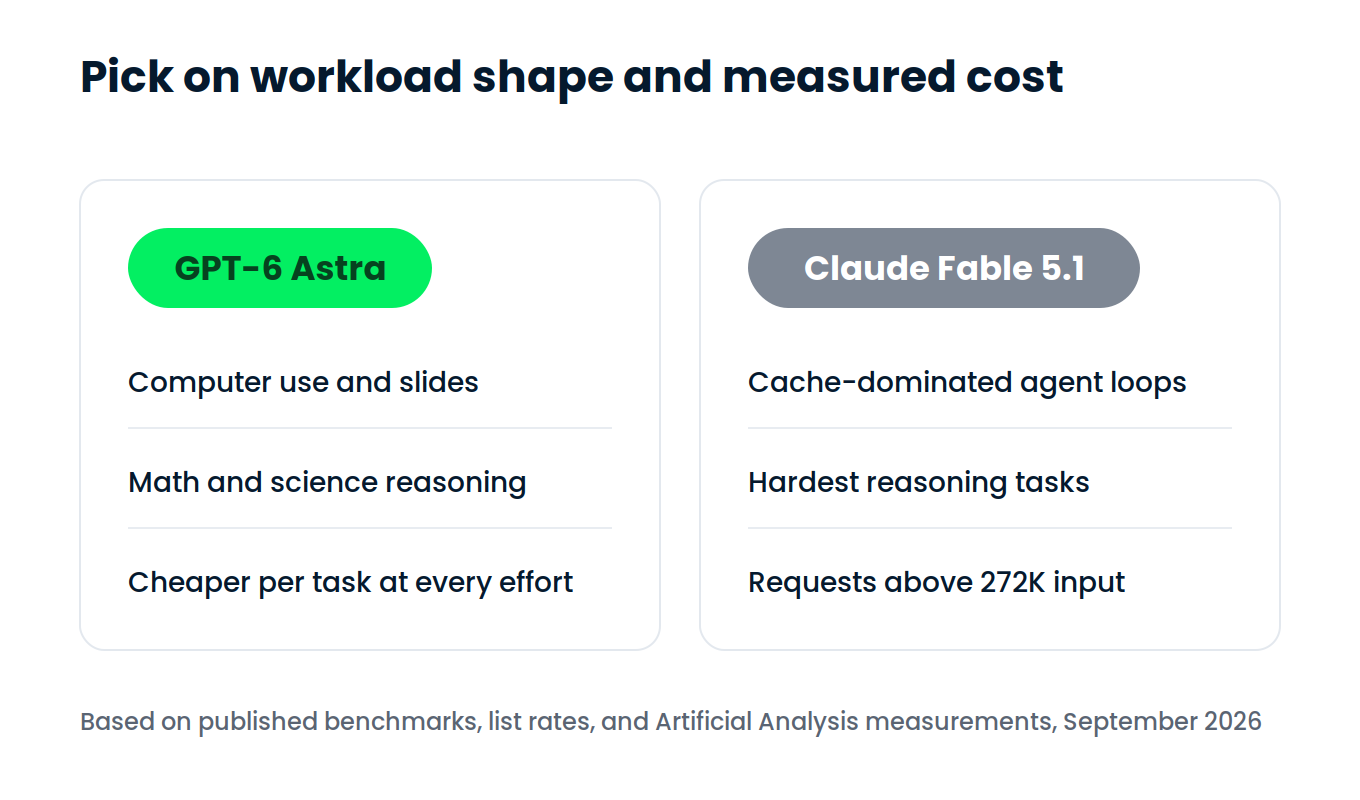
बेंचमार्क तालिकाओं पर नहीं, वर्कलोड के आकार और मापी गई लागत पर चुनाव करें। GPT-6 Astra उन एजेंट्स के लिए मजबूत है जो सॉफ्टवेयर पर क्लिक करके काम करते हैं, गणित करते हैं, या क्लाइंट-रेडी आर्टिफैक्ट्स बनाते हैं—और समान रेट कार्ड के बावजूद प्रति टास्क यह दोनों में सस्ता दिखता है। Claude Fable 5.1 आपको उपलब्ध सर्वाधिक स्वतंत्र तर्क स्कोर दिलाता है और बहुत बड़े अनुरोधों तथा कैश-प्रधान लूप्स पर कम लागत आता है।
इस तुलना में रेट कार्ड ही जाल है। $10 और $50 पर दो मॉडल कीमत में एक जैसे दिखते हैं, और एकमात्र दिखने वाला गैप—कैश रीड्स—Anthropic के पक्ष में 4x है। फिर आप मापते हैं कि हर एक टास्क खत्म करने के लिए वास्तव में क्या खर्च करता है, और Astra, Fable 5.1 की लागत के 44% पर आता है। मैं यह प्राइसिंग पेज से नहीं भांप सकता था, और यह वही एक चीज़ है जिसे मैं किसी भी ओर कमिट करने से पहले आपके अपने ट्रैफिक पर जाँचूँगा।
अगर आप पढ़ने के बजाय किसी भी मॉडल के साथ काम करना चाहते हैं, तो Anthropic साइड के लिए हमारा Introduction to Claude Models कोर्स और OpenAI के लिए Working with the OpenAI API सुझाता हूँ।
DataCamp के साथ AI सीखें!
कोर्स
कोर्स
कोर्स