강의
Claude 모델 입문
3시간
14.9K
GPT-6 Astra는 GPT-5.6 Sol의 후속작으로, 대화가 아닌 에이전트형 실행을 중심에 둔 OpenAI의 최전선 플래그십입니다. OpenAI는 이를 컴퓨터 사용, 전문 업무, 소프트웨어 엔지니어링에 포지셔닝했으며, 자사 Preparedness Framework에서 사이버보안 "Critical" 임계값을 처음으로 넘긴 모델입니다. 컨텍스트 윈도우는 1,050,000 토큰, 최대 출력은 128K, 지식 컷오프는 2026년 4월 30일입니다.
공개에서 눈에 띄는 점은 두 가지입니다. Codex에서는 Astra가 컨텍스트 윈도우 간 노트를 요약으로 압축하지 않고 그대로 유지해 이전 윈도우를 계속 검색할 수 있고, 항상 추측하거나 항상 질문하지 않고 필요할 때만 명확화 질문을 던진다는 점입니다.
전체 기능 목록, 벤치마크 표, 접근 방법은 GPT-6 Astra 가이드를 확인하세요. 또한 전작에 대한 소개인 GPT-5.6 Sol, Terra, Luna와 함께 읽을 만합니다.
Claude Fable 5.1은 난도 높은 추론과 장기 호라이즌 에이전트형 작업을 위한 Anthropic의 일반 제공(Generally Available) 최전선 모델입니다. 1M 토큰 컨텍스트 윈도우, 128K 최대 출력, 항상 활성화된 적응형 사고(adaptive thinking), 2026년 6월 지식 컷오프를 갖습니다. Anthropic 문서에 따르면 지연 시간은 가격대가 더 낮은 Claude Opus 5와 Claude Sonnet 5보다 느립니다.
Claude Mythos 5.1은 동일한 모델에 다른 안전장치를 적용한 변형으로, Project Glasswing을 통해 초대 기반으로 제공됩니다. 일반 사용자에게 중요한 변경 사항은 캐시 읽기 가격으로, 백만 토큰당 $0.25로 75% 인하되었으며, 기본 요율은 그대로입니다.
Claude Fable 5.1 가이드에서 전체 벤치마크를 확인할 수 있고, Claude Fable 5.1 API 튜토리얼에서는 리포지토리 인식 개발자 에이전트를 구축하며 노력 수준별 실제 비용 분해도 제공합니다.
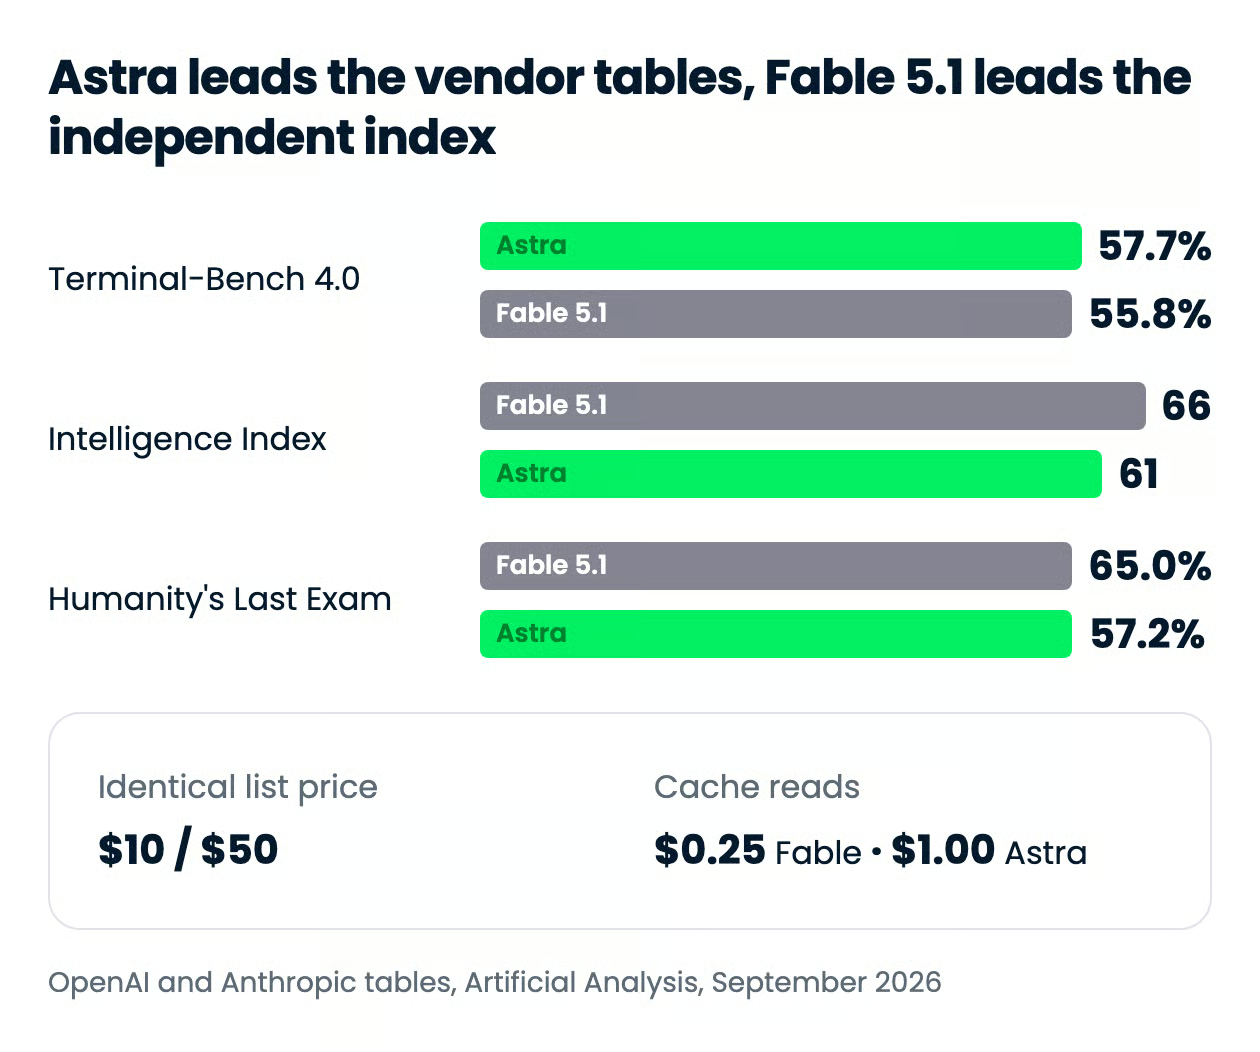
요지는 이렇습니다. OpenAI의 비교 표에서는 공개된 거의 모든 항목에서 Astra가 Fable 5.1보다 앞서고, Artificial Analysis는 두 지수 모두에서 정반대를 보입니다. 어느 쪽을 믿을지는 벤더가 스스로 경쟁자를 평가한 점수에 얼마만큼의 가중치를 두느냐에 달려 있습니다.
| 기능 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 출시일 | 2026년 9월 3일 | 2026년 9월 1일 |
| API 모델 ID | gpt-6-astra |
claude-fable-5-1 |
| 컨텍스트 윈도우 | 105만 토큰 | 100만 토큰 |
| 최대 출력 | 128K 토큰 | 128K 토큰 |
| 지식 컷오프 | 2026년 4월 30일 | 2026년 6월 |
| 백만 토큰당 정가 | $10 입력 / $50 출력 | $10 입력 / $50 출력 |
| 백만 토큰당 캐시 입력 읽기 | $1.00 (272K 초과 시 $2.00) | $0.25 |
| 272K 입력 토큰 초과 요율 | 입력·캐시 2배, 출력 1.5배 | 할증 없음 |
| FrontierMath 4단계 (v2) | 97.6% | 87.8% |
| Humanity's Last Exam, 도구 사용 | 57.2% | 65.0% |
| ScreenSpot-Pro (도구 없음) | 92.7% | 87.3% (Fable 5, Mythos 근거) |
| AutomationBench | 41.4% | 31.4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (최대 노력) | 61 | 66 |
| AA 과제당 비용 (최대 노력) | $1.67 | $3.76 |
| 가장 강한 영역 | 컴퓨터 사용, 수학, 사이버보안, 과제당 비용 | 추론 심도, 캐시 중심 에이전트 루프 |
OpenAI가 공개한 코딩 벤치마크에서는 Astra가 근소하게 앞서지만, 독립 지수는 다른 결론을 냅니다. 터미널에서의 소프트웨어 엔지니어링, 시스템 구성, 데이터 분석을 측정하는 Terminal-Bench 4.0에서 OpenAI는 Astra 57.7%, Fable 5.1 55.8%를 보고했습니다. Anthropic도 55.8%를 동일하게 게시했으므로 이 항목은 이견이 없습니다.
DeepSWE v1.1에서는 격차가 벌어져 Astra 74.1%, Fable 5.1 67.4%이고, FrontierCode 1.1 Main에서는 53.3% 대 50.9%로 거의 차이가 없는데, 이는 이미 Claude Fable 5(53.5%)와 Claude Opus 5(53.4%)가 차지하던 구간 안쪽입니다.
| 벤치마크 | GPT-6 Astra | Claude Fable 5.1 | 비고 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.7% | 55.8% | OpenAI 표는 57.7%, 차트 캡션은 57.9%로 표기 |
| DeepSWE v1.1 | 74.1% | 67.4% | OpenAI 보고 |
| FrontierCode 1.1 Main | 53.3% | 50.9% | Fable 5 53.5%, Opus 5 53.4%와 사실상 동률 |
| 내부 DB 마이그레이션 | 63.9% | 57.8% | OpenAI 내부 평가, 외부 재현 없음 |
| CursorBench 3.2.0 | 미공개 | 73.4% | Anthropic 보고; SpaceXAI가 최대 노력에서 73.4% 확인 |
| AA Coding Agent Index | Codex에서 67 | Claude Code에서 70 | 독립 평가이나 하니스가 다름 |
마지막 행이 특히 중요합니다. Artificial Analysis는 Claude Code의 Fable 5.1을 70으로, 코딩 에이전트 지수 최고 점수로 평가하고, Codex의 Astra를 67로 평가하며 이는 Claude Opus 5 및 Claude Fable 5와 비슷한 수준입니다. 여기에는 두 가지 유의점이 있습니다.
Astra는 공개된 코딩 항목에서 근소하게 이기고 효율 면에서는 확실히 앞서지만, Fable 5.1만이 두 모델을 모두 넘어서는 유일한 독립 코딩 에이전트 점수를 보유합니다.
이 비교에서 가장 명확하게 갈리는 영역이며, 양쪽 모두가 강점을 보입니다. Astra는 수학과 과학에서 우세합니다. FrontierMath Tier 4 v2에서 97.6% 대 87.8%, GPQA Diamond에서 96.0% 대 93.7%, 그리고 Anthropic이 자체 출시를 기반으로 삼았던 에이전트형 연구 벤치마크 Terminal-Bench Science 0.1에서 64.6% 대 52.6%입니다.
Fable 5.1은 도구 사용 시 Humanity's Last Exam에서 65.0% 대 57.2%로 크게 앞섭니다. 독립 기관인 Artificial Analysis도 같은 방향을 지지하며 Intelligence Index에서 Fable 5.1을 66, Astra를 61로 평가했는데, 이는 지금까지 측정된 최고 점수입니다.
이 66점에는 단서가 있습니다. Artificial Analysis는 Fable 5.1을 Anthropic 기본 서버 사이드 폴백(안전 플래그 요청을 Claude Opus 4.8 또는 Claude Opus 5로 라우팅)과 함께 실행했고, 폴백이 인덱스 전체 출력 토큰의 약 4%를 담당했습니다. 즉 이 점수는 순수 모델이 아닌, 실제 사용자가 호출하는 Fable 5.1의 점수입니다.
대학원 수준의 수학·과학 작업이라면 Astra, Humanity's Last Exam이 탐지하는 폭넓고 어려운 추론이라면 Fable 5.1을 추천합니다.
이 영역은 Astra가 우세합니다. 주로 Anthropic이 비교 가능한 수치를 공개하지 않았기 때문입니다. OpenAI는 OSWorld 2.0 오프라인 세트에서 Astra 72.6%, Claude Opus 5 70.2%, ScreenSpot-Pro에서 Astra 92.7%, Claude Fable 5 87.3%를 보고했습니다. Anthropic의 Fable 5.1 수치(부분 77.9%, 엄격 41.7%)는 다른 과제 릴리스와 채점 방식에서 나온 값입니다.
아티팩트 수치는 더 명확합니다. BenchCAD 95.9% 대 84.3%, AutomationBench 41.4% 대 31.4%입니다.
실제 소프트웨어를 클릭해 작업하고 슬라이드나 CAD 산출물을 만들어야 하는 에이전트라면 Astra가 더 적합합니다.
Astra의 정렬(alignment) 수치는 출시에서 상대적으로 덜 주목받았지만 중요합니다. OpenAI 내부 컴퓨터 사용 안전 벤치마크(낮을수록 좋음)에서 Astra 2.4%, Fable 5.1 9.5%를 기록했습니다.
사이버보안에서는 급이 다릅니다. ExploitBench 100%, Irregular의 독립 테스트에서 FrontierCyber 과제 226개 중 86개 해결(비교: GPT-5.6 Sol은 34개). Anthropic은 Fable 5.1의 취약점 탐지를 허용하되 익스플로잇은 제한했습니다.
두 가지 단서, 모두 중요합니다.
Astra는 더 안전한 에이전트이면서 동시에 더 강력한 공격자이기도 합니다. 그래서 게이팅이 존재합니다.
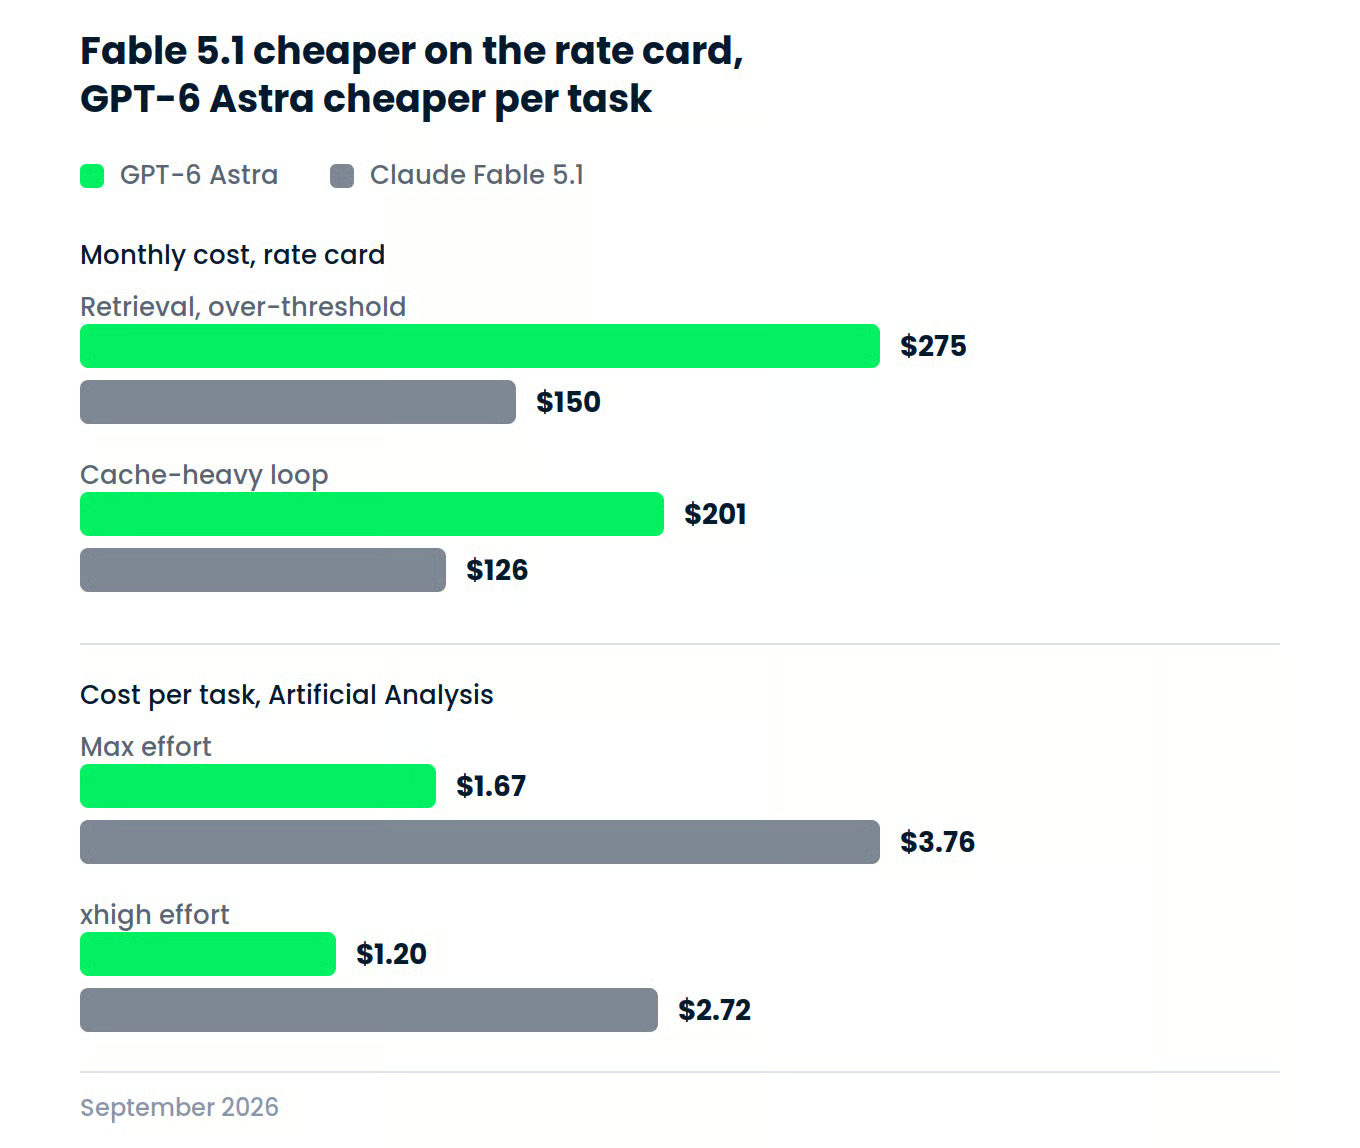
정가는 동일하므로, 요율표에서 두 모델의 차이는 캐싱과 장문 컨텍스트뿐입니다. 이 전제는 두 모델이 같은 작업에 같은 양의 토큰을 쓴다는 가정에서만 성립하며, 실제로는 그렇지 않습니다. 그래서 아래의 과제당 실측 수치가 요율표보다 중요합니다.
| 요율 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 입력, 백만 토큰당 | $10.00 | $10.00 |
| 출력, 백만 토큰당 | $50.00 | $50.00 |
| 캐시 입력 읽기, 백만 토큰당 | $1.00 | $0.25 |
| 캐시 쓰기(5분), 백만 토큰당 | $12.50 | $12.50 |
| 배치 할인 | 50% | 50% |
| 272K 입력 토큰 초과 요율 | $20.00 입력 / $2.00 캐시 / $75.00 출력 | 할증 없음 |
입력, 출력, 캐시 쓰기, 배치 할인은 1센트 단위까지 일치합니다. 예외는 캐시 읽기이며, 4배 차이입니다. Anthropic은 Fable 5.1의 캐시 읽기를 $0.25로 낮춘 반면, OpenAI는 Astra의 캐시 읽기를 $1.00으로 책정했습니다(입력 요율 대비 90% 할인).
272K 입력 토큰을 넘기면 격차는 8배로 벌어집니다. OpenAI의 할증으로 캐시 읽기도 입력과 함께 $2.00로 두 배가 되지만, Anthropic의 가격 문서는 100만 토큰 전체 컨텍스트 윈도우에 표준 요율을 적용합니다. 이 임계값이 Astra가 광고하는 컨텍스트 대비 얼마나 낮은지도 주목해야 합니다. 272K는 Astra 자체 105만 윈도우의 약 4분의 1이므로, 컨텍스트의 4분의 1을 넘겨 쓰는 요청부터는 상위 요율이 적용됩니다.
캐시 읽기는 긴 루프에서 누적되는 요율입니다. 에이전트는 매 턴 동일한 시스템 프롬프트, 도구 정의, 리포지토리 컨텍스트를 재전송하기 때문입니다. 캐시 쓰기와 캐시 읽기의 차이는 프롬프트 캐싱 가이드에서 자세히 다룹니다.
아래 표의 모든 수치는 고정 토큰 형태를 가정한 리스트가 산술이며, 실측 결과가 아닙니다. “두 모델이 동일한 토큰을 소모한다면 요율표 기준 비용은?”이라는 질문에 답합니다. 다음 섹션은 실제 소모량을 다룹니다.
| 워크로드 | GPT-6 Astra | Claude Fable 5.1 | 차이 |
|---|---|---|---|
| 균형형 어시스턴트: 100만 입력 / 25만 출력 | $22.50 | $22.50 | $0, 0% |
| 검색, 임계 하회: 1천만 입력 / 100만 출력 | $150 | $150 | $0, 0% |
| 검색, 임계 초과: 1천만 입력 / 100만 출력 | $275 | $150 | $125, Astra가 83% 더 비쌈 |
| 캐시 중심 루프: 10만 접두사, 1,000회 읽기 | $201 | $126 | $75, Astra가 59% 더 비쌈 |
공식은 모든 행에서 동일합니다. (볼륨 ÷ 100만) × 요율을 신규 입력, 캐시 읽기, 캐시 쓰기, 출력에 대해 합산했습니다. 캐시 중심 행은 10만 토큰 접두사를 한 번 쓰고 1,000번 읽으며, 요청당 신규 입력 5K와 출력 1K를 가정합니다.
임계 초과 검색 행이 핵심입니다. 각 요청을 272K 입력 토큰 아래로 유지하면 두 모델 모두 정확히 $150입니다. 동일한 1천만 토큰을 요청당 272K를 넘겨 보내면 Astra는 $275로 뛰고 Fable 5.1은 $150에 머뭅니다. Anthropic은 100만 토큰 컨텍스트 전체에 표준 요율을 적용하기 때문입니다.
캐시 중심 루프는 많은 독자가 직면할 형태입니다. 10만 접두사를 1,000번 캐시에서 읽을 때, 백만 캐시 토큰당 $0.75의 격차가 동일 워크로드에서 $75 차이로 확대됩니다. 다만 이 워크로드 형태는 의도적으로 출력이 적습니다. 요청당 출력 1K 토큰 vs 캐시 읽기 10만 토큰. Fable 5.1의 캐시 이점이 요금을 결정하는 유일한 형태입니다.
가정이 아닌 실제 토큰 소모를 측정하면 그림이 뒤집힙니다. Artificial Analysis는 Intelligence Index 과제당 모델별 비용을 제시하며, 이 방식은 입력, 캐시 히트, 캐시 쓰기, 사고 토큰, 답변 토큰을 이미 포함하므로 Fable 5.1의 더 저렴한 캐시도 반영되어 있습니다.
| 노력 수준 | GPT-6 Astra: 점수/과제당 비용 | Claude Fable 5.1: 점수/과제당 비용 |
|---|---|---|
| max | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
최대 노력에서 Fable 5.1은 동일 과제 집합을 동일 정가로 수행하면서 Astra 대비 2.25배의 비용이 듭니다. 코딩 지수에서도 같은 결론이 나옵니다. Astra는 Fable 5와 “절반 이하의 비용으로, 큰 토큰 효율 개선에 의해” 동률을 이룹니다. Astra의 범위는 낮은 노력에서 과제당 $0.46까지 내려갑니다.
여기서 Fable 5.1은 요율표가 아니라 출력 물량 때문에 불리합니다. Artificial Analysis는 최대 노력에서 Fable 5 대비 약 1.7배의 출력 토큰을 사용했다고 측정했으며, 캐시 인하에도 불구하고 전작 대비 과제당 비용이 20% 오른 이유가 여기에 있습니다. 인하가 없었다면 약 $5.16이었을 것이므로, 할인은 실제로 효과가 있지만 충분하진 않습니다.
물론 그 프리미엄에는 이유가 있습니다. Fable 5.1은 같은 지수에서 5점(및 xhigh에서 4점) 더 높습니다. 5점을 위해 2.25배를 지불할 가치는 각자의 판단에 맡기지만, 동일 정가가 동일 청구서를 의미한다는 가정은 실측과 맞지 않습니다.
벤더 자가보고라는 한계는 있지만, OpenAI의 캡션도 같은 방향을 가리킵니다. OpenAI는 Astra의 과제당 예상 API 비용이 Terminal-Bench Science 0.1에서 Fable 5.1 대비 약 31% 낮고, Terminal-Bench 4.0에서 약 63% 낮으며, BenchCAD에서 약 86% 낮다고 밝힙니다(모델별로 선택한 노력 설정 기준).
두 모델 모두 첫 시도에서 작동하는 시뮬레이션을 제출했지만, 전체적으로는 Astra가 근소하게 앞섰습니다.
여러 얕은 작업 대신 동일 조건에서 두 모델에 하나의 어려운 작업을 수행하게 했습니다. 이번 비교에서는 단일 HTML 파일로 처음부터 만드는 물리 시뮬레이션을 선정했습니다. 두 벤더가 개선했다고 주장하는 부분—라이브러리 없이 긴 빌드 동안의 지속적 정확성—을 정확히 찌르는 과제이기 때문입니다.
이 인스턴스는 해당 테스트를 새로 고친 버전입니다. 공개 변형은 회전하는 정사각형 용기를 사용했으나, 이번 실행은 회전하는 육각형과 반대 방향으로 회전하는 중앙 장애물, 크기에 비례한 질량을 도입해 난도를 높이되, 경계 유지 여부는 여전히 명확히 판정되도록 했습니다. 아래는 각 모델의 새 채팅에 그대로 붙여넣은 프롬프트입니다.
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
두 모델 모두 높은 추론 노력으로, 재시도 없이 1회 시도, 동일 코딩 에이전트와 동일 도구를 사용했습니다. 채점은 우선 실행 가능 여부(합/불), 그다음 물리 정확성, 30초 동안의 안정성, 시각적 품질에 대해 1~5점 루브릭으로 진행했습니다.
Astra는 실행 가능 판정을 통과했고, 세 루브릭 축에서 모두 5/5를 받았습니다. 6턴, 9번의 도구 호출로 도달했으며, 도구 믹스가 흥미롭습니다. 파일을 작성하고, 5번 읽어들이고, 두 번 grep하고, 두 번 패치한 뒤 완료를 선언했습니다.
시뮬레이션은 정확했습니다. 공 44개, 면적 비례 질량 스케일링, 육각형이 회전하는 동안 30초 내내 경계 유지. Astra는 내부 장애물을 챔버 대비 크게 설정해 공들이 그곳에 정착하지 못하고 계속 충돌하도록 했습니다.
또한 시뮬레이션 주변에 전체 에디토리얼 페이지를 구성했습니다. 세리프 헤드라인, 자간을 넓힌 모노스페이스 라벨, 회전 속도를 실시간으로 보고하는 텔레메트리 패널까지. 요구된 적은 없지만 보기에는 제법 훌륭했습니다. 일시정지와 재시작 컨트롤도 함께 제공했는데, 프롬프트에 없던 요구였지만 아티팩트를 검사하는 데 도움이 됐습니다.
Astra는 챔버를 0.09 rad/s, 장애물을 -0.16 rad/s로 회전시켰습니다. 바깥벽 회전은 Fable보다 약 3배 느리고, 장애물은 약 5배 느립니다. 관찰하기 쉽고, 더 빠른 회전보다 이동 경계에 대한 완만한 테스트였습니다. 프롬프트가 ‘천천히 회전하는 컨테이너’를 요구했으므로 적절합니다.
| 지표 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 턴 수 | 6 | 2 |
| 도구 호출 | 9 | 1 |
| 실행 가능성 | 통과 | 통과 |
| 물리 정확성 | 5 | 4 |
| 시간 경과 안정성 | 5 | 5 |
| 시각적 품질 | 5 | 4 |
| 루브릭 점수 | 5.0 | 4.3 |
Astra가 품질에서 이겼고, 물리보다 표현에서 격차가 컸습니다. 두 모델이 갈라진 지점은 ‘작업’의 해석입니다. Astra는 프롬프트를 해석형 브리프로 읽어 컨트롤, 전체 에디토리얼 레이아웃, 관찰에 적합한 느린 회전을 추가했습니다. Fable은 이를 충족시켜야 할 사양으로 읽었고, 한 번의 쓰기로 충족시킨 뒤 남은 노력을 진단용 HUD에 쏟았습니다.
모델당 1회 실행이므로, 벤치마크라기보다 데이터 포인트 하나로 보세요. 토큰이나 비용이 아니라 턴 수를 보고하며, 위에서 다룬 컴퓨터 사용이나 추론 차원을 검증하지 않고, 순수히 처음부터 작성한 시뮬레이션 코드만을 평가합니다.
정가가 같기 때문에, 결정은 워크로드 형태, 실측 토큰 소모, 이미 사용 중인 코딩 에이전트에 달려 있습니다. 결정을 좌우할 숫자는 4배의 캐시 읽기 격차, 272K 할증 임계값, 2.25배의 실측 과제당 비용입니다.
| 접점 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 소비자 앱 | ChatGPT Plus, Pro, Business, Enterprise | Claude 웹, 모바일, 데스크톱 (Pro, Max, Team, Enterprise) |
| 퍼스트파티 API | OpenAI API | Claude API |
| 클라우드 플랫폼 | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| 코딩 에이전트 | Codex | Claude Code, Cursor |
| 서드파티 라우터 | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API 모델 ID | gpt-6-astra |
claude-fable-5-1 |
첫 호출 전에 막히는 접근 제약이 두 가지 있습니다. Astra는 엔터프라이즈 워크스페이스에서 기본 비활성으로 제공되어 관리자가 켜야 하며, Fable 5.1은 30일 데이터 보존을 요구하고 Priority Tier에서는 지원되지 않습니다. 클라우드 제공은 두 모델이 거의 비슷하며, 현재 Google Cloud만 Fable 5.1이 있고 GPT-6 Astra는 없는 상태입니다.
각 모델은 고유 하니스에 네이티브입니다. Astra는 Codex, Fable 5.1은 Claude Code에서 /model claude-fable-5-1 또는 --model 플래그로 전환합니다. API에서는 문자열 하나만 바꾸면 되지만 SDK는 다릅니다.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Fable 5.1의 세 가지 변화는 Fable 5 기준으로 작성한 코드를 깨뜨릴 수 있습니다. 강제 도구 선택은 400을 반환하고, 이전 모델은 생각(think) 블록을 읽지 못하며, 생각 블록은 자신 바로 앞의 이력과 정확히 결속됩니다. 세 가지 모두는 Claude Fable 5.1 API 튜토리얼에서 다루며, 반대편의 등가 설정은 OpenAI API 입문 가이드에서 확인하세요.
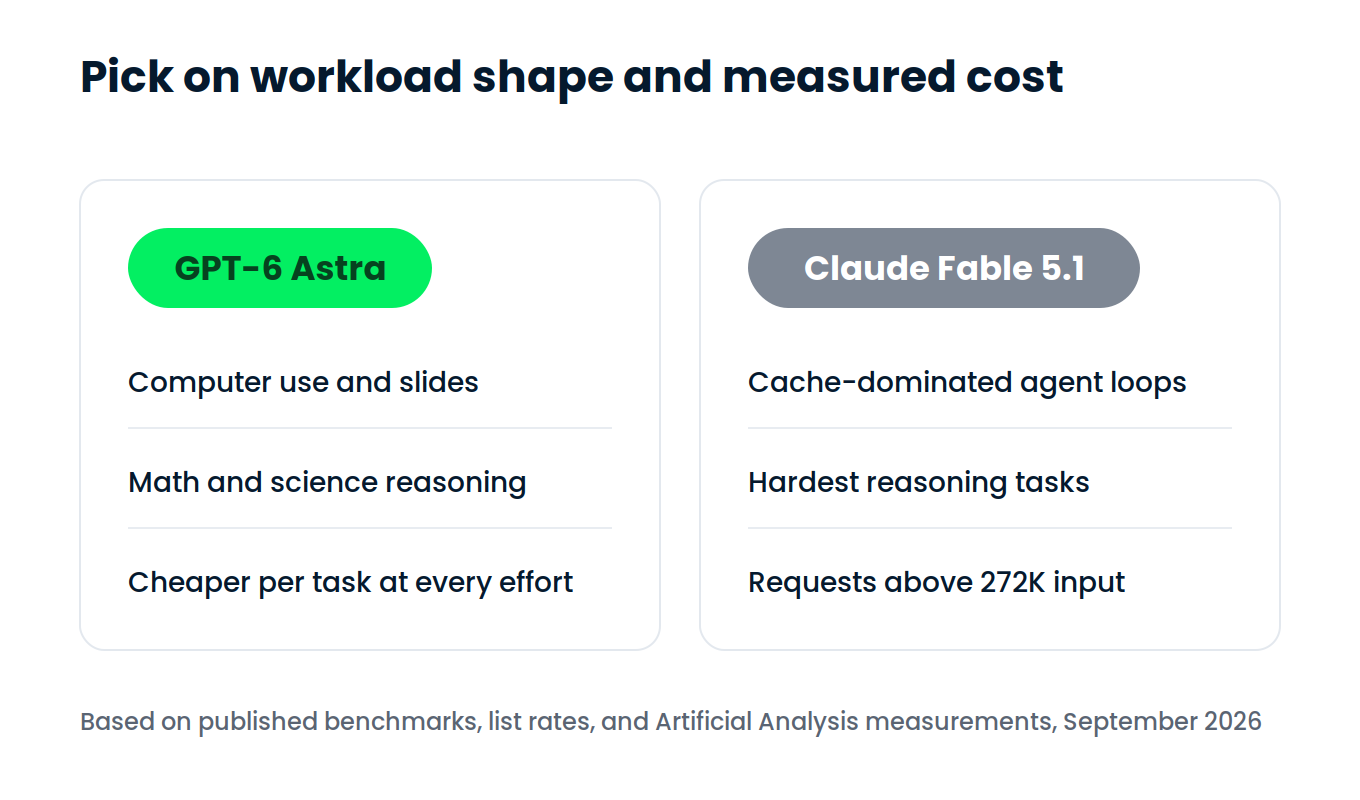
벤치마크 표가 아니라 워크로드 형태와 실측 비용으로 선택하세요. GPT-6 Astra는 소프트웨어를 클릭해 조작하는 에이전트, 수학 작업, 클라이언트 제출 가능한 아티팩트 제작에서 강하며, 동일한 요율표에도 과제당 비용은 더 저렴해 보입니다. Claude Fable 5.1은 최고 수준의 독립 추론 점수를 제공하고, 아주 큰 요청이나 캐시 중심 루프에서는 비용이 더 낮습니다.
이 비교에서 요율표는 함정입니다. 입력 $10, 출력 $50로 보이면 두 모델이 가격 면에서 동일해 보이고, 눈에 보이는 유일한 격차인 캐시 읽기는 Anthropic이 4배 유리합니다. 그러나 실제로 과제를 마치는 데 드는 소모를 측정하면 Astra가 Fable 5.1 비용의 44%에 그칩니다. 가격 페이지만 보고는 예측하기 어려웠고, 실제 트래픽으로 검증해야 할 가장 중요한 포인트입니다.
두 모델을 직접 다뤄 보고 싶다면, Anthropic 측은 Introduction to Claude Models, OpenAI 측은 Working with the OpenAI API 과정을 추천합니다.
DataCamp로 AI를 배워 보세요!
강의
강의
강의