课程
Claude 模型入门
3 小时
14.9K
GPT-6 Astra 是 OpenAI 的前沿旗舰,承接 GPT-5.6 Sol,围绕代理式执行而非聊天构建。OpenAI 将其定位于电脑使用、专业工作与软件工程领域;它也是首个跨过公司“备战框架(Preparedness Framework)”中“关键(Critical)”网络安全门槛的模型。其上下文窗口为 1,050,000 token,最大发电 128K,知识截止于 2026 年 4 月 30 日。
发布中两点尤为醒目。在 Codex 中,Astra 跨上下文窗口保留笔记,而非压缩成摘要,因此早期窗口仍可检索;并且它会自行决定何时发问澄清,而不是总是猜测或总是提问。
完整功能清单、基准表与接入详情,见我们的GPT-6 Astra 指南。也推荐结合前作的报道一起阅读:GPT-5.6 Sol、Terra 与 Luna。
Claude Fable 5.1 是 Anthropic 面向高要求推理与长视程代理式工作的前沿通用模型。其上下文窗口为 1M token,最大发电 128K,默认开启自适应思考,知识截止于 2026 年 6 月。Anthropic 文档标注其时延慢于 Claude Opus 5 与 Claude Sonnet 5,二者定价均低于它。
Claude Mythos 5.1 是相同模型但设有不同安全护栏,通过 Project Glasswing 邀请制提供。对其他所有人而言,头条变化是缓存读取价格——下调 75% 至每百万 token $0.25,而标价保持不变。
我们的Claude Fable 5.1 指南提供完整基准拆解;Claude Fable 5.1 API 教程用它构建了一个可识别代码库的开发者代理,并给出了不同工作量下的真实成本拆分。
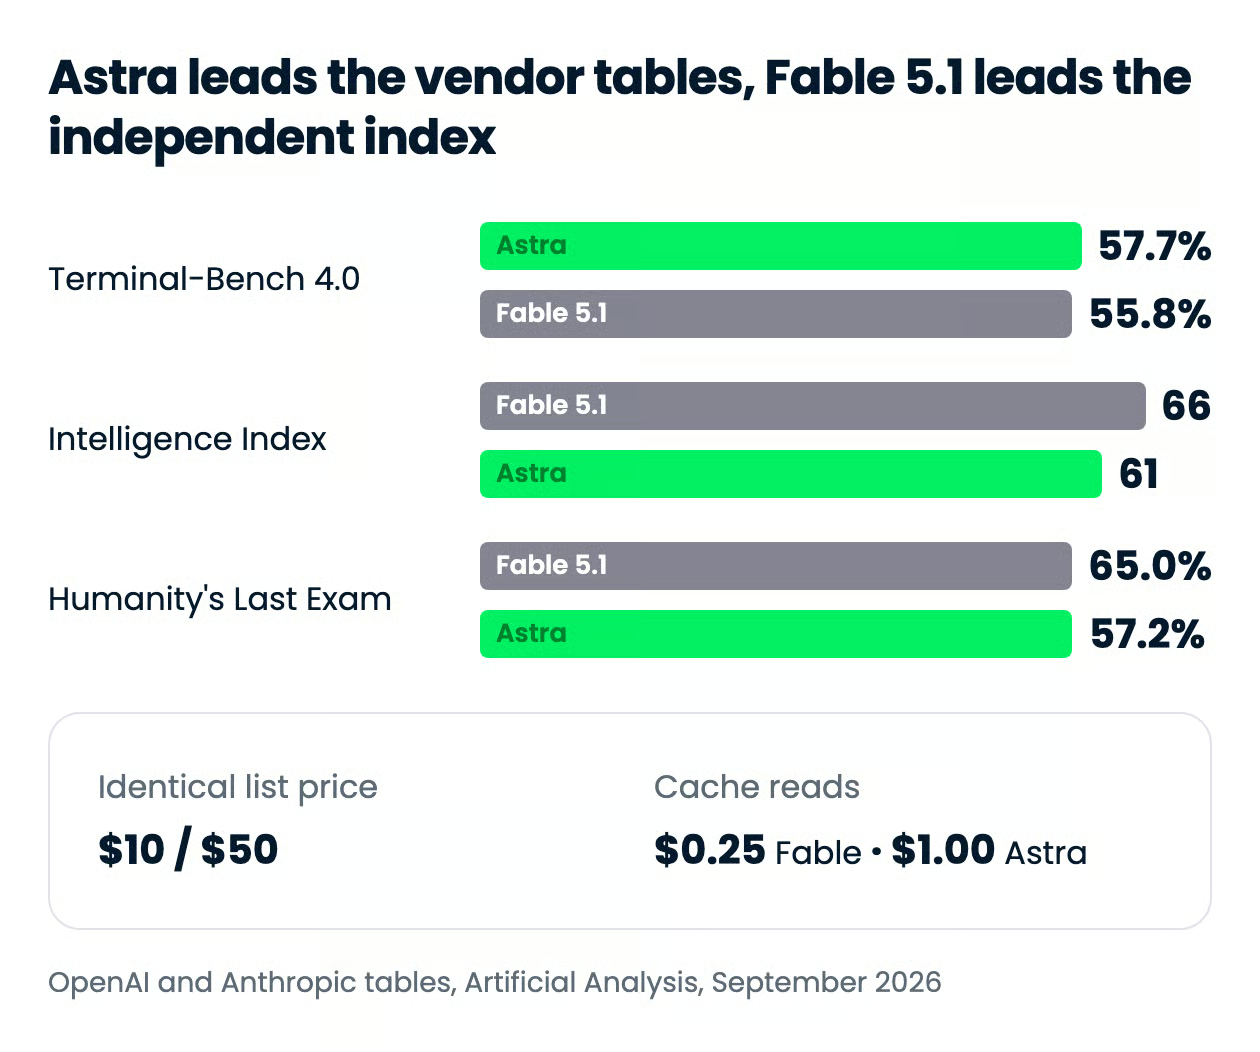
简言之:OpenAI 的对比表几乎每一行都让 Astra 领先 Fable 5.1,而 Artificial Analysis 则在其两个指数上给出了相反结论。您相信哪一边,取决于您对厂商自评竞争对手的权重判断。
| 特性 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 发布日期 | 2026 年 9 月 3 日 | 2026 年 9 月 1 日 |
| API 模型 ID | gpt-6-astra |
claude-fable-5-1 |
| 上下文窗口 | 105 万 token | 100 万 token |
| 最大输出 | 128K token | 128K token |
| 知识截止 | 2026 年 4 月 30 日 | 2026 年 6 月 |
| 标价(每百万 token) | $10 输入 / $50 输出 | $10 输入 / $50 输出 |
| 缓存输入读取(每百万) | $1.00(超 272K 为 $2.00) | $0.25 |
| 超 272K 输入 token 费率 | 输入与缓存翻倍,输出 1.5 倍 | 无附加费 |
| FrontierMath 第 4 级(v2) | 97.6% | 87.8% |
| Humanity's Last Exam(含工具) | 57.2% | 65.0% |
| ScreenSpot-Pro(无工具) | 92.7% | 87.3%(Fable 5,来源于 Mythos) |
| AutomationBench | 41.4% | 31.4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index(max 努力) | 61 | 66 |
| AA 每个 Intelligence Index 任务成本(max) | $1.67 | $3.76 |
| 强项 | 电脑使用、数学、网络安全、每任务成本 | 推理深度、以缓存为主导的代理循环 |
Astra 在 OpenAI 选择发布的编码基准上领先,但优势不大,且独立指数持不同意见。在测试软件工程、系统配置与终端数据分析的 Terminal-Bench 4.0 上,OpenAI 报告 Astra 为 57.7%,Fable 5.1 为 55.8%。Anthropic 发布的 Fable 5.1 同为 55.8%,因此至少这一行没有争议。
在 DeepSWE v1.1 上差距拉大,Astra 达到 74.1%,Fable 5.1 为 67.4%;而在 FrontierCode 1.1 Main 上差距几乎抹平:53.3% 对 50.9%,落在 Claude Fable 5(53.5%)与 Claude Opus 5(53.4%)既有区间内。
| 基准 | GPT-6 Astra | Claude Fable 5.1 | 备注 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.7% | 55.8% | OpenAI 的表写 57.7%,但自家图注写 57.9% |
| DeepSWE v1.1 | 74.1% | 67.4% | OpenAI 报告 |
| FrontierCode 1.1 Main | 53.3% | 50.9% | 与 Fable 5 的 53.5% 和 Opus 5 的 53.4% 基本持平 |
| 内部数据库迁移 | 63.9% | 57.8% | OpenAI 内部评测,暂无外部复现 |
| CursorBench 3.2.0 | 未发布 | 73.4% | Anthropic 报告;SpaceXAI 在最大努力下确认 73.4% |
| AA Coding Agent Index | 在 Codex 中为 67 | 在 Claude Code 中为 70 | 独立评测,但使用不同外框 |
最后一行是我不断回看的。Artificial Analysis 给出 Claude Code 中的 Fable 5.1 为 70,是其编码代理指数上的最高分;而 Codex 中的 Astra 为 67,大致与 Claude Opus 5 和 Claude Fable 5 齐平。这里有两点需要保留:
Astra 以微弱优势拿下已发布的编码项目,并在效率上明显占优;而 Fable 5.1 则握有唯一一个独立的编码代理高分,超越两者。
这是全篇中最清晰的分野,且呈双向。Astra 在数学与科学上领跑:FrontierMath 第 4 级 v2 为 97.6% 对 87.8%,GPQA Diamond 为 96.0% 对 93.7%,Terminal-Bench Science 0.1(Anthropic 自己的发布焦点之一、面向代理式研究的基准)为 64.6% 对 52.6%。
Fable 5.1 则在 Humanity's Last Exam(含工具)上以 65.0% 对 57.2% 明显领先。独立方 Artificial Analysis 也印证了这个方向,在其 Intelligence Index 上给出 Fable 5.1 为 66、Astra 为 61,这是其测得的历史最高分。
关于 66 分有一处保留。Artificial Analysis 以 Anthropic 的默认服务器端回退运行 Fable 5.1,即将安全标记的请求路由至 Claude Opus 4.8 或 Claude Opus 5,回退约占该指数输出 token 的 4%。该分数反映的是“多数实际调用方式”的 Fable 5.1,而非模型在隔离条件下的原始表现。
若您的工作是研究生水平的数学或科学,选 Astra;若是 Humanity's Last Exam 所探测的那类广泛而艰深的推理,选 Fable 5.1。
Astra 在这一维度占优,主要因为 Anthropic 尚未发布可比数据。OpenAI 报告 Astra 在 OSWorld 2.0 离线集为 72.6%,Claude Opus 5 为 70.2%;在 ScreenSpot-Pro 上,Astra 为 92.7%,Claude Fable 5 为 87.3%。Anthropic 发布的 Fable 5.1 成绩(77.9% 部分、41.7% 严格)来自不同任务版本与评分设置。
成品类数字更不含糊:BenchCAD 为 95.9% 对 84.3%,AutomationBench 为 41.4% 对 31.4%。
对于需要实际点击操作软件并产出幻灯片或 CAD 输出的代理,Astra 是更强的选择。
Astra 的对齐数据在发布中讨论得最少。在 OpenAI 的内部电脑使用安全基准(分数越低越好)上,它为 2.4%,Fable 5.1 为 9.5%。
在网络安全上,它进入了另一个档位:ExploitBench 100%,且在 Irregular 的独立测试中解出 226 道 FrontierCyber 挑战中的 86 道,GPT-5.6 Sol 为 34 道。Anthropic 对 Fable 5.1 的松绑足以发现漏洞,但不足以利用漏洞。
两点保留,均需持谨慎态度:
Astra 既是更安全的代理,也是更强的攻击者,因此设置了访问门槛。
标价完全一致,因此在价目表层面,这两款模型的差异只来自缓存与长上下文。不过,这一框架只在两者在同一任务上消耗相同 token 时成立,而事实并非如此——这也是为何下文“按任务测得成本”的数字比价目表更重要。
| 费率 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 输入(每百万 token) | $10.00 | $10.00 |
| 输出(每百万 token) | $50.00 | $50.00 |
| 缓存输入读取(每百万 token) | $1.00 | $0.25 |
| 缓存写入(5 分钟,有效)(每百万 token) | $12.50 | $12.50 |
| 批处理折扣 | 50% | 50% |
| 超 272K 输入 token 费率 | $20.00 输入 / $2.00 缓存 / $75.00 输出 | 无附加费 |
输入、输出、缓存写入与批量折扣都完全一致。唯独缓存读取不同,且差了 4 倍:Anthropic 将 Fable 5.1 的缓存读取定价为 $0.25,而 OpenAI 对 Astra 定价 $1.00,相当于输入费率的 90% 折扣。
当输入 token 超过 272K 时,差距扩大到 8 倍,因为 OpenAI 的附加费让缓存读取随输入一同加倍至 $2.00,而Anthropic 的定价文档明确 1M token 的完整上下文窗口按标准费率计价。请注意该阈值相对 Astra 宣称能力之低:272K 约为其 105 万窗口的四分之一,因此凡是使用超过四分之一上下文的请求,都按更高档计费。
缓存读取是在长循环中会复利的费率,因为代理在每一轮都会重发相同的系统提示、工具定义与代码库上下文。我们的提示缓存指南介绍了缓存写入与缓存读取的机制区别,若您对此还不熟悉可参考。
下表完全基于固定 token 形态下的标价算术,而非实测结果。它回答的问题是:“如果两款模型消耗的 token 完全相同,价目表会收多少?”下一节则回答它们实际消耗多少。
| 工作负载 | GPT-6 Astra | Claude Fable 5.1 | 差异 |
|---|---|---|---|
| 均衡助理:100 万入 / 25 万出 | $22.50 | $22.50 | $0,0% |
| 检索,低于阈值:1000 万入 / 100 万出 | $150 | $150 | $0,0% |
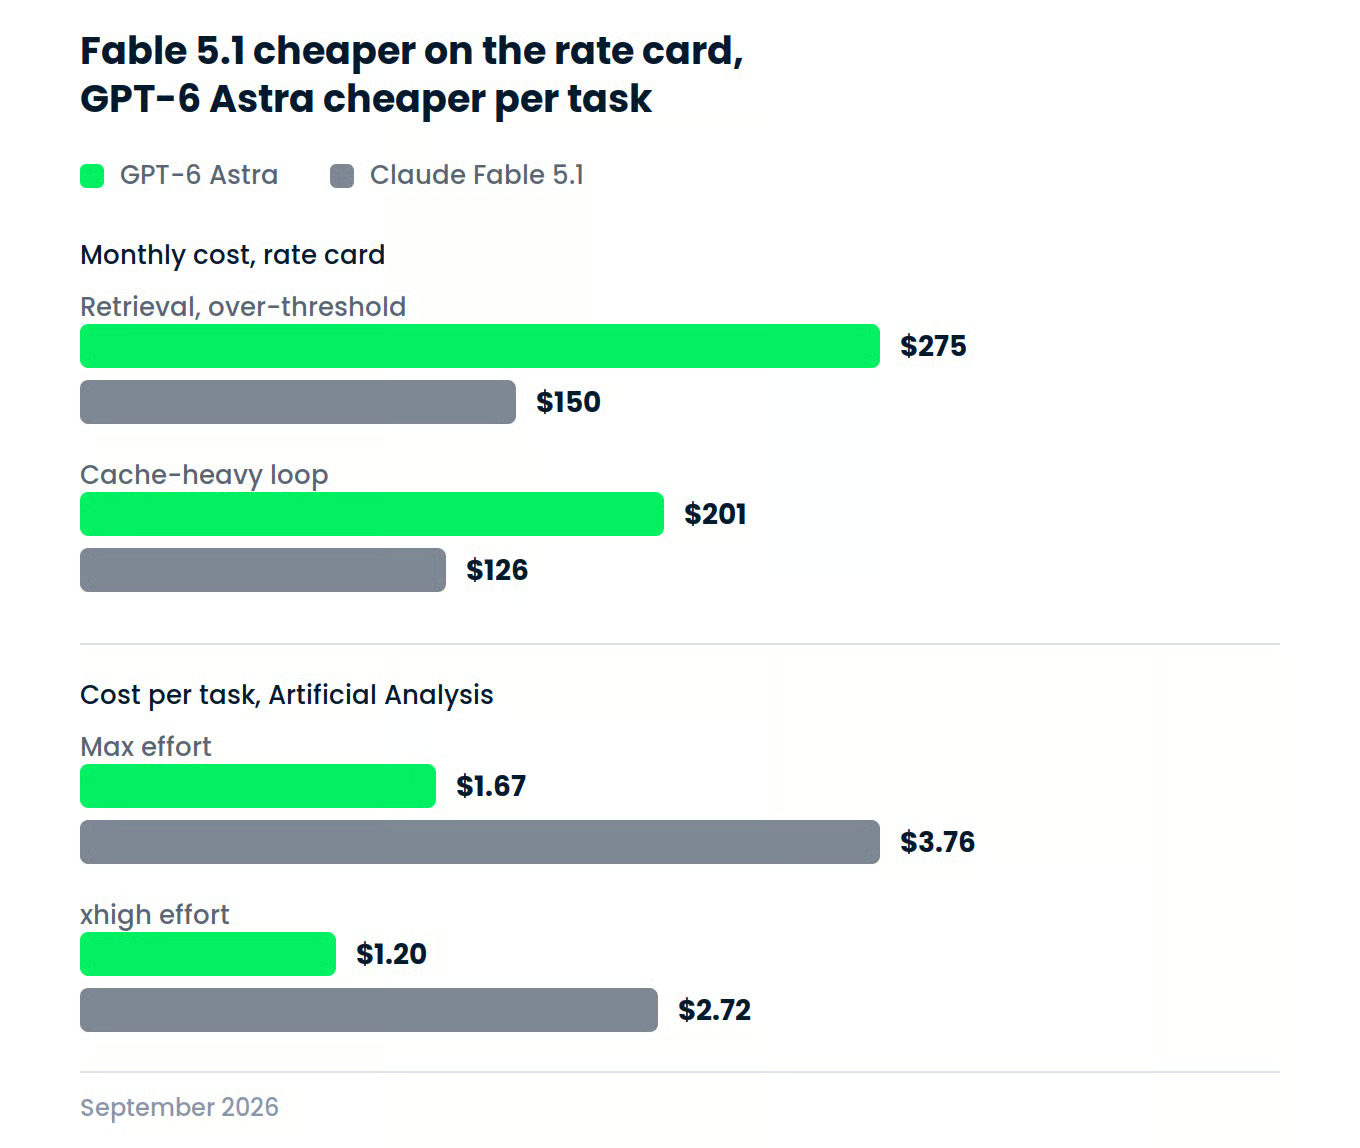
| 检索,超过阈值:1000 万入 / 100 万出 | $275 | $150 | $125,Astra 贵 83% |
| 重缓存循环:10 万前缀,读取 1000 次 | $201 | $126 | $75,Astra 贵 59% |
公式各行相同:(体量 ÷ 100 万)× 费率,并在新鲜输入、缓存读取、缓存写入与输出间求和。重缓存一行假设一次性写入 10 万前缀,随后读取 1000 次,每次请求另含 5K 新输入与 1K 输出。
超过阈值的检索是头条。将每次请求控制在 272K 输入 token 以下,两款模型的成本都恰为 $150。若把同样的 1000 万 token 以每次都超过 272K 的请求推进,Astra 会飙升至 $275,而 Fable 5.1 仍为 $150,因为 Anthropic 对完整 100 万上下文窗口按标准费率计价。
重缓存循环是大多数读者都会遇到的一类。在读取 1000 次、每次 10 万缓存 token 的规模下,每百万缓存 token $0.75 的差距,最终在相同工作负载上变成 $75 的差额。注意该负载的形态:它刻意让输出很轻,每次请求仅 1K 输出,对比 10 万缓存读取。这是 Fable 5.1 的缓存优势能决定账单的那一种形态。
一旦您测量真实的 token 消耗,而不是假设它,画面就会翻转。Artificial Analysis 为 Intelligence Index 的每个任务定价,其方法已包含输入、缓存命中、缓存写入、思考与答案 token,因此 Fable 5.1 更便宜的缓存已计入该数字。
| 努力级别 | GPT-6 Astra:分数/每任务成本 | Claude Fable 5.1:分数/每任务成本 |
|---|---|---|
| max | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
在最大努力下,Fable 5.1 针对相同任务集合的成本是 Astra 的 2.25 倍,尽管标价一致。Artificial Analysis 在其编码指数上得到同样结论:Astra 以显著的 token 效率提升,实现与 Fable 5 “不到一半成本的匹配”。若降至低努力,Astra 的每任务成本最低可至 $0.46。
这里 Fable 5.1 并非被价目表“惩罚”,而是被其输出体量所“惩罚”。Artificial Analysis 测得,在最大努力下,它使用的输出 token 约为 Fable 5 的 1.7 倍,因此尽管缓存更便宜,但其每任务成本仍较前代高出约 20%。剔除这一缓存降价影响,成本大约应为 $5.16——也就是说折扣确有实效,但不够抵消。
当然,您为此多付的钱也买到了东西。Fable 5.1 在同一指数上高出 5 分,在 xhigh 下高出 4 分。5 分值不值 2.25 倍,这取决于您;但“标价相同即账单相同”的比较思路,经不起实测的检验。
OpenAI 自家的图注也指向同样方向——就厂商自报而言。其称在 Terminal-Bench Science 0.1 上,Astra 的估算 API 每任务成本比 Fable 5.1 低约 31%;在 Terminal-Bench 4.0 上低约 63%;在 BenchCAD 上低约 86%(按 OpenAI 为各模型选取的努力设置测量)。
在我们的测试中,Astra 略胜一筹,但两款模型都在首次尝试即交付了可运行的模拟。
我选择在相同条件下,针对两款模型各跑一个高难任务,而非多个浅层任务。此次选用的是从零构建的物理模拟,以单个 HTML 文件实现;之所以选择它,是因为它正好考察了两家厂商都宣称有所提升的方面:在没有可依赖库的前提下,贯穿整个长流程的持续正确性。
这次是该测试的一个更新版本。已发布的变体使用的是旋转正方形容器;此处改为旋转六边形,中心障碍物反向旋转,并让质量与大小成正比,从而提高难度,同时保持“能否封闭容纳”这一判据的明确性。以下是提示词,已逐字逐句分别粘贴到两款模型的全新对话中:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
两款模型均设为高推理努力、各一次尝试、不重试,在同一个编码代理与相同工具链下运行。评分先看能否运行通过,再按物理正确性、30 秒稳定性与视觉质量三个维度各打 1–5 分。
Astra 通过了可运行性检查,并在三项评分维度均获 5/5。它用 6 个回合、9 次工具调用完成,工具组合颇有意思:写入文件后,回读 5 次,grep 两次,打补丁两次,最后宣布完成。
模拟是正确的:44 个球,质量随面积缩放,六边形旋转期间全程 30 秒均保持封闭。Astra 将中心障碍设置得相对较大,因此小球持续与其碰撞,而不是稳定在其触及不到的地方。
它还围绕模拟构建了完整的呈现页面:衬线标题、加字距的等宽标签,还有报告实时转速的遥测面板。没人要求这些,但依我看效果相当不错。它还提供了暂停与重启控制,提示词并未要求这些,但确实让成品更易检查。
Astra 令外壁以 0.09 rad/s 旋转、障碍以 -0.16 rad/s 旋转,外壁约比 Fable 慢 3 倍、障碍慢 5 倍。更便于观测,也较为温和地考验了移动边界。提示词要求“慢速旋转”,因此这是合格的。
| 指标 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 回合数 | 6 | 2 |
| 工具调用 | 9 | 1 |
| 可运行性 | 通过 | 通过 |
| 物理正确性 | 5 | 4 |
| 随时间稳定性 | 5 | 5 |
| 视觉质量 | 5 | 4 |
| 量表得分 | 5.0 | 4.3 |
Astra 在质量上取胜,且主要差距体现在呈现层面,而非物理表现。两者的分歧在于各自如何理解任务:Astra 把提示视作可解释的简述,加入了控制、完整的呈现布局,以及适合观看的较慢转速;Fable 则将其视作待满足的规格,一次写入即满足,并把剩余精力投入到诊断型 HUD。
这只是每个模型一次运行,因此将其视作数据点,而非基准。它记录的是回合数,而非 token 或成本;且仅考察了从零编写的模拟代码,并未覆盖上文的电脑使用或推理维度。
由于标价一致,决策取决于工作负载形态、实际 token 消耗,以及您已在用的编码代理。三个最关键的数字是:4 倍的缓存读取差距、272K 的附加费阈值、以及 2.25 倍的实测每任务成本差。
| 使用场景 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 消费级应用 | ChatGPT Plus、Pro、Business、Enterprise | Claude 网页、移动端、桌面端(Pro、Max、Team、Enterprise) |
| 官方 API | OpenAI API | Claude API |
| 云平台 | Amazon Bedrock、Microsoft Azure/Foundry | Amazon Bedrock、Google Cloud、Microsoft Azure/Foundry |
| 编码代理 | Codex | Claude Code、Cursor |
| 第三方路由 | OpenRouter、Vercel AI Gateway | OpenRouter、Vercel AI Gateway |
| API 模型 ID | gpt-6-astra |
claude-fable-5-1 |
有两条接入细节会在您首次调用前“拦住”您。Astra 在企业工作区默认关闭,需管理员开启;Fable 5.1 需要 30 天数据保留,且不支持 Priority Tier。在云上,两者覆盖大致相当,目前仅 Google Cloud 是 Fable 5.1 有而 GPT-6 Astra 暂无的平台。
各模型在自家外框中为原生:Astra 在 Codex,Fable 5.1 在 Claude Code,可用 /model claude-fable-5-1 或 --model 切换。通过 API 只需改一个字符串,不过 SDK 不同。
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
三项 Fable 5.1 的变化会让基于 Fable 5 的代码失效:强制工具选择现返回 400;早期模型无法读取其“思考”块;且“思考”块与其之前的完整历史精确绑定。我们的Claude Fable 5.1 API 教程逐一讲解了这三点;而OpenAI API 新手指南则覆盖了另一侧的等效设置。
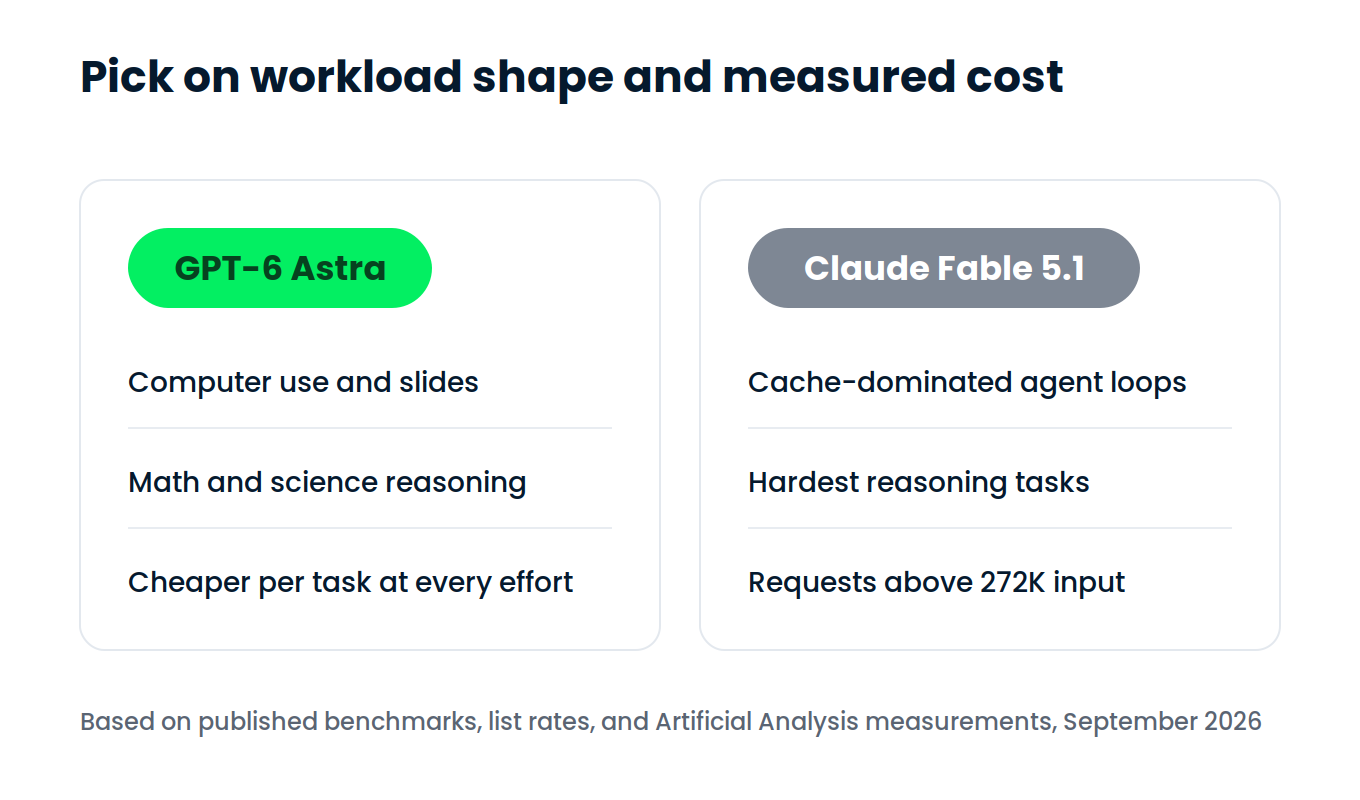
请基于工作负载形态与实测成本来选择,而非单看基准表。对于需要点击操作软件、做数学或产出可直接交付客户成品的代理,GPT-6 Astra 更强;尽管价目表一致,它看起来是每任务更便宜的那一个。Claude Fable 5.1 则提供当前最好的独立推理分数,并且在超大请求与以缓存为主导的循环上更省钱。
价目表是本次对比的“陷阱”。两款模型均为 $10 与 $50,看似价格可互换,且唯一可见差异——缓存读取——Anthropic 还便宜 4 倍。但当您测量各自为完成任务实际消耗多少时,Astra 的成本仅为 Fable 5.1 的 44%。我不会从定价页预判到这一点——而这恰是我建议您在自家流量上优先验证的单一要点。
如果您想“上手”而非“阅读”,推荐 Anthropic 方向的《Claude 模型入门》课程,以及 OpenAI 方向的《OpenAI API 实战》课程。
与 DataCamp 一起学习 AI!
课程
课程
课程