Kurs
Wprowadzenie do modeli Claude
3 godz.
14.9K
GPT-6 Astra to flagowy model graniczny OpenAI, następca GPT-5.6 Sol, zbudowany wokół wykonywania zadań przez agenta, a nie czatu. OpenAI pozycjonuje go pod kątem użycia komputera, pracy profesjonalnej i inżynierii oprogramowania, a to pierwszy model OpenAI, który przekracza próg cyberbezpieczeństwa „Critical” w firmowym Preparedness Framework. Działa w oknie kontekstowym 1 050 000 tokenów z maksymalnym wyjściem 128 tys. i ma cutoff wiedzy na 30 kwietnia 2026 r.
W ogłoszeniu wyróżniają się dwie rzeczy. W Codexie Astra prowadzi notatki między oknami kontekstu zamiast kompresować je do podsumowania, więc wcześniejsze okna pozostają przeszukiwalne, oraz decyduje, kiedy zadać pytanie doprecyzowujące, zamiast zawsze zgadywać albo zawsze pytać.
Pełną listę funkcji, tabele benchmarków i szczegóły dostępu znajdziesz w naszym przewodniku po GPT-6 Astra. Warto też czytać go równolegle z omówieniem poprzednika w GPT-5.6 Sol, Terra i Luna.
Claude Fable 5.1 to ogólnodostępny model graniczny Anthropic do wymagającego rozumowania i agentowej pracy o długim horyzoncie. Ma okno kontekstowe 1M tokenów z maksymalnym wyjściem 128 tys., adaptacyjne myślenie zawsze włączone i cutoff wiedzy na czerwiec 2026 r. Dokumentacja Anthropic ocenia jego latencję jako wolniejszą niż Claude Opus 5 i Claude Sonnet 5, oba tańsze.
Claude Mythos 5.1 to ten sam model z innymi zabezpieczeniami, dostępny na zaproszenie w ramach Project Glasswing. Najważniejsza zmiana dla pozostałych to cena odczytu z cache, obniżona o 75% do $0,25 za milion tokenów, przy niezmienionych stawkach katalogowych.
Nasz przewodnik po Claude Fable 5.1 zawiera pełny przegląd benchmarków, a w samouczku API Claude Fable 5.1 budujemy agenta deweloperskiego świadomego repozytorium, z rzeczywistym rozbiciem kosztów na poziomy wysiłku.
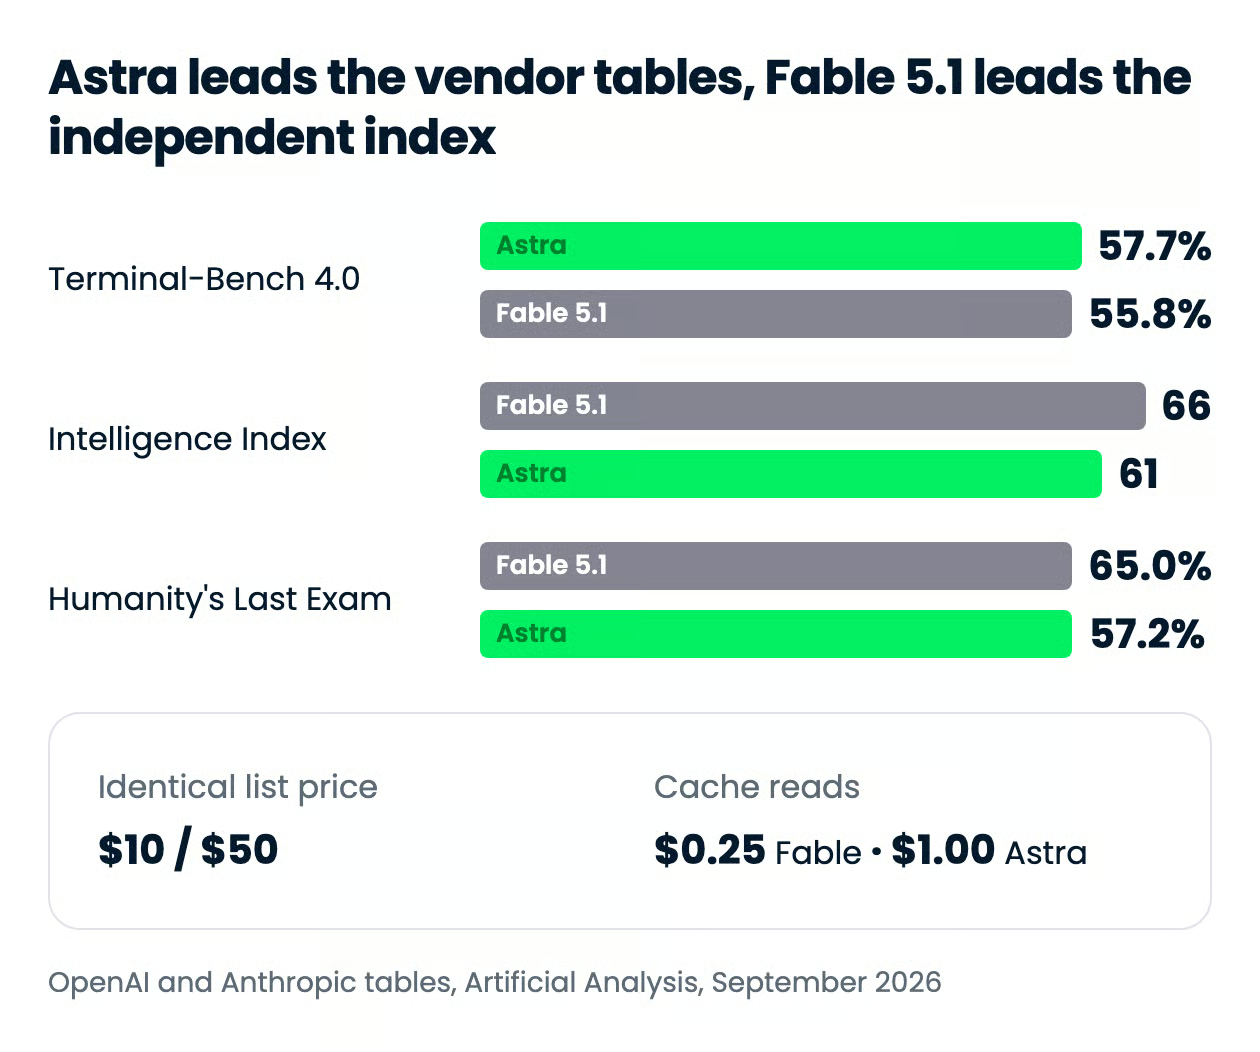
Krótko: tabela porównawcza OpenAI pokazuje Astrę przed Fable 5.1 na niemal każdym opublikowanym wierszu, a Artificial Analysis pokazuje odwrotnie na obu swoich indeksach. To, któremu wierzysz, zależy od tego, jaką wagę przywiązujesz do oceny konkurenta przez samego dostawcę.
| Funkcja | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Data wydania | 3 września 2026 | 1 września 2026 |
| ID modelu w API | gpt-6-astra |
claude-fable-5-1 |
| Okno kontekstu | 1,05M tokenów | 1M tokenów |
| Maks. wyjście | 128K tokenów | 128K tokenów |
| Cutoff wiedzy | 30 kwietnia 2026 | Czerwiec 2026 |
| Cena katalogowa za 1M tokenów | $10 wejście / $50 wyjście | $10 wejście / $50 wyjście |
| Odczyt z cache za 1M | $1,00 ($2,00 powyżej 272K) | $0,25 |
| Stawki powyżej 272K tokenów wejścia | 2x za wejście i cache, 1,5x za wyjście | Brak dopłaty |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, z narzędziami | 57,2% | 65,0% |
| ScreenSpot-Pro (bez narzędzi) | 92,7% | 87,3% (Fable 5, z Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (max effort) | 61 | 66 |
| AA koszt na zadanie z Intelligence Index (max) | $1,67 | $3,76 |
| Najmocniejszy obszar | Użycie komputera, matematyka, cyberbezpieczeństwo, koszt na zadanie | Głębia rozumowania, pętle agentowe zdominowane przez cache |
Astra prowadzi w benchmarkach kodowania, które OpenAI zdecydowało się opublikować, ale różnice są niewielkie, a niezależny indeks się z tym nie zgadza. W Terminal-Bench 4.0, który testuje inżynierię oprogramowania, konfigurację systemu i analizę danych w terminalu, OpenAI raportuje 57,7% dla Astry wobec 55,8% dla Fable 5.1. Anthropic publikuje to samo 55,8%, więc przynajmniej ten wiersz jest bezsporny.
Różnica rośnie w DeepSWE v1.1, gdzie Astra osiąga 74,1% wobec 67,4%, i niemal zanika w FrontierCode 1.1 Main, gdzie 53,3% wobec 50,9% mieści się w zakresie, który już zajmowały Claude Fable 5 (53,5%) i Claude Opus 5 (53,4%).
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Uwagi |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | Tabela OpenAI mówi 57,7%, a podpis wykresu 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | Raport OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Praktycznie remis z Fable 5 (53,5%) i Opus 5 (53,4%) |
| Wewnętrzna migracja bazy danych | 63,9% | 57,8% | Wewnętrzna ewaluacja OpenAI, brak replikacji zewnętrznej |
| CursorBench 3.2.0 | Nieopublikowane | 73,4% | Raport Anthropic; SpaceXAI potwierdziło 73,4% przy max effort |
| AA Coding Agent Index | 67 w Codex | 70 w Claude Code | Niezależne, ale różne harnessy |
Do tej ostatniej pozycji ciągle wracam. Artificial Analysis daje Fable 5.1 w Claude Code wynik 70, najwyższy na Coding Agent Index, a Astrze w Codex 67, mniej więcej na poziomie Claude Opus 5 i Claude Fable 5. Dwa zastrzeżenia warte odrobiny soli:
Astra wygrywa opublikowane wiersze kodowania o włos i bezdyskusyjnie wygrywa efektywnością, podczas gdy Fable 5.1 ma jedyny niezależny wynik agenta-kodera, który przewyższa oba.
To najczystszy podział w całym porównaniu i działa w obie strony. Astra bierze matematykę i nauki ścisłe: 97,6% kontra 87,8% na FrontierMath Tier 4 v2, 96,0% kontra 93,7% na GPQA Diamond i 64,6% kontra 52,6% na Terminal-Bench Science 0.1, agentowym benchmarku badawczym, wokół którego Anthropic budował własny launch.
Fable 5.1 wygrywa Humanity's Last Exam z narzędziami, 65,0% kontra 57,2%, i to wyraźnie. Artificial Analysis niezależnie potwierdza ten kierunek, dając Fable 5.1 wynik 66 na Intelligence Index wobec 61 dla Astry – najwyższy, jaki kiedykolwiek zmierzono.
Jedno zastrzeżenie do tych 66. Artificial Analysis uruchomiło Fable 5.1 z domyślnym fallbackiem po stronie serwera Anthropic, który kieruje żądania oznaczone bezpieczeństwem do Claude Opus 4.8 lub Claude Opus 5, i fallback obsłużył ok. 4% tokenów wyjściowych w całym indeksie. Wynik dotyczy Fable 5.1 tak, jak faktycznie będzie wywoływany przez większość osób, a nie surowego modelu w izolacji.
Jeśli twoja praca to matematyka lub nauki fizyczne na poziomie magisterskim, Astra. Jeśli to szerokie, trudne rozumowanie sondowane przez Humanity's Last Exam, Fable 5.1.
Astra dominuje w tym wymiarze, głównie dlatego, że Anthropic nie opublikował porównywalnych liczb. OpenAI raportuje 72,6% dla Astry na offline secie OSWorld 2.0 wobec 70,2% dla Claude Opus 5 oraz 92,7% na ScreenSpot-Pro wobec 87,3% dla Claude Fable 5. Własne liczby Anthropic dla Fable 5.1, 77,9% częściowe i 41,7% ścisłe, pochodzą z innej wersji zadań i oceny.
Wyniki dla artefaktów są mniej dwuznaczne: 95,9% na BenchCAD wobec 84,3% oraz 41,4% wobec 31,4% na AutomationBench.
Dla agentów, którzy klikają przez prawdziwe oprogramowanie i tworzą slajdy lub wyjście CAD, Astra to mocniejszy wybór.
Liczby dotyczące alignmentu Astry są najbardziej niedyskutowanym elementem jej premiery. Na wewnętrznym benchmarku bezpieczeństwa użycia komputera OpenAI, gdzie niżej znaczy lepiej, uzyskuje 2,4% wobec 9,5% dla Fable 5.1.
W cyberbezpieczeństwie to inna liga: 100% na ExploitBench i 86 z 226 wyzwań FrontierCyber rozwiązanych wobec 34 dla GPT-5.6 Sol w niezależnych testach Irregular. Anthropic poluzował Fable 5.1 na tyle, by znajdował podatności, ale nie je wykorzystywał.
Dwa zastrzeżenia, oba warte szczypty soli:
Astra jest zarazem bezpieczniejszym agentem i bardziej zdolnym atakującym, stąd bramkowanie.
Stawki katalogowe są identyczne, więc w cenniku jedyna różnica między tymi modelami dotyczy cache i długiego kontekstu. To ujęcie ma sens tylko wtedy, gdy oba modele zużywają tyle samo tokenów na to samo zadanie – a nie zużywają, dlatego zmierzone koszty na zadanie niżej znaczą więcej niż cennik.
| Stawka | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Wejście, za 1M tokenów | $10,00 | $10,00 |
| Wyjście, za 1M tokenów | $50,00 | $50,00 |
| Odczyt z cache, za 1M tokenów | $1,00 | $0,25 |
| Zapis do cache (5 min), za 1M tokenów | $12,50 | $12,50 |
| Rabat na batch | 50% | 50% |
| Stawki powyżej 272K tokenów wejścia | $20,00 wejście / $2,00 cache / $75,00 wyjście | Brak dopłaty |
Stawki za wejście, wyjście, zapisy do cache i rabat na batch zgadzają się co do centa. Wyjątkiem jest odczyt z cache i to aż 4x: Anthropic tnie odczyty cache Fable 5.1 do $0,25, podczas gdy OpenAI wycenia Astrę na $1,00, czyli 90% rabatu wobec stawki wejścia.
Powyżej 272 tys. tokenów wejścia różnica rośnie do 8x, bo dopłata OpenAI podwaja odczyty cache do $2,00 wraz z wejściem, podczas gdy dokumentacja cen Anthropic utrzymuje pełne 1M tokenów okna kontekstu w stawkach standardowych. Zauważ, jak nisko leży ten próg względem tego, co Astra reklamuje: 272 tys. to mniej więcej 1/4 jej 1,05M okna, więc każde żądanie wykorzystujące więcej niż 1/4 kontekstu jest rozliczane w wyższej taryfie.
Odczyty z cache to stawka, która kumuluje się w długiej pętli, bo agent na każdej turze wysyła ponownie ten sam prompt systemowy, definicje narzędzi i kontekst repozytorium. Nasz przewodnik po cache’owaniu promptów wyjaśnia mechanikę rozróżnienia zapis–odczyt cache, jeśli to dla ciebie nowe.
Wszystko w tej tabeli to arytmetyka wg stawek katalogowych przy stałym kształcie tokenów, a nie wynik pomiaru. Odpowiada na pytanie „gdyby oba modele zużyły identyczne tokeny, ile naliczyłby cennik?”. Następna sekcja odpowiada, ile faktycznie zużywają.
| Obciążenie | GPT-6 Astra | Claude Fable 5.1 | Różnica |
|---|---|---|---|
| Zbalansowany asystent: 1M wejścia / 250K wyjścia | $22,50 | $22,50 | $0, 0% |
| Retrieval, poniżej progu: 10M wejścia / 1M wyjścia | $150 | $150 | $0, 0% |
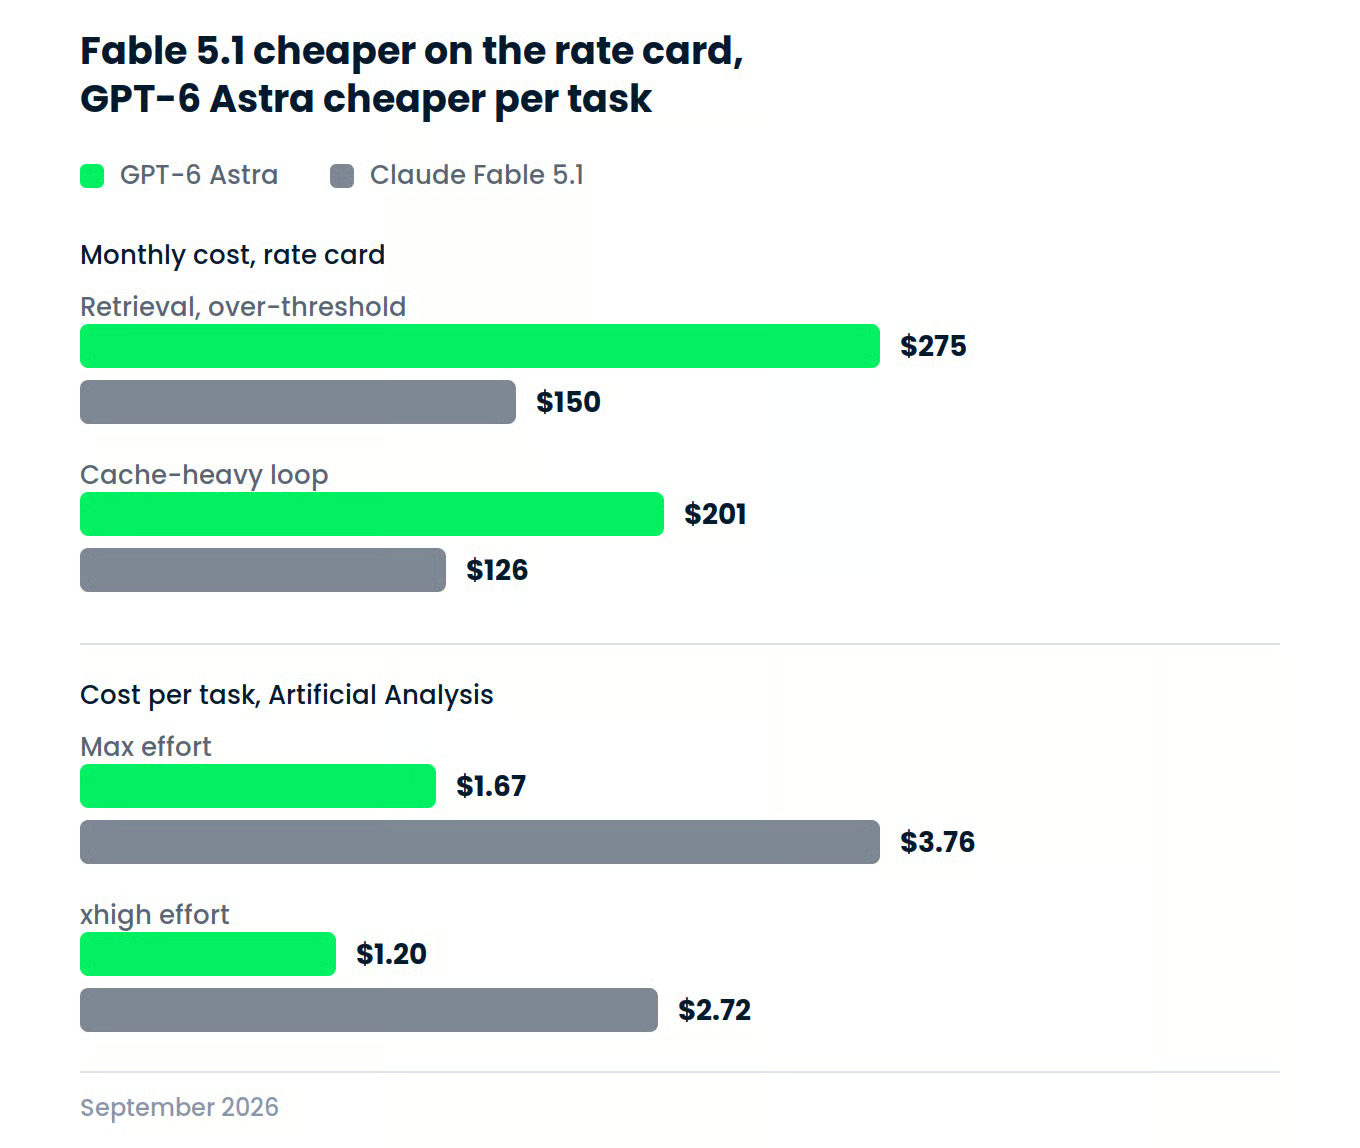
| Retrieval, powyżej progu: 10M wejścia / 1M wyjścia | $275 | $150 | $125, 83% więcej dla Astry |
| Ciężka pętla cache: prefiks 100K, 1 000 odczytów | $201 | $126 | $75, 59% więcej dla Astry |
Formuła jest ta sama dla każdego wiersza: (wolumen ÷ 1M) × stawka, zsumowane przez świeże wejście, odczyty cache, zapisy cache i wyjście. Wiersz „ciężka pętla cache” zakłada prefiks 100K zapisany raz i odczytany 1000 razy, plus 5K świeżych wejść i 1K wyjścia na żądanie.
Wiersz dot. retrieval powyżej progu to nagłówek. Trzymaj każde żądanie poniżej 272 tys. tokenów wejścia, a oba modele kosztują dokładnie $150. Przepchnij te same 10M tokenów w żądaniach, z których każde przekracza 272 tys., a Astra skacze do $275, podczas gdy Fable 5.1 zostaje na $150, bo Anthropic wycenia pełne 1M okna kontekstu w stawkach standardowych.
Ciężka pętla cache to scenariusz, który spotka większość czytelników. Przy 1000 odczytach cache prefiksu 100K różnica $0,75 za milion tokenów cache zamienia się w $75 na identycznym obciążeniu. Zwróć jednak uwagę na kształt: celowo niewielkie wyjście, 1K tokenów wyjścia na żądanie wobec 100K odczytów cache. To jedyny kształt, w którym przewaga cache Fable 5.1 decyduje o rachunku.
Gdy mierzysz rzeczywiste zużycie tokenów zamiast je zakładać, obraz się odwraca. Artificial Analysis wycenia każdy model na zadanie z Intelligence Index, a jego metoda uwzględnia już tokeny wejścia, trafienia cache, zapisu cache, rozumowania i odpowiedzi, więc tańszy cache Fable 5.1 jest wliczony w liczbę.
| Poziom wysiłku | GPT-6 Astra: wynik/koszt na zadanie | Claude Fable 5.1: wynik/koszt na zadanie |
|---|---|---|
| max | 61 / $1,67 | 66 / $3,76 |
| xhigh | 61 / $1,20 | 65 / $2,72 |
Przy max effort Fable 5.1 kosztuje 2,25 raza tyle co Astra za ten sam zestaw zadań przy tej samej cenie katalogowej. Artificial Analysis dochodzi do tego samego wniosku na swoim indeksie kodowania, gdzie Astra dorównuje Fable 5 „za mniej niż połowę kosztu, dzięki znaczącym zyskom efektywności tokenów”. Zakres Astry schodzi do $0,46 na zadanie przy low effort.
Fable 5.1 nie jest tu „karany” przez cennik, tylko przez wolumen wyjścia. Artificial Analysis zmierzyło, że zużywa ok. 1,7x tokenów wyjścia Fable 5 przy max effort, dlatego kosztuje o 20% więcej na zadanie niż poprzednik mimo cięcia cache. Gdyby to cięcie wyjąć, byłoby ok. $5,16, więc rabat robi realną robotę, tylko niewystarczającą.
Za tę premię za coś płacisz. Fable 5.1 zdobywa 5 punktów więcej na tym samym indeksie, a przy xhigh 4 punkty. Czy 5 punktów jest warte 2,25x – to już twoja decyzja, nie moja, ale wersja tego porównania, w której identyczne ceny katalogowe oznaczają identyczne rachunki, nie wytrzymuje konfrontacji z pomiarami.
Podpisy od OpenAI wskazują w tę samą stronę, na ile warto wierzyć samoocenie dostawcy. Szacują koszt API na zadanie dla Astry na ok. 31% poniżej Fable 5.1 na Terminal-Bench Science 0.1, ok. 63% poniżej na Terminal-Bench 4.0 i ok. 86% poniżej na BenchCAD, mierzone przy ustawieniach wysiłku wybranych przez OpenAI dla każdego modelu.
Astra minimalnie wygrała nasz test ogólnie, choć oba modele dostarczyły działającą symulację za pierwszym podejściem.
Uruchomiłem jedno trudne zadanie przeciw obu modelom w identycznych warunkach zamiast kilku płytkich. Wybrany test to symulacja fizyki od zera zbudowana jako pojedynczy plik HTML, bo dokładnie sprawdza to, co obaj dostawcy twierdzą, że poprawili: utrzymaną poprawność w długim buildzie, bez biblioteki jako podpórki.
Ta instancja to odświeżona wersja testu. Opublikowany wariant używał obracającego się kwadratowego kontenera, więc tym razem jest obracający się sześciokąt z przeciwnie obracającą się przeszkodą pośrodku i masą proporcjonalną do rozmiaru, co podnosi trudność, zachowując przechwytywanie jako jednoznaczne „zaliczone” lub „nie”. Oto prompt, wklejony dosłownie do świeżego czatu dla każdego modelu:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Oba modele działały przy wysokim wysiłku rozumowania, po jednej próbie bez ponowień, w tym samym agencie kodującym i z tym samym zestawem narzędzi. Ocena: najpierw pass/fail uruchamialności, potem rubryka 1–5 za poprawność fizyki, stabilność przez 30 sekund i jakość wizualną.
Astra przeszła test uruchamialności i zdobyła 5/5 na wszystkich trzech osiach rubryki. Doszła do tego w 6 turach i 9 wywołaniach narzędzi, a mieszanka narzędzi jest ciekawa: zapisała plik, odczytała go 5 razy, dwa razy zrobiła grep i dwa razy zaaplikowała łatkę, zanim ogłosiła gotowość.
Symulacja jest poprawna. 44 kule, masa skalowana z polem, przechwytywanie utrzymane przez pełne 30 sekund, gdy sześciokąt się obraca. Astra ustawiła wewnętrzną przeszkodę dużą względem komory, więc kule wciąż w nią uderzają zamiast osiąść tam, gdzie nie sięga.
Zbudowała też całą stronę redakcyjną wokół symulacji: nagłówek szeryfowy, rozstrzelone etykiety monospace i panel telemetryczny z bieżącymi prędkościami obrotu. Nikt o to nie prosił, ale moim zdaniem wygląda to całkiem dobrze. Dodała też pauzę i restart, których prompt nie wymagał, ale ułatwiły inspekcję artefaktu.
Astra obraca komorę z 0,09 rad/s, a przeszkodę z -0,16 rad/s, ok. 3 razy wolniej niż Fable na ścianie zewnętrznej i 5 razy wolniej na przeszkodzie. Łatwiej się to ogląda i to łagodniejszy test ruchomej granicy niż szybszy obrót. Ponieważ prompt prosi o wolno obracający się kontener, jest w porządku.
| Miara | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Tury | 6 | 2 |
| Wywołania narzędzi | 9 | 1 |
| Uruchamialność | Pass | Pass |
| Poprawność fizyki | 5 | 4 |
| Stabilność w czasie | 5 | 5 |
| Jakość wizualna | 5 | 4 |
| Wynik rubryki | 5,0 | 4,3 |
Astra wygrywa tu jakością, a margines jest szerszy w prezentacji niż w fizyce. Różnią się tym, co każdy model uznał za zadanie. Astra przeczytała prompt jako brief do zinterpretowania, dodając kontrolki, pełny układ redakcyjny i wolniejszy obrót, który sprzyja oglądaniu. Fable przeczytał go jako specyfikację do spełnienia, spełnił w jednym zapisie i resztę wysiłku poświęcił na diagnostyczny HUD.
To po jednym przebiegu na model, więc traktuj to jako jeden punkt danych, a nie benchmark. Raportuje tury, a nie tokeny czy koszt, i bada tylko kod symulacji od zera, a nie użycie komputera czy rozumowanie opisane wyżej.
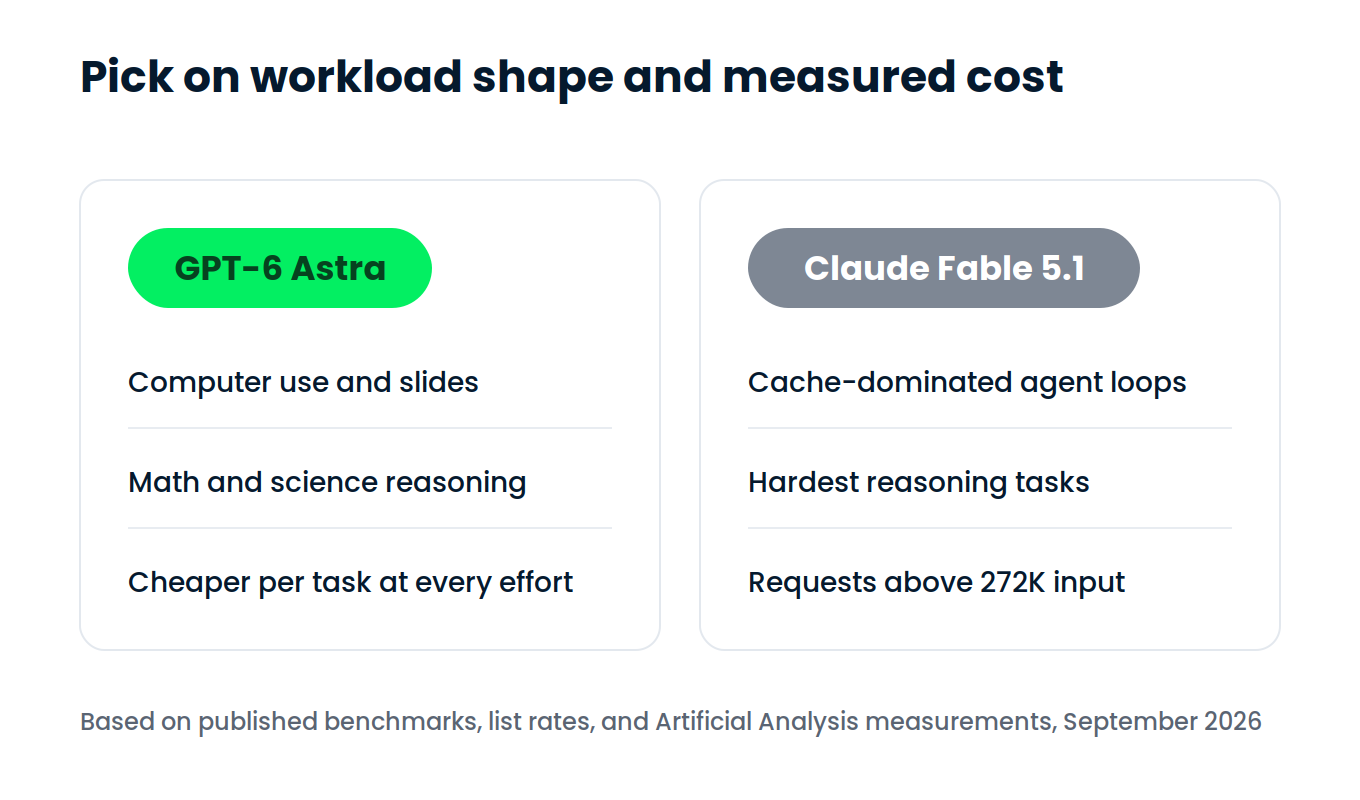
Ponieważ ceny katalogowe są zgodne, decyzja sprowadza się do kształtu obciążenia, zmierzonego zużycia tokenów i agenta-kodera, którego już używasz. Trzy liczby, które powinny cię poruszyć, to 4x różnica w odczytach cache, próg dopłaty 272 tys. i 2,25x zmierzony koszt na zadanie.
| Powierzchnia | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Aplikacja konsumencka | ChatGPT Plus, Pro, Business, Enterprise | Claude web, mobile, desktop (Pro, Max, Team, Enterprise) |
| API pierwszej strony | OpenAI API | Claude API |
| Platformy chmurowe | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Agenci do kodu | Codex | Claude Code, Cursor |
| Routery zewnętrzne | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID modelu w API | gpt-6-astra |
claude-fable-5-1 |
Dwa szczegóły dostępu mogą cię zatrzymać przed pierwszym wywołaniem. Astra jest domyślnie wyłączona dla przestrzeni enterprise, dopóki administrator jej nie włączy, a Fable 5.1 wymaga 30-dniowego przechowywania danych i nie jest wspierany na Priority Tier. Zasięg w chmurach jest zbliżony, przy czym Google Cloud to jedyna platforma, którą ma Fable 5.1, a GPT-6 Astra nie.
Każdy model jest natywny dla własnego harnessu: Astra w Codex i Fable 5.1 w Claude Code, gdzie przełączasz się poleceniem /model claude-fable-5-1 lub flagą --model. Przez API to jedna nazwa łańcucha, choć SDK się różnią.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Trzy zmiany w Fable 5.1 złamią kod pisany pod Fable 5: wymuszenie wyboru narzędzia teraz zwraca 400, wcześniejsze modele nie czytają jego bloków myślenia, a bloki myślenia są związane z dokładną historią przed nimi. Nasz samouczek API Claude Fable 5.1 przechodzi przez wszystkie trzy, a nasz przewodnik dla początkujących po OpenAI API pokazuje odpowiednią konfigurację po drugiej stronie.
Wybieraj według kształtu obciążenia i zmierzonego kosztu, a nie według tabel benchmarków. GPT-6 Astra jest silniejsza dla agentów, którzy klikają w oprogramowanie, liczą lub tworzą artefakty gotowe dla klienta, i wygląda na tańszą z tych dwóch na zadanie mimo identycznego cennika. Claude Fable 5.1 daje najwyższy dostępny niezależny wynik rozumowania i kosztuje mniej przy bardzo dużych żądaniach oraz w pętlach zdominowanych przez cache.
Cennik to pułapka w tym porównaniu. Dwa modele po $10 i $50 wyglądają cenowo zamiennie, a jedyna widoczna różnica – odczyty cache – faworyzuje Anthropic 4x. Potem mierzysz, ile każdy faktycznie wydaje, by skończyć zadanie, i Astra wychodzi na 44% kosztu Fable 5.1. Nie przewidziałbym tego z kart cen, i to jedyna rzecz, którą sprawdziłbym na twoim ruchu, zanim się zobowiążesz.
Jeśli chcesz pracować z którymś z modeli zamiast o nich czytać, polecam nasz kurs Introduction to Claude Models po stronie Anthropic oraz Working with the OpenAI API po stronie OpenAI.
Ucz się AI z DataCamp!
Kurs
Kurs
Kurs