Курс
Введение в модели Claude
3 ч
14.9K
GPT-6 Astra — флагманская модель OpenAI нового поколения, преемник GPT-5.6 Sol, разработанная вокруг агентного исполнения, а не чата. OpenAI позиционирует её для компьютерного использования, профессиональной работы и разработки ПО. Это первая модель OpenAI, пересекшая «критический» порог кибербезопасности в их Preparedness Framework. Контекстное окно — 1 050 000 токенов, максимум вывода — 128K, отсечка знаний — 30 апреля 2026 года.
В анонсе выделяются две вещи. В Codex Astra хранит заметки между окнами контекста вместо сжатия их в сводку, так что ранние окна остаются доступными для поиска; также модель решает, когда задавать уточняющий вопрос, вместо того чтобы всегда гадать или всегда спрашивать.
Полный список функций, таблицы бенчмарков и детали доступа — в нашем гиде по GPT-6 Astra. Полезно читать вместе с обзором предшественника — GPT-5.6 Sol, Terra и Luna.
Claude Fable 5.1 — доступная в общем пользовании модель Anthropic верхнего уровня для сложного рассуждения и агентной работы с длинным горизонтом. Контекстное окно — 1M токенов, максимум вывода — 128K, адаптивное «мышление» всегда включено, отсечка знаний — июнь 2026 года. В документации Anthropic её задержка оценена как выше, чем у Claude Opus 5 и Claude Sonnet 5, которые стоят дешевле.
Claude Mythos 5.1 — та же модель с иными мерами защиты, доступна по приглашению через Project Glasswing. Главная новость для остальных — цена чтения кеша: снижена на 75% до $0.25 за миллион токенов при неизменных тарифах в прайсе.
В нашем гиде по Claude Fable 5.1 — полный разбор бенчмарков, а в туториале по API Claude Fable 5.1 мы строим ориентированного на репозиторий разработческого агента с реальным разбором стоимости по уровням усилий.
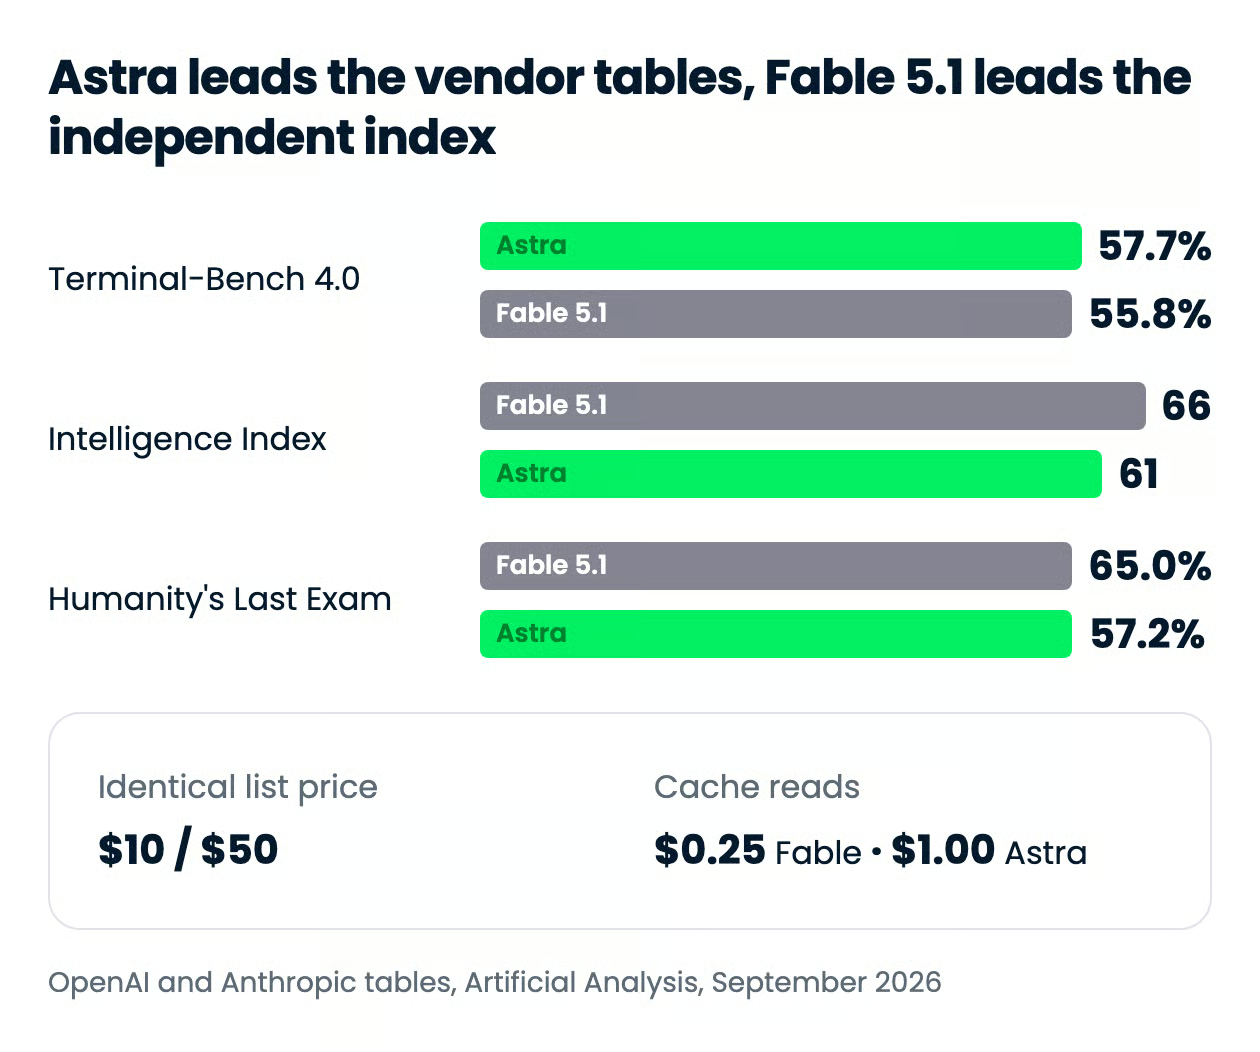
Коротко: таблица сравнения OpenAI показывает преимущество Astra над Fable 5.1 почти по всем опубликованным строкам, а Artificial Analysis демонстрирует обратное по обоим индексам. Всё зависит от того, насколько вы доверяете оценке вендора собственного конкурента.
| Характеристика | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Дата релиза | 3 сентября 2026 | 1 сентября 2026 |
| ID модели в API | gpt-6-astra |
claude-fable-5-1 |
| Окно контекста | 1.05M токенов | 1M токенов |
| Максимум вывода | 128K токенов | 128K токенов |
| Отсечка знаний | 30 апреля 2026 | Июнь 2026 |
| Список цен за 1M токенов | $10 вход / $50 выход | $10 вход / $50 выход |
| Чтение кешированных входов за 1M | $1.00 ($2.00 свыше 272K) | $0.25 |
| Ставки свыше 272K входных токенов | 2x вход и кеш, 1.5x выход | Без надбавки |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, с инструментами | 57,2% | 65,0% |
| ScreenSpot-Pro (без инструментов) | 92,7% | 87,3% (Fable 5, из Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (max effort) | 61 | 66 |
| AA стоимость задачи Intelligence Index (max) | $1.67 | $3.76 |
| Сильнейшая область | Компьютерное использование, математика, кибербезопасность, цена задачи | Глубина рассуждения, кеш‑доминируемые агентные циклы |
Astra лидирует в опубликованных OpenAI кодовых бенчмарках, но отрыв невелик, а независимый индекс не согласен. В Terminal-Bench 4.0, который тестирует разработку ПО, конфигурацию систем и анализ данных в терминале, OpenAI сообщает 57,7% у Astra против 55,8% у Fable 5.1. Anthropic публикует те же 55,8% — как минимум эта строка бесспорна.
Разрыв растёт в DeepSWE v1.1: Astra — 74,1% против 67,4%, и почти исчезает в FrontierCode 1.1 Main: 53,3% против 50,9% — в диапазоне, где уже находились Claude Fable 5 (53,5%) и Claude Opus 5 (53,4%).
| Бенчмарк | GPT-6 Astra | Claude Fable 5.1 | Примечания |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | В таблице OpenAI указано 57,7%, а в подписи к графику — 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | По данным OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Фактически на уровне Fable 5 (53,5%) и Opus 5 (53,4%) |
| Внутренняя миграция БД | 63,9% | 57,8% | Внутренняя оценка OpenAI, без внешнего повторения |
| CursorBench 3.2.0 | Не опубликовано | 73,4% | По данным Anthropic; SpaceXAI подтвердил 73,4% на max effort |
| AA Coding Agent Index | 67 в Codex | 70 в Claude Code | Независимый, но разные каркасы |
Последняя строка — к ней всё сводится. Artificial Analysis даёт Fable 5.1 в Claude Code 70 — лучший результат в их Coding Agent Index, а Astra в Codex — 67, примерно на уровне Claude Opus 5 и Claude Fable 5. Два важных оговорки:
Astra выигрывает опубликованные строки по кодингу с минимальным перевесом и уверенно побеждает по эффективности, тогда как Fable 5.1 удерживает единственную независимую оценку кодового агента, превосходящую их обеих.
Это самое чёткое расхождение в сравнении — и в обе стороны. Astra берёт математику и естественные науки: 97,6% против 87,8% в FrontierMath Tier 4 v2, 96,0% против 93,7% в GPQA Diamond и 64,6% против 52,6% в Terminal-Bench Science 0.1 — агентном научном бенчмарке, вокруг которого строился запуск Anthropic.
Fable 5.1 выигрывает Humanity's Last Exam с инструментами — 65,0% против 57,2%, и отрыв значителен. Artificial Analysis независимо подтверждает направление: 66 баллов по Intelligence Index против 61 у Astra — это их рекорд.
Оговорка к этим 66. Artificial Analysis запускала Fable 5.1 с серверным fallback по умолчанию Anthropic, который маршрутизирует запросы с флагами безопасности в Claude Opus 4.8 или Claude Opus 5, и на fallback пришлось около 4% выходных токенов по индексу. Оценка отражает именно Fable 5.1, как его будут реально вызывать, а не модель в изоляции.
Если ваша работа — математика или естественные науки на уровне магистратуры, берите Astra. Если это широкий, сложный тип рассуждений уровня Humanity's Last Exam — Fable 5.1.
Astra уверенно лидирует здесь, в основном потому, что Anthropic не опубликовал сопоставимых чисел. OpenAI сообщает 72,6% у Astra на офлайн‑наборе OSWorld 2.0 против 70,2% у Claude Opus 5 и 92,7% на ScreenSpot-Pro против 87,3% у Claude Fable 5. Цифры самого Anthropic для Fable 5.1 — 77,9% (partial) и 41,7% (strict) — получены на иной версии задач и ином грейдинге.
По артефактам неоднозначности меньше: 95,9% на BenchCAD против 84,3% и 41,4% против 31,4% на AutomationBench.
Для агентов, которые кликают по реальному софту и выдают слайды или CAD, сильнее Astra.
Числа Astra по выравниванию — самый недооценённый аспект запуска. В внутреннем бенчмарке OpenAI по безопасности компьютерного использования, где меньше — лучше, у Astra 2,4% против 9,5% у Fable 5.1.
В кибербезопасности — иной уровень: 100% на ExploitBench и 86 из 226 задач FrontierCyber против 34 у GPT-5.6 Sol по независимому тестированию Irregular. Anthropic ослабил Fable 5.1 настолько, чтобы находить уязвимости, но не эксплуатировать их.
Две солидные оговорки:
Astra одновременно и безопаснее как агент, и сильнее как атакующий — отсюда и ограничения доступа.
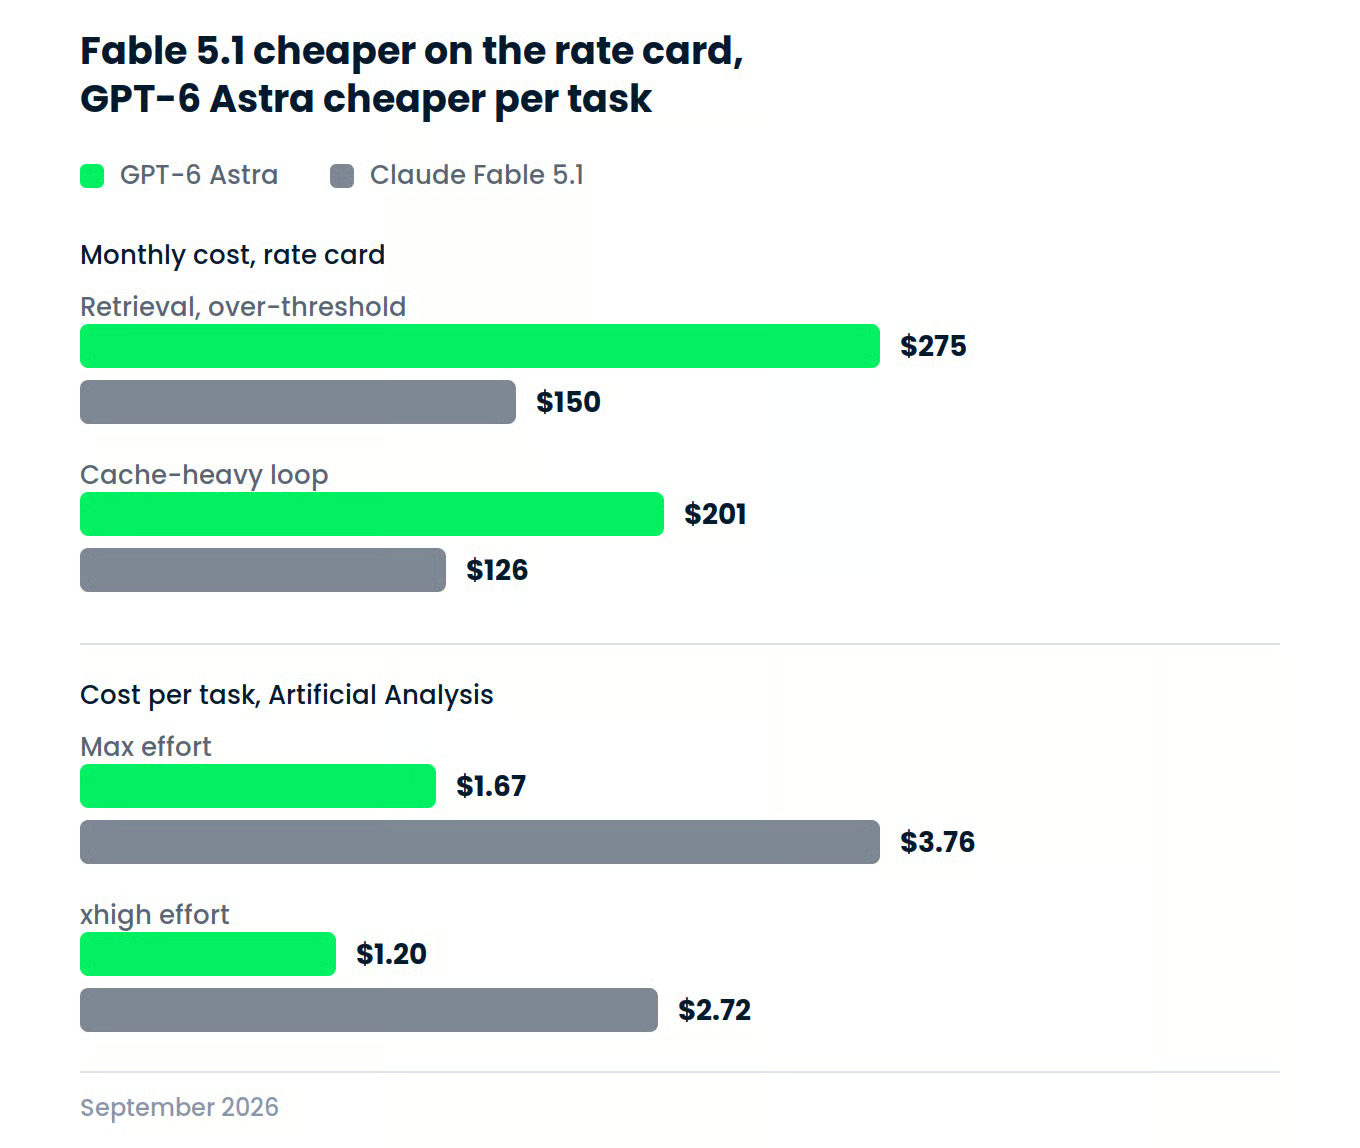
Список ставок идентичен, так что в тарифной сетке разница между моделями — только в кешировании и длинном контексте. Но это верно лишь если обе модели тратят одинаковое число токенов на одну и ту же задачу. Они так не делают — поэтому измеренные показатели «цена задачи» ниже важнее прайс-листа.
| Ставка | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Вход, за 1M токенов | $10.00 | $10.00 |
| Выход, за 1M токенов | $50.00 | $50.00 |
| Чтение кеша, за 1M токенов | $1.00 | $0.25 |
| Запись в кеш (5 минут), за 1M токенов | $12.50 | $12.50 |
| Скидка на батчи | 50% | 50% |
| Ставки свыше 272K входных токенов | $20.00 вход / $2.00 кеш / $75.00 выход | Без надбавки |
Вход, выход, записи кеша и скидка на батчи совпадают до цента. Исключение — строка про чтение кеша, и там разрыв 4x: Anthropic снижает чтения кеша у Fable 5.1 до $0.25, тогда как у Astra — $1.00, что уже составляет скидку 90% от входной ставки.
Свыше 272K входных токенов разрыв растёт до 8x, поскольку надбавка OpenAI удваивает чтения кеша до $2.00 вместе со входом, тогда как документы по ценам Anthropic оставляют полное окно в 1M токенов по стандартным ставкам. Обратите внимание, насколько низок порог относительно заявленного окна Astra: 272K — примерно четверть её собственного окна 1.05M, так что любой запрос, использующий больше четверти контекста, тарифицируется по повышенной ставке.
Чтения кеша — ставка, которая накапливается по длинному циклу, потому что агент на каждом шаге пересылает один и тот же системный промпт, определения инструментов и контекст репозитория. Наш гид по кешированию промптов объясняет механику различия «запись в кеш — чтение из кеша», если это для вас ново.
Все цифры в этой таблице — арифметика по прайсу при фиксированной форме токенов, а не измерение. Это ответ на вопрос: «если обе модели потратят одинаковые токены, что насчитает прайс?». В следующем разделе — что они тратят на деле.
| Нагрузка | GPT-6 Astra | Claude Fable 5.1 | Разница |
|---|---|---|---|
| Сбалансированный ассистент: 1M вход / 250K выход | $22.50 | $22.50 | $0, 0% |
| Retrieval, ниже порога: 10M вход / 1M выход | $150 | $150 | $0, 0% |
| Retrieval, выше порога: 10M вход / 1M выход | $275 | $150 | $125, на 83% дороже у Astra |
| Кеш‑тяжёлый цикл: префикс 100K, 1 000 чтений | $201 | $126 | $75, на 59% дороже у Astra |
Формула одинакова: (объём ÷ 1M) × ставка, суммируем по свежему входу, чтениям кеша, записям кеша и выходу. В кеш‑тяжёлом ряду предполагается префикс 100K, записанный один раз и прочитанный 1 000 раз, плюс 5K свежего входа и 1K вывода на запрос.
Строка про retrieval выше порога — главная. Держите каждый запрос ниже 272K входных токенов — и обе модели стоят ровно $150. Протолкните те же 10M токенов в запросах, каждый из которых превышает 272K, — и Astra вырастает до $275, тогда как Fable 5.1 остаётся на $150, потому что Anthropic тарифирует полное окно в 1M токенов по стандарту.
Кеш‑тяжёлый цикл — сценарий, с которым столкнётся большинство читателей. При 1 000 чтениях кеша 100K префикса разница $0.75 за миллион кешированных токенов превращается в $75 на идентичной нагрузке. Но обратите внимание на форму: она намеренно «лёгкая» по выводу — 1K выходных токенов на запрос против 100K чтений кеша. Это ровно тот сценарий, где преимущество Fable 5.1 по кешу определяет счёт.
Если измерять реальное потребление токенов, а не предполагать его, картина переворачивается. Artificial Analysis считает цену каждой модели за задачу Intelligence Index, и их метод уже включает вход, попадания в кеш, записи кеша, токены рассуждения и ответа — то есть более дешёвый кеш Fable 5.1 уже «зашит» в число.
| Уровень усилий | GPT-6 Astra: баллы/цена задачи | Claude Fable 5.1: баллы/цена задачи |
|---|---|---|
| max | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
На max effort Fable 5.1 стоит в 2,25 раза дороже, чем Astra, за тот же набор задач при одинаковом прайсе. Artificial Analysis приходит к тому же выводу и в кодовом индексе: Astra сопоставима с Fable 5 «менее чем за половину стоимости, благодаря значительному росту токенной эффективности». Диапазон Astra доходит до $0.46 за задачу на низком уровне усилий.
Здесь Fable 5.1 «штрафует» не прайс-лист, а объём вывода. Artificial Analysis измерила, что на max effort он использует около 1,7x выходных токенов по сравнению с Fable 5, поэтому и стоит на 20% больше за задачу, несмотря на удешевление кеша. Уберите скидку — было бы около $5.16, то есть дисконт работает, просто его недостаточно.
Вы платите этот «премиум» не просто так. Fable 5.1 набирает на 5 баллов больше на том же индексе и на 4 балла больше на xhigh. Стоит ли 5 баллов в 2,25 раза — решать вам, но версия сравнения, где одинаковые прайсы означают одинаковые счета, не выдерживает соприкосновения с измерениями.
Подписи самих OpenAI указывают в ту же сторону, насколько бы вы им ни доверяли: по их оценке, примерная стоимость API за задачу у Astra ниже Fable 5.1 примерно на 31% в Terminal-Bench Science 0.1, примерно на 63% в Terminal-Bench 4.0 и примерно на 86% в BenchCAD — при выбранных ими же настройках усилий для каждой модели.
В нашем тесте Astra немного выиграла в целом, хотя обе модели с первого раза выдали рабочую симуляцию.
Мы прогнали одну сложную задачу для обеих моделей в идентичных условиях вместо нескольких поверхностных. Тест — физическая симуляция «с нуля» в одном HTML‑файле, выбранная потому, что она проверяет именно то, что оба вендора заявляли как улучшенное: устойчивую корректность на длинной сборке без опоры на библиотеку.
Эта итерация — освежённая версия теста. В опубликованном варианте контейнер был вращающимся квадратом, здесь мы заменили его на вращающийся шестиугольник с противовращающимся центральным препятствием и массой, пропорциональной размеру, — это усложняет задачу, сохраняя критерий удержания внутри как однозначный проход/провал. Вот промпт, вставленный дословно в новый чат для каждой модели:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Обе модели запускались на высоком уровне рассуждения, по одной попытке без ретраев, в одном и том же кодовом агенте с одинаковыми инструментами. Сначала — проверка запускаемости (pass/fail), затем рубрика 1–5 по корректности физики, стабильности за 30 секунд и визуальному качеству.
Astra прошла проверку запускаемости и набрала 5/5 по всем трём пунктам. Ей понадобилось 6 ходов и 9 вызовов инструментов, и самое интересное — комбинация инструментов: запись файла, 5 чтений, 2 grep и 2 патча перед финалом.
Симуляция корректна. 44 шара, масса масштабируется по площади, удержание внутри камеры в течение всех 30 секунд при вращающемся шестиугольнике. Astra сделала внутреннее препятствие крупным относительно камеры, так что шары продолжают с ним сталкиваться, а не оседают там, где оно их не достанет.
Она также построила полноценную редакционную страницу вокруг симуляции: засечный заголовок, моноширинные подписи с кернингом и панель телеметрии с живыми скоростями вращения. Никто этого не просил, но выглядит достойно. Поставила и управление паузой и рестартом — чего промпт не запрашивал, но это упростило инспекцию артефакта.
Astra вращает камеру со скоростью 0,09 рад/с, а препятствие — −0,16 рад/с — примерно в 3 раза медленнее по внешней стенке и в 5 раз медленнее по препятствию, чем у Fable. Смотреть удобнее, и это более щадящая проверка движущейся границы. Поскольку в промпте просили медленное вращение, всё корректно.
| Метрика | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Ходов | 6 | 2 |
| Вызовов инструментов | 9 | 1 |
| Запускаемость | Pass | Pass |
| Корректность физики | 5 | 4 |
| Стабильность во времени | 5 | 5 |
| Визуальное качество | 5 | 4 |
| Оценка по рубрике | 5.0 | 4.3 |
Astra выигрывает по качеству, и разрыв сильнее в подаче, чем в физике. Ключевое различие — в том, как модели поняли задачу. Astra прочитала промпт как бриф для интерпретации, добавив элементы управления, полноценный редакционный макет и более медленное вращение, удобное для наблюдения. Fable воспринял его как ТЗ, выполнил одной записью и оставшееся усилие потратил на диагностический HUD.
Это единичный прогон на модель, так что воспринимайте как один датапоинт, а не бенчмарк. Мы фиксируем ходы, а не токены или стоимость, и тестируем только симуляцию «с нуля», а не аспекты компьютерного использования или рассуждения из разделов выше.
Поскольку прайсы совпадают, решение упирается в форму нагрузки, измеренное потребление токенов и уже используемого кодового агента. Три числа, на которые стоит смотреть: 4x разрыв в чтении кеша, порог 272K и 2,25x измеренная цена задачи.
| Площадка | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Пользовательское приложение | ChatGPT Plus, Pro, Business, Enterprise | Веб, мобильное и десктоп‑приложения Claude (Pro, Max, Team, Enterprise) |
| Собственный API | OpenAI API | Claude API |
| Облачные платформы | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Кодовые агенты | Codex | Claude Code, Cursor |
| Сторонние роутеры | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID модели в API | gpt-6-astra |
claude-fable-5-1 |
Две детали доступа могут остановить вас перед первым вызовом. Astra изначально выключена для корпоративных рабочих пространств — администратору нужно её включить. Fable 5.1 требует 30‑дневного хранения данных и не поддерживается на Priority Tier. По облакам паритет близок: единственная платформа, где сейчас есть Fable 5.1, а GPT-6 Astra нет, — Google Cloud.
Каждая модель «родная» для своего каркаса: Astra — для Codex, Fable 5.1 — для Claude Code; переключение — через /model claude-fable-5-1 или флаг --model. Через API это одна строка, хотя SDK различаются.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Три изменения в Fable 5.1 сломают код под Fable 5: принудительный выбор инструмента теперь возвращает 400, ранние модели не читают его блоки «мышления», а сами блоки привязаны к точной предшествующей истории. В туториале по API Claude Fable 5.1 мы разбираем все три, а в руководстве для начинающих по OpenAI API — эквивалентную настройку с другой стороны.
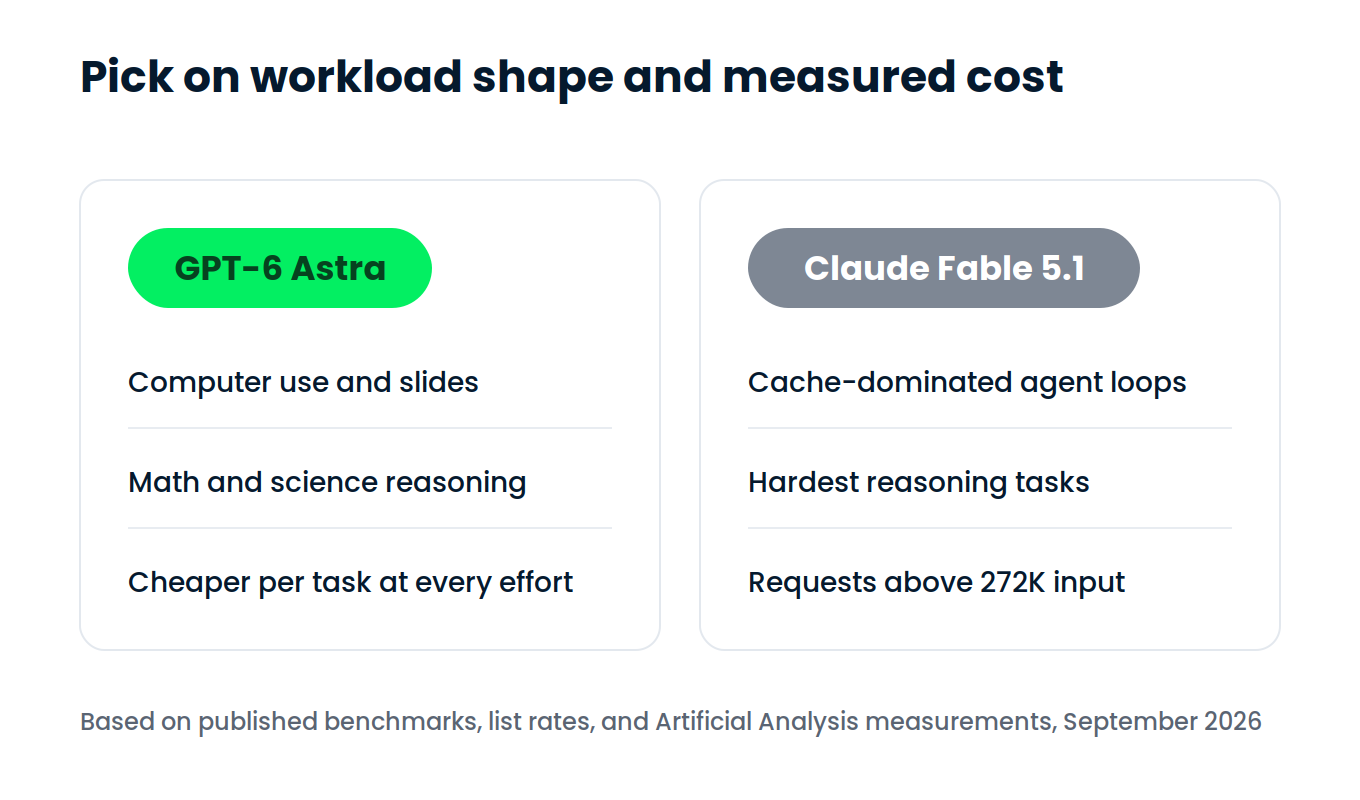
Выбирайте по форме нагрузки и измеренной стоимости, а не по таблицам бенчмарков. GPT-6 Astra сильнее для агентов, которые кликают по софту, решают математику или создают готовые для клиента артефакты, и выглядит дешевле за задачу, несмотря на одинаковый прайс. Claude Fable 5.1 даёт лучший независимый балл по рассуждению и обходится дешевле на очень больших запросах и в кеш‑доминируемых циклах.
Прайс — ловушка в этом сравнении. Две модели по $10 и $50 кажутся взаимозаменяемыми по цене, и единственный видимый разрыв — чтения кеша — в 4 раза в пользу Anthropic. Но стоит померить, сколько каждая реально тратит, чтобы завершить задачу, — и Astra выходит на 44% стоимости Fable 5.1. Это нельзя было предсказать по ценовым страницам, и это единственное, что я бы проверил на своём трафике, прежде чем выбирать.
Если хотите работать с моделями на практике, а не читать о них, рекомендуем наш курс Introduction to Claude Models по стороне Anthropic и Working with the OpenAI API по стороне OpenAI.
Учитесь ИИ вместе с DataCamp!
Курс
Курс
Курс