コース
Claude モデル入門
3時間
14.9K
GPT-6 Astra は OpenAI の最前線フラグシップモデルで、GPT-5.6 Sol の後継です。チャットではなくエージェント実行を中核に据え、コンピュータ操作、プロフェッショナルワーク、ソフトウェアエンジニアリングに重点を置いています。OpenAI の Preparedness Framework で同社として初めてサイバーセキュリティの「Critical」閾値を超えました。コンテキストウィンドウは 1,050,000 トークン、最大出力は 128K、知識カットオフは 2026年4月30日です。
発表で際立った点は2つあります。Codex において Astra は、コンテキストウィンドウ間のメモを要約に圧縮せずに保持するため、過去のウィンドウが検索可能なまま残ります。また、常に推測したり常に質問したりするのではなく、明確化の質問を「いつ」行うかを自ら判断します。
機能一覧、ベンチマーク表、アクセス方法の詳細はGPT-6 Astra ガイドをご覧ください。あわせて、前世代モデルの解説であるGPT-5.6 Sol/Terra/Lunaも読む価値があります。
Claude Fable 5.1 は、厳しい推論や長期的なエージェント作業に向けた Anthropic の一般提供フロンティアモデルです。1M トークンのコンテキストウィンドウ、最大 128K 出力、常時オンの適応的思考、そして 2026年6月の知識カットオフを備えています。Anthropic のドキュメントでは、同価格帯より下位の Claude Opus 5 および Claude Sonnet 5 と比較してレイテンシが遅いとされています。
Claude Mythos 5.1 は同一モデルに異なるセーフガードを施したもので、Project Glasswing を通じた招待制で提供されます。一般ユーザーにとっての目玉の変更はキャッシュ読み出し価格で、100万トークンあたり $0.25 へと 75% 引き下げられ、公称単価は据え置かれました。
Claude Fable 5.1 ガイドではベンチマークの全内訳を、Claude Fable 5.1 API チュートリアルでは、実際のコスト内訳を含むリポジトリ認識型の開発者エージェントの構築を扱っています。
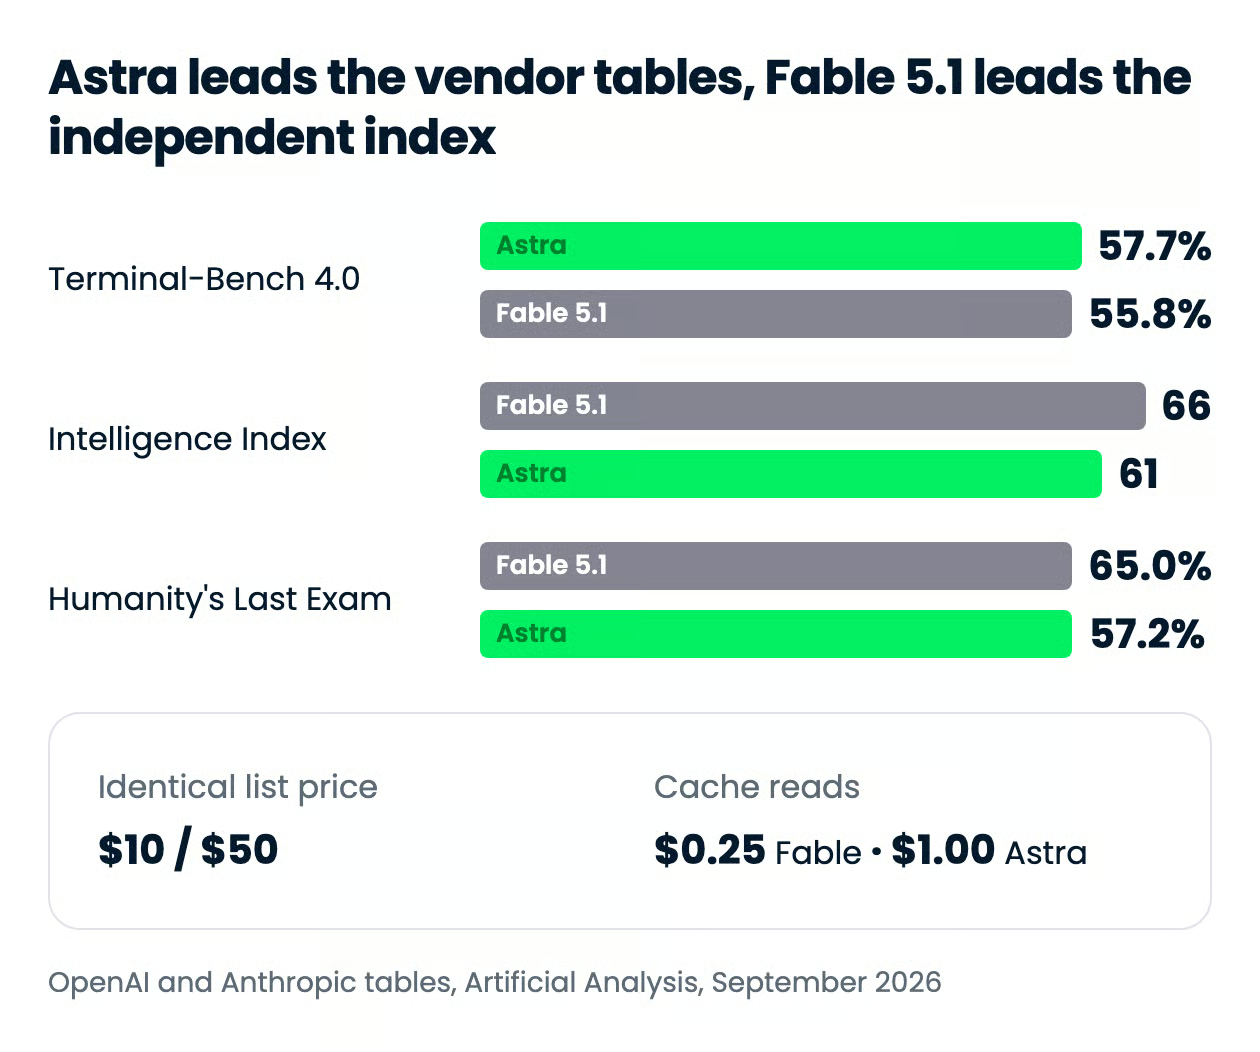
短く言えばこうです。OpenAI の比較表では、公開されたほぼすべての行で Astra が Fable 5.1 を上回り、Artificial Analysis ではその逆で、同社の2つの指数の両方で Fable 5.1 が上位です。どちらを信じるかは、競合他社を評価するベンダー自身のスコアにどれだけ重みを置くかによります。
| 機能 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| リリース日 | 2026年9月3日 | 2026年9月1日 |
| API モデル ID | gpt-6-astra |
claude-fable-5-1 |
| コンテキストウィンドウ | 1.05M トークン | 1M トークン |
| 最大出力 | 128K トークン | 128K トークン |
| 知識カットオフ | 2026年4月30日 | 2026年6月 |
| 100万トークンあたりのリスト価格 | $10(入力) / $50(出力) | $10(入力) / $50(出力) |
| 100万トークンあたりのキャッシュ読み出し | $1.00(272K 超で $2.00) | $0.25 |
| 272K 入力トークン超のレート | 入力とキャッシュ 2倍、出力 1.5倍 | サーチャージなし |
| FrontierMath Tier 4(v2) | 97.6% | 87.8% |
| Humanity's Last Exam(ツールあり) | 57.2% | 65.0% |
| ScreenSpot-Pro(ツールなし) | 92.7% | 87.3%(Mythos 由来の Fable 5) |
| AutomationBench | 41.4% | 31.4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index(最大努力) | 61 | 66 |
| AA:Intelligence Index タスクあたりコスト(最大) | $1.67 | $3.76 |
| 最も強い分野 | コンピュータ操作、数学、サイバーセキュリティ、タスク単価 | 推論の深さ、キャッシュ支配のエージェントループ |
Astra は OpenAI が公開したコーディング系ベンチマークでリードしていますが、その差は小さく、独立指数は異なる結論です。ターミナルでのソフトウェア開発、システム構成、データ分析を試す Terminal-Bench 4.0 では、OpenAI は Astra 57.7%、Fable 5.1 55.8% と報告。Anthropic も同じ 55.8% を公表しており、この行は少なくとも一致しています。
差が広がるのは DeepSWE v1.1 で、Astra 74.1% に対し 67.4%。一方で FrontierCode 1.1 Main では 53.3% と 50.9% と差は小さく、Claude Fable 5(53.5%)や Claude Opus 5(53.4%)のレンジ内に収まります。
| ベンチマーク | GPT-6 Astra | Claude Fable 5.1 | 注記 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.7% | 55.8% | OpenAI の表は 57.7%、同社の図表キャプションは 57.9% |
| DeepSWE v1.1 | 74.1% | 67.4% | OpenAI 公表値 |
| FrontierCode 1.1 Main | 53.3% | 50.9% | Fable 5(53.5%)と Opus 5(53.4%)と実質同水準 |
| 内部 DB マイグレーション | 63.9% | 57.8% | OpenAI 内部評価(外部再現なし) |
| CursorBench 3.2.0 | 未公表 | 73.4% | Anthropic 公表値;SpaceXAI が最大努力で 73.4% を確認 |
| AA Coding Agent Index | Codex で 67 | Claude Code で 70 | 独立評価だがハーネスが異なる |
最後の行が特に重要です。Artificial Analysis は、Coding Agent Index で Claude Code の Fable 5.1 を 70(同指数の最高スコア)、Codex の Astra を 67 と評価し、概ね Claude Opus 5 と Claude Fable 5 と同水準としています。ここで注意すべき点が2つあります。
公開済みのコーディング行では Astra が僅差で勝ち、効率では明確に勝利。一方で独立のコーディングエージェント指標で両者を上回る唯一のスコアは Fable 5.1 が持ちます。
この領域の分かれ方は最も明確で、しかも両方向に振れます。数学・科学では Astra が優位。FrontierMath Tier 4 v2 で 97.6% 対 87.8%、GPQA Diamond で 96.0% 対 93.7%、そして Anthropic が自身のローンチで強調したエージェント型リサーチの Terminal-Bench Science 0.1 で 64.6% 対 52.6%。
一方で Fable 5.1 は Humanity's Last Exam(ツールあり)で 65.0% 対 57.2% と大差で勝利。Artificial Analysis の独立評価もこれに沿い、Intelligence Index で Fable 5.1 が 66、Astra が 61(過去最高スコア)としています。
この 66 には注意点があります。Artificial Analysis は、Anthropic のデフォルトのサーバーサイド・フォールバック(安全性でフラグが立つと Claude Opus 4.8 または Claude Opus 5 に迂回)を有効にしており、指数全体で出力トークンの約4%をフォールバックが担いました。多くの利用者が実際に呼び出す形での Fable 5.1 のスコアであり、素のモデル単独の数値ではありません。
大学院レベルの数学や理科系の仕事なら Astra。Humanity's Last Exam が測るような広範で難度の高い推論なら Fable 5.1 です。
ここは Astra の独壇場で、主に Anthropic が比較可能な数値を公開していないためです。OpenAI は OSWorld 2.0 のオフラインセットで Astra 72.6%、Claude Opus 5 が 70.2%、ScreenSpot-Pro で 92.7%(Claude Fable 5 は 87.3%)と公表。Anthropic の Fable 5.1 の数値(partial 77.9%、strict 41.7%)は、タスクのリリースや採点設定が異なります。
アーティファクトの数値はより明確です。BenchCAD が 95.9% 対 84.3%、AutomationBench が 41.4% 対 31.4%。
実際のソフトウェアをクリックで操作し、スライドや CAD 出力を作るエージェントなら、Astra が優位です。
Astra のアライメント指標は、ローンチ時に最も過小評価された部分かもしれません。OpenAI 内部のコンピュータ使用に関する安全性ベンチマーク(低いほど良い)では、Astra 2.4% に対し Fable 5.1 は 9.5%。
サイバーセキュリティでは別次元です。ExploitBench で 100%、Irregular の独立テストでは、FrontierCyber の 226 課題中 86 を解決(GPT-5.6 Sol は 34)。Anthropic は、脆弱性の発見は許しつつ、悪用まではできないよう Fable 5.1 を調整しています。
ただし注意点が2つあり、いずれも留意すべきです。
つまり Astra は、より安全なエージェントであると同時に、より強力な攻撃者でもあるため、ゲーティングがかかっています。
公称レートは同じなので、レート表上の違いはキャッシュと長文脈のみです。ただしこの見方が成り立つのは、両モデルが同一タスクで同じトークン量を費やす場合に限られます。実際はそうではありません。だからこそ、この先に示す実測のタスク単価の方が、レート表より重要なのです。
| レート | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 入力(100万トークンあたり) | $10.00 | $10.00 |
| 出力(100万トークンあたり) | $50.00 | $50.00 |
| キャッシュ読み出し(100万トークンあたり) | $1.00 | $0.25 |
| キャッシュ書き込み(5分、100万トークンあたり) | $12.50 | $12.50 |
| バッチ割引 | 50% | 50% |
| 272K 入力トークン超のレート | $20.00(入力) / $2.00(キャッシュ) / $75.00(出力) | サーチャージなし |
入力、出力、キャッシュ書き込み、バッチ割引はセント単位まで一致。例外はキャッシュ読み出しで、ここは 4倍の差があります。Anthropic は Fable 5.1 のキャッシュ読み出しを $0.25 に設定し、OpenAI は Astra を $1.00(入力の 90% 割引)に設定しています。
272K 入力トークンを超えると差は 8倍に拡大します。OpenAI のサーチャージは入力と同時にキャッシュ読み出しも $2.00 に倍化する一方、Anthropic の料金ドキュメントでは 1M トークンのフル文脈でも標準単価のままです。Astra が宣伝するコンテキストに対してこの閾値がいかに低いかにも注目してください。272K は 1.05M の約4分の1であり、提供コンテキストの4分の1超を使うリクエストはすべて高い階層で請求されます。
長いループで複利的に効いてくるのはキャッシュ読み出しです。エージェントは各ターンで同じシステムプロンプト、ツール定義、リポジトリ文脈を送り直すからです。キャッシュの書き込みと読み出しの違いの仕組みは、プロンプトキャッシングのガイドをご参照ください。
この表はすべて、固定トークン形状に対する公称レートの四則演算であり、実測値ではありません。「両モデルが同じトークンを消費した場合、レート表ではいくら請求されるか?」という問いに答えます。次の節では、実際に消費する量を扱います。
| ワークロード | GPT-6 Astra | Claude Fable 5.1 | 差分 |
|---|---|---|---|
| バランス型アシスタント:1M 入力 / 250K 出力 | $22.50 | $22.50 | $0、0% |
| 検索(閾値未満):10M 入力 / 1M 出力 | $150 | $150 | $0、0% |
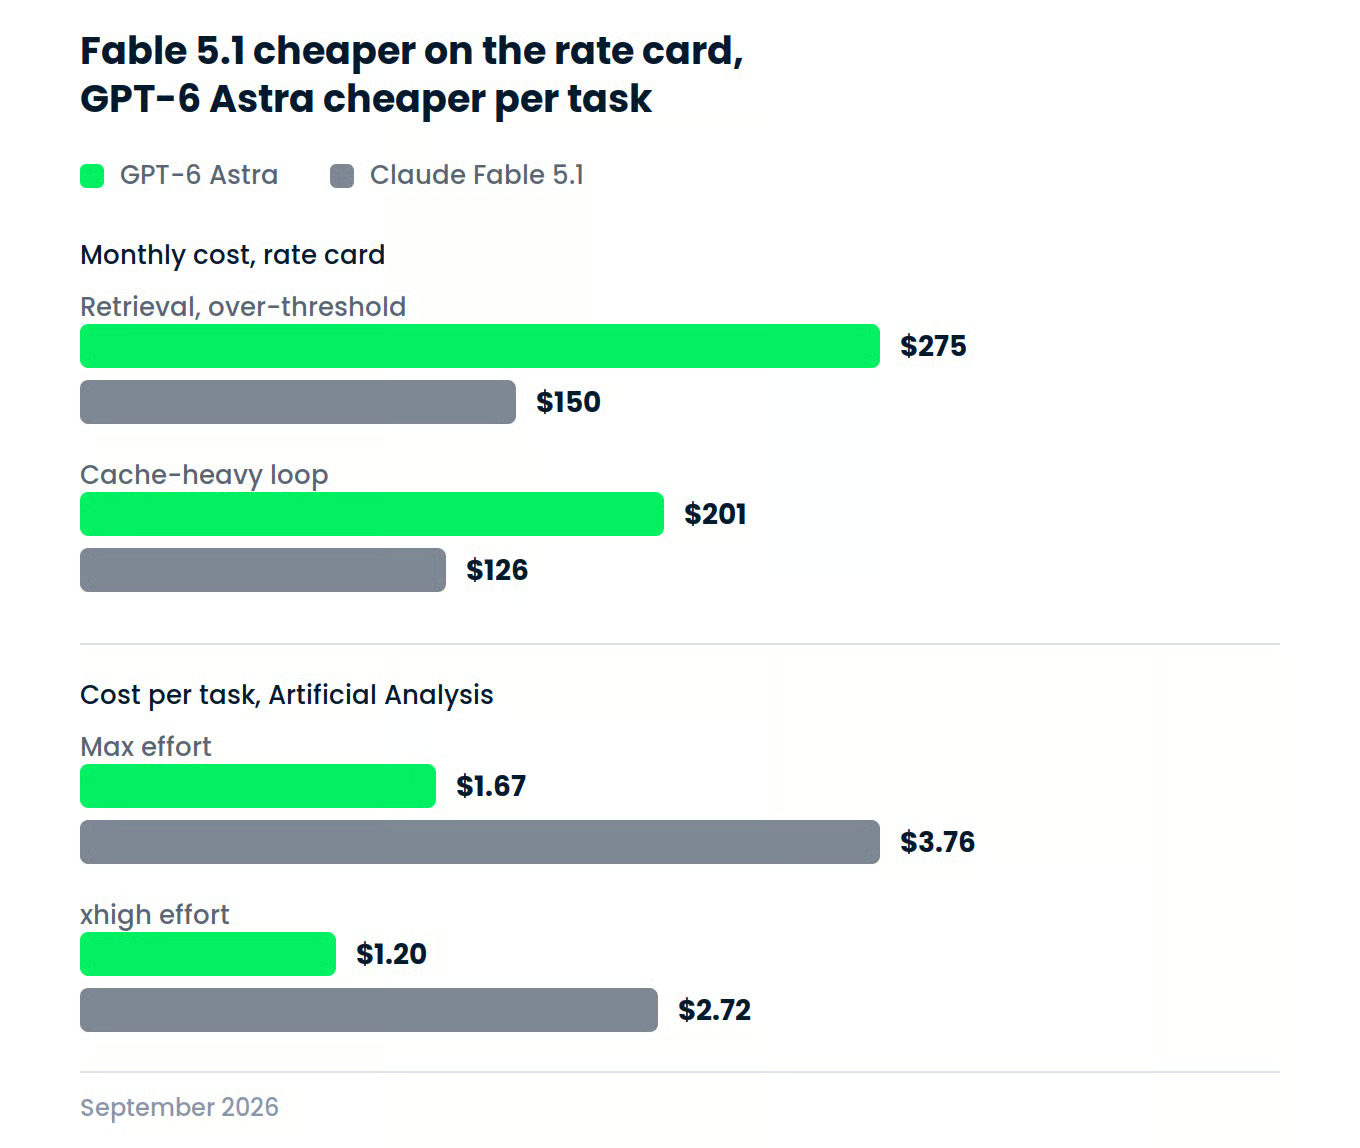
| 検索(閾値超過):10M 入力 / 1M 出力 | $275 | $150 | $125、Astra が 83% 高い |
| キャッシュ重視ループ:100K 接頭辞、1,000 読み出し | $201 | $126 | $75、Astra が 59% 高い |
計算式は各行で同じです。(ボリューム ÷ 100万)× レートを、新規入力、キャッシュ読み出し、キャッシュ書き込み、出力で合算します。キャッシュ重視の行では、100K の接頭辞を一度書き込み、1,000 回読み出す前提に、各リクエストあたり 5K の新規入力と 1K の出力を加えています。
見出しは閾値超過の検索行です。各リクエストを 272K 入力トークン未満に抑えれば、両モデルともコストは $150 で完全一致。同じ 10M トークンを各リクエストで 272K 超にして流すと、Anthropic は 1M トークンの文脈でも標準単価のままなので Fable 5.1 は $150 のまま、Astra は $275 に跳ね上がります。
キャッシュ重視のループは多くの読者が直面する形です。100K 接頭辞の 1,000 回読み出しでは、100万キャッシュトークンあたり $0.75 の差が、同一ワークロードで $75 の違いになります。ただしワークロードの形状に注意してください。これは意図的に出力が軽く、各リクエストの出力は 1K トークン、キャッシュ読み出しは 100K です。Fable 5.1 のキャッシュ優位が請求額を左右するのは、まさにこの形状だけです。
仮定ではなく実際のトークン消費を測ると、見え方は逆転します。Artificial Analysis は Intelligence Index のタスクあたりで各モデルのコストを算出しており、その手法には入力、キャッシュヒット、キャッシュ書き込み、思考、回答トークンがすでに含まれています。つまり Fable 5.1 の安いキャッシュも織り込み済みです。
| 努力レベル | GPT-6 Astra:スコア/タスクあたりコスト | Claude Fable 5.1:スコア/タスクあたりコスト |
|---|---|---|
| max | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
最大努力では、同じタスク群・同じ公称価格にもかかわらず、Fable 5.1 は Astra の 2.25 倍のコストになります。Artificial Analysis はコーディング指数でも同様の結論に達しており、Astra は Fable 5 に「半分以下のコストで匹敵、顕著なトークン効率の改善が原動力」と述べています。Astra の範囲は低努力でタスクあたり $0.46 まで下がります。
ここで Fable 5.1 はレート表に罰せられているわけではなく、出力量に起因します。Artificial Analysis は、最大努力で Fable 5 の約 1.7 倍の出力トークンを消費すると測定しており、そのためキャッシュ値下げにもかかわらずタスクあたりでは前世代より 20% 高くなっています。値下げがなかったと仮定すれば約 $5.16 で、値下げは確かに効いていますが、それでも十分ではないということです。
もちろん、そのプレミアムは無駄ではありません。Fable 5.1 は同じ指数で 5 ポイント高く、xhigh でも 4 ポイント高い。5 ポイントの差に 2.25 倍の価値を見いだすかどうかは各自の判断ですが、「公称価格が同一なら請求額も同一」という見立ては、実測には耐えません。
ベンダー自身の自社報告としてどこまで重視するかは別として、OpenAI のキャプションも同様の示唆を与えます。Terminal-Bench Science 0.1 で Fable 5.1 より約 31% 低く、Terminal-Bench 4.0 で約 63% 低く、BenchCAD で約 86% 低い API 推定タスク単価を Astra に付けています(各モデルに選んだ努力設定で測定)。
総合では僅差で Astra の勝利でしたが、どちらのモデルも初回で動作するシミュレーションを出荷しました。
浅い課題を複数ではなく、同一条件で難度の高いタスクを1件ずつ実施しました。比較用に選んだのは、単一 HTML ファイルでゼロから構築する物理シミュレーションです。両ベンダーが改善を主張する点、すなわちライブラリに頼らず長いビルドを通じた持続的な正確性を、ちょうど突く課題だからです。
今回はそのテストの刷新版です。公開済みのバリアントでは回転する四角形のコンテナを用いましたが、この実施では回転する六角形に、逆回転する中央障害物とサイズ比例の質量を加えています。難度を上げつつ、閉じ込め判定は明確な合否で保てます。プロンプトは以下のとおりで、両モデルにそれぞれ新規チャットへ逐語貼り付けしました。
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
両モデルとも高い推論努力で、各1回、リトライなし。同一のコーディングエージェントと同一ツール群で実行しました。採点は、まず動作可否の合否、その後、物理の正確性、30秒での安定性、視覚品質の各 1~5 点です。
Astra は動作可否を通過し、3つの評価軸すべてで 5/5。6 ターン、9 ツールコールで到達し、ツールの組み合わせが興味深いところです。ファイルを書き、5 回読み戻し、2 回 grep し、2 回パッチして完了を宣言しました。
シミュレーションは正確です。44 個のボール、面積比例の質量、六角形の回転中も 30 秒間の完全な閉じ込めを維持。Astra は内部障害物をチャンバーに対して大きめに設定し、障害物が届かない場所で安定してしまわないよう、ボールが継続的に衝突する構成にしました。
さらに、シミュレーションの周囲に編集ページ全体を構築しました。セリフ体の見出し、字間を空けた等幅ラベル、回転速度をライブ表示するテレメトリパネルまで。誰も要求していませんが、見栄えはかなり良いと感じました。ポーズと再開のコントロールも同梱され、プロンプトに明記はありませんが、成果物の検証が容易になりました。
Astra は外壁を 0.09 rad/s、障害物を -0.16 rad/s で回転させ、外壁で Fable の約 3 分の 1、障害物で約 5 分の 1 の低速です。観察しやすく、動く境界のテストとしても穏当。プロンプトは「ゆっくり回転」を求めているため、これは妥当です。
| 指標 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| ターン数 | 6 | 2 |
| ツールコール数 | 9 | 1 |
| 動作可否 | 合格 | 合格 |
| 物理の正確性 | 5 | 4 |
| 経時安定性 | 5 | 5 |
| 視覚品質 | 5 | 4 |
| 総合ルーブリックスコア | 5.0 | 4.3 |
品質では Astra の勝ちで、差は物理よりプレゼンテーションで広がりました。両者の分かれ目は「仕事の解釈」です。Astra はプロンプトを解釈して、コントロールや編集レイアウト、観察しやすい低速回転を追加。一方 Fable は仕様遵守として一発で満たし、残りの労力を診断用 HUD に振り向けました。
これは各モデル1回の実施なので、ベンチマークではなく1つのデータポイントとして扱ってください。トークンやコストではなくターン数を報告しており、上で扱ったコンピュータ操作や推論ではなく、ゼロからのシミュレーションコーディングだけを突いています。
公称レートが同じなので、決め手はワークロードの形、実測トークン消費、そして既存のコーディングエージェントです。意思決定を動かすべき数字は、4倍のキャッシュ読み出し差、272K のサーチャージ閾値、そして 2.25 倍の実測タスク単価の3つです。
| サーフェス | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| コンシューマー向けアプリ | ChatGPT Plus、Pro、Business、Enterprise | Claude(Web、モバイル、デスクトップ:Pro、Max、Team、Enterprise) |
| ファーストパーティ API | OpenAI API | Claude API |
| クラウドプラットフォーム | Amazon Bedrock、Microsoft Azure/Foundry | Amazon Bedrock、Google Cloud、Microsoft Azure/Foundry |
| コーディングエージェント | Codex | Claude Code、Cursor |
| サードパーティルーター | OpenRouter、Vercel AI Gateway | OpenRouter、Vercel AI Gateway |
| API モデル ID | gpt-6-astra |
claude-fable-5-1 |
初回コール前に注意すべき点が2つあります。Astra はエンタープライズのワークスペースでデフォルト無効(管理者が有効化する必要あり)。Fable 5.1 は 30 日のデータ保持が必須で、Priority Tier ではサポートされません。クラウドの対応は概ね拮抗していますが、現時点で Google Cloud は Fable 5.1 のみがあり、GPT-6 Astra はありません。
各モデルは自社ハーネスがネイティブです。Astra は Codex、Fable 5.1 は Claude Code で、/model claude-fable-5-1 か --model フラグで切り替えます。API では単なる文字列の差ですが、SDK は異なります。
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Fable 5.1 での変更点は3つあり、Fable 5 向けのコードを壊します。強制ツール選択が 400 を返す、旧モデルは思考ブロックを読めない、思考ブロックは直前の履歴に厳密に結び付く、の3点です。これらは Claude Fable 5.1 API チュートリアルで解説しています。対になる OpenAI API 入門ガイドも参照してください。
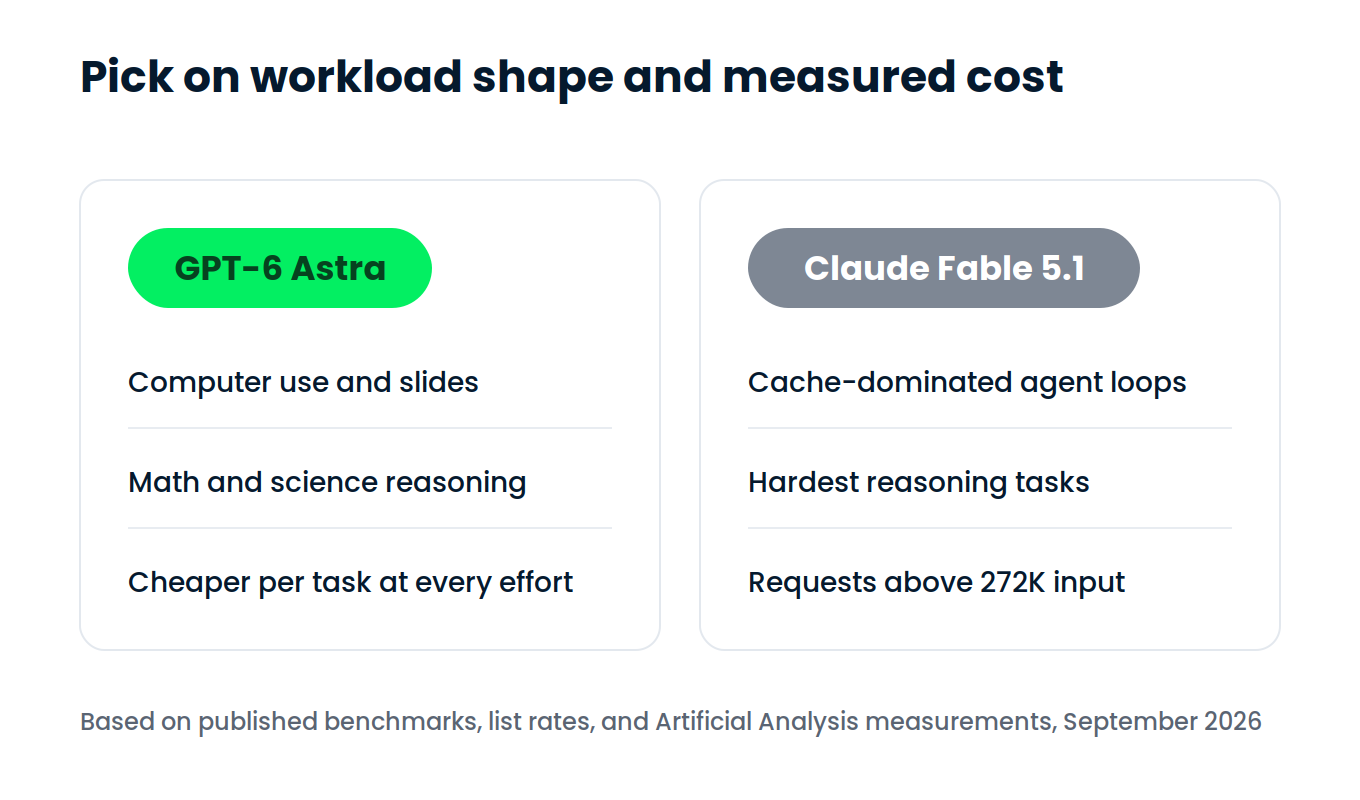
ベンチマーク表ではなく、ワークロード形状と実測コストで選んでください。GPT-6 Astra は、ソフトをクリックで操作するエージェント、数理系タスク、クライアントにそのまま出せる成果物で強く、レート表が同一でもタスクあたりでは安い傾向が見られます。Claude Fable 5.1 は、独立評価で最高の推論スコアを得られ、非常に大きなリクエストやキャッシュ支配のループでは安価です。
この比較の落とし穴はレート表です。$10 と $50 の2モデルは価格面で取り替え可能に見え、唯一の目立つ差であるキャッシュ読み出しは Anthropic に 4倍の優位があります。ところが、タスク完了に実際に要したトークンを測ると、Astra のコストは Fable 5.1 の 44% に。料金ページからは予測しづらく、最終判断前に自社トラフィックで必ず検証すべき一点です。
どちらかのモデルを「使って」学ぶなら、Anthropic 側は Introduction to Claude Models、OpenAI 側は Working with the OpenAI API をおすすめします。
DataCamp で AI を学ぼう!
コース
コース
コース