Curso
Introducción a los modelos Claude
3 h
14.9K
Aprende a trabajar con LLMs en Python directamente en tu navegador
GPT-6 Astra es el buque insignia de frontera de OpenAI, sucesor de GPT-5.6 Sol, y está diseñado alrededor de la ejecución agentiva más que del chat. OpenAI lo posiciona para uso de ordenador, trabajo profesional e ingeniería de software, y es el primer modelo de OpenAI en superar el umbral de ciberseguridad "Crítico" en su Preparedness Framework. Ofrece una ventana de contexto de 1.050.000 tokens, con salida máxima de 128K y fecha de corte de conocimiento del 30 de abril de 2026.
Dos puntos destacan en el anuncio. En Codex, Astra mantiene notas a través de ventanas de contexto en lugar de compactarlas en un resumen, de modo que las ventanas anteriores siguen siendo consultables, y decide cuándo hacer una pregunta de clarificación en lugar de adivinar siempre o preguntar siempre.
Para ver la lista completa de funciones, tablas de benchmarks y detalles de acceso, consulta nuestra guía de GPT-6 Astra. También merece la pena leerla junto con nuestra cobertura de su predecesor en GPT-5.6 Sol, Terra y Luna.
Claude Fable 5.1 es el modelo de frontera de Anthropic de disponibilidad general para razonamiento exigente y trabajo agentivo de largo recorrido. Ofrece una ventana de contexto de 1M de tokens con salida máxima de 128K, pensamiento adaptativo siempre activo y fecha de corte de conocimiento de junio de 2026. La documentación de Anthropic indica una latencia más lenta que Claude Opus 5 y Claude Sonnet 5, ambos por debajo en precio.
Claude Mythos 5.1 es el mismo modelo con salvaguardas distintas, disponible por invitación a través de Project Glasswing. El cambio clave para el resto es el precio de lectura de caché, reducido un 75% a $0.25 por millón de tokens, mientras las tarifas de lista se mantienen.
Nuestra guía de Claude Fable 5.1 incluye el desglose completo de benchmarks, y nuestro tutorial de la API de Claude Fable 5.1 construye un agente para desarrolladores con conocimiento del repositorio, con un desglose real de costes por niveles de esfuerzo.
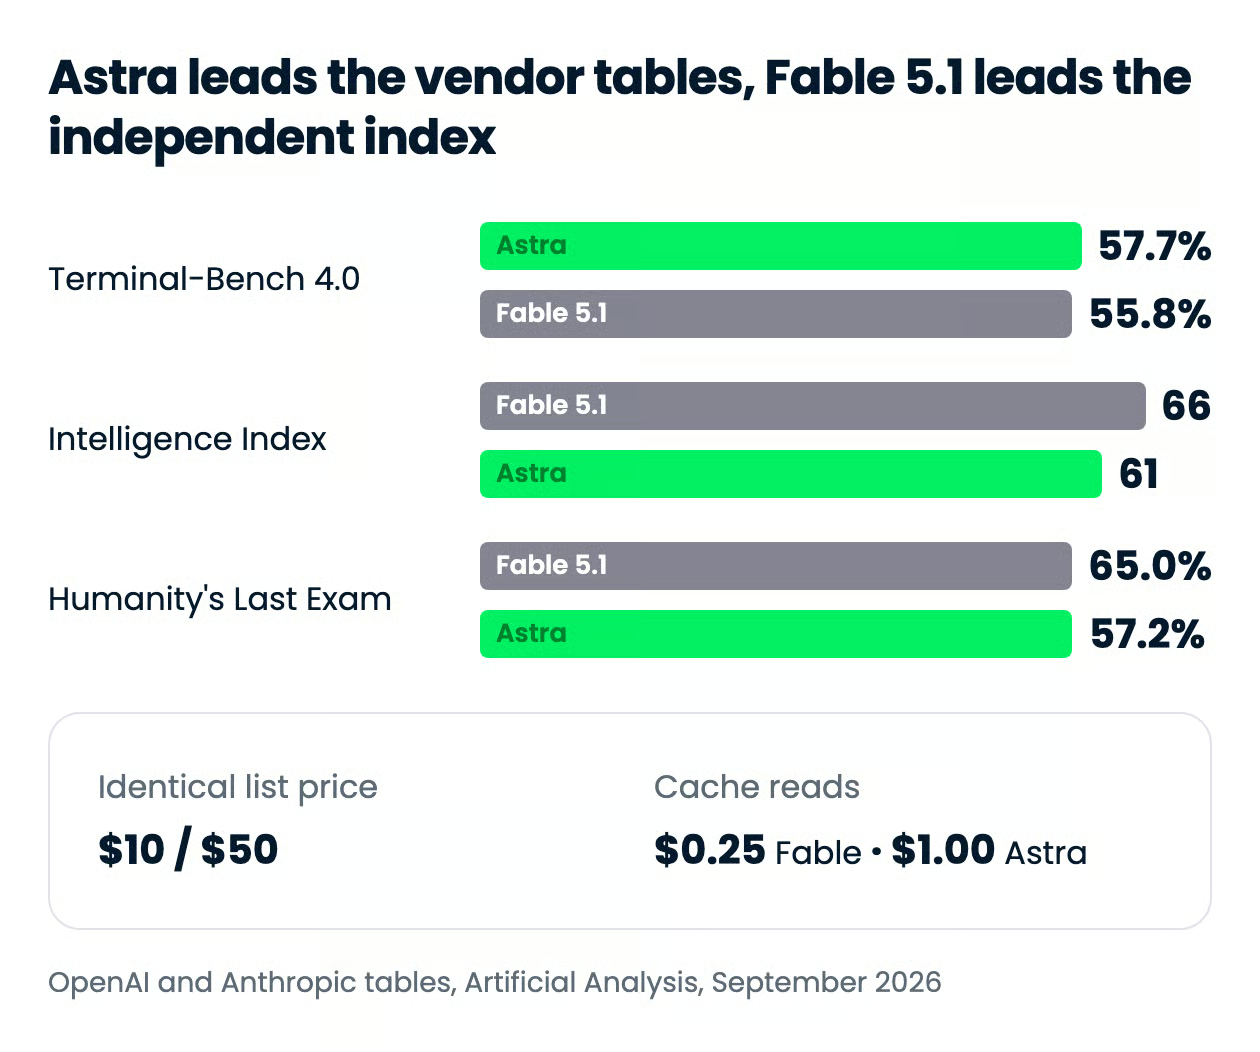
La versión corta: la tabla comparativa de OpenAI muestra a Astra por delante de Fable 5.1 en casi todas las filas publicadas, y Artificial Analysis muestra lo contrario en sus dos índices. En cuál confíes depende de cuánto peso des a un proveedor puntuando a su competidor.
| Función | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Fecha de lanzamiento | 3 de septiembre de 2026 | 1 de septiembre de 2026 |
| ID de modelo en la API | gpt-6-astra |
claude-fable-5-1 |
| Ventana de contexto | 1,05M tokens | 1M tokens |
| Salida máxima | 128K tokens | 128K tokens |
| Fecha de corte de conocimiento | 30 de abril de 2026 | junio de 2026 |
| Precio de lista por 1M tokens | $10 entrada / $50 salida | $10 entrada / $50 salida |
| Lectura de entrada en caché por 1M | $1.00 ($2.00 por encima de 272K) | $0.25 |
| Tarifas por encima de 272K tokens de entrada | 2x en entrada y caché, 1,5x en salida | Sin recargo |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, con herramientas | 57,2% | 65,0% |
| ScreenSpot-Pro (sin herramientas) | 92,7% | 87,3% (Fable 5, desde Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (máximo esfuerzo) | 61 | 66 |
| AA coste por tarea del Intelligence Index (máx.) | $1.67 | $3.76 |
| Área más fuerte | Uso de ordenador, matemáticas, ciberseguridad, coste por tarea | Profundidad de razonamiento, bucles agentivos dominados por caché |
Astra lidera en los benchmarks de código que OpenAI eligió publicar, pero por márgenes ajustados, y el índice independiente discrepa. En Terminal-Bench 4.0, que evalúa ingeniería de software, configuración de sistemas y análisis de datos en una terminal, OpenAI reporta 57,7% para Astra frente a 55,8% para Fable 5.1. Anthropic publica el mismo 55,8%, así que al menos esa fila no se discute.
La brecha se amplía en DeepSWE v1.1, donde Astra alcanza 74,1% frente a 67,4%, y se cierra casi del todo en FrontierCode 1.1 Main, donde 53,3% frente a 50,9% queda dentro del rango que ya ocupaban Claude Fable 5 (53,5%) y Claude Opus 5 (53,4%).
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Notas |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | La tabla de OpenAI indica 57,7% mientras que el pie de su gráfico dice 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | Reportado por OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | Práctico empate con Fable 5 (53,5%) y Opus 5 (53,4%) |
| Migración de base de datos interna | 63,9% | 57,8% | Evaluación interna de OpenAI, sin réplica externa |
| CursorBench 3.2.0 | No publicado | 73,4% | Reportado por Anthropic; SpaceXAI confirmó 73,4% en esfuerzo máximo |
| AA Coding Agent Index | 67 en Codex | 70 en Claude Code | Independiente, pero con arneses distintos |
Esa última fila es a la que vuelvo siempre. Artificial Analysis sitúa a Fable 5.1 en Claude Code con 70, la puntuación más alta de su Coding Agent Index, y a Astra en Codex con 67, a la altura de Claude Opus 5 y Claude Fable 5. Dos matices con cautela aquí:
Astra gana por poco las filas publicadas de código y gana con claridad en eficiencia, mientras que Fable 5.1 conserva la única puntuación independiente de agente de código que los supera a ambos.
Esta es la división más nítida de toda la comparación, y va en ambas direcciones. Astra se lleva las filas de matemáticas y ciencia: 97,6% frente a 87,8% en FrontierMath Tier 4 v2, 96,0% frente a 93,7% en GPQA Diamond y 64,6% frente a 52,6% en Terminal-Bench Science 0.1, el benchmark agentivo de investigación alrededor del cual Anthropic construyó su propio lanzamiento.
Fable 5.1 gana Humanity's Last Exam con herramientas, 65,0% frente a 57,2%, y no es ajustado. Artificial Analysis respalda la dirección del resultado de forma independiente, puntuando Fable 5.1 con 66 en su Intelligence Index frente a 61 de Astra, la puntuación más alta que ha medido.
Un matiz sobre ese 66. Artificial Analysis ejecutó Fable 5.1 con el fallback del lado servidor por defecto de Anthropic, que redirige las peticiones marcadas por seguridad a Claude Opus 4.8 o Claude Opus 5, y el fallback sirvió aproximadamente el 4% de los tokens de salida en el índice. La puntuación es Fable 5.1 tal y como lo usará la mayoría, no el modelo en aislamiento.
Si tu trabajo es matemáticas o ciencia a nivel de posgrado, Astra. Si es el tipo de razonamiento amplio y difícil que sondea Humanity's Last Exam, Fable 5.1.
Astra domina esta dimensión, en gran parte porque Anthropic no ha publicado cifras comparables. OpenAI reporta 72,6% para Astra en el conjunto offline de OSWorld 2.0 frente a 70,2% para Claude Opus 5, y 92,7% en ScreenSpot-Pro frente a 87,3% para Claude Fable 5. Las cifras propias de Anthropic para Fable 5.1, 77,9% parcial y 41,7% estricto, proceden de otra versión de tareas y otro esquema de evaluación.
Los números de artefactos son menos ambiguos: 95,9% en BenchCAD frente a 84,3%, y 41,4% frente a 31,4% en AutomationBench.
Para agentes que clican por software real y producen diapositivas o salida CAD, Astra es la apuesta más sólida.
Las cifras de alineamiento de Astra son lo menos comentado de su lanzamiento. En el benchmark interno de seguridad de uso de ordenador de OpenAI, donde menos es mejor, obtiene 2,4% frente a 9,5% de Fable 5.1.
En ciberseguridad, juega en otra liga: 100% en ExploitBench, y 86 de 226 retos de FrontierCyber resueltos frente a 34 de GPT-5.6 Sol en pruebas independientes de Irregular. Anthropic aflojó Fable 5.1 lo suficiente como para encontrar vulnerabilidades, pero no para explotarlas.
Dos matices, ambos con cautela:
Astra es a la vez el agente más seguro y el atacante más capaz; de ahí las restricciones de acceso.
Las tarifas de lista son idénticas, así que, en la tabla de precios, la única diferencia entre estos dos modelos proviene del caché y del contexto largo. Ese marco solo vale si ambos modelos gastan el mismo número de tokens en la misma tarea, y no es así; por eso los costes medidos por tarea más abajo importan más que la tabla de precios.
| Tarifa | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Entrada, por 1M tokens | $10.00 | $10.00 |
| Salida, por 1M tokens | $50.00 | $50.00 |
| Lectura de entrada en caché, por 1M tokens | $1.00 | $0.25 |
| Escritura en caché (5 minutos), por 1M tokens | $12.50 | $12.50 |
| Descuento por lotes | 50% | 50% |
| Tarifas por encima de 272K tokens de entrada | $20.00 entrada / $2.00 caché / $75.00 salida | Sin recargo |
Entrada, salida, escrituras en caché y el descuento por lotes coinciden al céntimo. La excepción son las lecturas de caché, con una brecha de 4x: Anthropic baja las lecturas de caché de Fable 5.1 a $0.25, mientras que OpenAI fija las de Astra en $1.00, un 90% de descuento sobre su tarifa de entrada.
Por encima de 272K tokens de entrada, la brecha se amplía a 8x, porque el recargo de OpenAI duplica las lecturas de caché a $2.00 junto con la entrada, mientras que la documentación de precios de Anthropic mantiene toda la ventana de 1M tokens a tarifas estándar. Observa lo bajo que queda ese umbral respecto a lo que anuncia Astra: 272K es aproximadamente una cuarta parte de su ventana de 1,05M, así que cualquier solicitud que use más de una cuarta parte del contexto se factura en el tramo superior.
Las lecturas de caché son la tarifa que se acumula en un bucle largo, porque un agente reenvía el mismo mensaje del sistema, definiciones de herramientas y contexto del repositorio en cada turno. Nuestra guía de prompt caching cubre la mecánica entre escribir en caché y leer de caché si ese matiz es nuevo para ti.
Todo en esta tabla es aritmética a tarifa de lista con una forma de tokens fija, no un resultado medido. Responde a la pregunta «si ambos modelos gastaran tokens idénticos, ¿qué cobraría la tarifa?». La siguiente sección responde a qué gastan en realidad.
| Carga de trabajo | GPT-6 Astra | Claude Fable 5.1 | Diferencia |
|---|---|---|---|
| Asistente equilibrado: 1M entrada / 250K salida | $22.50 | $22.50 | $0, 0% |
| Recuperación, bajo umbral: 10M entrada / 1M salida | $150 | $150 | $0, 0% |
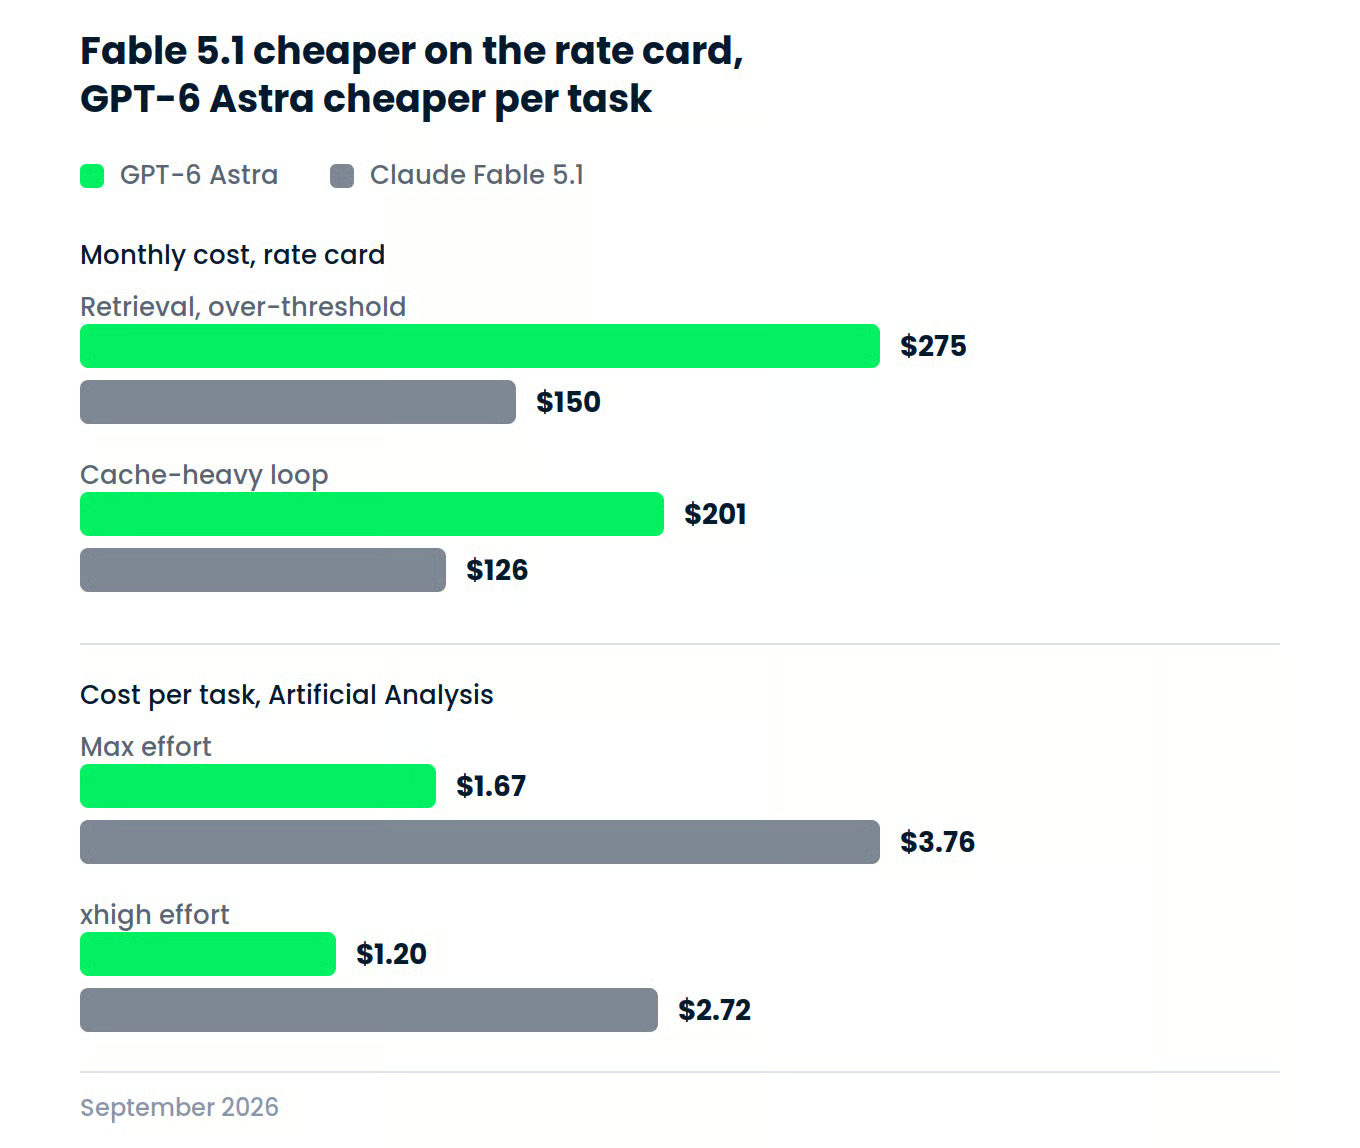
| Recuperación, sobre umbral: 10M entrada / 1M salida | $275 | $150 | $125, 83% más para Astra |
| Bucle con mucha caché: prefijo 100K, 1.000 lecturas | $201 | $126 | $75, 59% más para Astra |
La fórmula es la misma para cada fila: (volumen ÷ 1M) × tarifa, sumando entrada nueva, lecturas de caché, escrituras de caché y salida. La fila de mucha caché asume un prefijo de 100K escrito una vez y leído 1.000 veces, más 5K de entrada nueva y 1K de salida por solicitud.
La fila de recuperación sobre umbral es la titular. Mantén cada solicitud por debajo de 272K tokens de entrada, y los dos modelos cuestan exactamente los mismos $150. Empuja los mismos 10M tokens en solicitudes que superen 272K cada una, y Astra sube a $275 mientras Fable 5.1 se queda en $150, porque Anthropic cobra toda la ventana de 1M tokens a tarifa estándar.
El bucle con mucha caché es el que más lectores encontrarán. Con 1.000 lecturas en caché de un prefijo de 100K, la brecha de $0.75 por millón de tokens en caché se convierte en $75 de diferencia en una carga de trabajo por lo demás idéntica. Fíjate en la forma de la carga: es deliberadamente ligera en salida, 1K tokens de salida por solicitud frente a 100K de lecturas de caché. Es la única forma donde la ventaja de caché de Fable 5.1 decide la factura.
Cuando mides el consumo real de tokens en lugar de asumirlo, el panorama cambia. Artificial Analysis calcula el precio por tarea del Intelligence Index para cada modelo, y su método ya incluye tokens de entrada, aciertos de caché, escrituras de caché, razonamiento y respuesta, así que la caché más barata de Fable 5.1 ya está reflejada.
| Nivel de esfuerzo | GPT-6 Astra: puntuación/coste por tarea | Claude Fable 5.1: puntuación/coste por tarea |
|---|---|---|
| máx | 61 / $1.67 | 66 / $3.76 |
| xhigh | 61 / $1.20 | 65 / $2.72 |
A esfuerzo máximo, Fable 5.1 cuesta 2,25 veces lo que Astra para el mismo conjunto de tareas al mismo precio de lista. Artificial Analysis llega a la misma conclusión en su índice de código, donde Astra iguala a Fable 5 "a menos de la mitad del coste, gracias a importantes ganancias de eficiencia en tokens". El rango de Astra baja hasta $0.46 por tarea a esfuerzo bajo.
Aquí Fable 5.1 no es penalizado por su tarifa, sino por su volumen de salida. Artificial Analysis midió que usa ~1,7x los tokens de salida de Fable 5 a esfuerzo máximo, por lo que cuesta un 20% más por tarea que su predecesor pese a la rebaja de caché. Sin esa rebaja, la cifra rondaría $5.16; el descuento aporta, pero no basta.
Pagas ese plus por algo. Fable 5.1 puntúa 5 puntos más en el mismo índice, y 4 puntos más en xhigh. Si 5 puntos valen 2,25x es cosa tuya; la versión donde precios idénticos implican facturas idénticas no aguanta cuando mides.
Los pies de foto de OpenAI apuntan en la misma dirección, con el valor que tenga un autorreporte: estiman el coste por tarea de Astra en la API ~31% por debajo de Fable 5.1 en Terminal-Bench Science 0.1, ~63% por debajo en Terminal-Bench 4.0 y ~86% por debajo en BenchCAD, medido con los ajustes de esfuerzo que OpenAI eligió.
Astra ganó ligeramente nuestra prueba global, aunque ambos modelos entregaron una simulación funcional al primer intento.
Ejecuté una tarea difícil contra ambos modelos en condiciones idénticas en lugar de varias superficiales. La prueba elegida es una simulación de física desde cero en un único archivo HTML, escogida porque explora justo lo que ambos proveedores dicen haber mejorado: corrección sostenida a lo largo de una construcción larga, sin biblioteca de apoyo.
Esta instancia es una versión actualizada de esa prueba. La variante publicada usó un contenedor cuadrado giratorio; en esta ejecución se usa un hexágono giratorio con un obstáculo central que gira en sentido contrario y masa proporcional al tamaño, elevando la dificultad y manteniendo el confinamiento como aprobado o fallo inequívoco. Este es el prompt, pegado literalmente en un chat nuevo para cada modelo:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Ambos modelos corren a alto esfuerzo de razonamiento, un intento cada uno sin reintentos, dentro del mismo agente de código con las mismas herramientas. La evaluación es un check de ejecutabilidad (apto/no apto) y luego una rúbrica del 1 al 5 en corrección física, estabilidad durante 30 segundos y calidad visual.
Astra pasó el check de ejecutabilidad y puntuó 5/5 en los tres ejes de la rúbrica. Llegó en 6 turnos y 9 llamadas a herramientas, y la mezcla de herramientas es lo interesante: escribió el archivo, lo leyó 5 veces, hizo dos grep y aplicó dos parches antes de darlo por terminado.
La simulación es correcta. 44 bolas, masa escalando con el área, confinamiento mantenido durante los 30 segundos mientras gira el hexágono. Astra dimensionó el obstáculo interno grande respecto a la cámara, así que las bolas siguen chocando con él en lugar de asentarse en un lugar donde no alcance.
También construyó toda una página editorial alrededor de la simulación, con un titular con serif, etiquetas monoespaciadas con tracking y un panel de telemetría con tasas de rotación en vivo. Nadie lo pidió, pero queda bastante bien. También añadió controles de pausa y reinicio, que el prompt no solicitaba, pero que facilitaron la inspección del artefacto.
Astra hace girar la cámara a 0,09 rad/s y el obstáculo a -0,16 rad/s, unas 3 veces más lento que Fable en la pared exterior y 5 veces más lento en el obstáculo. Más fácil de ver y una prueba más suave de la frontera móvil que una rotación más rápida. Dado que el prompt pedía un contenedor de rotación lenta, está bien.
| Medida | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Turnos | 6 | 2 |
| Llamadas a herramientas | 9 | 1 |
| Ejecutabilidad | Apto | Apto |
| Corrección física | 5 | 4 |
| Estabilidad en el tiempo | 5 | 5 |
| Calidad visual | 5 | 4 |
| Puntuación de la rúbrica | 5,0 | 4,3 |
Astra gana en calidad, con una diferencia mayor en presentación que en física. Donde se separan es en cómo cada modelo entendió el encargo. Astra leyó el prompt como un brief a interpretar, añadiendo controles, un diseño editorial completo y una rotación más lenta que favorece la visualización. Fable lo leyó como una especificación a cumplir, la cumplió en una sola escritura y destinó el resto del esfuerzo a un HUD de diagnóstico.
Esto es una sola ejecución por modelo, así que tómalo como un dato, no un benchmark. Reporta turnos, no tokens ni coste, y solo explora código de simulación desde cero, no el uso de ordenador ni el razonamiento tratados arriba.
Como las tarifas de lista coinciden, la decisión depende de la forma de tu carga, el consumo real de tokens y el agente de código que ya uses. Las tres cifras que deberían moverte son la brecha 4x en lecturas de caché, el umbral de recargo de 272K y el coste medido por tarea 2,25x.
| Superficie | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| App de consumo | ChatGPT Plus, Pro, Business, Enterprise | Claude web, móvil, escritorio (Pro, Max, Team, Enterprise) |
| API de primera parte | OpenAI API | Claude API |
| Nubes | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Agentes de código | Codex | Claude Code, Cursor |
| Routers de terceros | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID de modelo en la API | gpt-6-astra |
claude-fable-5-1 |
Dos detalles de acceso te frenarán antes de la primera llamada. Astra está desactivado por defecto en espacios Enterprise hasta que un administrador lo active, y Fable 5.1 requiere retención de datos de 30 días y no es compatible con Priority Tier. La disponibilidad en la nube es casi pareja, con Google Cloud como la única plataforma que hoy tiene Fable 5.1 y no GPT-6 Astra.
Cada modelo es nativo de su propio arnés: Astra en Codex y Fable 5.1 en Claude Code, donde cambias con /model claude-fable-5-1 o la bandera --model. Por API, el cambio es una cadena, aunque los SDK difieran.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Tres cambios en Fable 5.1 romperán código escrito para Fable 5: la selección forzada de herramienta ahora devuelve 400, los modelos anteriores no pueden leer sus bloques de pensamiento, y los bloques de pensamiento quedan vinculados al historial exacto anterior. Nuestro tutorial de la API de Claude Fable 5.1 recorre los tres, y nuestra guía para principiantes de la OpenAI API cubre el equivalente en el otro lado.
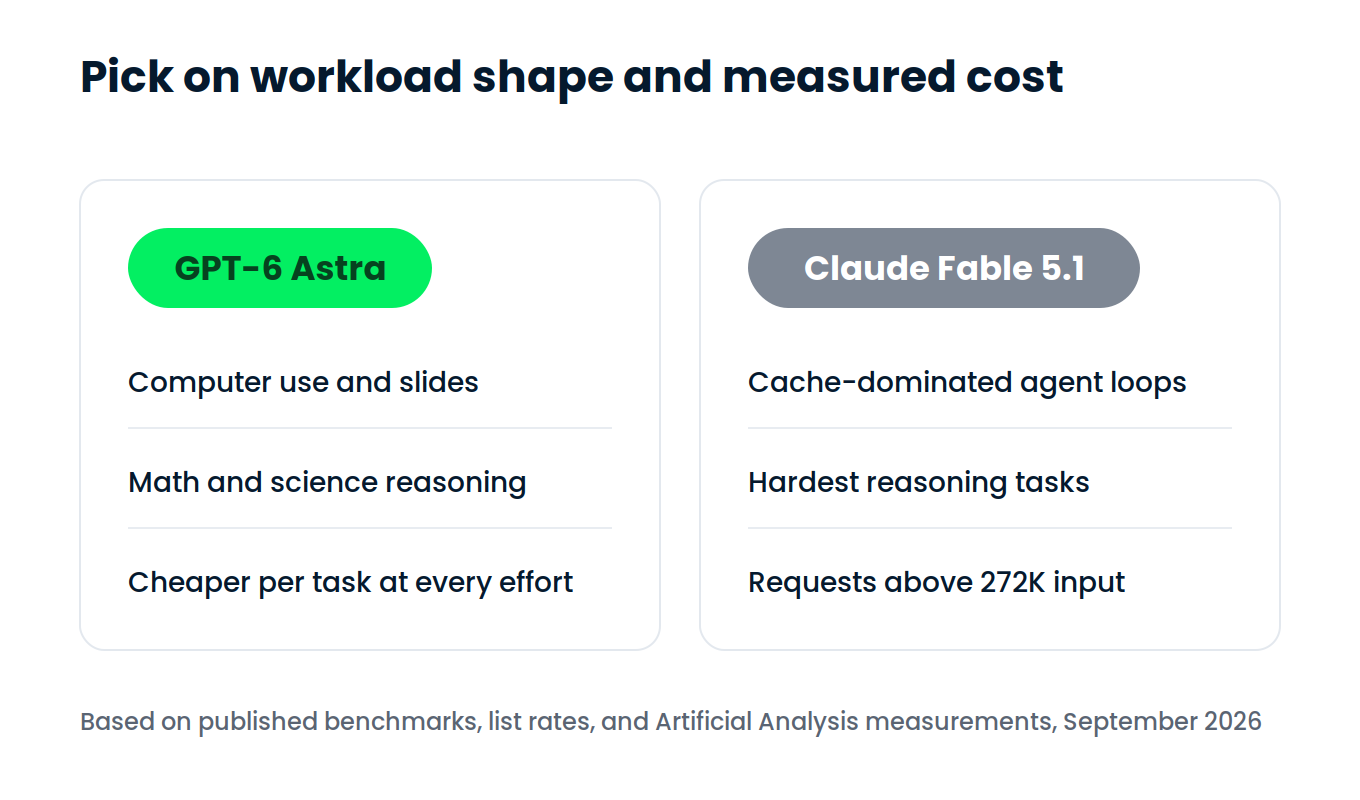
Decide por la forma de la carga y el coste medido, no por las tablas de benchmarks. GPT-6 Astra es más fuerte para agentes que clican por software, hacen matemáticas o producen artefactos listos para cliente, y parece más barato por tarea pese a la tarifa idéntica. Claude Fable 5.1 te compra la mejor puntuación independiente en razonamiento y cuesta menos en solicitudes muy grandes y en bucles dominados por caché.
La tabla de precios es la trampa aquí. Dos modelos a $10 y $50 parecen intercambiables en precio, y la única brecha visible, lecturas de caché, favorece a Anthropic por 4x. Luego mides lo que realmente gasta cada uno para terminar una tarea, y Astra sale al 44% del coste de Fable 5.1. No lo habría predicho por las páginas de precios, y es lo primero que comprobaría con tu propio tráfico antes de decidir.
Si quieres trabajar con cualquiera de los dos modelos en lugar de leer sobre ellos, te recomiendo nuestro curso Introduction to Claude Models para el lado de Anthropic y Working with the OpenAI API para el de OpenAI.
¡Aprende IA con DataCamp!
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
Tutorial
Moez Ali
11 min
Tutorial
Arunn Thevapalan
12 min