Kurs
Introduktion till Claude-modeller
3 tim
14.9K
GPT-6 Astra är OpenAI:s yttersta flaggskepp, efterföljare till GPT-5.6 Sol, och är byggt kring agentisk exekvering snarare än chatt. OpenAI positionerar den för datoranvändning, professionellt arbete och programvaruteknik, och det är den första OpenAI-modellen som passerar den ”kritiska” cybersäkerhetströskeln i företagets Preparedness Framework. Den har ett kontextfönster på 1 050 000 token med 128K maxoutput och en kunskapsavgränsning den 30 april 2026.
Två saker sticker ut i tillkännagivandet. I Codex behåller Astra anteckningar över kontextfönster i stället för att komprimera dem till en sammanfattning, så tidigare fönster förblir sökbara, och den avgör när den ska ställa en förtydligande fråga i stället för att alltid gissa eller alltid fråga.
För hela funktionslistan, benchmarktabeller och detaljer om åtkomst, se vår GPT-6 Astra-guide. Det är också värt att läsa tillsammans med vår genomgång av föregångaren i GPT-5.6 Sol, Terra och Luna.
Claude Fable 5.1 är Anthropics allmänt tillgängliga toppmodell för krävande resonemang och långsiktigt agentiskt arbete. Den kör ett kontextfönster på 1M token med 128K maxoutput, adaptivt tänkande som alltid är påslaget och en kunskapsavgränsning i juni 2026. Enligt Anthropics dokumentation är latensen långsammare än Claude Opus 5 och Claude Sonnet 5, som båda ligger lägre i pris.
Claude Mythos 5.1 är samma modell med andra skyddsräcken, tillgänglig via inbjudan genom Project Glasswing. Nyheten för alla andra är priset för cacheläsning, sänkt med 75% till $0,25 per miljon token, medan listpriserna ligger kvar.
Vår Claude Fable 5.1-guide har hela benchmarkgenomgången, och vår Claude Fable 5.1 API-handledning bygger en utvecklaragent med repo-kännedom, inklusive en verklig kostnadsuppdelning över olika ambitionsnivåer.
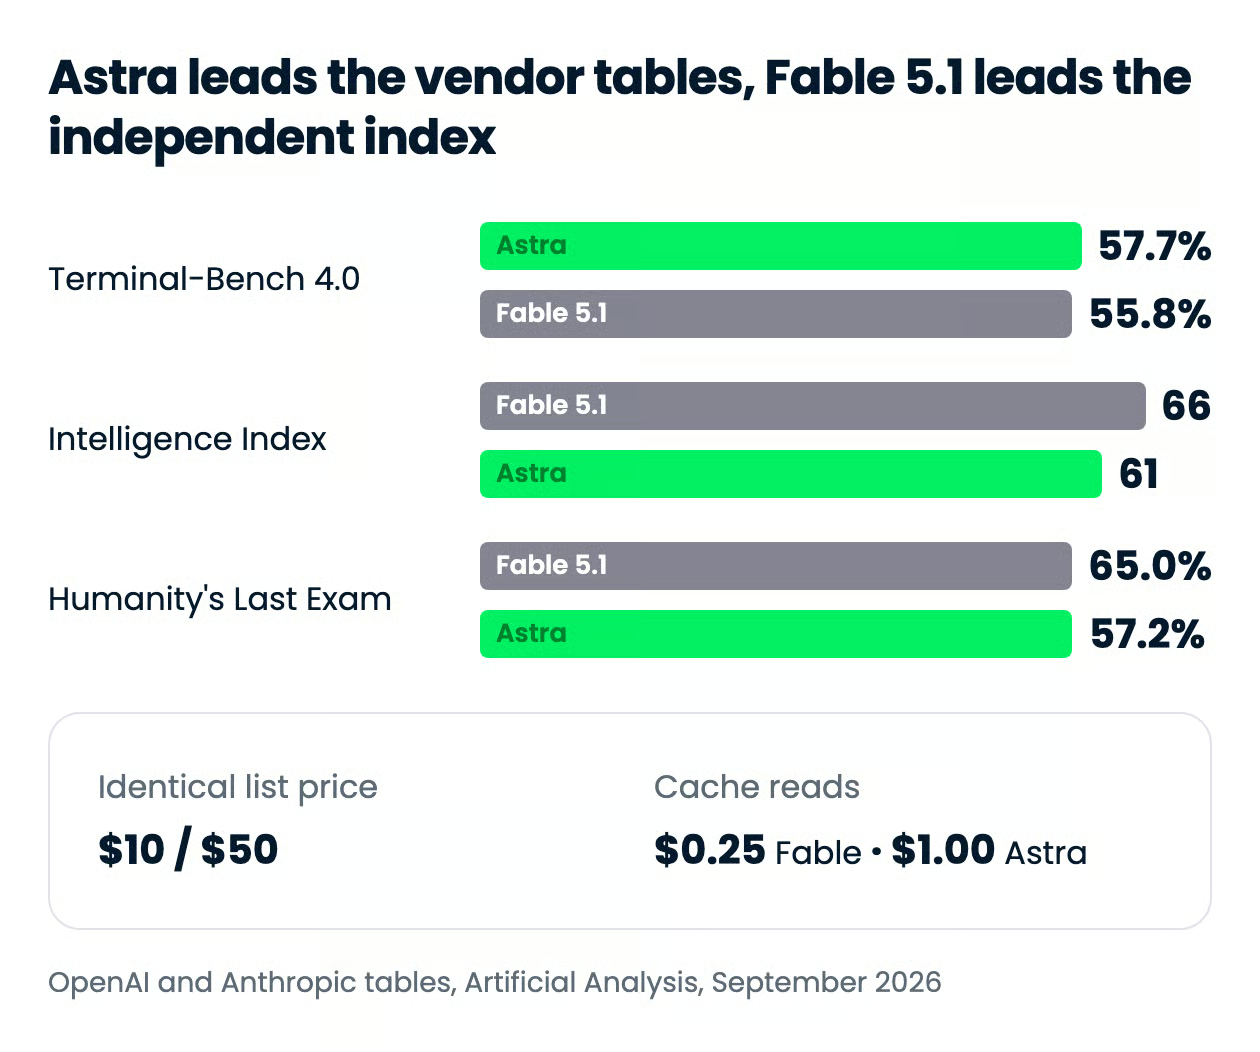
Den korta versionen: OpenAI:s jämförelsetabell visar Astra före Fable 5.1 på nästan varje rad man publicerade, och Artificial Analysis visar motsatsen på båda sina index. Vilken du tror på beror på hur mycket vikt du lägger vid att en leverantör poängsätter sin egen konkurrent.
| Funktion | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Lanseringsdatum | 3 september 2026 | 1 september 2026 |
| API-modell-ID | gpt-6-astra |
claude-fable-5-1 |
| Kontextfönster | 1,05M token | 1M token |
| Maxoutput | 128K token | 128K token |
| Kunskapsavgränsning | 30 april 2026 | Juni 2026 |
| Listpris per 1M token | $10 in / $50 ut | $10 in / $50 ut |
| Cacheläst input per 1M | $1,00 ($2,00 över 272K) | $0,25 |
| Taxor över 272K inputtoken | 2x input och cache, 1,5x output | Ingen tilläggsavgift |
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% |
| Humanity's Last Exam, med verktyg | 57,2% | 65,0% |
| ScreenSpot-Pro (inga verktyg) | 92,7% | 87,3% (Fable 5, från Mythos) |
| AutomationBench | 41,4% | 31,4% |
| ExploitBench | 100% | 70% |
| AA Intelligence Index (max effort) | 61 | 66 |
| AA kostnad per Intelligence Index-uppgift (max) | $1,67 | $3,76 |
| Starkaste område | Datoranvändning, matematik, cybersäkerhet, kostnad per uppgift | Resonemangsdjup, cache-dominerade agentloopar |
Astra leder på de kodningsbenchmark som OpenAI valt att publicera, men marginalerna är små och det oberoende indexet säger emot. På Terminal-Bench 4.0, som testar mjukvaruteknik, systemkonfiguration och dataanalys i en terminal, rapporterar OpenAI 57,7% för Astra mot 55,8% för Fable 5.1. Anthropic publicerar samma 55,8%-siffra, så den raden är åtminstone okontroversiell.
Gapet vidgas på DeepSWE v1.1, där Astra når 74,1% mot 67,4%, och krymper nästan helt på FrontierCode 1.1 Main, där 53,3% mot 50,9% ligger inom spannet som Claude Fable 5 (53,5%) och Claude Opus 5 (53,4%) redan upptog.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Kommentarer |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,7% | 55,8% | OpenAI:s tabell säger 57,7% medan bildtexten i deras diagram säger 57,9% |
| DeepSWE v1.1 | 74,1% | 67,4% | Rapporterat av OpenAI |
| FrontierCode 1.1 Main | 53,3% | 50,9% | I praktiken oavgjort med Fable 5 på 53,5% och Opus 5 på 53,4% |
| Intern databasmigrering | 63,9% | 57,8% | OpenAI intern utvärdering, ingen extern replikation |
| CursorBench 3.2.0 | Ej publicerat | 73,4% | Rapporterat av Anthropic; SpaceXAI bekräftade 73,4% på max effort |
| AA Coding Agent Index | 67 i Codex | 70 i Claude Code | Oberoende, men olika ramverk |
Det är den sista raden jag återkommer till. Artificial Analysis sätter Fable 5.1 i Claude Code på 70, den högsta poängen på dess Coding Agent Index, och Astra i Codex på 67, ungefär i nivå med Claude Opus 5 och Claude Fable 5. Två brasklappar förtjänar en nypa salt här:
Astra vinner de publicerade kodningsraderna med liten marginal och vinner effektivitetsargumentet tydligt, medan Fable 5.1 håller det enda oberoende kodagentbetyget som överträffar dem båda.
Det här är den tydligaste uppdelningen i hela jämförelsen, och den går åt båda hållen. Astra tar raderna för matematik och naturvetenskap: 97,6% mot 87,8% på FrontierMath Tier 4 v2, 96,0% mot 93,7% på GPQA Diamond och 64,6% mot 52,6% på Terminal-Bench Science 0.1, det agentiska forskningsbenchmark som Anthropic byggde sin egen lansering kring.
Fable 5.1 tar Humanity's Last Exam med verktyg, 65,0% mot 57,2%, och det är inte jämnt. Artificial Analysis stödjer riktningen i det resultatet oberoende, och ger Fable 5.1 poängen 66 på sitt Intelligence Index mot 61 för Astra, den högsta poäng de någonsin mätt.
En brasklapp kring den där 66:an. Artificial Analysis körde Fable 5.1 med Anthropics standardmässiga server-sides fallback, som dirigerar säkerhetsflaggade förfrågningar till Claude Opus 4.8 eller Claude Opus 5, och fallbacken stod för ungefär 4% av outputtoken över indexet. Poängen är Fable 5.1 såsom de flesta faktiskt kallar den, inte den råa modellen i isolering.
Om ditt arbete är avancerad matematik eller naturvetenskap: Astra. Om det är den breda, svåra typ av resonemang som Humanity's Last Exam testar: Fable 5.1.
Astra äger denna dimension, mest för att Anthropic inte publicerat jämförbara siffror. OpenAI rapporterar 72,6% för Astra på OSWorld 2.0:s offline-svit mot 70,2% för Claude Opus 5, och 92,7% på ScreenSpot-Pro mot 87,3% för Claude Fable 5. Anthropics egna Fable 5.1-siffror, 77,9% partial och 41,7% strict, kommer från en annan uppgiftsrelease och bedömningssetup.
Artefaktsiffrorna är mindre tvetydiga: 95,9% på BenchCAD mot 84,3%, och 41,4% mot 31,4% på AutomationBench.
För agenter som klickar sig igenom verklig programvara och producerar presentationer eller CAD-output är Astra det starkare valet.
Astras alignment-siffror är den mest underdiskuterade delen av lanseringen. På OpenAI:s interna säkerhetsbenchmark för datoranvändning, där lägre är bättre, får den 2,4% mot 9,5% för Fable 5.1.
Inom cybersäkerhet ligger den i en annan klass: 100% på ExploitBench och 86 av 226 FrontierCyber-utmaningar lösta mot 34 för GPT-5.6 Sol i Irregulars oberoende testning. Anthropic släppte på Fable 5.1 tillräckligt för att hitta sårbarheter men inte utnyttja dem.
Två brasklappar, båda värda saltet:
Astra är både den säkrare agenten och den mer kapabla angriparen, därav insläppsbegränsningarna.
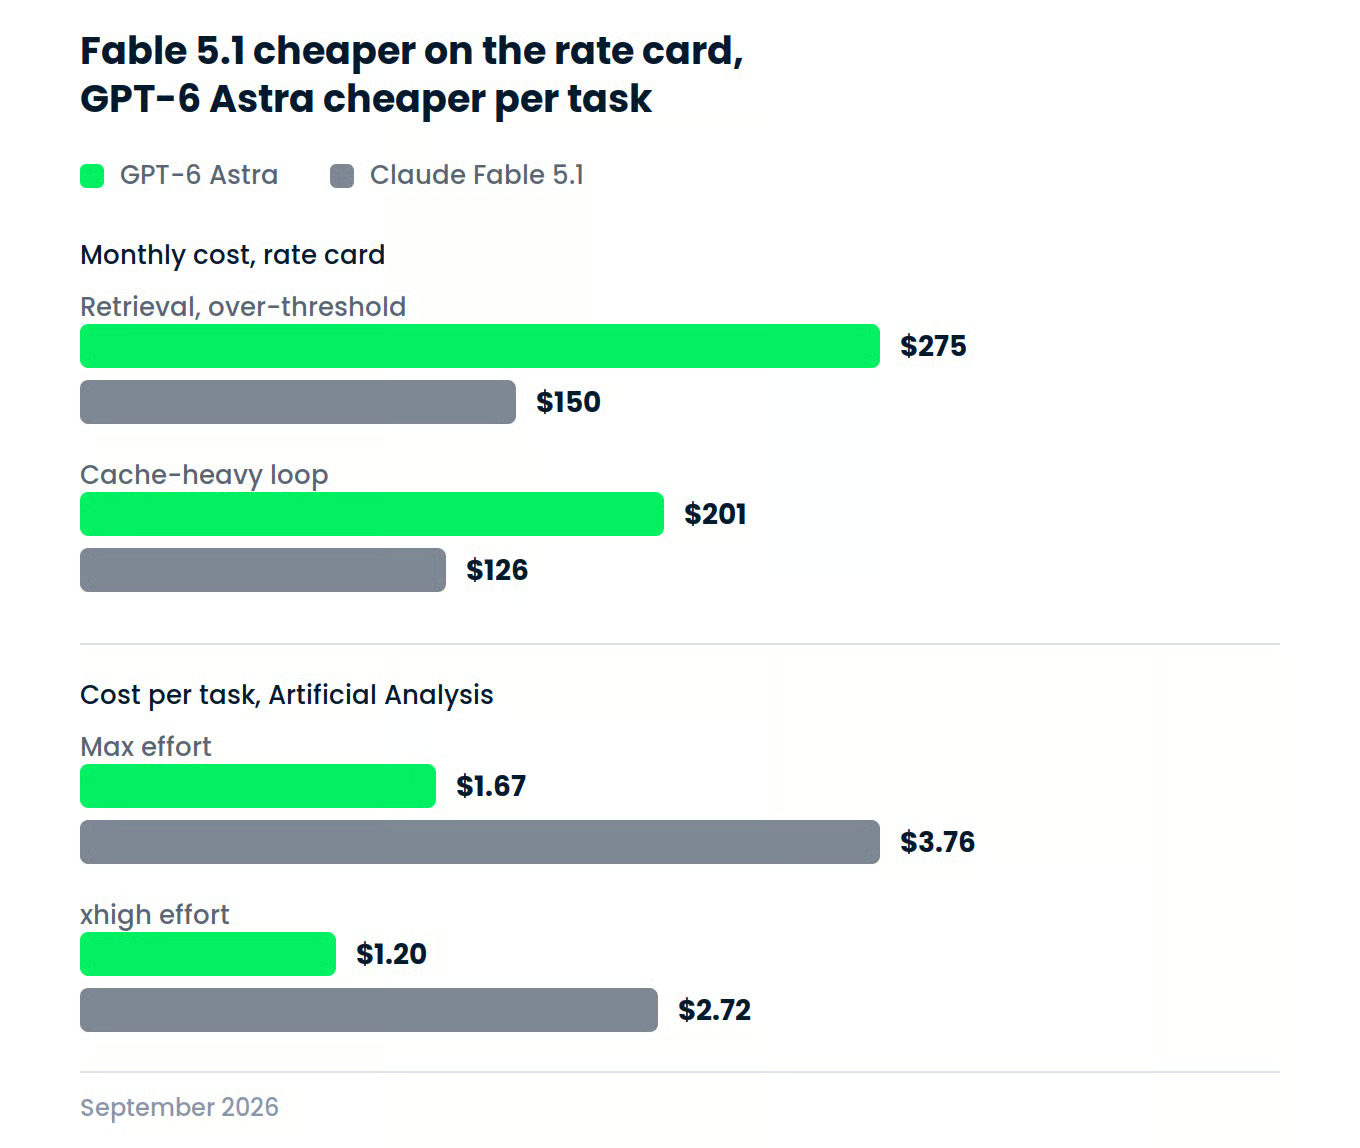
Listtaxorna är identiska, så i prislistan kommer den enda skillnaden mellan dessa två modeller från caching och långt kontextfönster. Den inramningen gäller bara om båda modellerna förbrukar samma antal token på samma uppgift, och det gör de inte, vilket är anledningen till att de uppmätta per-uppgiftssiffrorna längre ned betyder mer än prislistan.
| Taxa | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input, per 1M token | $10,00 | $10,00 |
| Output, per 1M token | $50,00 | $50,00 |
| Cacheläst input, per 1M token | $1,00 | $0,25 |
| Cache write (5 minuter), per 1M token | $12,50 | $12,50 |
| Batchrabatt | 50% | 50% |
| Taxor över 272K inputtoken | $20,00 in / $2,00 cached / $75,00 ut | Ingen tilläggsavgift |
Input, output, cache writes och batchrabatt matchar på centen. Raden för cacheläsning är undantaget, och det är ett 4x-glapp: Anthropic sänker Fable 5.1:s cacheläsningar till $0,25, medan OpenAI prissätter Astras till $1,00, en 90% rabatt på dess inputtaxa.
Över 272K inputtoken vidgas gapet till 8x, eftersom OpenAI:s tilläggsavgift fördubblar cacheläsningar till $2,00 tillsammans med input, medan Anthropics prissättningsdokument lägger hela kontextfönstret på 1M token på standardtaxor. Notera hur lågt den tröskeln ligger i förhållande till vad Astra annonserar: 272K är ungefär en fjärdedel av dess eget 1,05M-fönster, så alla förfrågningar som använder mer än en fjärdedel av det kontext den levereras med debiteras på den högre nivån.
Cacheläsningar är taxan som ackumuleras över en lång loop, eftersom en agent skickar om samma systemprompt, verktygsdefinitioner och repo-kontekst i varje vända. Vår guide till promptcaching går igenom mekaniken i skillnaden mellan cache write och cache read, om den är ny för dig.
Allt i den här tabellen är listprisaritmetik på en fast tokenform, inte ett uppmätt resultat. Den besvarar frågan ”om båda modellerna förbrukade identiska token, vad skulle prislistan debitera?” Nästa avsnitt besvarar frågan vad de faktiskt förbrukar.
| Arbetslast | GPT-6 Astra | Claude Fable 5.1 | Skillnad |
|---|---|---|---|
| Balanserad assistent: 1M in / 250K ut | $22,50 | $22,50 | $0, 0% |
| Återhämtning, under tröskel: 10M in / 1M ut | $150 | $150 | $0, 0% |
| Återhämtning, över tröskel: 10M in / 1M ut | $275 | $150 | $125, 83% mer för Astra |
| Cache-tung loop: 100K prefix, 1 000 läsningar | $201 | $126 | $75, 59% mer för Astra |
Formeln är densamma för varje rad: (volym ÷ 1M) × taxa, summerat över ny input, cacheläsningar, cache writes och output. Den cache-tunga raden antar ett prefix på 100K som skrivs en gång och läses tillbaka 1 000 gånger, plus 5K ny input och 1K output per förfrågan.
Raden för återhämtning över tröskel är rubriken. Håll varje förfrågan under 272K inputtoken, och de två modellerna kostar exakt samma $150. Skicka igenom samma 10M token i förfrågningar som var och en överstiger 272K, så hoppar Astra till $275 medan Fable 5.1 ligger kvar på $150, eftersom Anthopic prissätter hela kontextfönstret på 1M token till standardtaxor.
Den cache-tunga loopen är den de flesta läsare kommer att stöta på. Vid 1 000 cacheläsningar av ett 100K-prefix förvandlas $0,75-gapet per miljon cacheade token till en skillnad på $75 på en i övrigt identisk arbetslast. Notera formen på arbetslasten, dock: den är medvetet output-lätt, 1K outputtoken per förfrågan mot 100K cacheläsningar. Det är den ena form där Fable 5.1:s cachefördel avgör fakturan.
När du mäter verklig tokenförbrukning i stället för att anta den, vänds bilden. Artificial Analysis prissätter varje modell per uppgift i Intelligence Index, och metoden inkluderar redan input, cacheträff, cache write, resonemangs- och svarstoken, så Fable 5.1:s billigare cache är inbakad i siffran.
| Ambitionsnivå | GPT-6 Astra: poäng/kostnad per uppgift | Claude Fable 5.1: poäng/kostnad per uppgift |
|---|---|---|
| max | 61 / $1,67 | 66 / $3,76 |
| xhigh | 61 / $1,20 | 65 / $2,72 |
På max effort kostar Fable 5.1 2,25 gånger så mycket som Astra för samma uppsättning uppgifter till samma listpris. Artificial Analysis når samma slutsats på sitt kodningsindex, där Astra matchar Fable 5 ”till mindre än halva kostnaden, drivet av betydande tokeneffektivitetsvinster”. Astras spann går ned till $0,46 per uppgift på låg effort.
Fable 5.1 straffas inte av sin prislista här, utan av sin outputvolym. Artificial Analysis mätte att den använde cirka 1,7x outputtoken jämfört med Fable 5 på max effort, vilket är varför den kostar 20% mer per uppgift än sin föregångare trots cachesänkningen. Tar du bort sänkningen skulle siffran vara cirka $5,16, så rabatten gör verklig nytta, bara inte tillräckligt.
Du betalar den premien för något. Fable 5.1 får 5 poäng högre på samma index, och 4 poäng högre på xhigh. Om 5 poäng är värt 2,25x är ditt beslut, inte mitt, men versionen av den här jämförelsen där identiska listpriser innebär identiska fakturor överlever inte mötet med mätningarna.
OpenAI:s egna bildtexter pekar åt samma håll, för vad en leverantörs självrapport är värd. Man sätter Astras uppskattade API-kostnad per uppgift till ungefär 31% under Fable 5.1 på Terminal-Bench Science 0.1, ungefär 63% under på Terminal-Bench 4.0, och ungefär 86% under på BenchCAD, mätt vid de ambitionsinställningar OpenAI valde för respektive modell.
Astra vann vårt test marginellt totalt sett, även om båda modellerna levererade en fungerande simulering vid första försöket.
Jag körde en svår uppgift mot båda modellerna under identiska förhållanden i stället för flera ytliga. Testet som valdes för denna jämförelse är en fysiksimulering byggd från grunden som en enda HTML-fil, vald eftersom den prövar precis det som båda leverantörerna hävdar sig ha förbättrat: uthållig korrekthet under en lång byggprocess, utan något bibliotek att luta sig mot.
Detta är en uppdaterad variant av det testet. Den publicerade varianten använde en roterande fyrkantig behållare, så denna körning byter in en roterande hexagon med ett motroterande centralt hinder och storleksproportionell massa, vilket höjer svårighetsgraden samtidigt som inneslutningen förblir ett entydigt godkänt eller underkänt. Här är prompten, inklistrad ordagrant i en ny chatt för varje modell:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external libraries, no network) that simulates a few dozen balls of varying sizes bouncing under gravity inside a **slowly rotating hexagonal container**, with a **smaller counter-rotating obstacle at the centre** that the balls also collide with.
Ball mass should scale with size, so larger balls shove smaller ones around.
The balls should collide with each other, with the hexagon's walls, and with the central obstacle, and lose a little energy on each collision so the system settles rather than gaining energy over time.
Both the hexagon and the inner obstacle keep rotating throughout, so the balls should slosh and re-pile as they turn.

Ship it as one working file named `index.html` that starts animating on load.
Do not install packages.
Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome).
Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Båda modellerna körs på hög resonemangsnivå, ett försök vardera utan omtag, i samma kodagent med samma verktyg. Bedömningen är först ett körbarhetskontroll godkänd/underkänd, därefter en rubric på 1 till 5 för fysikkorrekthet, stabilitet över 30 sekunder och visuell kvalitet.
Astra klarade körbarhetskontrollen och fick 5/5 på alla tre rubrikaxlarna. Den kom dit på 6 vändor och 9 verktygsanrop, och verktygsmixen är den intressanta delen: den skrev filen, läste tillbaka den 5 gånger, grepade den två gånger och patchade den två gånger innan den deklarerade sig klar.
Simuleringen är korrekt. 44 bollar, massa som skalar med area, inneslutningen håller i fulla 30 sekunder medan hexagonen roterar. Astra dimensionerade det inre hindret stort i förhållande till kammaren, så bollar fortsätter att kollidera med det i stället för att lägga sig där det inte når dem.
Den byggde också en hel redaktionell sida runt simuleringen, med en serifrubrik, glesade monospace-etiketter och en telemetripanel som rapporterar live rotationshastigheter. Ingen bad om det, men det ser riktigt trevligt ut enligt min mening. Den skickade även med paus- och omstartskontroller, vilket prompten aldrig begärde, men som gjorde artefakten lättare att granska.
Astra vrider kammaren med 0,09 rad/s och hindret med -0,16 rad/s, cirka 3 gånger långsammare än Fable på ytterväggen och 5 gånger långsammare på hindret. Lättare att titta på, och ett mildare test av den rörliga gränsen än en snabbare rotation hade varit. Eftersom prompten efterfrågar en långsamt roterande behållare är detta bra.
| Mått | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Vändor | 6 | 2 |
| Verktygsanrop | 9 | 1 |
| Körbarhet | Godkänd | Godkänd |
| Fysikkorrekthet | 5 | 4 |
| Stabilitet över tid | 5 | 5 |
| Visuell kvalitet | 5 | 4 |
| Rubric-poäng | 5,0 | 4,3 |
Astra tar denna på kvalitet, och marginalen är större på presentation än på fysik. Där de skiljer sig åt är vad varje modell ansåg att jobbet var. Astra läste prompten som en brief att tolka, lade till kontroller, en fullständig redaktionell layout och en långsammare rotation som passar att titta på. Fable läste den som en specifikation att uppfylla, uppfyllde den i en skrivning och lade sin återstående insats på en diagnostisk HUD.
Detta är en körning per modell, så betrakta det som en datapunkt snarare än ett benchmark. Den rapporterar vändor snarare än token eller kostnad, och prövar endast kod för simulering från grunden, inte dimensionerna för datoranvändning eller resonemang som täcks ovan.
Eftersom listtaxorna matchar handlar beslutet om arbetslastens form, uppmätt tokenförbrukning och den kodagent du redan kör. De tre siffror som bör påverka dig är 4x-gapet i cacheläsning, 272K-tröskeln för tilläggsavgift och den uppmätta kostnaden per uppgift på 2,25x.
| Yta | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Konsumentapp | ChatGPT Plus, Pro, Business, Enterprise | Claude web, mobil, skrivbord (Pro, Max, Team, Enterprise) |
| Förstaparts-API | OpenAI API | Claude API |
| Molnplattformar | Amazon Bedrock, Microsoft Azure/Foundry | Amazon Bedrock, Google Cloud, Microsoft Azure/Foundry |
| Kodningsagenter | Codex | Claude Code, Cursor |
| Tredjepartsroutrar | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| API-modell-ID | gpt-6-astra |
claude-fable-5-1 |
Två åtkomstdetaljer kan stoppa dig innan ditt första anrop. Astra är avstängd som standard för företagsarbetsytor tills en administratör slår på den, och Fable 5.1 kräver 30 dagars dataretention och stöds inte på Priority Tier. Molnmässigt är räckvidden nästan jämn dem emellan, där Google Cloud för närvarande är den enda plattform Fable 5.1 har och GPT-6 Astra inte har.
Varje modell är inhemsk i sitt eget ramverk, Astra i Codex och Fable 5.1 i Claude Code, där du byter med /model claude-fable-5-1 eller flaggan --model. Via API:t är bytet en sträng, även om SDK:erna skiljer sig.
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-fable-5-1",  # OpenAI SDK equivalent: model="gpt-6-astra"
    max_tokens=16000,          # thinking plus response share this budget
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": "Refactor this module..."}],
)
print(response.content[0].text)
Tre ändringar i Fable 5.1 kommer att bryta kod skriven för Fable 5: framtvingat verktygsval ger nu 400, tidigare modeller kan inte läsa dess tänkandeblock, och tänkandeblock binds till den exakta historiken före dem. Vår Claude Fable 5.1 API-handledning går igenom alla tre, och vår nybörjarguide till OpenAI API täcker motsvarande setup på andra sidan.
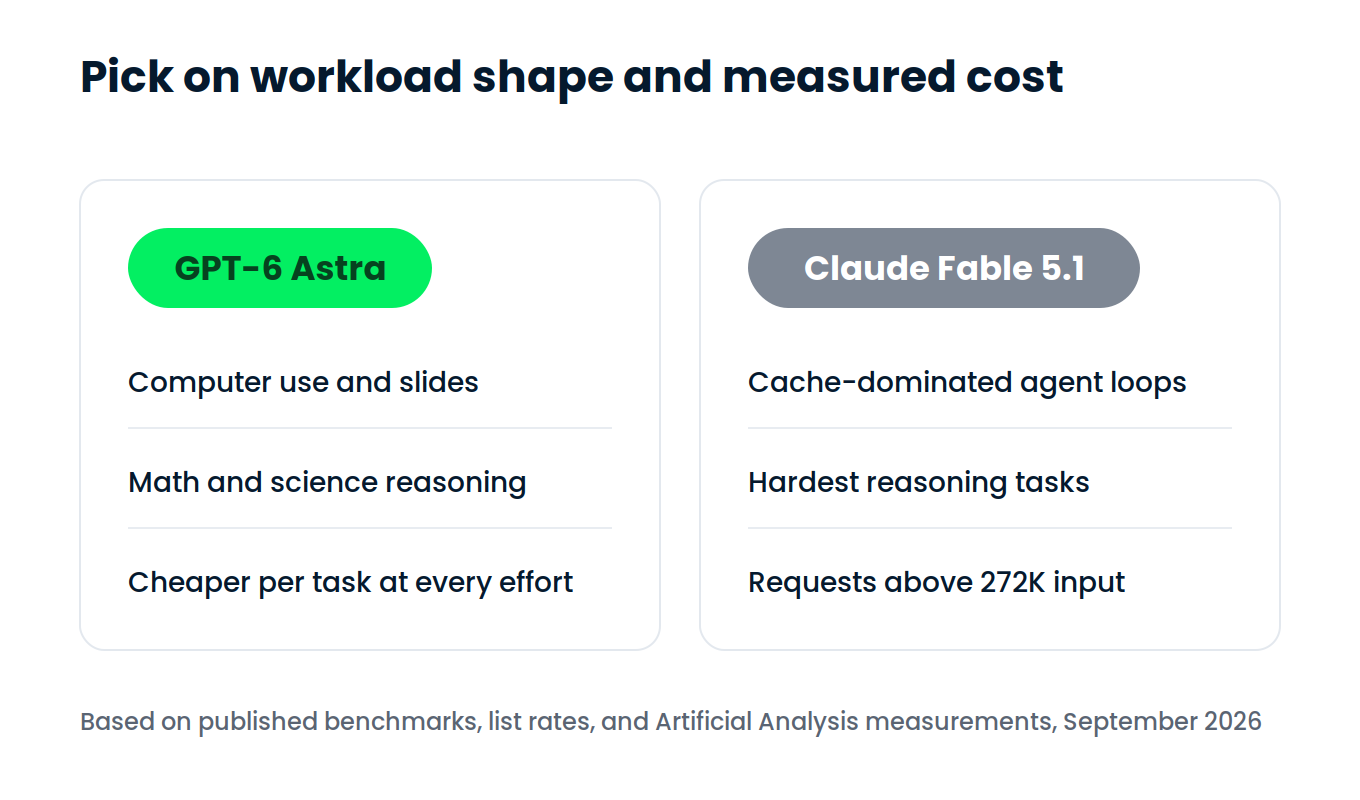
Välj efter arbetslastens form och uppmätt kostnad, inte efter benchmarktabellerna. GPT-6 Astra är starkare för agenter som klickar genom programvara, gör matematik eller producerar kundklara artefakter, och den verkar vara billigare per uppgift trots identisk prislista. Claude Fable 5.1 ger dig det högsta oberoende resonemangsbetyget som finns och kostar mindre på mycket stora förfrågningar och på cache-dominerade loopar.
Prislistan är fällan i den här jämförelsen. Två modeller på $10 och $50 ser utbytbara ut i pris, och det enda synliga gapet, cacheläsningar, gynnar Anthropic med 4x. Sedan mäter du vad var och en faktiskt förbrukar för att slutföra en uppgift, och Astra landar på 44% av Fable 5.1:s kostnad. Det hade jag inte förutspått från prissidorna, och det är den enskilt viktigaste saken jag skulle kontrollera mot din egen trafik innan du bestämmer dig.
Om du vill arbeta med någon av modellerna i stället för att läsa om dem rekommenderar jag vår kurs Introduction to Claude Models för Anthropics sida och Working with the OpenAI API för OpenAI:s.
Lär dig AI med DataCamp!
Kurs
Kurs
Kurs