
Program
AI İşletme Temelleri
12 sa
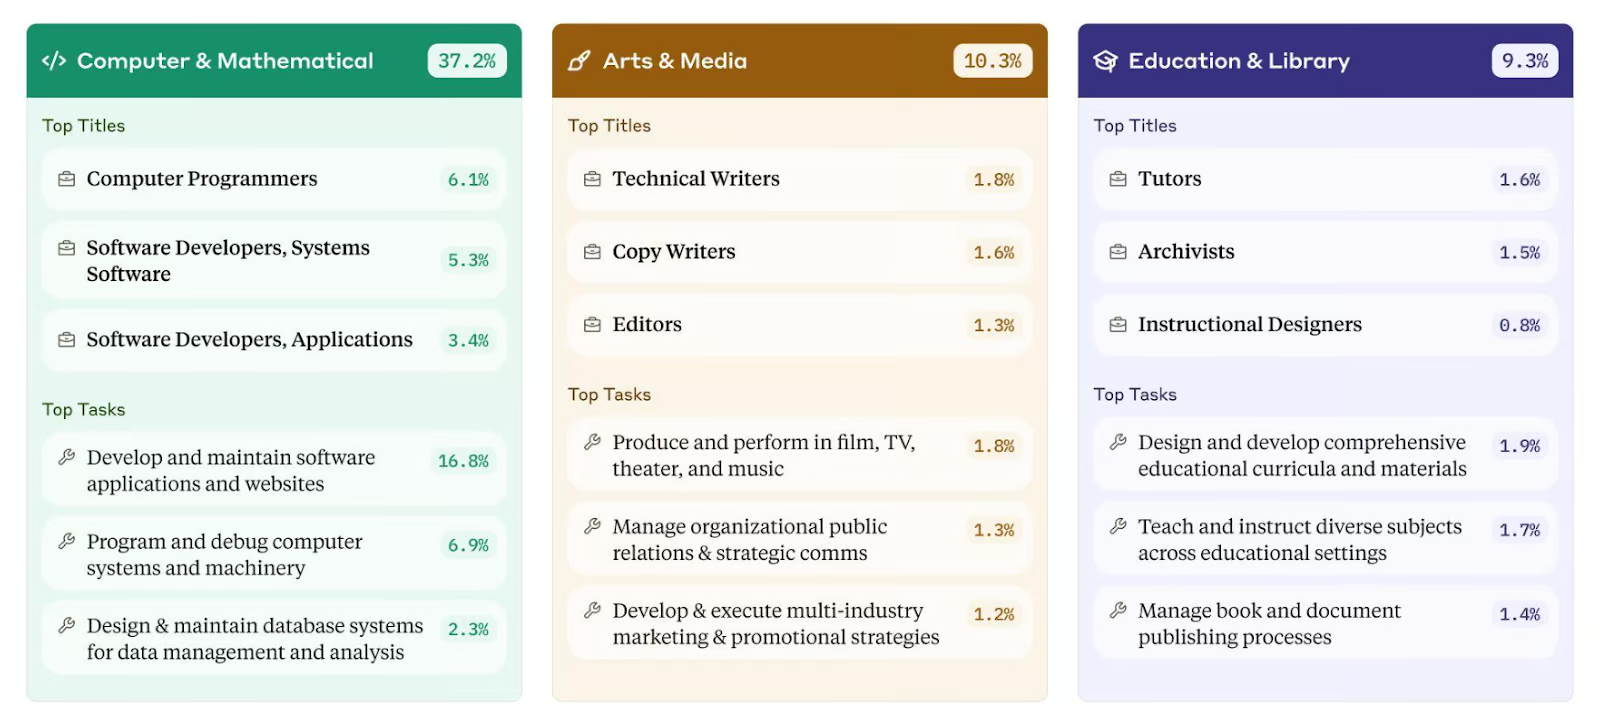
Muhakeme modelleri giderek daha önemli ve yaygın hale geliyor; nedenini anlamak zor değil. Aşağıdaki grafiğe baktığınızda, Anthropic Economic Index'e göre kullanıcıların %37,2’sinin kodlama ve matematik soruları için Claude’a başvurduğunu fark edeceksiniz. Bu da bize şunu söylüyor—güçlü muhakeme modelleri, özellikle kurumsal ortamlarda yapay zekâ benimsemesi düşüken seyrederken, gerçek iş değeri sağlayabilir.
Kaynak: Antrophic Economic Index
Aynı zamanda Claude 3.7 yalnızca bir muhakeme modeli değil—hibrit bir yapıya sahip. Yapılandırılmış muhakeme görevleri için Düşünme Modu ile genel sohbet, yazma ve özetleme için standart sohbet modu arasında geçiş yapabiliyoruz.
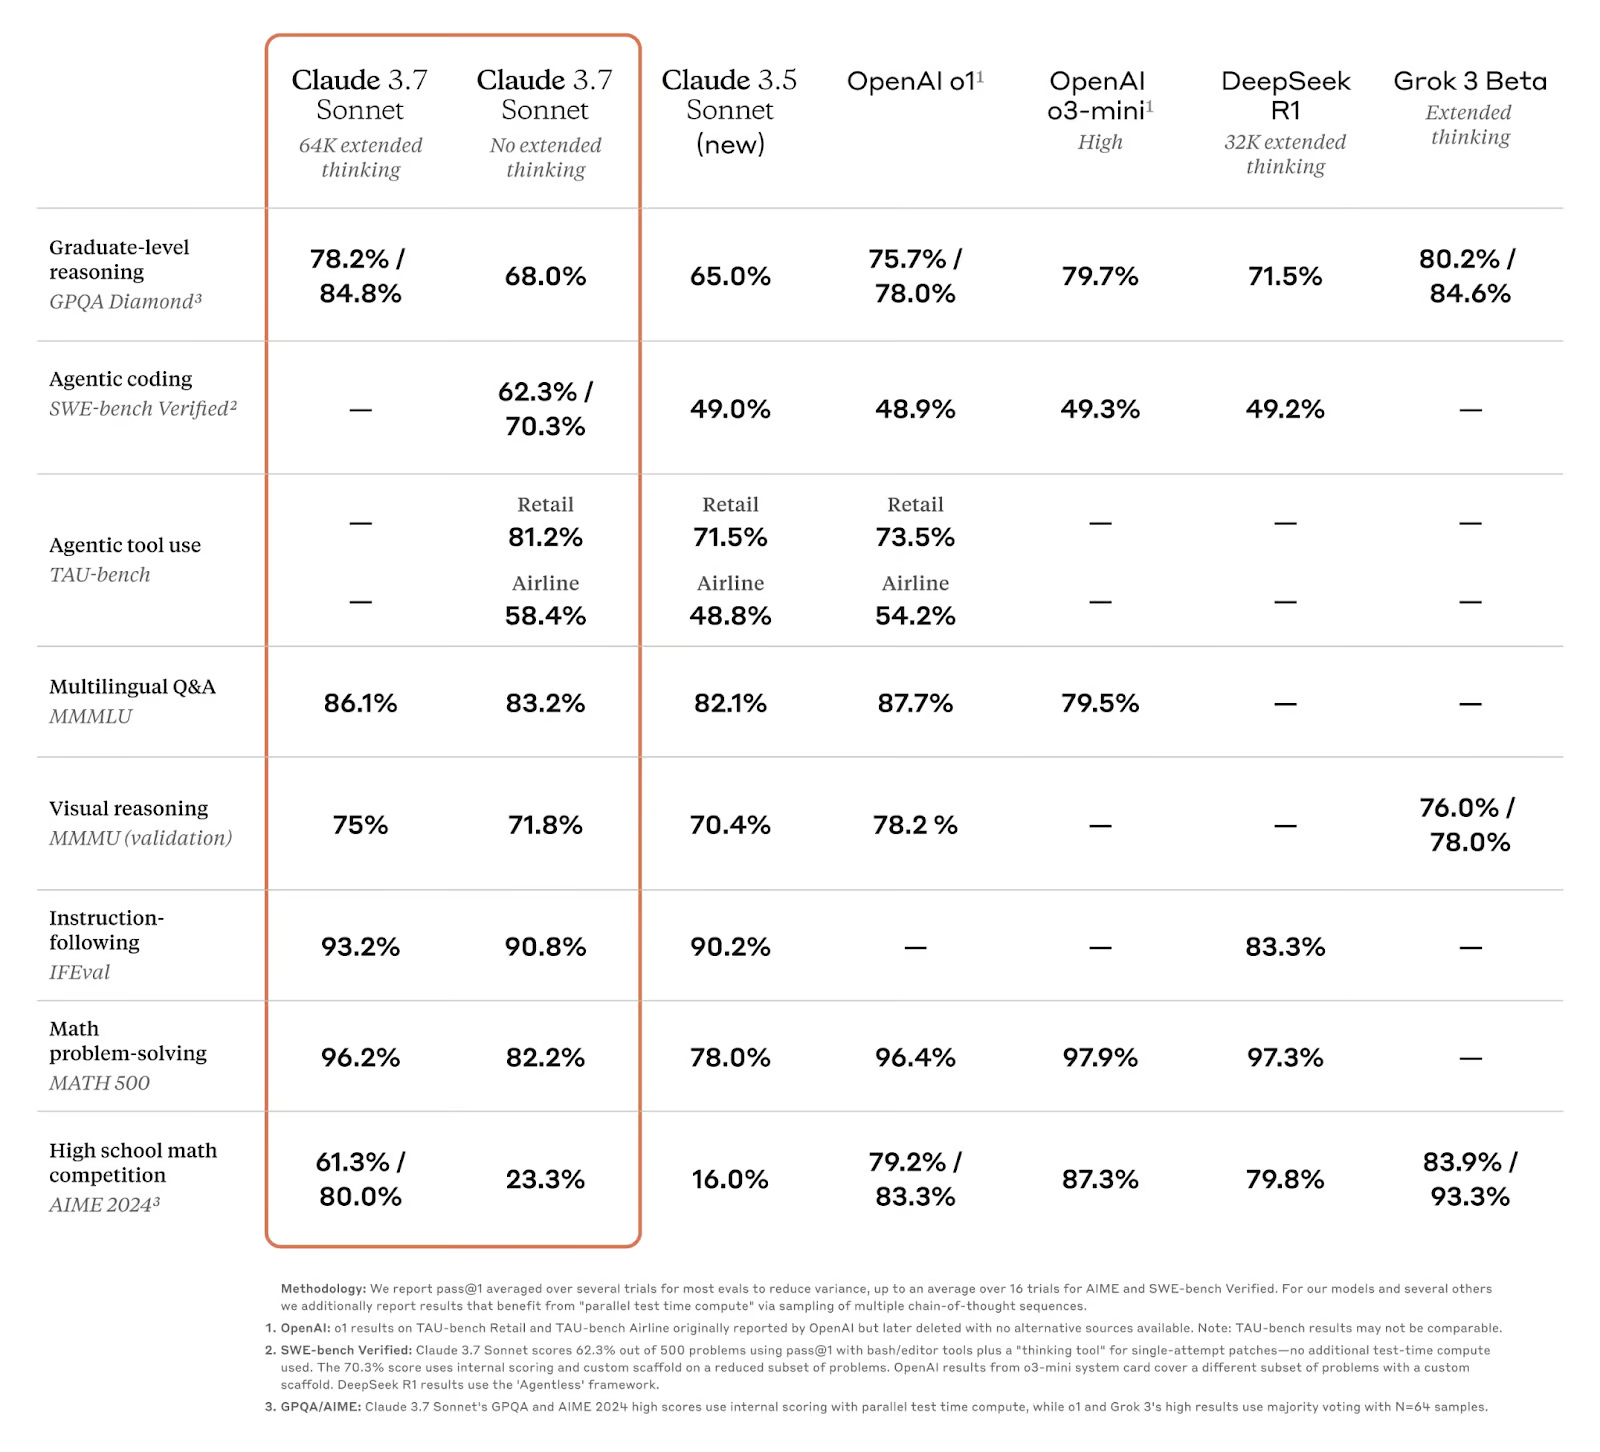
Claude 3.7 Sonnet, sürüm numarasının önerdiğinden çok daha büyük bir yükseltme. Karşılaştırma verileri, muhakeme, kodlama ve gerçek dünya görev yürütmede Claude 3.5 Sonnet‑ı geride bıraktığını doğruluyor.
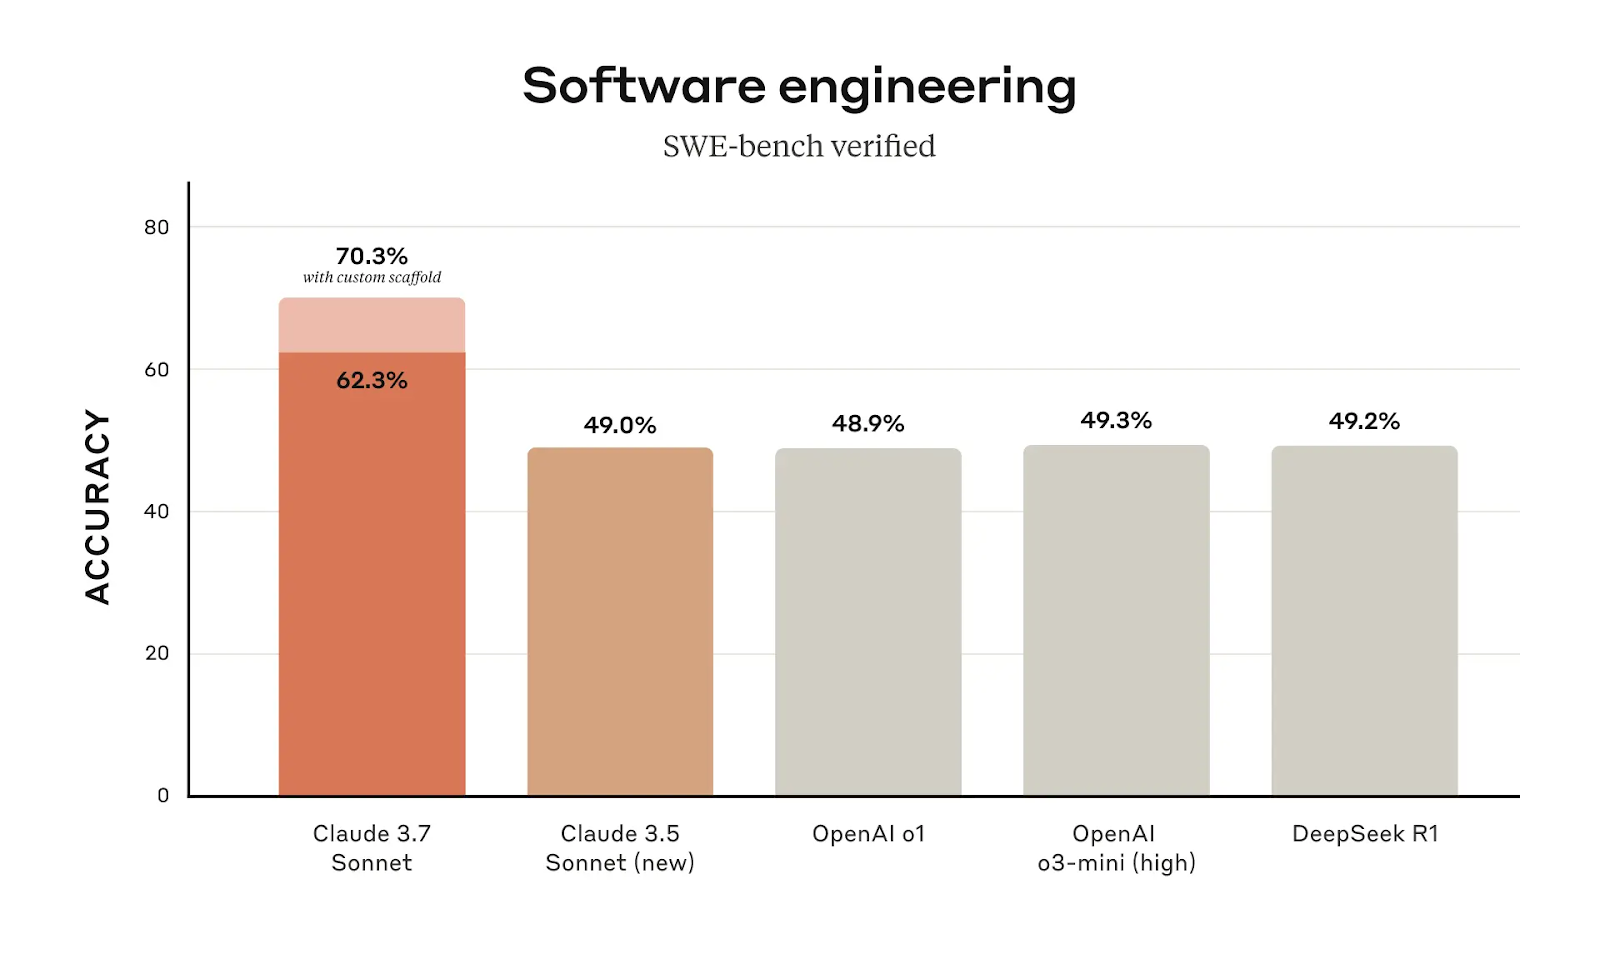
Claude 3.7 Sonnet, yazılım mühendisliğinde belirgin bir üstünlük gösteriyor; SWE-bench Verified'da %62,3 doğruluk puanı alarak Claude 3.5 Sonnet’in %49,0'ından kayda değer ölçüde yükseliyor. Özel bir iskelet (modelin yanıtını daha doğru bir çözüme yönlendirmeye yardımcı olan yapılandırılmış bir istem veya ek bağlam) kullanıldığında bu doğruluk %70,3’e çıkarak bu kategoride en iyi performans gösteren model oluyor.
Kaynak: Anthropic
Model sürümleri arasında yaklaşık %13’lük doğruluk artışı, basit bir ince ayardan ibaret değil. Bu, Claude 3.7 Sonnet’ın programlama ile ilgili görevleri anlama ve yürütme konusunda optimize edildiğini gösteriyor. Yazılım mühendisliği, hata ayıklama veya otomasyon için Claude’a güvenen kullanıcılar için bu yükseltme somut bir fark yaratıyor.
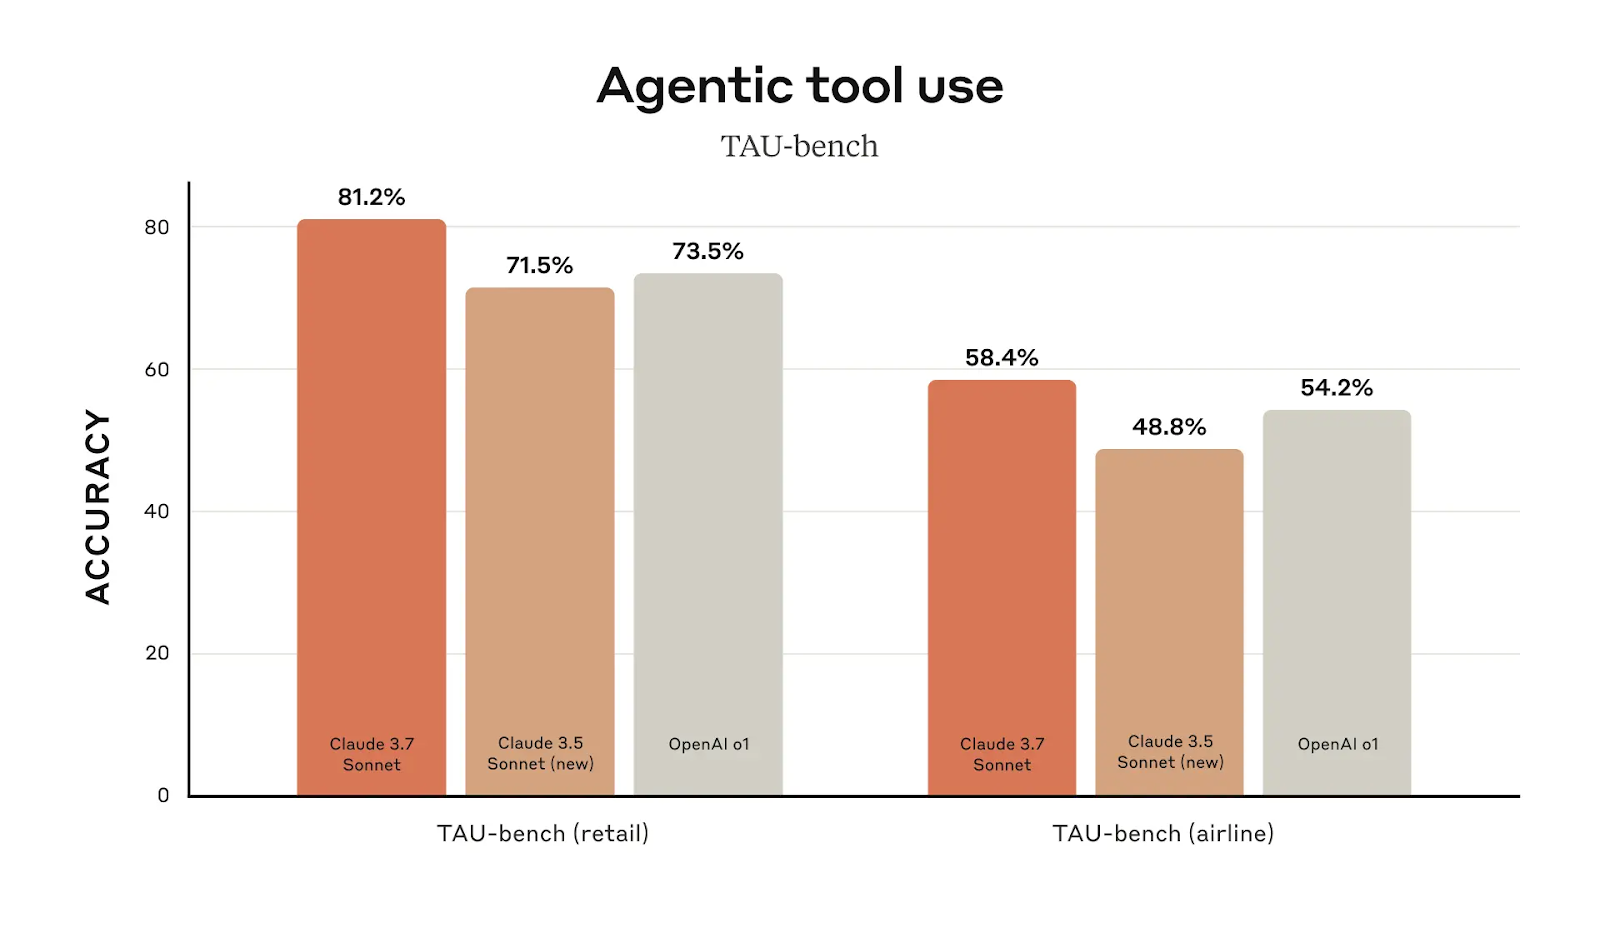
Aracı araç kullanımı performansı, Claude 3.7 Sonnet’in selefini aştığı diğer bir alan. Perakende ile ilişkili görevlerde %81,2 doğruluğa ulaşıyor; bu oran Claude 3.5 Sonnet’in %71,5’inden yüksek. Havayolu ile ilişkili görevlerde ise %58,4 puan alarak önceki sürüme göre yaklaşık on puanlık bir iyileşme sağlıyor.
Kaynak: Anthropic
Tüm karşılaştırmalar genelinde en büyük kazançlar, Claude 3.7’nin karmaşık muhakeme görevlerinde çok daha üst düzeyde performans göstermesine olanak tanıyan genişletilmiş düşünmeden geliyor. Yapılandırılmış iş akışları, kodlama veya sorun çözme için yapay zekadan yararlanan kullanıcılar, özellikle genişletilmiş düşünme kullanıldığında Claude 3.5 ile Claude 3.7 arasında net bir fark görecektir.
Kaynak: Anthropic
Bu ilerlemenin çoğu Claude’un genişletilmiş düşünmesinden geliyor; o halde bununla ilgili daha fazla bilgi edinelim.
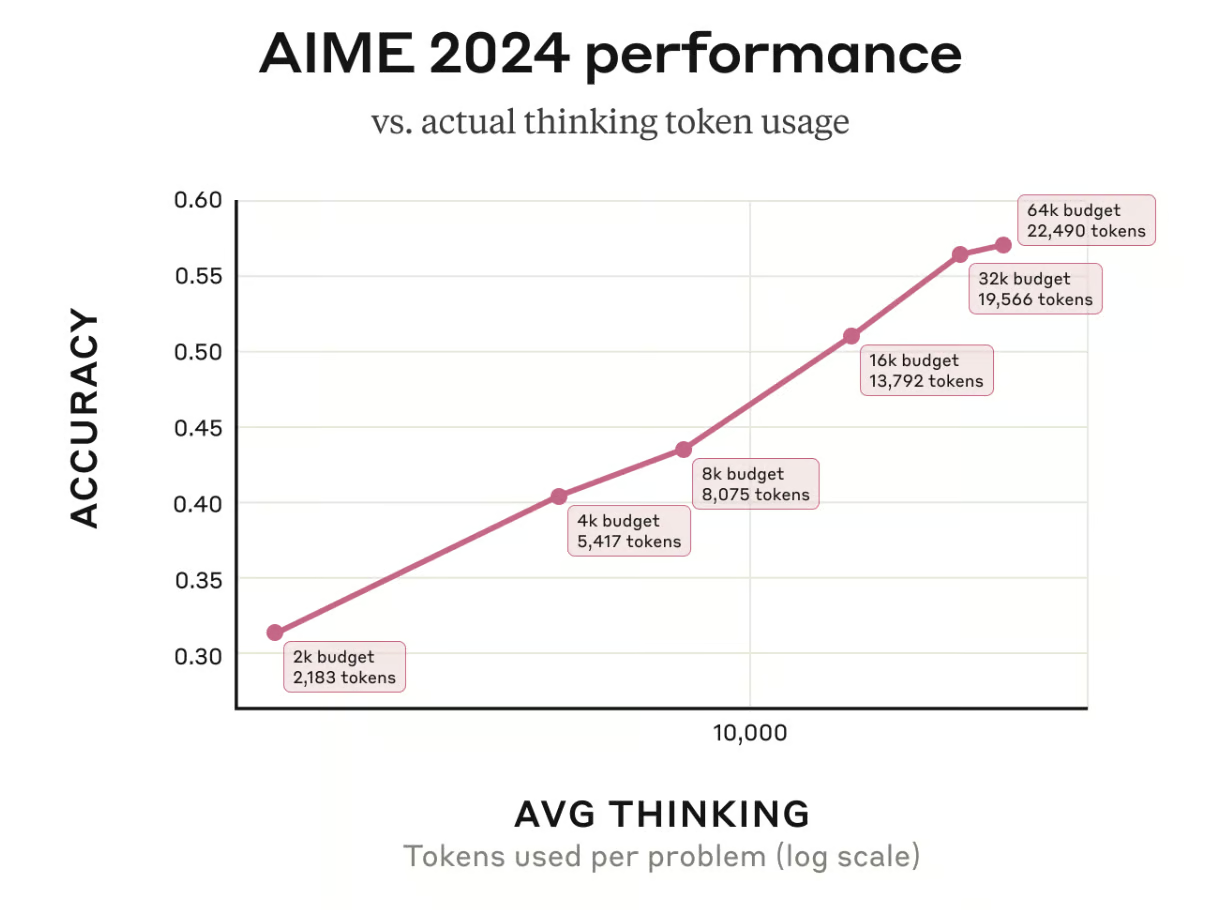
Etkinleştirildiğinde, genişletilmiş düşünme modu, Claude’un bir yanıtı sonlandırmadan önce attığı muhakeme adımlarının sayısını artırır. Geliştiriciler bu süreci, modelin bir sorunu çalışırken kullanabileceği belirteç sayısını tanımlayan bir düşünme bütçesi ayarlayarak ince ayar yapabilir. Aşağıdaki AIME 2024 performans grafiğinde gösterildiği gibi, daha fazla belirteç ayrıldıkça doğruluk logaritmik bir eğilimle artar.
Kaynak: Anthropic
Bu yaklaşım, insan bilişsel çabasını andırır: basit görevlerde hızlı yanıtlar yeterliyken, karmaşık olanlarda daha derin analiz daha iyi sonuçlara yol açar. Claude artık anında yanıtlara varsayılan olarak dönmek yerine ne zaman durup yeniden değerlendirme yapacağına ve muhakemesini nasıl rafine edeceğine karar verebiliyor.
Genişletilmiş düşünme modunun en ilginç yönlerinden biri, Claude’un muhakeme sürecinin kullanıcıya görünür olması. Ancak bu özellik bazı zorlukları da beraberinde getiriyor. Yapay zekânın muhakemesine dair bir içgörü sunsa da, görüntülenen düşünce süreci, modelin gerçekte nasıl karar verdiğiyle her zaman mükemmel ölçüde örtüşmek zorunda değil. Bir yapay zekânın kendi bildirdiği düşüncelerinin içsel mekaniklerini doğru yansıtıp yansıtmadığına ilişkin “doğruluk sorunu” halen açık bir araştırma sorusu.
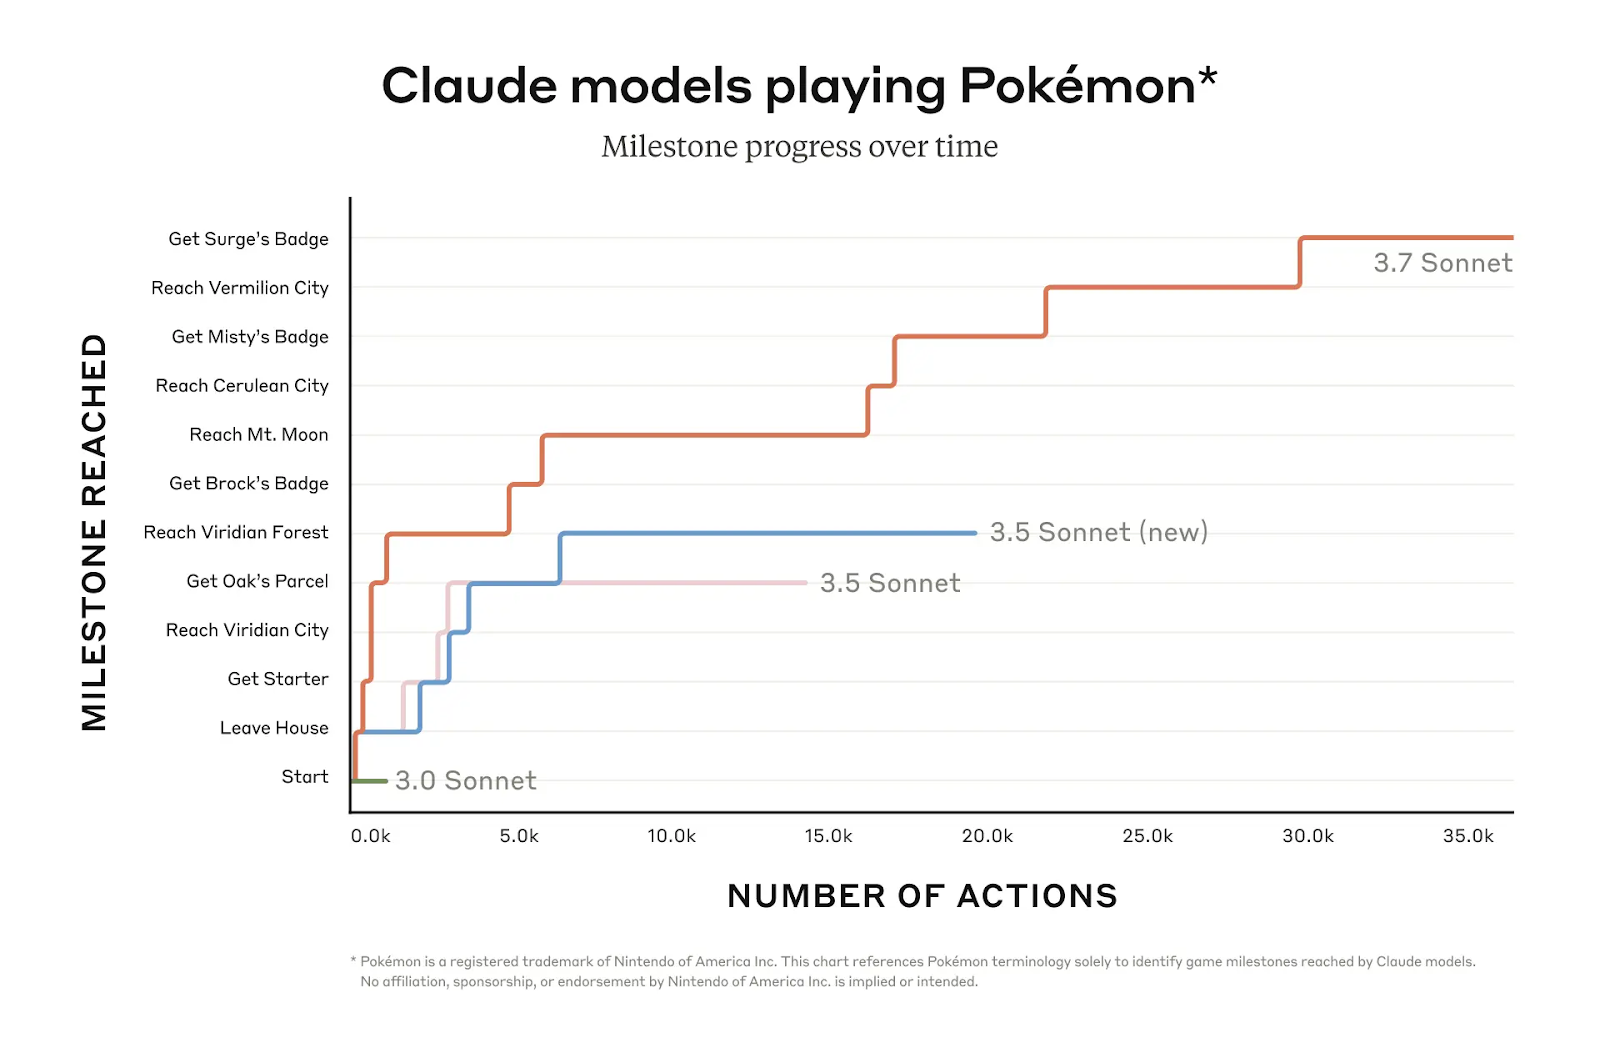
Claude 3.7 Sonnet’in uzun vadeli, yinelemeli muhakemeye girme becerisi, OSWorld ve Pokémon Red oynanışı gibi değerlendirmelerde test ediliyor. Örneğin Pokémon Red’de, Claude 3.7 Sonnet önceki sürümlerden çok daha fazla oyun içi ilerleme kaydediyor; önceki modeller oyunun başlarında takılıp kalırken bu sürüm birden çok kilometre taşını geçiyor.
Kaynak: Anthropic
Claude 3.7 Sonnet’in önceki sürümüne karşı nasıl performans gösterdiğini gördük; peki OpenAI’nin o3-mini’si, DeepSeek-R1 veya Grok 3 ile nasıl karşılaştır?
Güncellenmiş karşılaştırmalara bakıldığında, Claude 3.7 Sonnet kendini özellikle muhakeme ağırlıklı görevler, kodlama ve aracı araç kullanımında en iyi performans gösteren modellerden biri olarak konumlandırıyor.
Lisansüstü düzeyde muhakemede (GPQA Diamond), Claude 3.7 Sonnet standart modda %68,0 ve genişletilmiş düşünme modunda %84,8 puan alarak bu kategorideki en güçlü modellerden biri oluyor. OpenAI’nin o1’ini (%78,0) ve DeepSeek-R1’i (%71,5) kayda değer ölçüde geride bırakıyor ve Grok 3 Beta’ya (%84,6) ise yalnızca ufak bir farkla yaklaşıyor.
|
Karşılaştırma |
Claude 3.7 Sonnet (Standart) |
Claude 3.7 Sonnet (Genişletilmiş Düşünme) |
OpenAI o1 |
OpenAI o3-mini (yüksek) |
DeepSeek R1 |
Grok 3 Beta |
|
GPQA Diamond (Lisansüstü düzeyde muhakeme) |
68.0% |
84.8% |
78.0% |
79.7% |
71.5% |
84.6% |
|
AIME 2024 (Lise matematik yarışması) |
23.3% |
80.0% |
83.3% |
87.3% |
79.8% |
93.3% |
|
Matematik Problem Çözme (MATH 500) |
82.2% |
96.2% |
96.4% |
97.9% |
97.3% |
- |
AIME 2024 karşılaştırması, lise matematik yarışması sorularını test eder ve benzer bir eğilim gösterir. Claude 3.7 Sonnet, genişletilmiş düşünme etkinleştirildiğinde %80,0 puan alarak önceki sürümlerden büyük bir sıçrama yapar. DeepSeek-R1’i (%79,8) küçük bir farkla geçse de, OpenAI’nin o3-mini’sinin (%87,3) ve Grok 3 Beta’nın (%93,3) gerisinde kalır.
Matematik problem çözmede (MATH 500), Claude 3.7 Sonnet %96,2’ye ulaşarak OpenAI’nin o3-mini’si (%97,9) ve DeepSeek R1’e (%97,3) yakın bir performans sergiliyor.
Claude 3.7 Sonnet en büyük kazançlarını kodlama karşılaştırmalarında elde ediyor. Yazılım mühendisliği görevlerinde BMM’leri değerlendiren SWE-bench Verified’da Claude 3.7 Sonnet %62,3 puan alıyor ve özel bir iskelet ile %70,3’e yükseliyor. Bu da onu, kodlama odağlı tasarlanan DeepSeek R1 (%49,2) ile birlikte OpenAI’nin o1 (%48,9) ve o3-mini (%49,3) modellerinin oldukça önüne geçiriyor. Bu, Claude 3.7’nin artık programlama ile ilgili görevler için en iyi yapay zeka modellerinden biri olduğunu doğruluyor.
|
Karşılaştırma |
Claude 3.7 Sonnet (Standart) |
Claude 3.7 Sonnet (Özel İskelet) |
OpenAI o1 |
OpenAI o3-mini (yüksek) |
DeepSeek R1 |
|
SWE-bench Verified (Kodlama) |
62.3% |
70.3% |
48.9% |
49.3% |
49.2% |
|
TAU-bench Perakende (Araç Kullanımı) |
81.2% |
- |
73.5% |
- |
- |
|
TAU-bench Havayolu (Araç Kullanımı) |
58.4% |
- |
54.2% |
- |
- |
Kodlamanın ötesinde, Claude 3.7 Sonnet aracı araç kullanımında da önde gelerek otomasyon ve iş akışı yürütme için güçlü bir seçenek sunuyor. TAU-bench’te (yapay zekânın yapılandırılmış ortamlarda harici araçlarla etkileşime girme becerisini ölçer) Claude 3.7, perakende ile ilgili görevlerde %81,2’ye ulaşarak OpenAI o1’i (%73,5) geride bırakıyor. Havayolu ile ilgili görevlerde de %58,4’e ulaşarak yine OpenAI o1’i (%54,2) geride bırakıyor.
Bu da Claude 3.7’nin iş uygulamaları ve yapılandırılmış iş akışları için iyi bir uyum sunduğunu; karar alma ve operasyonel süreçlerine yapay zekâ entegre etmek isteyen kurumsal kullanıcılar için güçlü bir seçenek olduğunu gösteriyor.
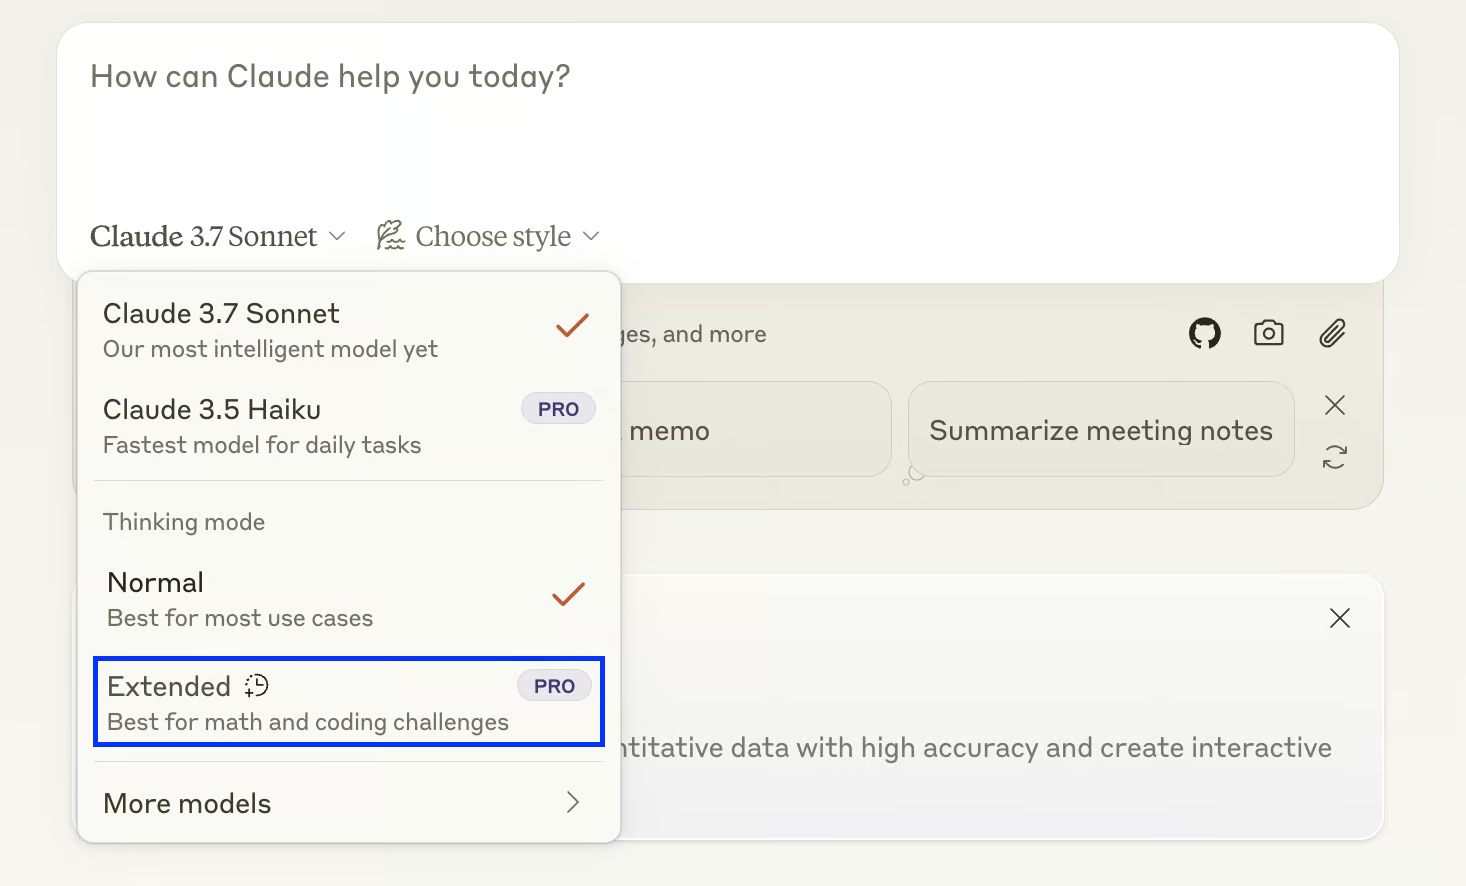
Claude 3.7 Sonnet, Anthropic’in web arayüzü, çeşitli uygulamalardaki Claude entegrasyonları ve geliştiriciler için API erişimi dahil birden fazla kanal aracılığıyla kullanıma sunuluyor. Model kayda değer bir yükseltme olsa da, erişilebilirlik bazı sınırlamalarla birlikte geliyor—özellikle de şu anda ücretli katmanda kilitli olan Düşünme Modu’nu kullanmak istiyorsanız.
Genel kullanıcılar için Claude 3.7 Sonnet, Anthropic’in resmî web sitesi (claude.ai) ve Claude uygulaması üzerinden erişilebilir. Ücretsiz katmanda sunulur, ancak bazı kısıtlamalar vardır:
Düşünme Modu’nu etkinleştirmek için model açılan menüsünden Extended seçeneğine tıklamanız gerekir:
Geliştiriciler, Claude 3.7 Sonnet’i Anthropic’in geliştirici portalı aracılığıyla erişilebilir olan Anthropic API’sini kullanarak uygulamalarına entegre edebilir. API, belirteç kullanımına dayalı kullandıkça öde fiyatlandırma modelini destekler.
İşte Anthropic’in API sunumlarının bir özeti:
|
Özellik |
Claude 3.7 Sonnet |
Claude 3.5 Sonnet |
Claude 3.5 Haiku |
Claude 3 Opus |
Claude 3 Haiku |
|
Açıklama |
En zeki modelimiz |
Önceki en zeki modelimiz |
En hızlı modelimiz |
Karmaşık görevler için güçlü model |
Anlık yanıtlar için en hızlı ve en kompakt model |
|
Güçlü yanlar |
Açılıp kapatılabilir genişletilmiş düşünme ile en üst düzey zeka ve yetenek |
Yüksek düzey zeka ve yetenek |
İnanılmaz hızlarda zeka |
Üst düzey zeka, akıcılık ve anlama |
Hızlı ve doğru hedefli performans |
|
Çok dilli |
Evet |
Evet |
Evet |
Evet |
Evet |
|
Görü |
Evet |
Evet |
Evet |
Evet |
Evet |
|
Evet |
Hayır |
Hayır |
Hayır |
Hayır |
|
|
API model adı |
claude-3-7-sonnet-20250219 |
Güncellenmiş sürüm: claude-3-5-sonnet-20241022 Önceki sürüm: claude-3-5-sonnet-20240620 |
claude-3-5-haiku-20241022 |
claude-3-opus-20240229 |
claude-3-haiku-20240307 |
|
Görece gecikme |
Hızlı |
Hızlı |
En hızlı |
Orta hızda |
En hızlı |
|
Bağlam penceresi |
200K |
200K |
200K |
200K |
200K |
|
Azami çıktı |
Normal: 8192 belirteç Genişletilmiş düşünme:64000 belirteç |
8192 belirteç |
8192 belirteç |
4096 belirteç |
4096 belirteç |
|
Maliyet (Girdi / Çıktı MTok başına) |
$3.00 / $15.00 |
$3.00 / $15.00 |
$0.80 / $4.00 |
$15.00 / $75.00 |
$0.25 / $1.25 |
|
Eğitim verisi kesim tarihi |
Eki 2024 |
Nis 2024 |
Tem 2024 |
Ağu 2023 |
Ağu 2023 |
Kaynak: Anthropic
En güncel API fiyatlandırmasını her zaman kontrol ettiğinizden emin olun.
Anthropic, Claude 3.7 Sonnet ile bir süredir en büyük hamlesini yaptı ve sonunda muhakeme odaklı yapay zekâ alanına giriş yaptı. Karşılaştırmalara göre, kodlama, yapılandırılmış sorun çözme ve aracı araç kullanımında güçlü performansıyla OpenAI’nin o3-mini’si, DeepSeek-R1 ve Grok 3 için meşru bir rakip olduğunu görüyoruz.
Genelist ve muhakeme modları arasında geçiş yapabilme yeteneği onu daha esnek kılsa da, Düşünme Modu’nun ücret duvarının arkasında kilitlenmesi, özellikle ücretsiz alternatifler varken, talihsiz bir adım gibi hissettiriyor. Yine de, Claude 3.7 büyük bir ilerleme.
Bir sonraki adıma hazır mısınız? Kendi çok modlu araştırma asistanınızı nasıl oluşturabileceğinizi göstereceğimiz Claude 3.7 Sonnet API videomuza göz atın.
Bu kurslarla yapay zekâyı öğrenin!
Program
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




