Kurs
Google Gemini ve NotebookLM ile Pratik AI
2 sa
10K
Google, Flash modellerini yetişmesi zor bir hızda yayımlıyor. Gemini 3.8 Flash, şirketin altı haftadaki üçüncü Flash sürümü ve Flash katmanındaki en iyi akıl yürütme ve kodlama modeli olarak, üç hafta önce çıkan 3.7 Flash ile aynı hız ve düşük maliyetle geliyor.
Standart modelin yanında, Google yalnızca güvenilir savunuculara Fairwind Programı aracılığıyla sunulan, siber güvenlik işleri için ayarlanmış Gemini 3.8 Flash Cyber'ı tanıttı. Her iki model de aynı temel zekâyı paylaşıyor.
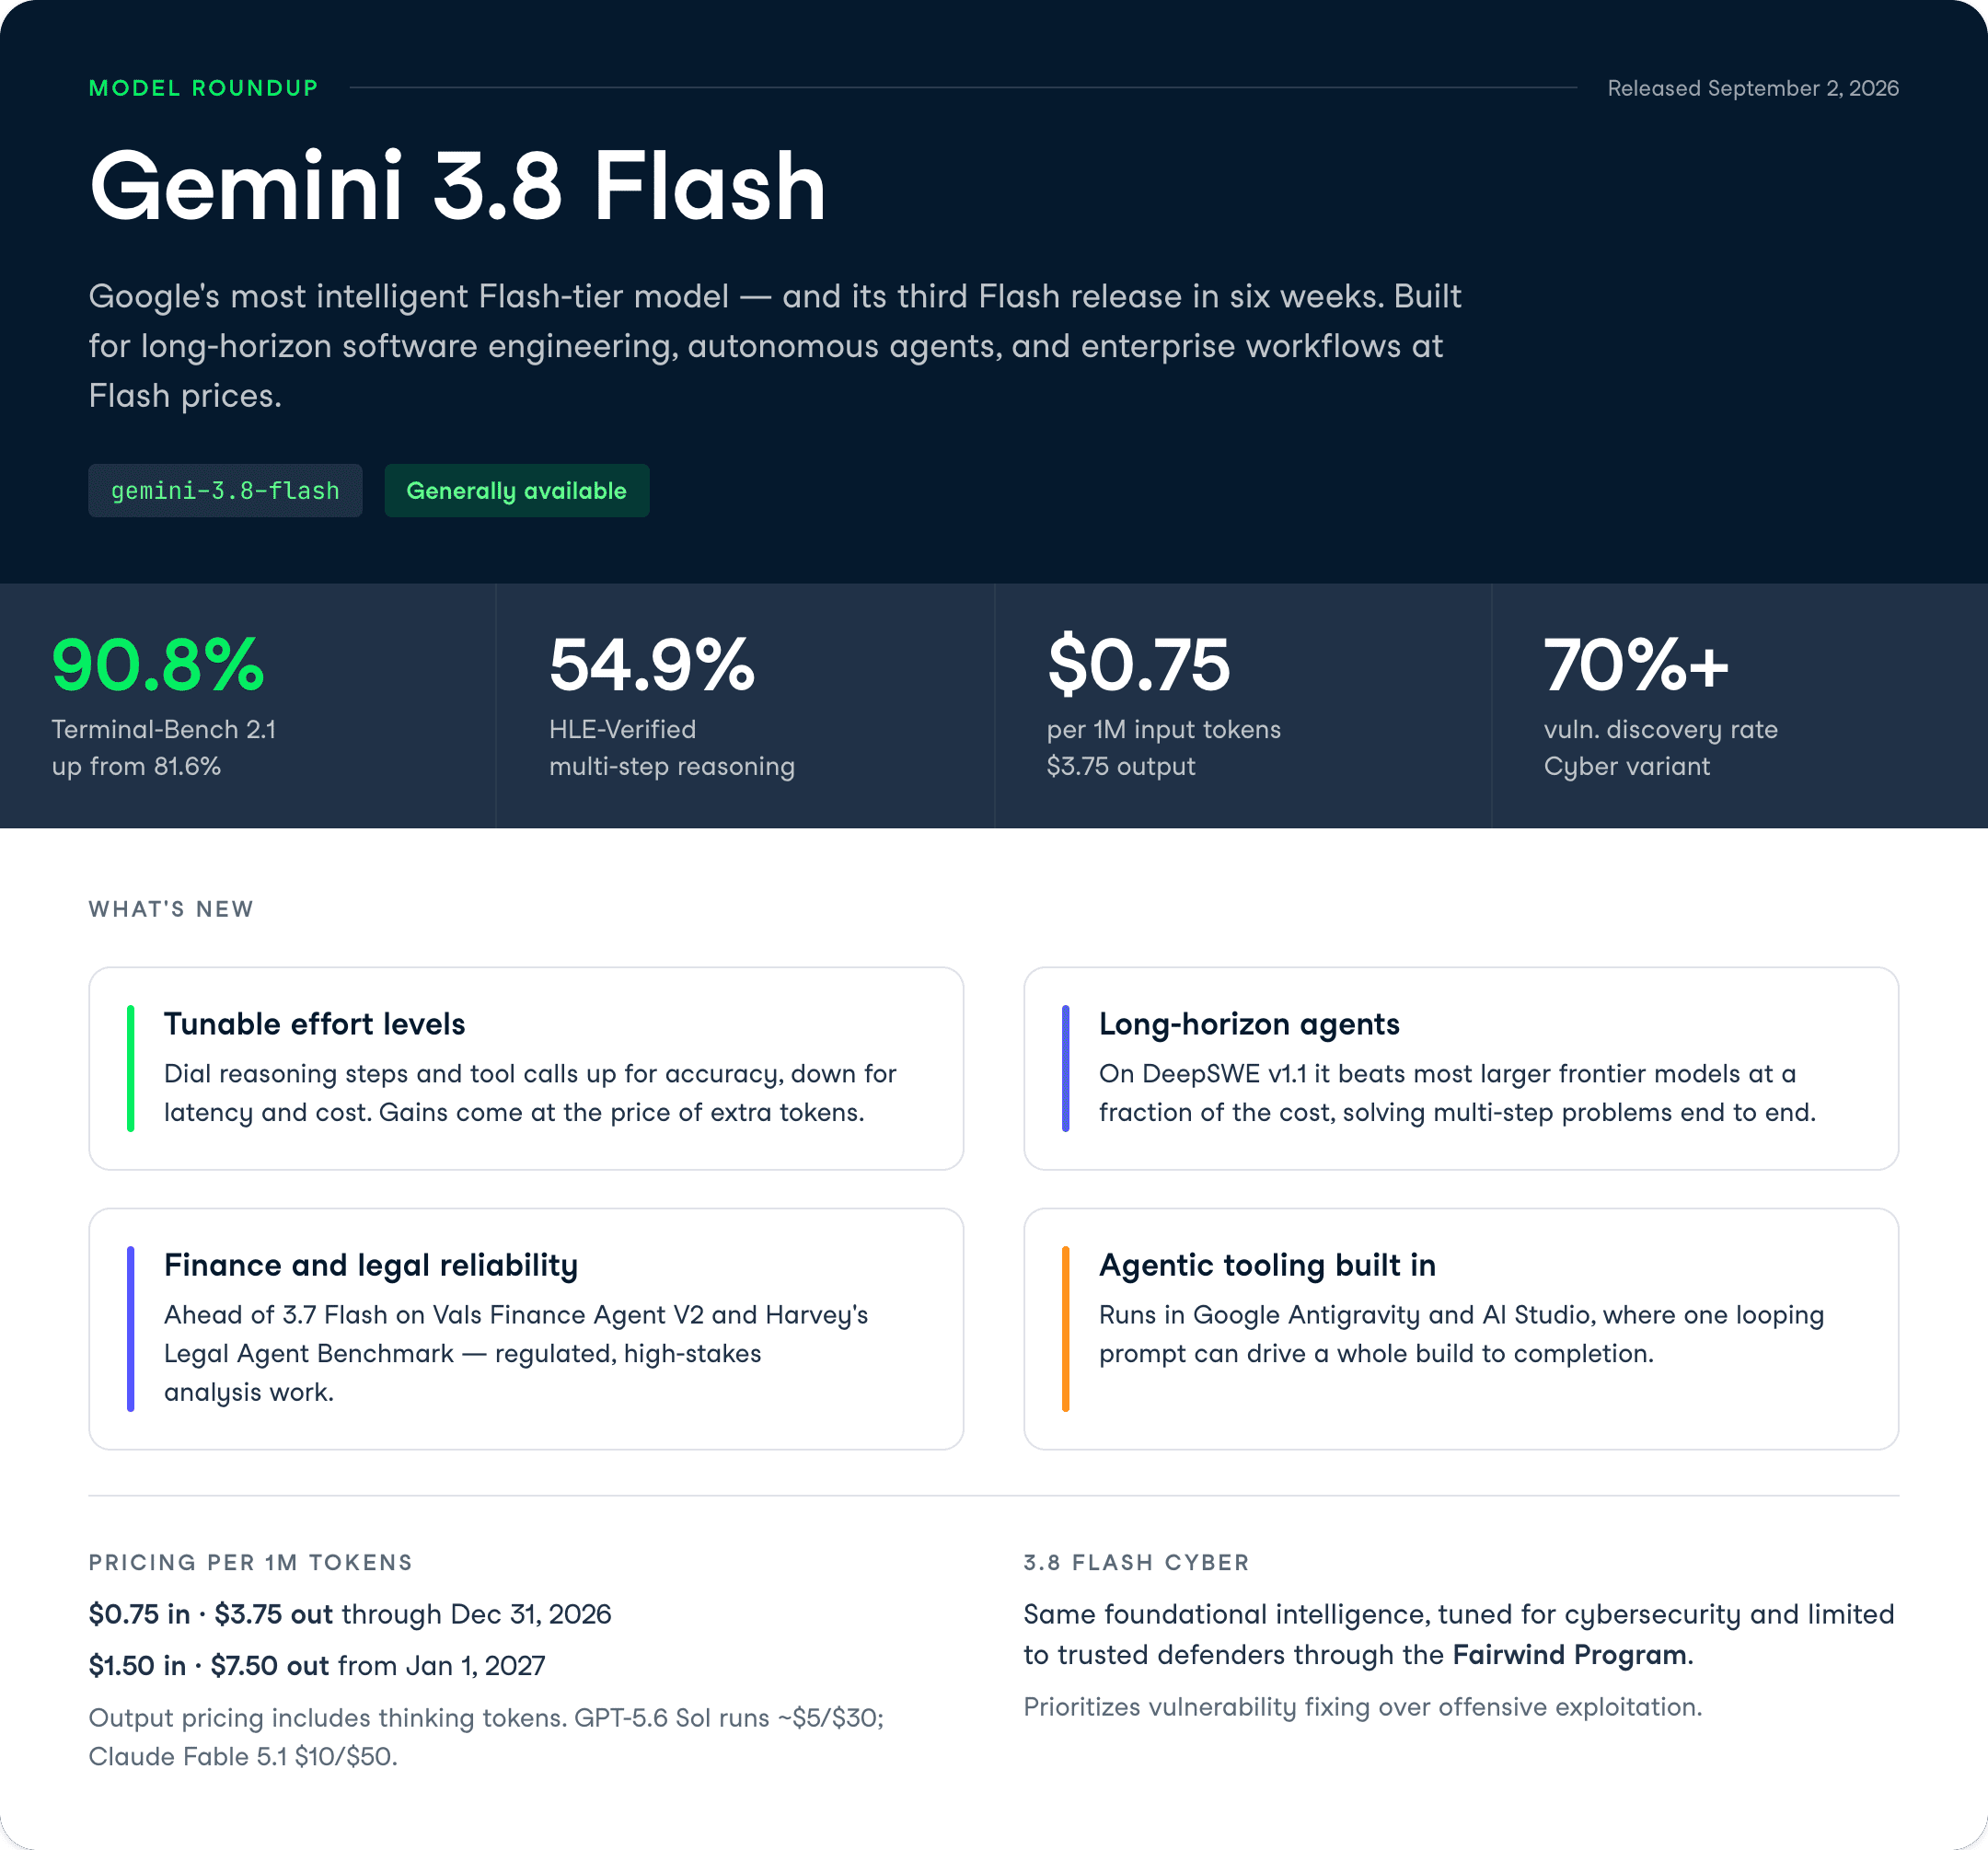
Dikkat çekici başlık sayıları güçlü: Gemini 3.8 Flash, Terminal-Bench 2.1'de %90,8 (3.7 Flash için %81,6'dan yukarı), HLE-Verified'da %54,9 ve Cyber varyantı için gerçek dünyada güvenlik açığı keşif oranında %70'in üzerinde skor alıyor.
Bu yazıda, Gemini 3.8 Flash ve 3.8 Flash Cyber ile gelen tüm yenilikleri ele alacak, yeni özelliklere bakacak, kıyaslamaları inceleyecek ve uygulamalı örneklerle sınayacağım. Modeli çalışır hâlde görmek için Gemini 3.8 Flash API eğitimimize göz atın; Google'ın en yeni sesli asistan modeli hakkında bilgi için de Gemini 3.8 Live rehberimizi okuyun.
Bu modellerin rekabet ettiği rakipler hakkında hız kazanmak için şu rehberlerimize bakın: DeepSeek v4.1 vs Gemini 3.8 Flash ve Claude Opus 5 vs Sonnet 5.
Gemini 3.8 Flash, uzun ufuklu yazılım mühendisliği, otonom ajanlar ve karmaşık kurumsal iş akışları için tasarlanmış, Google'ın en yetenekli Flash katmanı modelidir.
Pro katmanının (ör. Gemini 3.1 Pro) altında konumlanır ancak maliyetin küçük bir kısmına fiyatlandırılır; 31 Aralık 2026'ya kadar 1M giriş tokenı için $0,75 ve 1M çıkış tokenı için $3,75 olan tanıtım fiyatını korur.
3.7 Flash'tan temel fark, 3.8 Flash'ın basitçe daha çok çalışmasıdır.
Karmaşık görevlerde ek akıl yürütme adımları çalıştırır ve araçları yinelemeli olarak çağırır; bu sayede daha yüksek maliyetli sınır modellerin performansına yaklaşabilir. Bedeli ise token ek yükü: daha yüksek çaba seviyelerinde, model son birkaç puanlık doğruluğu zorlamak için daha fazla token harcayabilir.
En çarpıcı kıyaslama başlığı Terminal-Bench 2.1'de: 3.8 Flash, 3.7 Flash'ın %81,6'sına karşı %90,8 aldı. Terminal-Bench, bir modelin gerçek komut satırı ve kodlama görevlerini uçtan uca ne kadar güvenilir tamamladığını ölçer; dolayısıyla 9 puanlık sıçrama doğrudan daha iyi ajansal kodlama davranışına işaret eder.
 Gemini 3.8 Flash'ta Neler Yeni?
3.8 Flash'taki özellikler, sıradan sohbet kullanıcılarından ziyade ajanlar ve uzun kodlama oturumları çalıştıran geliştiricileri hedefliyor.
İşte bilmeye değer yetenekler.
Doğruluk mu, maliyet mi daha önemli olduğuna göre modelin çabasını artırıp azaltabilirsiniz.
Bu önemli, çünkü 3.8 Flash'ın kazançları ekstra token bedeliyle geliyor.
İş yükünüz verimlilik odaklıysa Google, tam olarak desteklenmeye devam eden 3.7 Flash'ta kalabileceğinizi açıkça belirtiyor.
Bu, Google'ın bir lansman yazısına eklediği alışılmadık ölçüde dürüst bir not ve size çaba ayarının bedelsiz performans değil, gerçek bir ödünleşim olduğunu söylüyor.
Gemini 3.8 Flash, çok adımlı mühendislik problemlerini el tutmadan çözen ajanları çalıştırmak için inşa edildi.
Uzun ufuklu bir yazılım mühendisliği kıyaslaması olan DeepSWE v1.1'de, karmaşık problemleri uçtan uca çözerken maliyetlerinin küçük bir kısmına çoğu daha büyük sınır modelini geride bırakıyor.
Kodlama ajanları inşa eden uygulayıcılar için önemli olan sayı bu.
Reddit ve X'teki sızıntı niteliğindeki ön izlenimler, onu "Fable 5 seviyesinde performans, Flash fiyatlandırmasıyla" diye tanımladı; Wall Street Journal'ın haberine göre de Google'ın dahili Jetski birebir testlerinde mühendisler kodlama için 3.8 Flash'ı Anthropic'in Opus modeline tercih etti.
Bu iddia iddialı ve API yaygınlaştığında doğrulanmaya değer.
3.8 Flash, yanlış cevabın maliyetli olduğu düzenlenmiş, yüksek riskli alanları hedefliyor.
Finans ve hukukta analiz ve raporlamayı test eden Vals Finance Agent V2 ve Harvey's Legal Agent Benchmark'ta 3.7 Flash ve diğer sınır modelleri geride bırakıyor.
Bir ajanın bir dizi çeyreklik bildirimi okuyup bir uyum özeti taslağı çıkardığı ya da sözleşme maddelerini bir politikaya göre incelediği bir iş akışını düşünün. Orada gereken güvenilirlik, genel sohbetten farklıdır ve Google 3.8 Flash'ı bu bilgi alanlarında doğrudan kurumsal özerklik için konumluyor.
Gemini 3.8 Flash, tek bir döngüsel istemin onu tüm bir derleme boyunca yönlendirebildiği Google Antigravity ve Google AI Studio içinde çalışır.
Google'ın kendi örneği, Antigravity'de tek bir istemden üretilen, konumlar, yol tarifi ve Street View ile tam oynanabilir DOS tarzı bir Google Haritalar sürümü.
Kendi çalışmalarınız için, "bu CSV'yi çeken, üç grafik türü çizen ve bölgeye göre filtrelememe izin veren etkileşimli bir gösterge paneli oluştur" gibi tek bir talimat vermeyi ve ajansal döngünün çalışana kadar yinelemesini hayal edin.
Döngüsel talimat kalıbı, modelin ilk taslakta durmak yerine rafine etmeye devam ettiği için ekstra çaba seviyelerinin karşılığını verdiği yerdir.
Kıyaslama tablosu eşit değil; bu da kazançların nereye indiğini gösterdiği için temiz bir süpürmeden daha faydalı.
Kodlama ve terminal görevleri keskin biçimde iyileşirken, sınav tarzı akıl yürütme neredeyse yerinde saydı.
İşte Google'ın geliştirici dokümanları ve duyurusundan gelen sayılar.
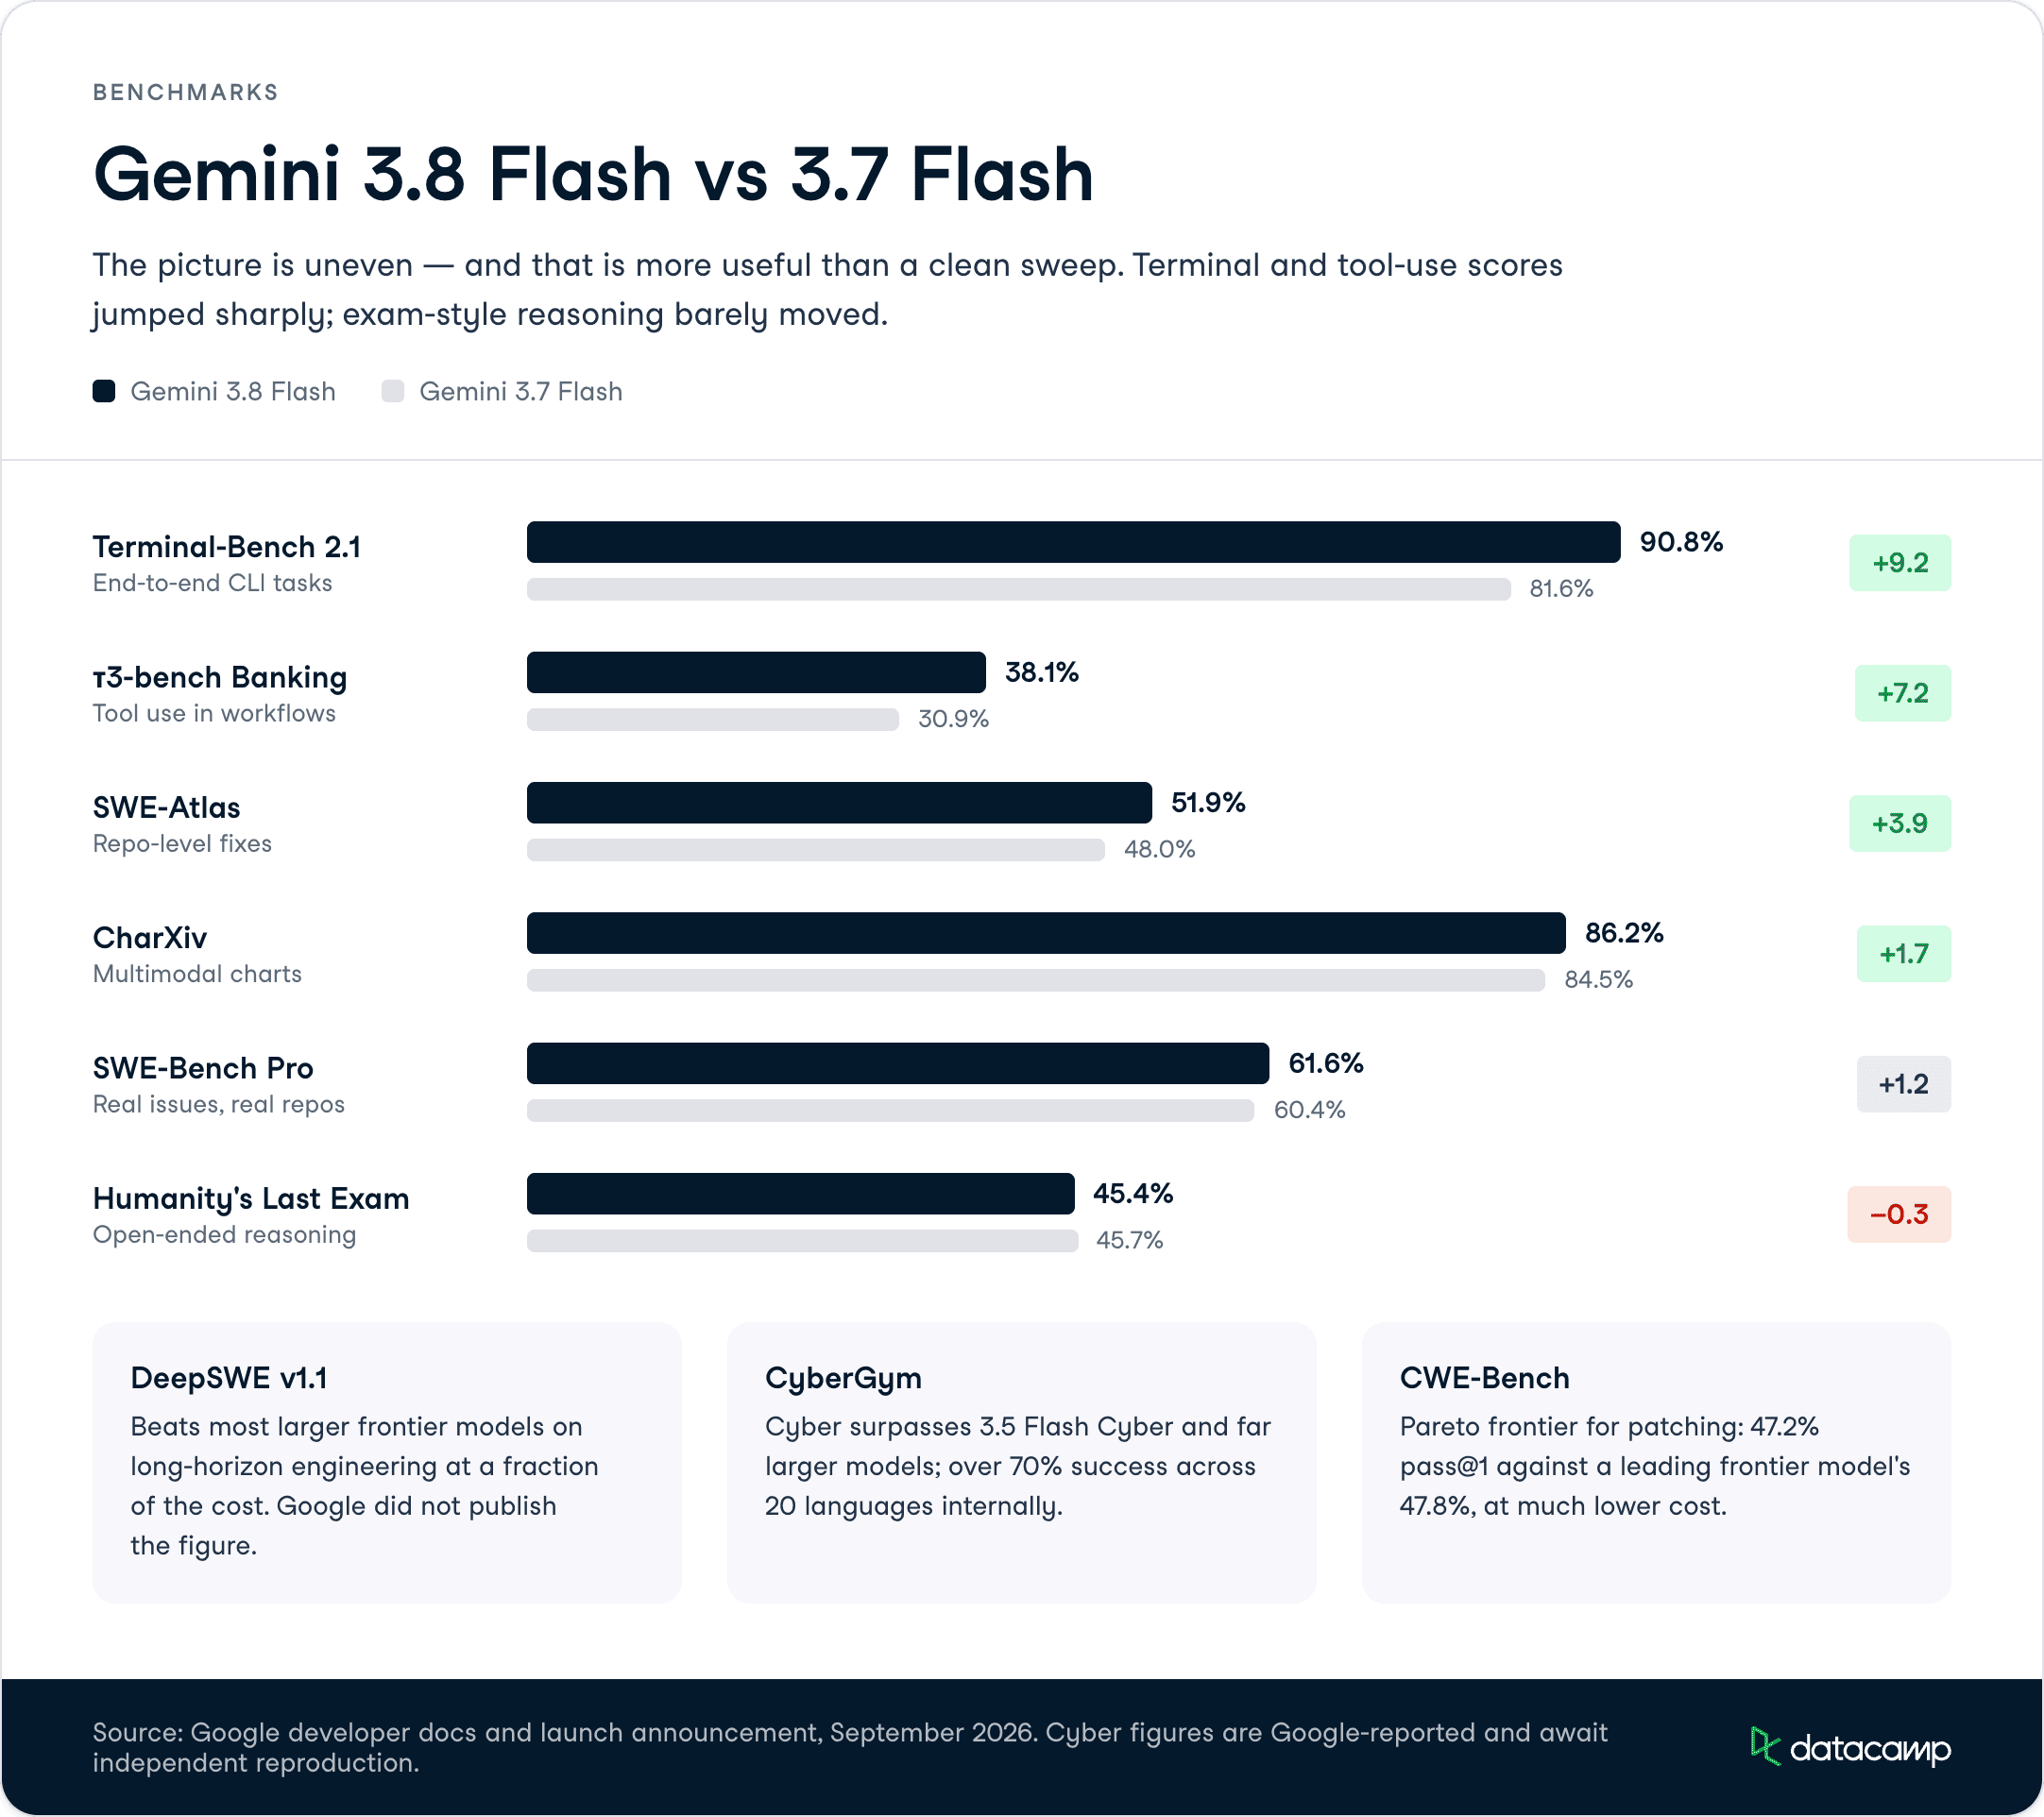
Gemini 3.8 Flash, Terminal-Bench 2.1'de %90,8 aldı; 3.7 Flash'ın %81,6'sından yukarı.
Bu kıyaslama, araç çalıştırma ve hatalardan toparlanma dâhil olmak üzere bir modelin gerçek komut satırı ve kodlama görevlerini baştan sona ne kadar güvenilir tamamladığını ölçer.
Rakip orta seviye modeller bağlamı için, GPT-5.6 Terra vs Claude Sonnet 5 karşılaştırmamızda Terra'nın Terminal-Bench 2.1'de %87,4 ve Sonnet 5'in %80,4 aldığını bulduk. Bu skor çizgisinde 3.8 Flash'ın %90,8'i her ikisinin de önüne geçiyor; bu da $0,75 giriş fiyatlı bir Flash katmanı modeli için dikkat çekici bir iddia.
Uzun ufuklu bir yazılım mühendisliği kıyaslaması olan DeepSWE v1.1'de 3.8 Flash, maliyetlerinin küçük bir kısmına çoğu daha büyük sınır modelini geride bırakıyor.
Google, çıkarılan notlarda tam yüzdelik değeri yayımlamadı; çerçeveleme, karmaşık mühendislik problemlerini otonom biçimde, uçtan uca çözdüğü yönünde.
Bu, "işi bitiren ajan" anlatısını destekleyen kıyaslama.
İş yükünüz bir kod tabanı üzerinde çok adımda yineleyen bir ajan içeriyorsa, DeepSWE tek atımlık bir kodlama puanından gerçeğinize daha yakındır.
SWE-Bench Pro'da 3.8 Flash %61,6, 3.7 Flash %60,4 aldı; SWE-Atlas'ta ise %51,9'a karşı %48,0'a ulaştı.
Bunlar, gerçek kod depolarındaki gerçek sorunları düzeltmeyi ölçen depo düzeyi yazılım mühendisliği kıyaslamalarıdır.
SWE-Bench Pro'daki sadece 1 puanı biraz aşan artış mütevazı; bu not edilmeli. Daha büyük sıçramalar Terminal-Bench'te; dolayısıyla özellikle terminal ve araç güvenilirliğiyle ilgileniyorsanız, 3.8 Flash'ın selefinden ayrıştığı yer orası.
3.8 Flash, STEM, beşeri bilimler ve profesyonel alanlarda çok adımlı akıl yürütmeyi test eden HLE-Verified'da %54,9'a ulaşıyor.
Ancak Google'ın geliştirici dokümanlarındaki daha geniş Humanity's Last Exam karşılaştırmasında skor esasen yatay: 3.8 Flash için %45,4'e karşı 3.7 Flash için %45,7.
Genel sınav tarzı akıl yürütme çok ilerlemedi; bu nedenle kullanım durumunuz kodlama ve araç kullanımı yerine zor, açık uçlu akıl yürütmeyse, 3.7'den 3.8 Flash'a yükseltme ekstra tokenlara değmeyebilir.
Gemini 3.8 Flash Cyber, güvenlik açığı keşfi ve yamalamada sınır düzeyi sonuçlar veriyor.
Otonom güvenlik açığı keşfi için standart endüstri kıyaslaması olan CyberGym'de, 3.5 Flash Cyber ve anlamlı ölçüde daha büyük sınır modelleri geride bırakıyor; Google'ın 20 programlama dilini kapsayan dahili kıyaslamasında ise %70'i aşan bir başarı oranına ulaşıyor.
Collinear tarafından yürütülen haricî bir yamalama kıyaslaması olan CWE-Bench'te, Cyber çok daha düşük maliyetle, önde gelen bir sınır modelinin %47,8'ine karşı %47,2 pass@1 ile Pareto sınırında yer alıyor.
Google, saldırgan sömürüye kıyasla güvenlik açığı düzeltmeyi bilerek önceliklendirdi; bu da Anthropic'in Sonnet 5'i varsayılan olarak siber korumalar açık şekilde (Firefox exploit geliştirme değerlendirmesinde %0,0, Opus 5 vs Sonnet 5 incelememizde belirttiğimiz gibi) sunmasıyla paralel.
Aşağıdaki tabloda, yeni modelin yalnızca birkaç haftalık selefiyle nasıl karşılaştırıldığını görebilirsiniz:
| Kıyaslama | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | %90,8 | %81,6 |
| SWE-Bench Pro | %61,6 | %60,4 |
| SWE-Atlas | %51,9 | %48,0 |
| τ³-bench Banking | %38,1 | %30,9 |
| CharXiv (çok modlu) | %86,2 | %84,5 |
| Humanity's Last Exam | %45,4 | %45,7 |
Gemini 3.8 Flash, 2 Eylül 2026'da yayımlanarak Google AI Studio ve Gemini Enterprise Agent Platform üzerinden genel kullanıma sunuldu; API model kimliği gemini-3.8-flash.
3.8 Flash Cyber varyantı, Fairwind Programı aracılığıyla güvenilir savunucularla sınırlıdır ve genel kullanıma açık değildir.
Fiyatlandırma, 3.7 Flash ile aynı tanıtım oranlarını korur:
Eylül 2026 itibarıyla rakiplerle kıyaslamak gerekirse: GPT-5.6 Sol yaklaşık 1M token için giriş $5 ve çıkış $30; yeni Claude Fable 5.1 ise giriş $10 ve çıkış $50.
Gemini 3.8 Flash, Flash katmanının amacına uygun şekilde her ikisini de açık ara alt ediyor.
Gemini 3.8 Flash, kodlama modeli pazarının değer odaklı ucunda Google'ın güçlü baskısını temsil ediyor; strateji net: $0,75 girişte sınır düzeyine yakın kodlama performansını yakalamak ve her birkaç haftada bir yeni bir Flash modeli göndermek.
Terminal-Bench 2.1'de %90,8 ve $1 altı fiyatlandırma, onu ajansal kodlama iş yükleri için ciddi bir varsayılan yapıyor.
Bana göre sürüm eşit değil ve Google bunun hakkında açık.
Terminal ve araç kullanımı puanları sıçradı; DeepSWE ile finans ve hukuk kıyasları iyileşti; ancak HLE yatay kaldı ve SWE-Bench Pro zar zor hareket etti.
Kodlama ajanları inşa ediyorsanız, bu 3.7 Flash'a göre anlamlı bir yükseltme.
Zor, açık uçlu akıl yürütmeye ihtiyacınız varsa, gerekçe daha zayıf ve verimlilik odaklı işler için 3.7 Flash'ta kalmak makul bir tercih.
Cyber varyantı daha ilginç uzun vadeli hamle. %70+ gerçek dünya güvenlik açığı keşfi ve Pareto sınırında yamalama; Fairwind Programı arkasında, sömürüye kıyasla savunmayı önceleyen bir önyargıyla; kendi kodunu zaten bununla güvenceye alan bir şirket için savunulabilir bir pozisyon.
Şimdiye kadarki verilerin neredeyse tamamı Google'dan geldiği için, CyberGym ve CWE-Bench sayılarını olduğu gibi kabul etmeden önce bağımsız tekrarlar görmek isterim.
Bu tür modeller etrafında ajanlar ve kodlama iş akışları inşa etmek istiyorsanız, AI Agent Fundamentals beceri yolumuz sağlam bir başlangıç noktasıdır.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.