
कोर्स
Google Gemini और NotebookLM के साथ प्रैक्टिकल AI
2 घंटा
10.1K
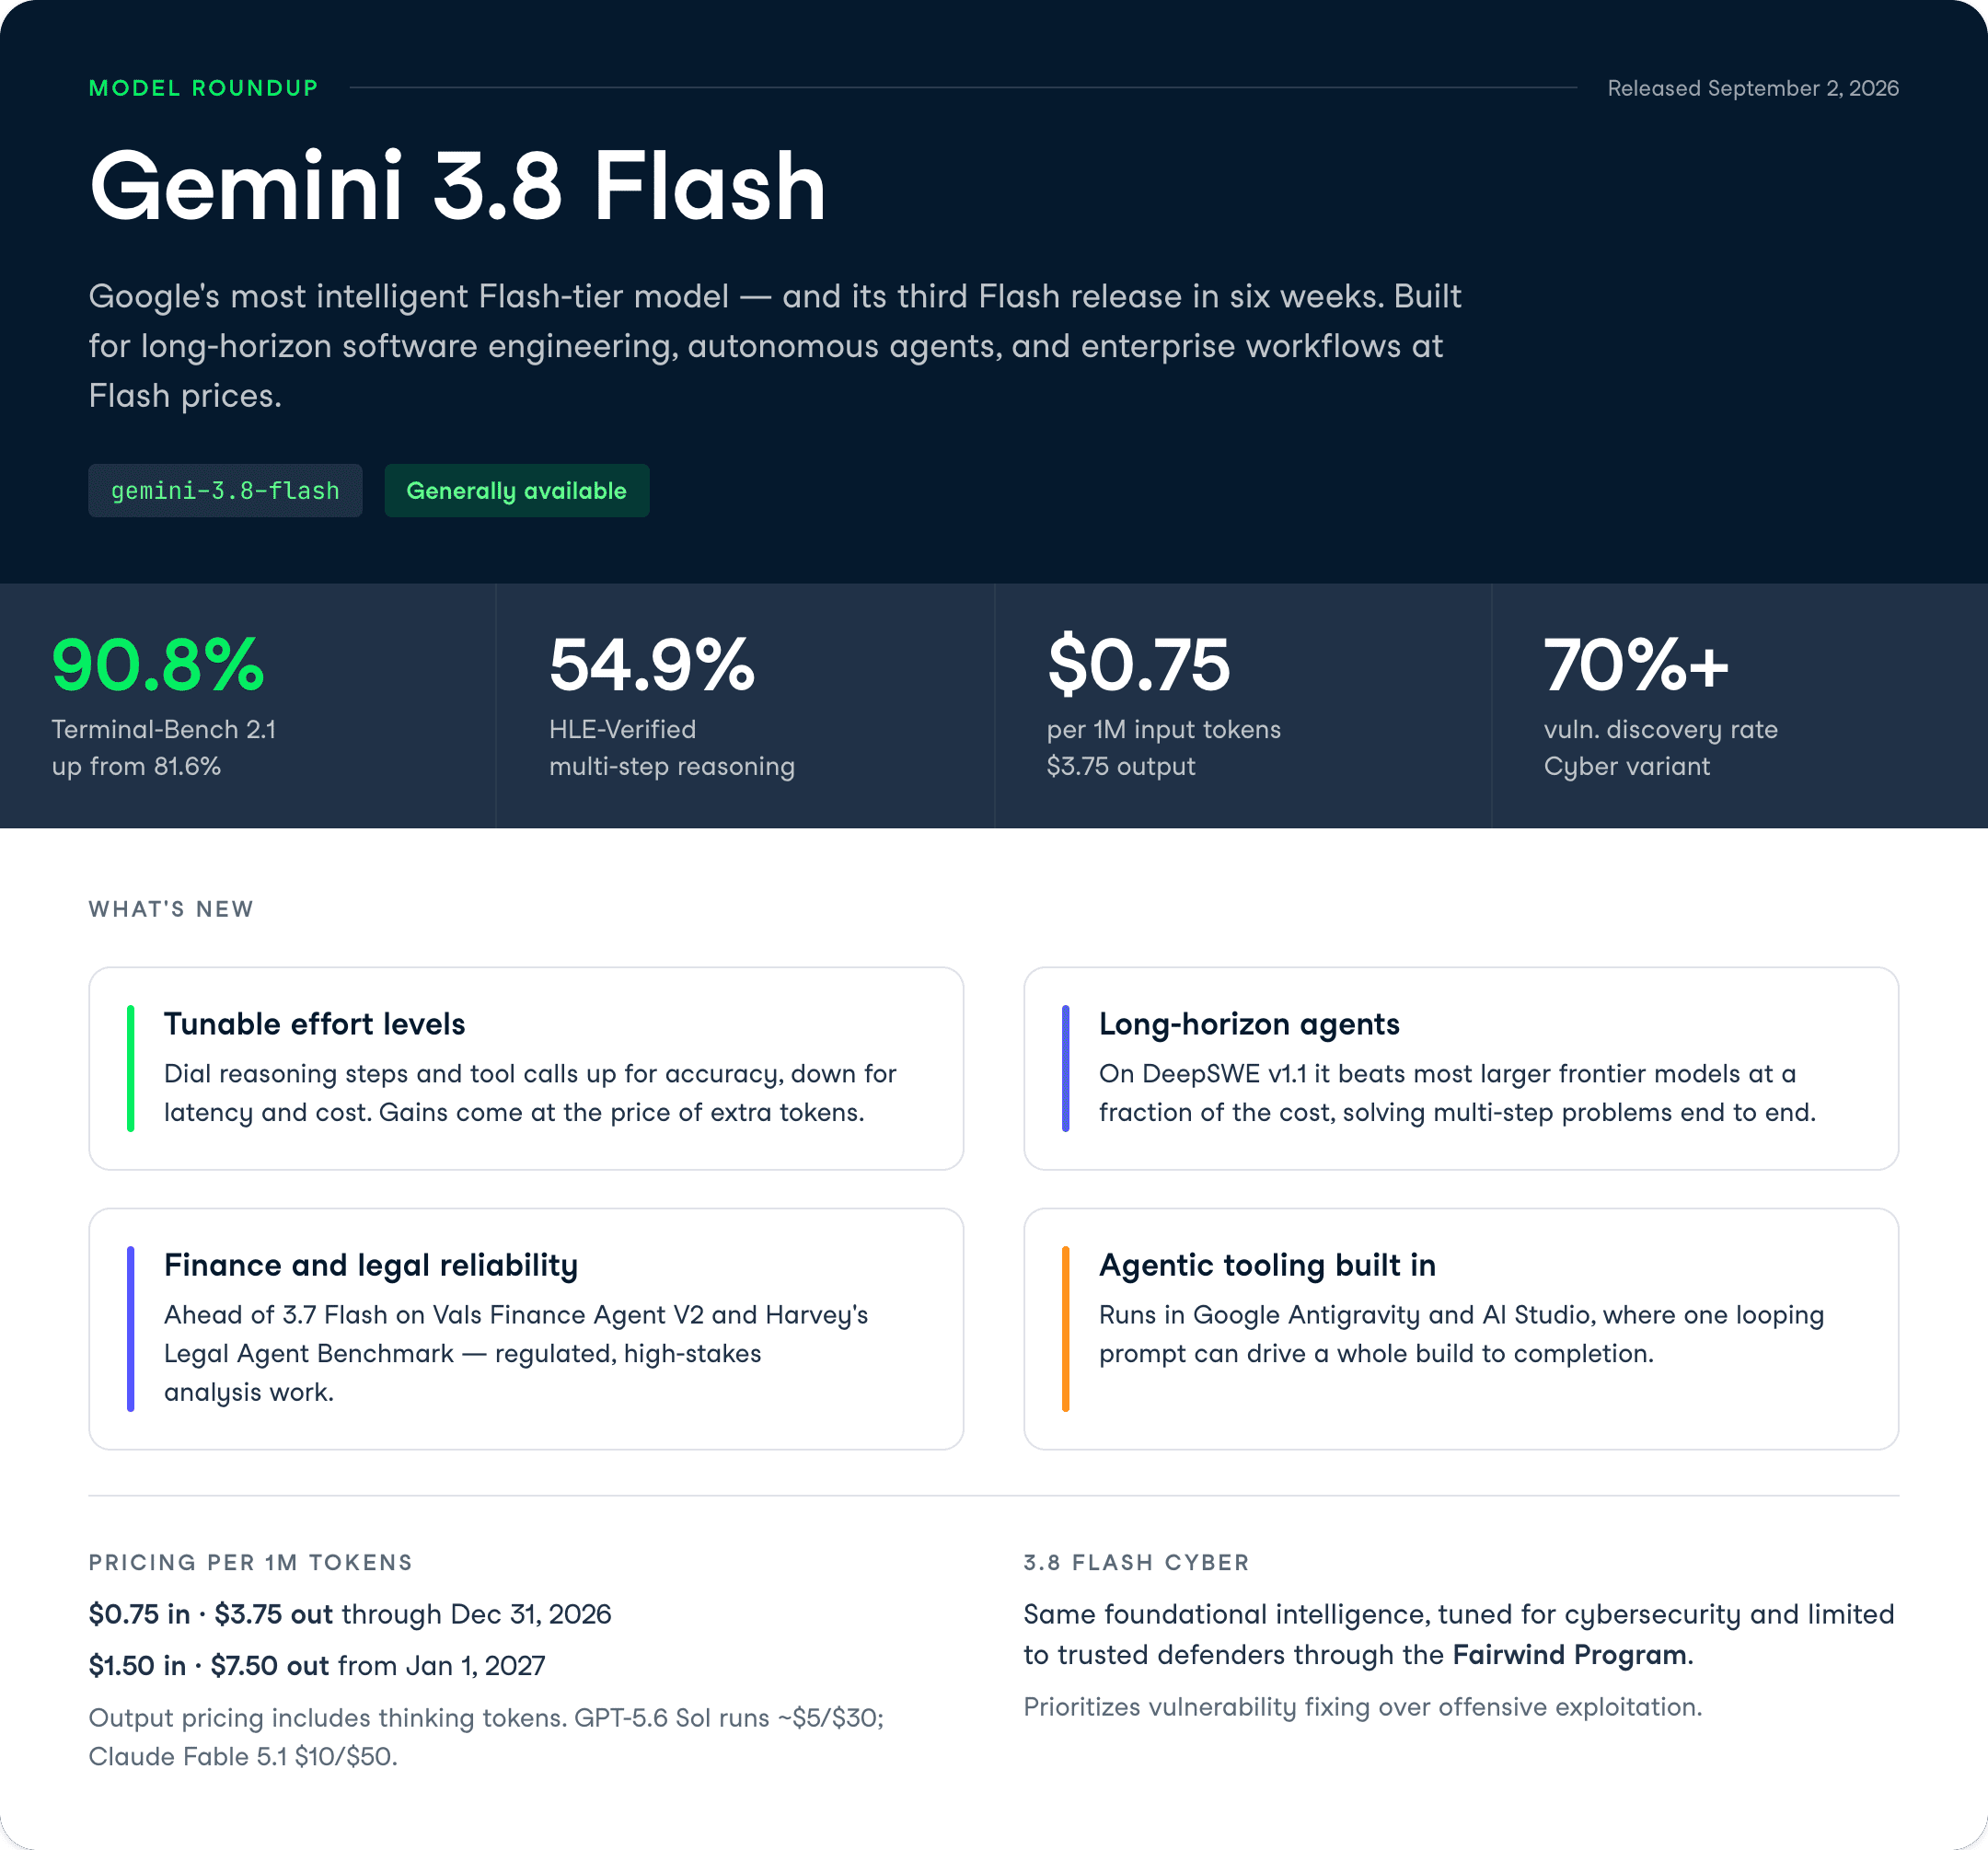
Google जिस रफ्तार से Flash मॉडल जारी कर रहा है, उसके साथ बना रहना मुश्किल है। Gemini 3.8 Flash छह हफ्तों में कंपनी की तीसरी Flash रिलीज़ है, और यह Flash टियर में अब तक का सर्वश्रेष्ठ रीजनिंग और कोडिंग मॉडल बनकर आया है—तीन हफ्ते पहले के 3.7 Flash जितनी ही स्पीड और कम लागत पर।
मानक मॉडल के साथ ही Google ने Gemini 3.8 Flash Cyber पेश किया—साइबरसिक्योरिटी कार्य के लिए ट्यून किया गया एक वेरिएंट, जो केवल भरोसेमंद डिफेंडरों के लिए Fairwind Program के माध्यम से उपलब्ध है—यह सीमित-एक्सेस पहल नए मॉडलों के साथ ही लॉन्च की गई। दोनों मॉडल एक ही आधारभूत इंटेलिजेंस साझा करते हैं।
सुर्खियों के आंकड़े मजबूत हैं: Gemini 3.8 Flash ने Terminal-Bench 2.1 पर 90.8% (3.7 Flash के 81.6% से ऊपर), HLE-Verified पर 54.9%, और Cyber वेरिएंट के लिए वास्तविक दुनिया की वल्नरेबिलिटी खोज दर 70% से अधिक हासिल की।
इस लेख में, मैं Gemini 3.8 Flash और 3.8 Flash Cyber में आई सभी नई चीज़ों को कवर करूँगा—नए फीचर्स, बेंचमार्क्स, और हैंड्स-ऑन उदाहरणों के साथ उनकी वास्तविक परख। हमारे Gemini 3.8 Flash API ट्यूटोरियल में मॉडल को एक्शन में देखें, और Google के नए वॉइस असिस्टेंट मॉडल के बारे में हमारे Gemini 3.8 Live गाइड में पढ़ें।
इनके प्रतिद्वंद्वी मॉडलों पर पकड़ बनाने के लिए, हमारे ये गाइड देखें: DeepSeek v4.1 बनाम Gemini 3.8 Flash और Claude Opus 5 बनाम Sonnet 5।
Gemini 3.8 Flash Google का सबसे बुद्धिमान Flash-टियर मॉडल है, जिसे लंबे-क्षेत्र सॉफ्टवेयर इंजीनियरिंग, स्वायत्त एजेंट्स, और जटिल एंटरप्राइज़ वर्कफ़्लोज़ के लिए इंजीनियर किया गया है।
यह Pro टियर (जैसे Gemini 3.1 Pro) से नीचे बैठता है, लेकिन लागत का एक हिस्सा ही लेता है—31 दिसंबर, 2026 तक 1M इनपुट टोकन पर $0.75 और 1M आउटपुट टोकन पर $3.75 की शुरुआती दर बनी रहती है।
3.7 Flash से मुख्य बदलाव यह है कि 3.8 Flash बस अधिक मेहनत करता है।
जटिल कार्यों पर, यह अतिरिक्त रीजनिंग स्टेप्स चलाता है और टूल्स को क्रमिक रूप से कॉल करता है—इसीलिए यह अधिक कीमत वाले फ्रंटियर मॉडलों के प्रदर्शन के करीब पहुँच पाता है। समझौता टोकन ओवरहेड का है: ऊँचे प्रयास स्तरों पर, मॉडल अंतिम कुछ अंकों की सटीकता निचोड़ने के लिए अधिक टोकन जला सकता है।
सबसे चौंकाने वाला बेंचमार्क हेडलाइन Terminal-Bench 2.1 पर है, जहाँ 3.8 Flash ने 3.7 Flash के 81.6% के मुकाबले 90.8% स्कोर किया। Terminal-Bench मापता है कि कोई मॉडल वास्तविक कमांड-लाइन और कोडिंग कार्यों को एंड-टू-एंड कितनी विश्वसनीयता से पूरा करता है—इसलिए 9-पॉइंट की छलांग सीधे बेहतर एजेंटिक कोडिंग व्यवहार की ओर इशारा करती है।
 Gemini 3.8 Flash में नया क्या है?
3.8 Flash के फीचर्स आकस्मिक चैट यूज़र्स के बजाय एजेंट्स और लंबे कोडिंग सेशंस चलाने वाले डेवलपर्स को ध्यान में रखकर बनाए गए हैं।
यहाँ वे क्षमताएँ हैं जिनके बारे में जानना चाहिए।
आप सटीकता या लागत—जिसे आप प्राथमिकता देते हैं—उसके अनुसार मॉडल का प्रयास स्तर ऊपर-नीचे कर सकते हैं।
यह इसलिए मायने रखता है क्योंकि 3.8 Flash के लाभ अतिरिक्त टोकनों की कीमत पर आते हैं।
यदि आपका वर्कलोड दक्षता-प्रथम है, तो Google स्पष्ट रूप से कहता है कि आप 3.7 Flash पर बने रह सकते हैं, जिसे पूर्ण रूप से सपोर्ट मिलता रहेगा।
यह लॉन्च पोस्ट में Google की असामान्य ईमानदार टिप्पणी है—और बताती है कि प्रयास का डायल मुफ़्त प्रदर्शन नहीं, बल्कि एक वास्तविक ट्रेड-ऑफ है।
Gemini 3.8 Flash उन एजेंट्स को चलाने के लिए बनाया गया है जो मल्टी-स्टेप इंजीनियरिंग समस्याओं को बिना हाथ पकड़ाए सुलझाते हैं।
DeepSWE v1.1—लंबे-क्षेत्र सॉफ्टवेयर इंजीनियरिंग बेंचमार्क—पर, यह अपनी लागत के एक अंश पर अधिकांश बड़े फ्रंटियर मॉडलों से बेहतर प्रदर्शन करता है, जबकि जटिल समस्याएँ एंड-टू-एंड हल करता है।
कोडिंग एजेंट्स बनाने वाले प्रैक्टिशनर्स के लिए, यही संख्या मायने रखती है।
प्री-रिलीज़ इम्प्रेशंस लीक करने वाले Reddit और X यूज़र्स ने इसे “Flash प्राइसिंग पर Fable 5 स्तर का प्रदर्शन” बताया, और वॉल स्ट्रीट जर्नल की रिपोर्टिंग में आया कि Google के आंतरिक Jetski हेड-टू-हेड टेस्टिंग में इंजीनियरों ने कोडिंग के लिए 3.8 Flash को Anthropic के Opus मॉडल पर तरजीह दी।
यह आक्रामक प्रतिस्पर्धी दावा है—API व्यापक रूप से उपलब्ध होते ही इसकी जाँच करना उचित होगा।
3.8 Flash लक्षित करता है विनियमित, उच्च-जोखिम वाले क्षेत्रों को, जहाँ गलत जवाब महँगा पड़ता है।
यह Vals Finance Agent V2 और Harvey's Legal Agent Benchmark पर 3.7 Flash और अन्य फ्रंटियर मॉडलों से बेहतर है—दोनों वित्त और कानून में विश्लेषण और रिपोर्टिंग की जाँच करते हैं।
एक ऐसे वर्कफ़्लो के बारे में सोचें जहाँ कोई एजेंट तिमाही फाइलिंग्स पढ़कर अनुपालन सारांश ड्राफ्ट करे, या नीतियों के खिलाफ कॉन्ट्रैक्ट क्लॉज़ की समीक्षा करे। वहाँ अपेक्षित विश्वसनीयता सामान्य चैट से अलग होती है—और Google 3.8 Flash को सीधे इन नॉलेज डोमेन्स में एंटरप्राइज़ ऑटोनॉमी के लिए पेश कर रहा है।
Gemini 3.8 Flash Google Antigravity और Google AI Studio में चलता है, जहाँ एक ही लूपिंग प्रॉम्प्ट पूरे बिल्ड को आगे बढ़ा सकता है।
Google का अपना उदाहरण Antigravity में एक ही प्रॉम्प्ट से जनरेट किया गया Google Maps का पूरी तरह खेलने योग्य DOS-स्टाइल संस्करण है—लोकेशंस, निर्देश, और Street View सहित।
अपने काम के लिए कल्पना करें कि आप एक ही निर्देश दें—"एक इंटरैक्टिव डैशबोर्ड बनाइए जो इस CSV को खींचे, तीन चार्ट प्रकार प्लॉट करे, और मुझे क्षेत्र के हिसाब से फ़िल्टर करने दे"—और एजेंटिक लूप तब तक इटरिट करे जब तक यह चल न पड़े।
लूपिंग इंस्ट्रक्शन पैटर्न वहीं है जहाँ अतिरिक्त प्रयास स्तरों का लाभ मिलता है—क्योंकि मॉडल पहले ड्राफ्ट पर रुकने के बजाय सुधार करता रहता है।
बेंचमार्क तस्वीर असमान है—जो कि क्लीन स्वीप से अधिक उपयोगी है, क्योंकि यह बताती है कि लाभ वास्तव में कहाँ उतरे।
कोडिंग और टर्मिनल कार्यों में तेज़ सुधार हुआ, जबकि एग्ज़ाम-स्टाइल रीजनिंग मुश्किल से हिली।
यहाँ Google के डेवलपर डॉक और घोषणा से लिए गए आँकड़े हैं।
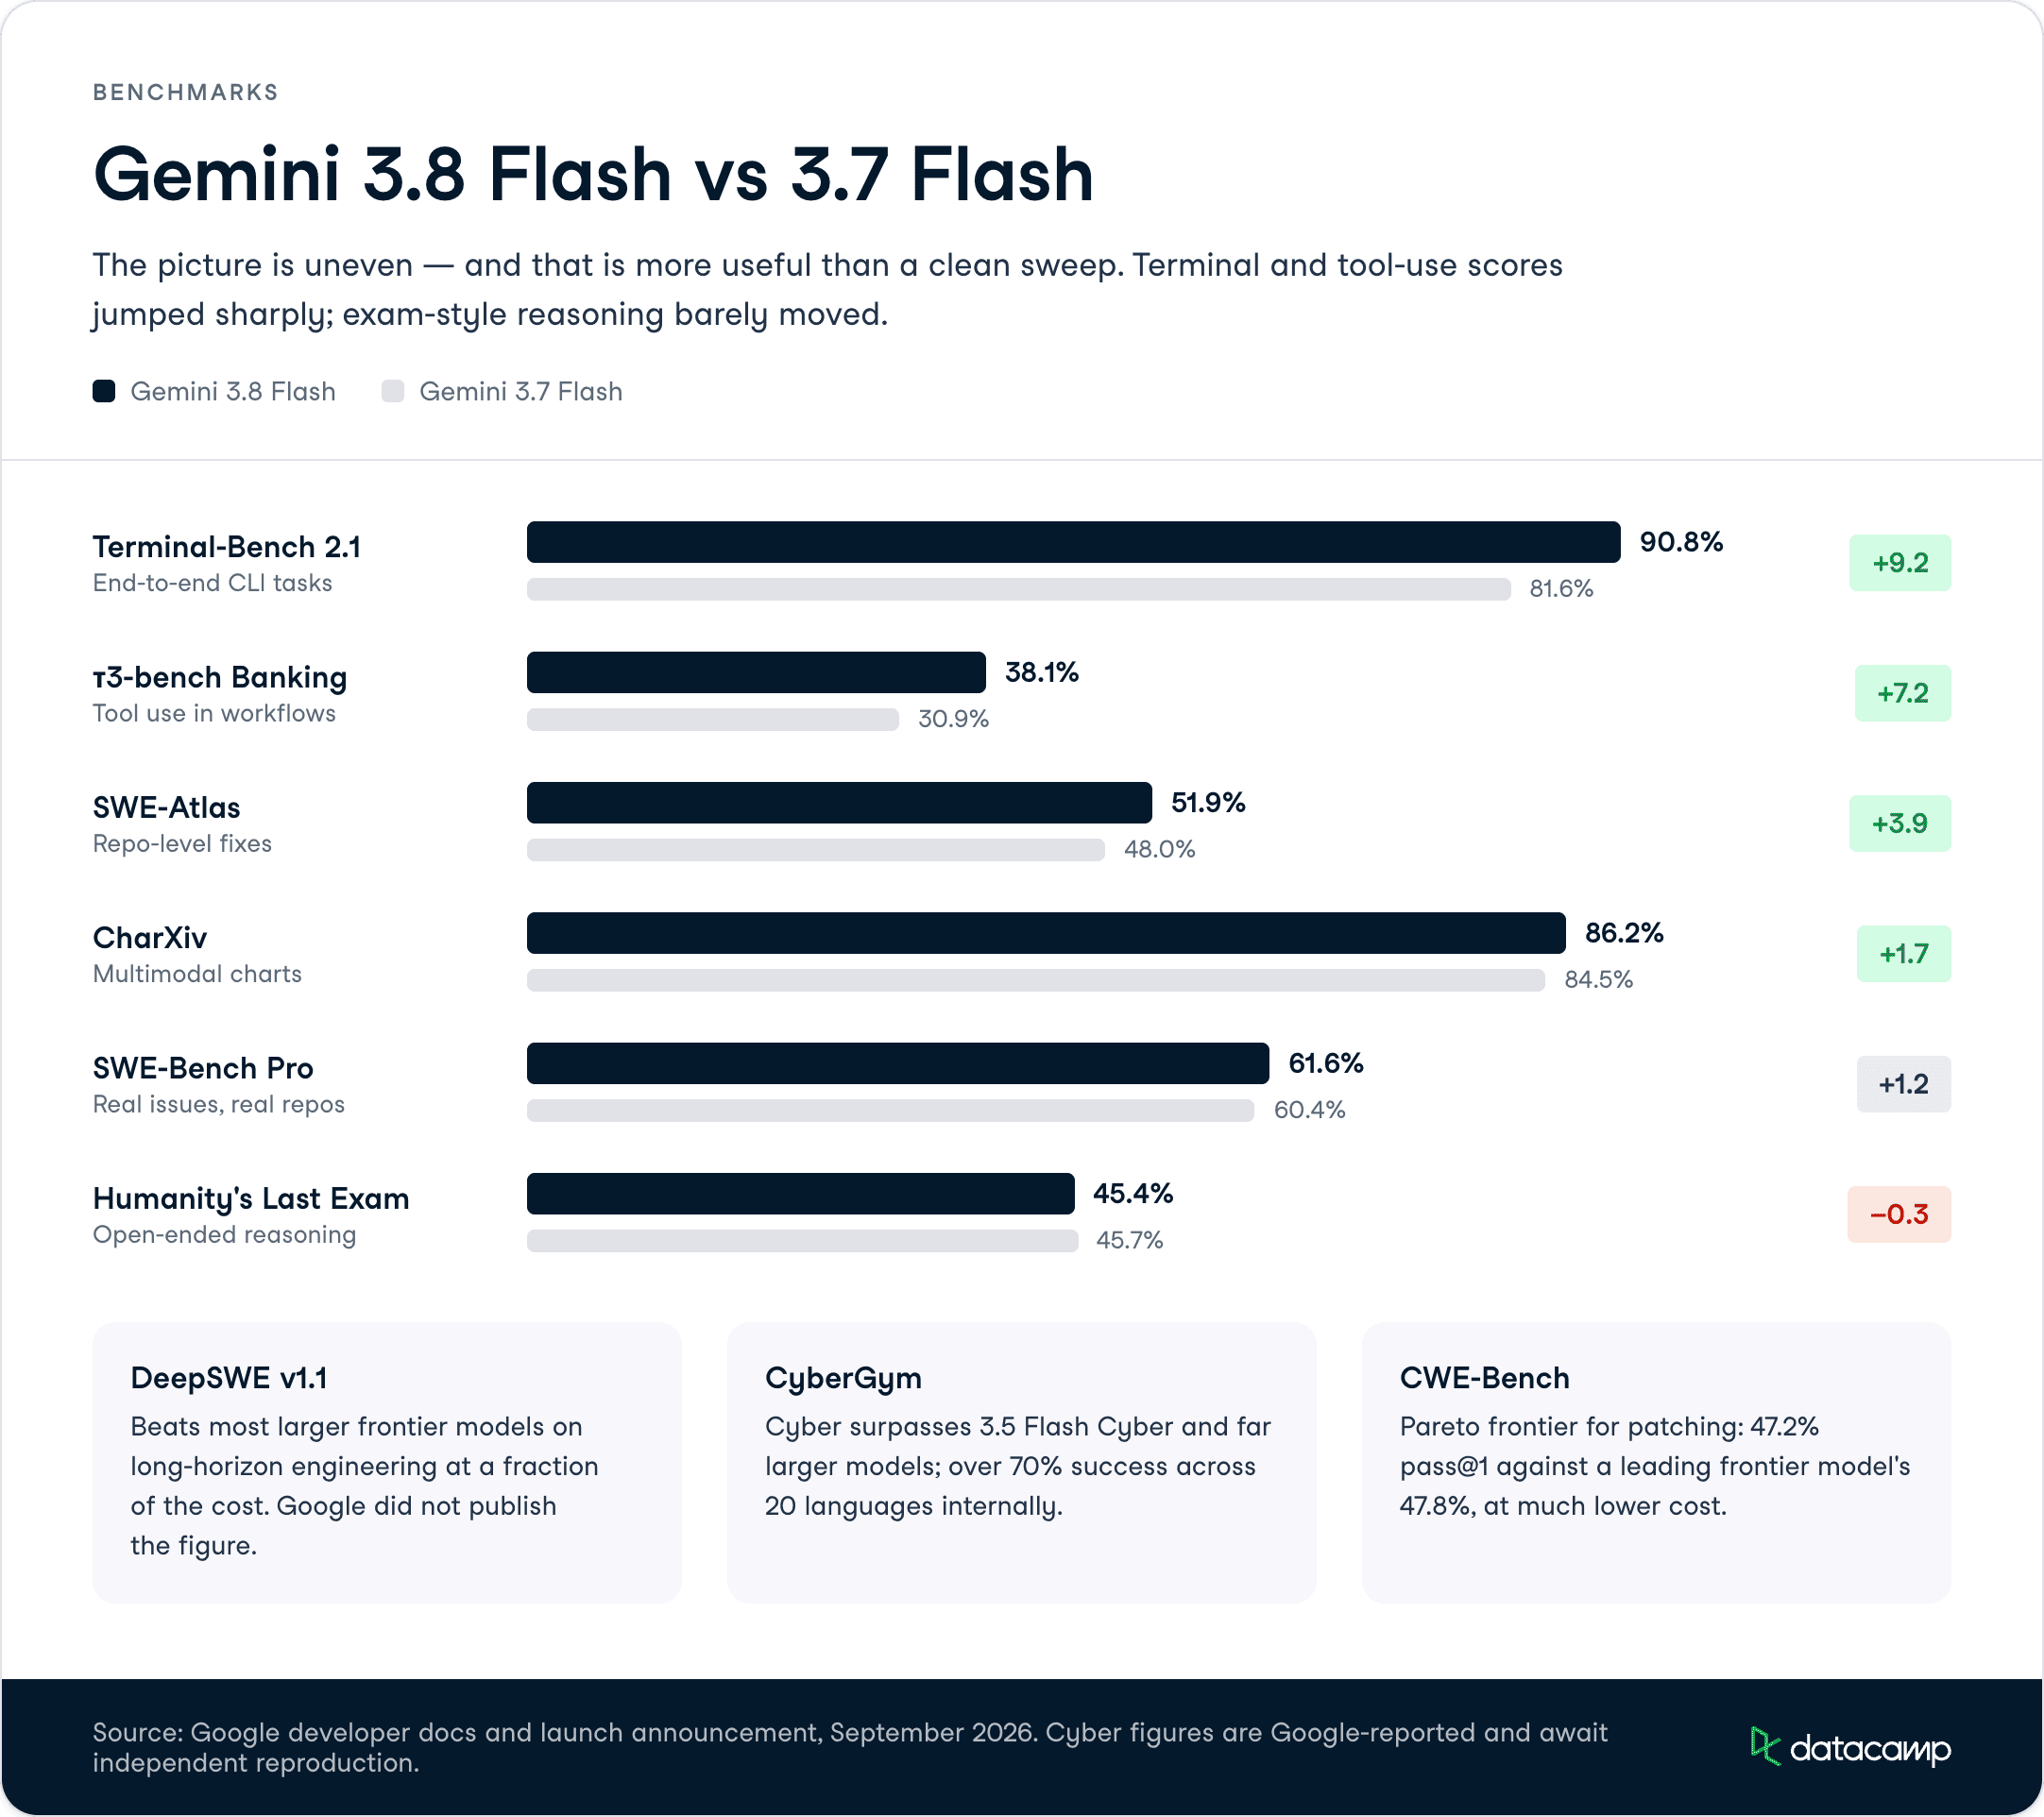
Gemini 3.8 Flash ने Terminal-Bench 2.1 पर 90.8% स्कोर किया—3.7 Flash के 81.6% से ऊपर।
यह बेंचमार्क मापता है कि कोई मॉडल वास्तविक कमांड-लाइन और कोडिंग कार्यों को शुरुआत से अंत तक कितनी विश्वसनीयता से पूरा करता है—टूल्स चलाना और त्रुटियों से उबरना शामिल है।
प्रतिद्वंद्वी मिड-टियर मॉडलों के संदर्भ में, हमारे GPT-5.6 Terra बनाम Claude Sonnet 5 तुलना में हमें मिला कि Terra ने Terminal-Bench 2.1 पर 87.4% और Sonnet 5 ने 80.4% स्कोर किया। उस स्कोरलाइन पर, 3.8 Flash का 90.8% दोनों से आगे निकलता है—जो $0.75 इनपुट पर एक Flash-टियर मॉडल के लिए उल्लेखनीय दावा है।
DeepSWE v1.1—लंबे-क्षेत्र सॉफ्टवेयर इंजीनियरिंग बेंचमार्क—पर, 3.8 Flash अपनी लागत के एक अंश पर अधिकांश बड़े फ्रंटियर मॉडलों से बेहतर प्रदर्शन करता है।
Google ने निकाले गए नोट्स में सटीक प्रतिशत प्रकाशित नहीं किया, लेकिन फ्रेमिंग यह है कि यह जटिल इंजीनियरिंग समस्याओं को स्वायत्त रूप से एंड-टू-एंड हल करता है।
यही वह बेंचमार्क है जो “काम पूरा करने वाले एजेंट” की पिच को सहारा देता है।
यदि आपका वर्कलोड किसी एजेंट के कई स्टेप्स में कोडबेस पर इटरिट करने से जुड़ा है, तो DeepSWE आपकी हकीकत के अधिक करीब है बनिस्बत किसी सिंगल-शॉट कोडिंग स्कोर के।
SWE-Bench Pro पर, 3.8 Flash ने 3.7 Flash के 60.4% के मुकाबले 61.6% स्कोर किया, और SWE-Atlas पर यह 48.0% के मुकाबले 51.9% तक पहुँचा।
ये रिपॉज़िटरी-स्तरीय सॉफ्टवेयर इंजीनियरिंग बेंचमार्क हैं जो वास्तविक कोडबेस में वास्तविक इश्यूज़ को ठीक करने को मापते हैं।
SWE-Bench Pro पर ज़्यादा से ज़्यादा 1 पॉइंट की बढ़त मामूली है—जो नोट करने योग्य है। बड़े उछाल Terminal-Bench में हैं, तो यदि आपको खास तौर पर टर्मिनल और टूल विश्वसनीयता मायने रखती है, 3.8 Flash यहीं अपने पूर्ववर्ती से अलग होता है।
3.8 Flash ने HLE-Verified पर 54.9% हासिल किया—यह STEM, ह्यूमैनिटीज़ और प्रोफेशनल क्षेत्रों में मल्टी-स्टेप रीजनिंग की जाँच करता है।
लेकिन Google के डेवलपर डॉक के व्यापक Humanity's Last Exam पर स्कोर मूलतः सपाट रहा: 3.8 Flash के लिए 45.4% बनाम 3.7 Flash के लिए 45.7%।
सामान्य एग्ज़ाम-स्टाइल रीजनिंग में बहुत प्रगति नहीं हुई—तो यदि आपका यूज़ केस कठिन ओपन-एंडेड रीजनिंग है, न कि कोडिंग और टूल यूज़, तो 3.7 से 3.8 Flash पर जाना अतिरिक्त टोकनों के लायक नहीं भी हो सकता है।
Gemini 3.8 Flash Cyber वल्नरेबिलिटी खोज और पैचिंग पर फ्रंटियर-स्तरीय नतीजे देता है।
CyberGym—स्वायत्त वल्नरेबिलिटी डिस्कवरी के लिए उद्योग का मानक बेंचमार्क—पर, यह 3.5 Flash Cyber और काफी बड़े फ्रंटियर मॉडलों से आगे निकलता है; और Google के आंतरिक बेंचमार्क (20 प्रोग्रामिंग भाषाओं में फैला) पर 70% से अधिक सफलता दर हासिल करता है।
CWE-Bench—Collinear द्वारा चलाया गया एक बाहरी पैचिंग बेंचमार्क—पर, Cyber कम लागत पर 47.2% pass@1 के साथ Pareto फ्रंटियर पर बैठता है, जबकि एक अग्रणी फ्रंटियर मॉडल 47.8% पर है।
Google ने जानबूझकर आक्रामक एक्सप्लॉइटेशन के बजाय वल्नरेबिलिटी फिक्सिंग को प्राथमिकता दी—यह उसी तरह है जैसे Anthropic Sonnet 5 को डिफॉल्ट रूप से साइबर सेफगार्ड्स ऑन के साथ शिप करता है (Firefox एक्सप्लॉइट-डेवलपमेंट इवाल पर 0.0%, जैसा कि हमने अपने Opus 5 बनाम Sonnet 5 रिव्यू में नोट किया)।
नीचे दी गई तालिका में, आप देख सकते हैं कि नया मॉडल अपने कुछ ही हफ्तों पुराने पूर्ववर्ती की तुलना में कैसा है:
| बेंचमार्क | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90.8% | 81.6% |
| SWE-Bench Pro | 61.6% | 60.4% |
| SWE-Atlas | 51.9% | 48.0% |
| τ³-bench Banking | 38.1% | 30.9% |
| CharXiv (मल्टीमोडल) | 86.2% | 84.5% |
| Humanity's Last Exam | 45.4% | 45.7% |
Gemini 3.8 Flash Google AI Studio और Gemini Enterprise Agent Platform के माध्यम से सामान्य रूप से उपलब्ध है, 2 सितंबर, 2026 को जारी—API मॉडल ID gemini-3.8-flash।
3.8 Flash Cyber वेरिएंट Fairwind Program के माध्यम से भरोसेमंद डिफेंडरों तक सीमित है—और सामान्य रिलीज़ पर नहीं है।
प्राइसिंग 3.7 Flash जैसी ही शुरुआती दरें रखती है:
सितंबर 2026 तक के प्रतिद्वंद्वियों की तुलना में देखें: GPT-5.6 Sol लगभग प्रति 1M टोकन $5 इनपुट और $30 आउटपुट पर चलता है, और नया Claude Fable 5.1 $10 इनपुट और $50 आउटपुट लेता है।
Gemini 3.8 Flash दोनों से बहुत कम है—यही Flash टियर का मूल बिंदु है।
Gemini 3.8 Flash Google का कोडिंग-मॉडल बाज़ार के वैल्यू छोर पर जोरदार दांव है—रणनीति साफ़ है: $0.75 इनपुट पर लगभग फ्रंटियर स्तर का कोडिंग प्रदर्शन, और हर कुछ हफ्तों में नया Flash मॉडल।
Terminal-Bench 2.1 पर 90.8% और $1 से कम की प्राइसिंग इसे एजेंटिक कोडिंग वर्कलोड्स के लिए एक गंभीर डिफॉल्ट बनाती है।
मेरा मानना है कि रिलीज़ असमान है—और Google इस बारे में साफ़गोई दिखाता है।
टर्मिनल और टूल-यूज़ स्कोर उछले, DeepSWE और फाइनेंस व लीगल बेंचमार्क बेहतर हुए, लेकिन HLE सपाट रहा, और SWE-Bench Pro मुश्किल से हिला।
यदि आप कोडिंग एजेंट्स बनाते हैं, तो यह 3.7 Flash से एक ठोस अपग्रेड है।
यदि आपको कठिन ओपन-एंडेड रीजनिंग चाहिए, तो मामला कम मज़बूत है—और दक्षता-प्रथम कार्य के लिए 3.7 Flash पर बने रहना समझदारी हो सकती है।
Cyber वेरिएंट लंबी अवधि का अधिक दिलचस्प दांव है। 70%+ वास्तविक दुनिया की वल्नरेबिलिटी खोज दर और Pareto-फ्रंटियर पैचिंग—Fairwind Program के पीछे गेटेड और आक्रामक एक्सप्लॉइटेशन के बजाय डिफेंस की ओर झुका—उस कंपनी के लिए एक बचाव योग्य रुख है जो पहले से अपने कोड को सुरक्षित करने में इसका इस्तेमाल कर रही है।
मैं CyberGym और CWE-Bench के आँकड़ों को ज्यों का त्यों मानने से पहले स्वतंत्र पुनरुत्पादन देखना चाहूँगा—क्योंकि अब तक लगभग सारा डेटा Google से ही आया है।
यदि आप ऐसे मॉडलों के इर्द-गिर्द एजेंट्स और कोडिंग वर्कफ़्लोज़ बनाना चाहते हैं, तो हमारा AI Agent Fundamentals स्किल ट्रैक एक ठोस शुरुआती जगह है।
टॉप DataCamp कोर्स
कोर्स
कोर्स
कोर्स