
Khóa học
AI thực chiến với Google Gemini và NotebookLM
2 giờ
10.1K
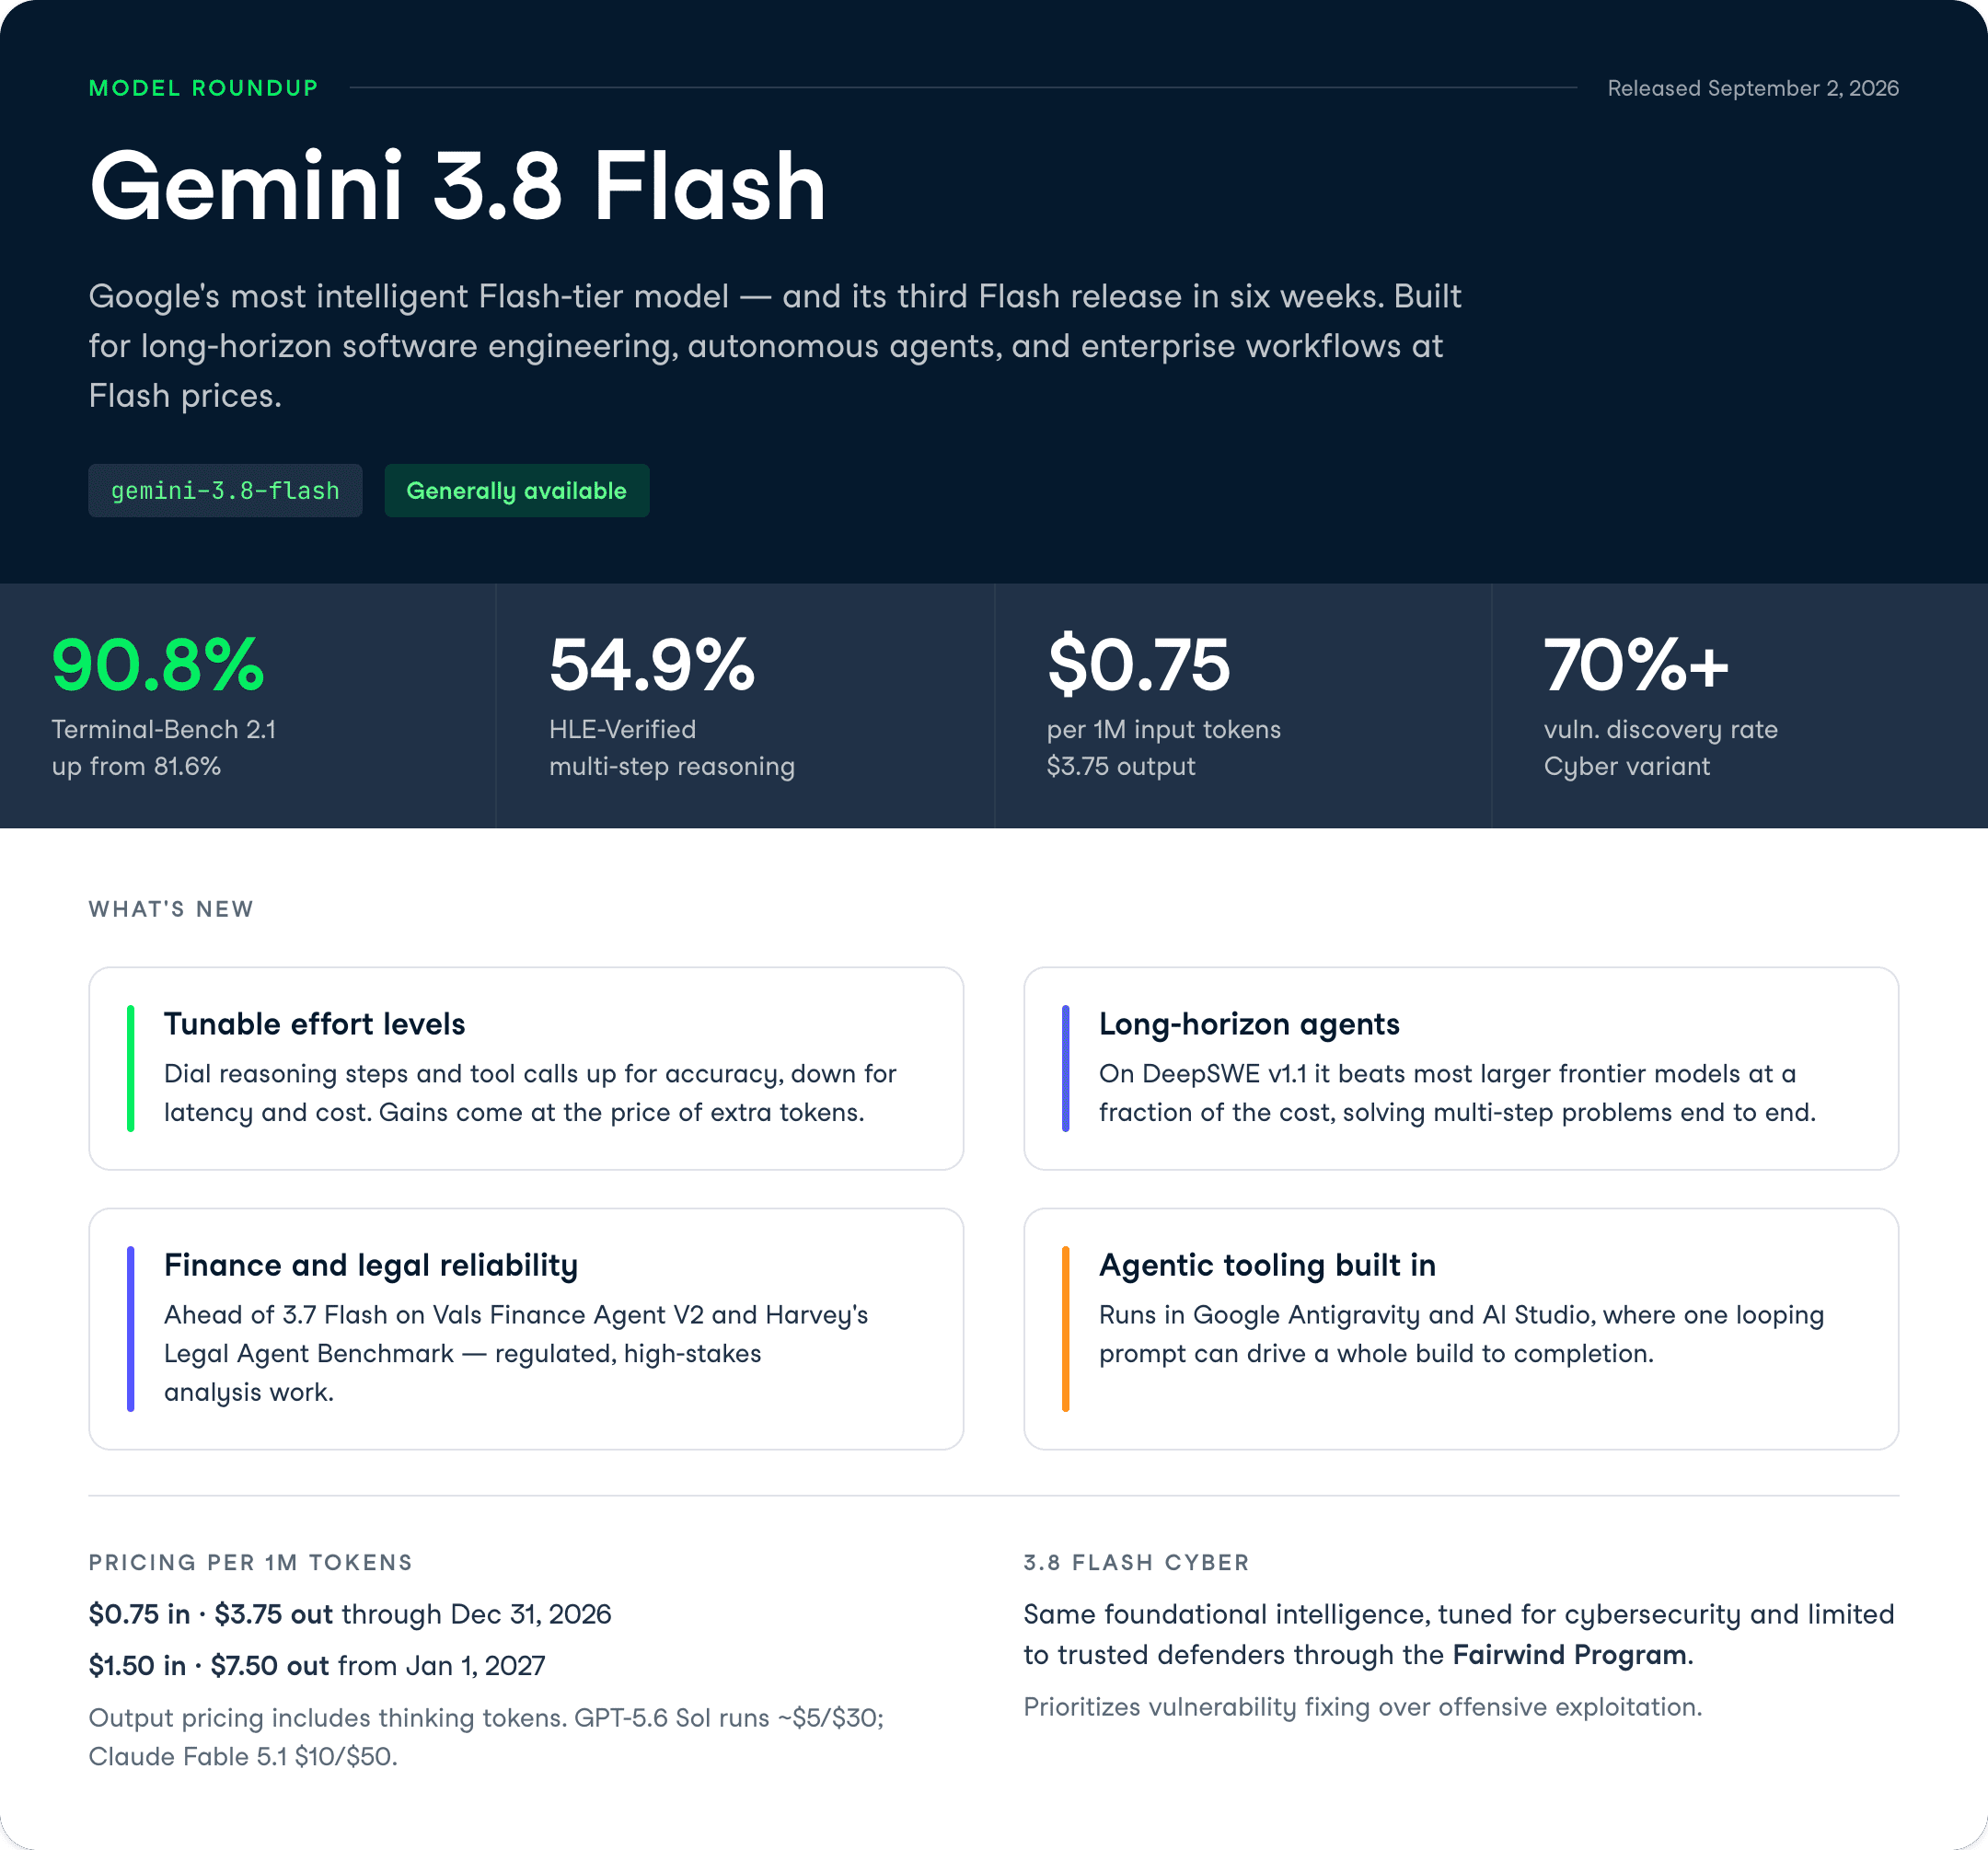
Google tung ra các mẫu Flash với tốc độ khó theo kịp. Gemini 3.8 Flash là bản phát hành Flash thứ ba của công ty trong sáu tuần và trở thành mẫu tốt nhất về suy luận và lập trình trong phân khúc Flash, với cùng tốc độ và chi phí thấp như 3.7 Flash ra mắt ba tuần trước.
Bên cạnh mẫu tiêu chuẩn, Google giới thiệu Gemini 3.8 Flash Cyber, một biến thể tinh chỉnh cho công việc an ninh mạng, chỉ dành cho những người bảo vệ đáng tin cậy thông qua Chương trình Fairwind, một sáng kiến truy cập hạn chế ra mắt cùng thời điểm với các mẫu mới. Cả hai mẫu chia sẻ cùng nền tảng trí tuệ.
Các con số tiêu đề rất ấn tượng, với Gemini 3.8 Flash đạt 90,8% trên Terminal-Bench 2.1 (tăng từ 81,6% của 3.7 Flash), 54,9% trên HLE-Verified, và tỷ lệ phát hiện lỗ hổng trong thế giới thực trên 70% đối với biến thể Cyber.
Trong bài viết này, tôi sẽ trình bày mọi điểm mới của Gemini 3.8 Flash và 3.8 Flash Cyber, xem xét các tính năng mới, khám phá điểm chuẩn và thử nghiệm chúng với các ví dụ thực tế. Xem mô hình hoạt động trong hướng dẫn API Gemini 3.8 Flash của chúng tôi, và đọc về mẫu trợ lý giọng nói mới nhất của Google trong phần Gemini 3.8 Live.
Để nắm bắt nhanh các mẫu đối thủ mà chúng cạnh tranh, xem hướng dẫn của chúng tôi về DeepSeek v4.1 so với Gemini 3.8 Flash và Claude Opus 5 so với Sonnet 5.
Gemini 3.8 Flash là mẫu thông minh nhất của Google trong phân khúc Flash, được thiết kế cho kỹ thuật phần mềm tầm xa, tác nhân tự động và quy trình nghiệp vụ doanh nghiệp phức tạp.
Nó đứng dưới phân khúc Pro (như Gemini 3.1 Pro) nhưng có giá chỉ bằng một phần nhỏ, giữ mức giá giới thiệu 0,75 USD mỗi 1 triệu token đầu vào và 3,75 USD mỗi 1 triệu token đầu ra đến hết ngày 31 tháng 12 năm 2026.
Thay đổi chính so với 3.7 Flash là 3.8 Flash đơn giản là làm việc nhiều hơn.
Trên các tác vụ phức tạp, nó chạy thêm các bước suy luận và gọi công cụ lặp đi lặp lại, đó là lý do nó có thể tiệm cận hiệu năng của các mẫu frontier đắt tiền hơn. Đổi lại là chi phí token: ở mức nỗ lực cao hơn, mẫu có thể tiêu tốn nhiều token hơn để vắt ra vài điểm chính xác cuối cùng.
Điểm nhấn đáng chú ý nhất là trên Terminal-Bench 2.1, nơi 3.8 Flash đạt 90,8% so với 81,6% của 3.7 Flash. Terminal-Bench đo lường mức độ đáng tin cậy khi một mẫu hoàn thành các tác vụ dòng lệnh và lập trình thực tế từ đầu đến cuối, nên mức tăng 9 điểm phản ánh trực tiếp hành vi lập trình dạng tác nhân tốt hơn.
 Có gì mới ở Gemini 3.8 Flash?
Các tính năng trong 3.8 Flash nhắm đến nhà phát triển chạy tác nhân và các phiên lập trình dài hơn là người dùng trò chuyện thông thường.
Dưới đây là các năng lực đáng lưu ý.
Bạn có thể tăng hoặc giảm mức nỗ lực của mẫu tùy thuộc vào việc bạn ưu tiên độ chính xác hay chi phí.
Điều này quan trọng vì các lợi ích của 3.8 Flash đi kèm giá token tăng thêm.
Nếu khối lượng công việc của bạn ưu tiên hiệu quả, Google nói rõ rằng bạn có thể tiếp tục dùng 3.7 Flash, mẫu này vẫn được hỗ trợ đầy đủ.
Đó là một ghi chú thẳng thắn hiếm thấy trong bài ra mắt của Google, và cho thấy nút chỉnh nỗ lực là một đánh đổi thực sự chứ không phải hiệu năng miễn phí.
Gemini 3.8 Flash được xây để chạy các tác nhân xử lý những vấn đề kỹ thuật nhiều bước mà không cần cầm tay chỉ việc.
Trên DeepSWE v1.1, một điểm chuẩn kỹ thuật phần mềm tầm xa, nó vượt qua hầu hết các mẫu frontier lớn hơn với chi phí chỉ bằng một phần nhỏ, đồng thời giải quyết các vấn đề phức tạp từ đầu đến cuối.
Với người triển khai tác nhân lập trình, đây là con số then chốt.
Người dùng Reddit và X rò rỉ ấn tượng trước phát hành mô tả nó là "hiệu năng cấp Fable 5 với giá Flash", và Wall Street Journal ghi nhận rằng trong thử nghiệm đối đầu nội bộ Jetski của Google, kỹ sư ưu tiên 3.8 Flash hơn mẫu Opus của Anthropic cho tác vụ lập trình.
Đó là một tuyên bố cạnh tranh mạnh mẽ và đáng để kiểm chứng khi API được mở rộng.
3.8 Flash nhắm đến các lĩnh vực được quản lý, rủi ro cao, nơi một câu trả lời sai có thể rất tốn kém.
Nó vượt qua 3.7 Flash và các mẫu frontier khác trên Vals Finance Agent V2 và Harvey's Legal Agent Benchmark, cả hai đều kiểm tra phân tích và báo cáo trong tài chính và pháp lý.
Hãy hình dung một quy trình trong đó tác nhân đọc bộ hồ sơ quý và soạn tóm tắt tuân thủ, hoặc rà soát các điều khoản hợp đồng so với chính sách. Mức độ tin cậy cần thiết ở đó khác với trò chuyện chung, và Google đang định vị 3.8 Flash trực tiếp cho tính tự chủ doanh nghiệp trong các miền tri thức này.
Gemini 3.8 Flash chạy bên trong Google Antigravity và Google AI Studio, nơi một prompt lặp duy nhất có thể dẫn dắt nó qua toàn bộ quá trình xây dựng.
Ví dụ của chính Google là một phiên bản Google Maps kiểu DOS có thể chơi được tạo từ một prompt trong Antigravity, bao gồm địa điểm, chỉ đường và Street View.
Cho công việc của bạn, hãy tưởng tượng đưa một chỉ dẫn như "xây một bảng điều khiển tương tác lấy CSV này, vẽ ba loại biểu đồ và cho phép tôi lọc theo khu vực", rồi để vòng lặp tác nhân chạy cho đến khi vận hành được.
Mẫu lặp chỉ dẫn là nơi các mức nỗ lực bổ sung phát huy tác dụng, vì mô hình tiếp tục tinh chỉnh thay vì dừng ở bản nháp đầu tiên.
Bức tranh điểm chuẩn không đồng đều, điều này hữu ích hơn một màn thắng tuyệt đối vì cho biết chính xác các cải thiện rơi vào đâu.
Các tác vụ lập trình và terminal cải thiện rõ rệt, trong khi suy luận kiểu bài thi hầu như không thay đổi.
Dưới đây là các con số từ tài liệu nhà phát triển và thông báo của Google.
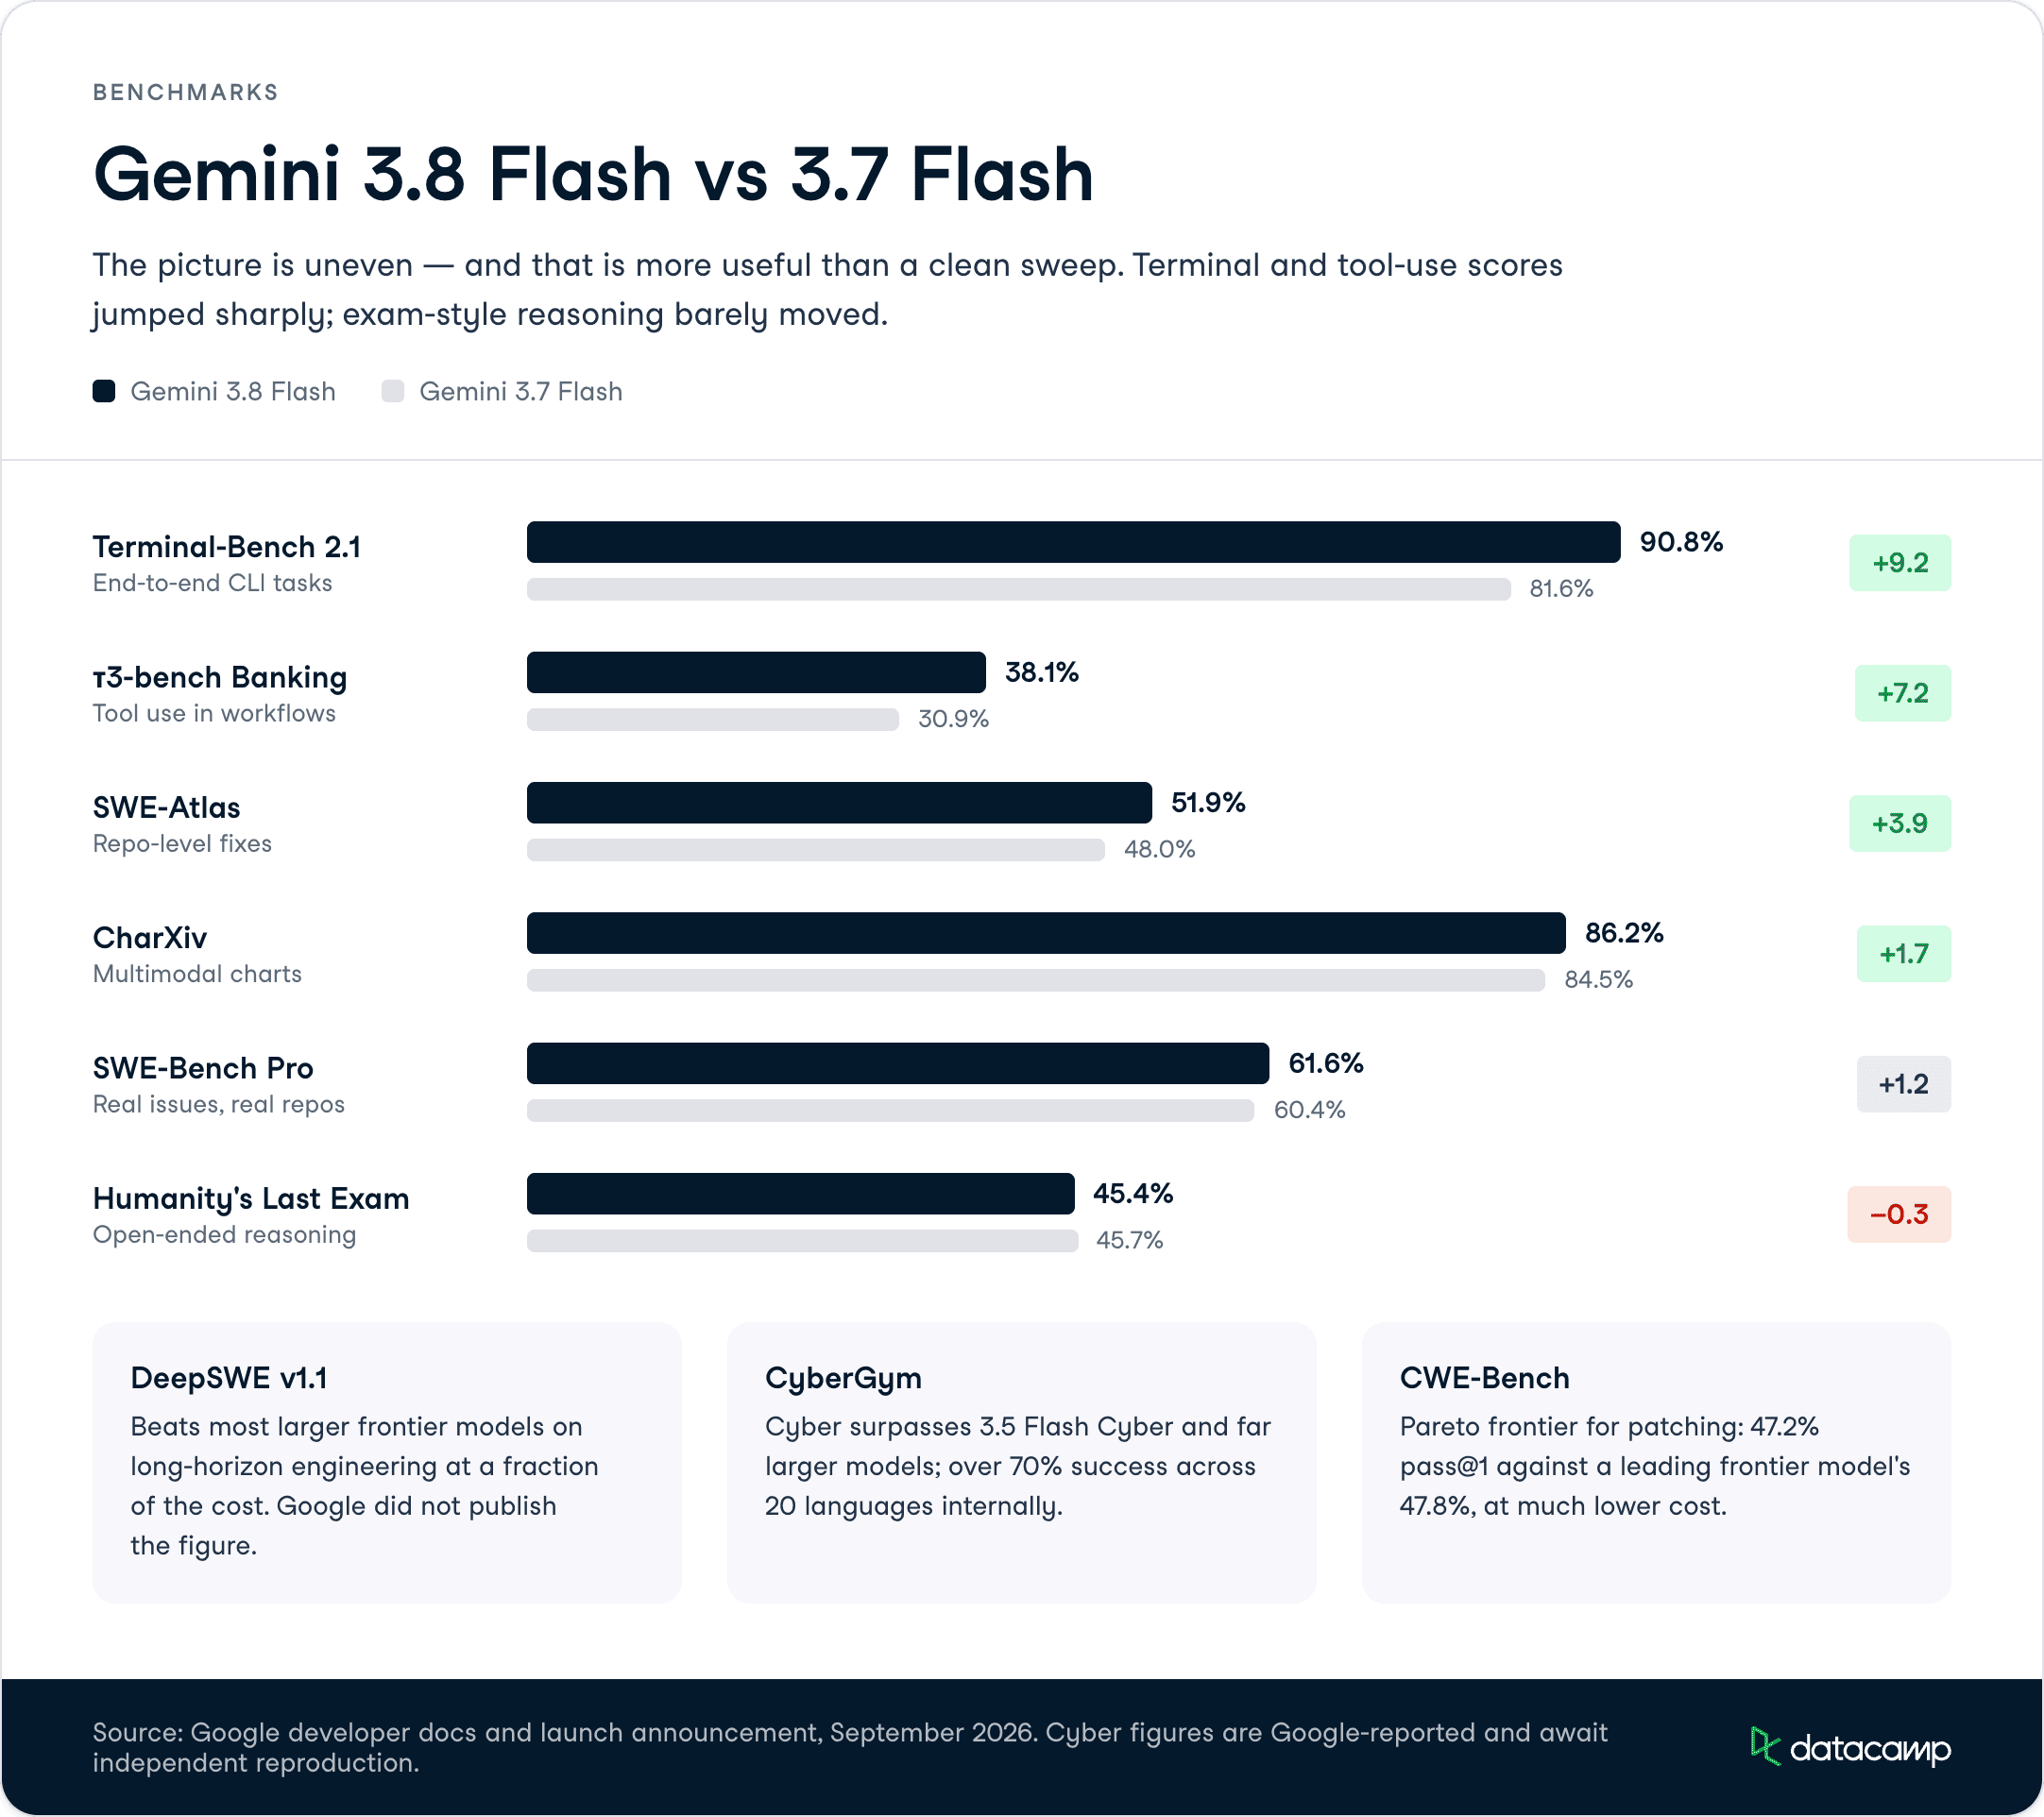
Gemini 3.8 Flash đạt 90,8% trên Terminal-Bench 2.1, tăng từ 81,6% của 3.7 Flash.
Điểm chuẩn này đo mức độ đáng tin cậy khi một mẫu hoàn thành các tác vụ dòng lệnh và lập trình thực tế từ đầu đến cuối, bao gồm chạy công cụ và phục hồi sau lỗi.
Để tham chiếu các mẫu tầm trung đối thủ, trong so sánh GPT-5.6 Terra với Claude Sonnet 5 của chúng tôi, Terra đạt 87,4% trên Terminal-Bench 2.1 và Sonnet 5 đạt 80,4%. Với kết quả đó, 90,8% của 3.8 Flash nhỉnh hơn cả hai, một tuyên bố đáng chú ý cho mẫu phân khúc Flash với giá đầu vào 0,75 USD.
Trên DeepSWE v1.1, một điểm chuẩn kỹ thuật phần mềm tầm xa, 3.8 Flash vượt qua hầu hết các mẫu frontier lớn hơn với chi phí chỉ bằng một phần nhỏ.
Google không công bố phần trăm chính xác trong ghi chú trích xuất, nhưng cách diễn giải là nó giải quyết tự động các vấn đề kỹ thuật phức tạp từ đầu đến cuối.
Đây là điểm chuẩn hậu thuẫn cho thông điệp "tác nhân hoàn thành công việc".
Nếu công việc của bạn liên quan đến tác nhân lặp qua codebase trong nhiều bước, DeepSWE gần với thực tế của bạn hơn là một điểm số lập trình một phát.
Trên SWE-Bench Pro, 3.8 Flash đạt 61,6% so với 60,4% của 3.7 Flash, và trên SWE-Atlas đạt 51,9% so với 48,0%.
Đây là các điểm chuẩn kỹ thuật phần mềm cấp độ kho mã, đo lường việc sửa lỗi thực trong các codebase thực.
Mức tăng hơn 1 điểm trên SWE-Bench Pro là khiêm tốn, đáng lưu ý. Các bước nhảy lớn nằm ở Terminal-Bench, nên nếu bạn quan tâm đặc biệt đến độ tin cậy của terminal và công cụ, đó là nơi 3.8 Flash tách biệt so với tiền nhiệm.
3.8 Flash đạt 54,9% trên HLE-Verified, một bài kiểm tra suy luận nhiều bước trên các lĩnh vực STEM, khoa học xã hội-nhân văn và chuyên môn.
Tuy nhiên, trên so sánh tổng thể Humanity's Last Exam trong tài liệu nhà phát triển của Google, điểm gần như đi ngang: 45,4% cho 3.8 Flash so với 45,7% cho 3.7 Flash.
Suy luận kiểu bài thi nói chung không tiến nhiều, vì vậy nếu bài toán của bạn là suy luận mở khó thay vì lập trình và dùng công cụ, nâng cấp từ 3.7 lên 3.8 Flash có thể không đáng với số token bổ sung.
Gemini 3.8 Flash Cyber đạt mức frontier về phát hiện và vá lỗ hổng.
Trên CyberGym, điểm chuẩn công nghiệp tiêu chuẩn cho phát hiện lỗ hổng tự động, nó vượt 3.5 Flash Cyber và các mẫu frontier lớn hơn đáng kể, và trên điểm chuẩn nội bộ của Google bao phủ 20 ngôn ngữ lập trình, nó vượt mức 70% thành công.
Trên CWE-Bench, một điểm chuẩn vá lỗi bên ngoài do Collinear vận hành, Cyber nằm trên biên Pareto với pass@1 là 47,2% so với 47,8% của một mẫu frontier dẫn đầu, với chi phí thấp hơn nhiều.
Google cố ý ưu tiên sửa lỗ hổng hơn là khai thác tấn công, tương tự cách Anthropic xuất xưởng Sonnet 5 với các biện pháp bảo vệ cyber bật mặc định (0,0% trên một đánh giá phát triển khai thác Firefox, như chúng tôi đã ghi nhận trong bài đánh giá Opus 5 vs Sonnet 5).
Trong bảng dưới đây, bạn có thể thấy mẫu mới so với đàn anh vừa ra mắt vài tuần trước:
| Điểm chuẩn | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90,8% | 81,6% |
| SWE-Bench Pro | 61,6% | 60,4% |
| SWE-Atlas | 51,9% | 48,0% |
| τ³-bench Banking | 38,1% | 30,9% |
| CharXiv (đa phương thức) | 86,2% | 84,5% |
| Humanity's Last Exam | 45,4% | 45,7% |
Gemini 3.8 Flash khả dụng rộng rãi qua Google AI Studio và Nền tảng Gemini Enterprise Agent, phát hành ngày 2 tháng 9 năm 2026, với ID mẫu API gemini-3.8-flash.
Biến thể 3.8 Flash Cyber bị giới hạn cho các defender đáng tin cậy qua Chương trình Fairwind và không phát hành rộng rãi.
Mức giá giữ nguyên như 3.7 Flash:
Để so sánh với đối thủ tính đến tháng 9 năm 2026: GPT-5.6 Sol khoảng 5 USD đầu vào và 30 USD đầu ra mỗi 1 triệu token, và Claude Fable 5.1 mới có giá 10 USD đầu vào và 50 USD đầu ra.
Gemini 3.8 Flash rẻ hơn cả hai với biên lớn, đó là mục tiêu của phân khúc Flash.
Gemini 3.8 Flash cho thấy Google đang đẩy mạnh ở phân khúc giá trị của thị trường mẫu lập trình, với chiến lược rõ ràng: đạt hiệu năng gần frontier cho lập trình ở mức giá 0,75 USD đầu vào, đồng thời tung mẫu Flash mới mỗi vài tuần.
Mức 90,8% trên Terminal-Bench 2.1 và giá dưới 1 USD khiến nó trở thành lựa chọn mặc định nghiêm túc cho khối lượng công việc lập trình dạng tác nhân.
Theo tôi, bản phát hành này không đồng đều, và Google thẳng thắn về điều đó.
Điểm terminal và sử dụng công cụ tăng mạnh, DeepSWE cùng các điểm chuẩn tài chính và pháp lý cải thiện, nhưng HLE đi ngang và SWE-Bench Pro hầu như không nhúc nhích.
Nếu bạn xây tác nhân lập trình, đây là nâng cấp đáng giá so với 3.7 Flash.
Nếu bạn cần suy luận mở khó, luận điểm kém thuyết phục hơn, và tiếp tục dùng 3.7 Flash cho công việc ưu tiên hiệu quả là lựa chọn hợp lý.
Biến thể Cyber là nước cờ dài hạn thú vị hơn. Tỷ lệ phát hiện lỗ hổng trong thế giới thực 70%+ và khả năng vá ở biên Pareto, được giới hạn qua Chương trình Fairwind và thiên về phòng thủ hơn tấn công, là lập trường có thể bảo vệ cho một công ty vốn đã dùng nó để bảo vệ mã nguồn nội bộ.
Tôi muốn thấy các tái lập độc lập trước khi chấp nhận nguyên xi các con số CyberGym và CWE-Bench, vì gần như toàn bộ dữ liệu đến từ chính Google.
Nếu bạn muốn xây tác nhân và quy trình lập trình xoay quanh các mẫu như vậy, lộ trình kỹ năng AI Agent Fundamentals của chúng tôi là điểm khởi đầu vững chắc.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
