Curso
IA na prática com Google Gemini e NotebookLM
2 h
10K
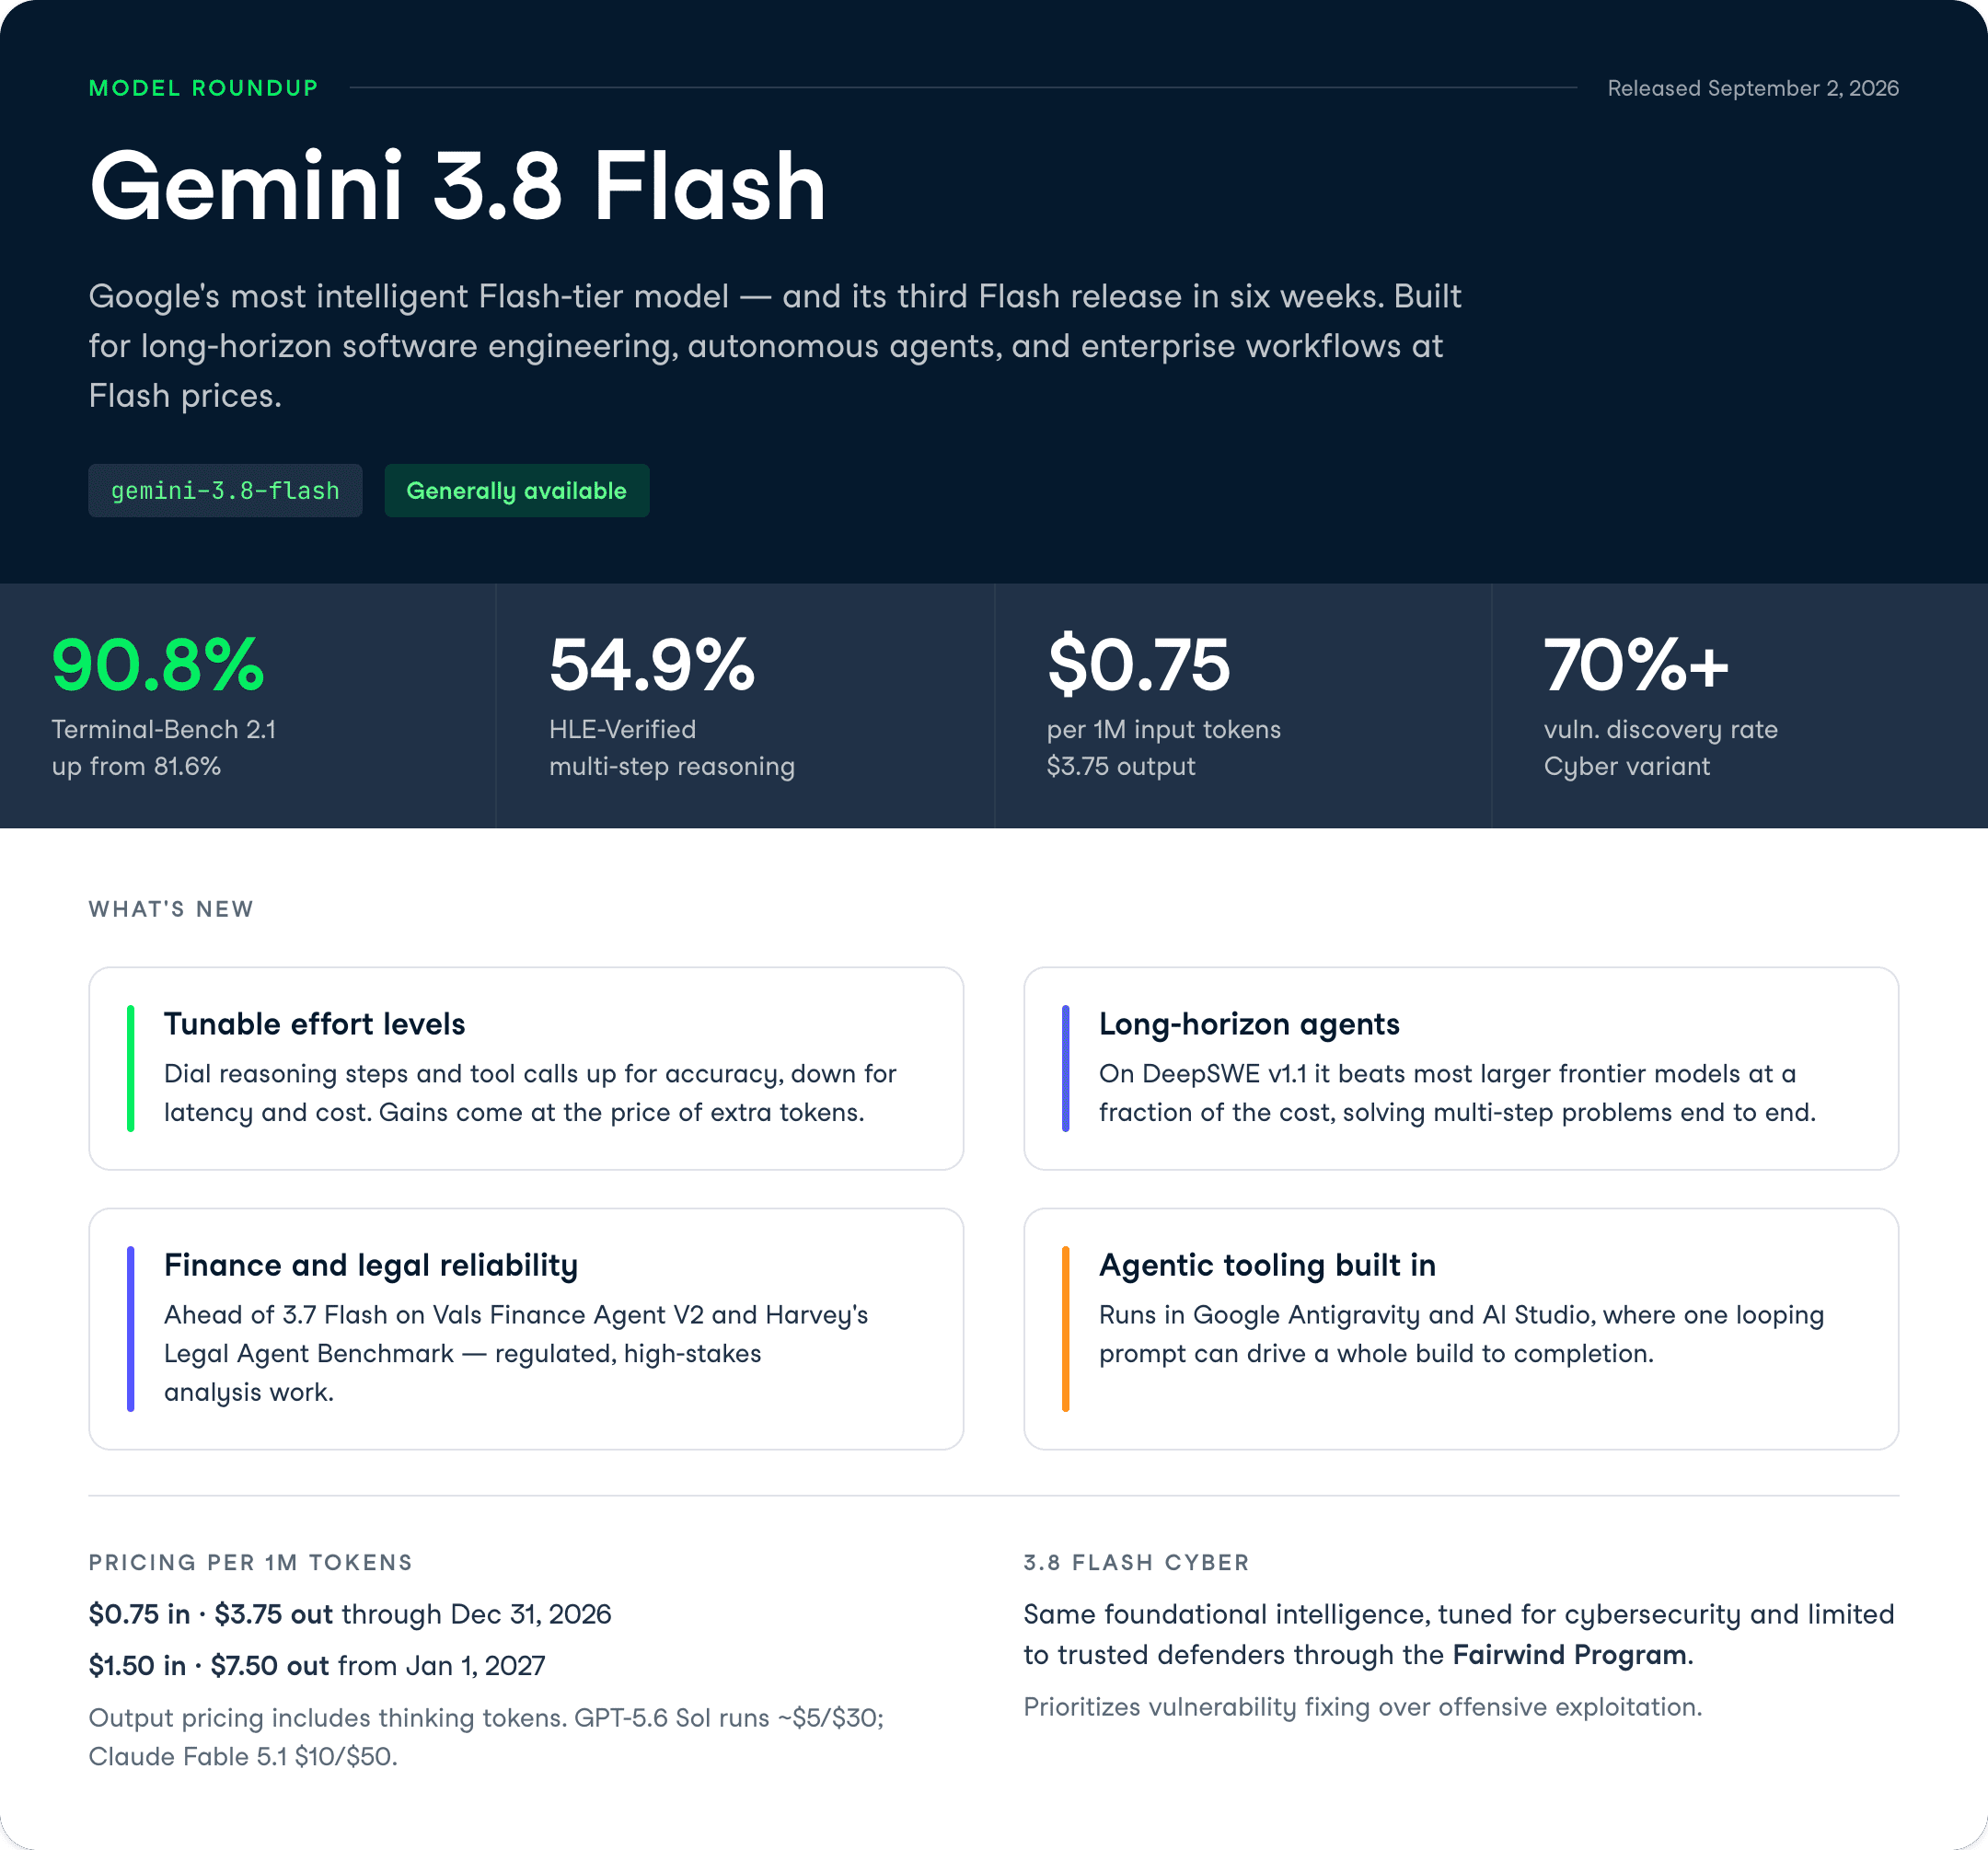
O Google está lançando modelos Flash em um ritmo difícil de acompanhar. O Gemini 3.8 Flash é o terceiro lançamento da linha em seis semanas e chega como seu melhor modelo de raciocínio e código no segmento Flash — mantendo a mesma velocidade e o baixo custo do 3.7 Flash de três semanas antes.
Junto do modelo padrão, o Google apresentou o Gemini 3.8 Flash Cyber, uma variante ajustada para trabalhos de cibersegurança, disponível apenas para defensores confiáveis por meio do Fairwind Program, iniciativa de acesso limitado lançada junto com os novos modelos. Ambos compartilham a mesma inteligência fundamental.
Os números chamam atenção: o Gemini 3.8 Flash marcou 90,8% no Terminal-Bench 2.1 (contra 81,6% do 3.7 Flash), 54,9% no HLE-Verified e uma taxa de descoberta de vulnerabilidades acima de 70% para a variante Cyber em cenários reais.
Neste artigo, vou cobrir tudo o que há de novo no Gemini 3.8 Flash e no 3.8 Flash Cyber, passando pelos recursos, explorando os benchmarks e testando na prática com exemplos. Veja o modelo em ação no nosso tutorial da API do Gemini 3.8 Flash e conheça o novo assistente de voz do Google no nosso guia sobre o Gemini 3.8 Live.
Para entender os modelos rivais com os quais ele concorre, veja nossos comparativos entre DeepSeek v4.1 vs Gemini 3.8 Flash e Claude Opus 5 vs Sonnet 5.
O Gemini 3.8 Flash é o modelo mais inteligente do Google na faixa Flash, projetado para engenharia de software de longo horizonte, agentes autônomos e fluxos de trabalho corporativos complexos.
Ele fica abaixo da faixa Pro (como o Gemini 3.1 Pro), mas custa uma fração do preço, mantendo a tarifa de lançamento de US$ 0,75 por 1M de tokens de entrada e US$ 3,75 por 1M de tokens de saída até 31 de dezembro de 2026.
A principal mudança em relação ao 3.7 Flash é que o 3.8 Flash simplesmente se esforça mais.
Em tarefas complexas, ele executa passos extras de raciocínio e chama ferramentas de forma iterativa — por isso consegue se aproximar do desempenho de modelos de fronteira mais caros. A troca é o overhead de tokens: em níveis de esforço mais altos, o modelo pode consumir mais tokens para extrair os últimos pontos de precisão.
O destaque dos benchmarks é o Terminal-Bench 2.1, onde o 3.8 Flash marcou 90,8% contra 81,6% do 3.7 Flash. O Terminal-Bench mede quão confiavelmente um modelo completa tarefas reais de linha de comando e programação de ponta a ponta, então um salto de 9 pontos aponta direto para um comportamento agente melhor no coding.
 O que há de novo no Gemini 3.8 Flash?
Os recursos do 3.8 Flash miram desenvolvedores que rodam agentes e longas sessões de código, não usuários ocasionais de chat.
Veja as capacidades que valem a pena conhecer.
Você pode aumentar ou reduzir o esforço do modelo dependendo se prioriza mais a precisão ou o custo.
Isso importa porque os ganhos do 3.8 Flash vêm ao preço de tokens extras.
Se sua carga de trabalho prioriza eficiência, o Google afirma explicitamente que você pode continuar no 3.7 Flash, que segue totalmente suportado.
É um recado incomum em um anúncio do Google — e mostra que o controle de esforço é uma troca real, não desempenho grátis.
O Gemini 3.8 Flash foi feito para rodar agentes que resolvem problemas de engenharia em múltiplas etapas sem precisar de supervisão constante.
No DeepSWE v1.1, um benchmark de engenharia de software de longo horizonte, ele supera a maioria dos modelos de fronteira maiores por uma fração do custo, resolvendo problemas complexos de ponta a ponta.
Para quem constrói agentes de código, esse é o número que conta.
Usuários no Reddit e no X vazando impressões pré-lançamento o descreveram como "desempenho nível Fable 5 com preço de Flash", e o Wall Street Journal informou que, nos testes internos Jetski do Google, engenheiros preferiram o 3.8 Flash ao Opus da Anthropic para programação.
É uma afirmação competitiva agressiva — vale validar assim que a API estiver amplamente disponível.
O 3.8 Flash mira setores regulados e de alto risco, onde errar sai caro.
Ele supera o 3.7 Flash e outros modelos de fronteira no Vals Finance Agent V2 e no Harvey's Legal Agent Benchmark, que testam análise e relatórios em finanças e direito.
Pense em um fluxo de trabalho no qual um agente lê um conjunto de demonstrações trimestrais e redige um sumário de compliance, ou revisa cláusulas contratuais frente a uma política. A confiabilidade exigida ali é diferente de um chat genérico — e o Google posiciona o 3.8 Flash diretamente para autonomia corporativa nesses domínios de conhecimento.
O Gemini 3.8 Flash roda dentro do Google Antigravity e do Google AI Studio, onde um único prompt em loop pode conduzi-lo por todo o build.
No exemplo do próprio Google, um Google Maps no estilo DOS, totalmente jogável, foi gerado a partir de um único prompt no Antigravity — com locais, rotas e Street View.
No seu dia a dia, imagine dar uma instrução única como "construa um dashboard interativo que puxe este CSV, desenhe três tipos de gráfico e me deixe filtrar por região" e deixar o loop agentic iterar até rodar.
Esse padrão de instrução em loop é onde os níveis extras de esforço rendem mais, já que o modelo segue refinando em vez de parar no primeiro rascunho.
O panorama dos benchmarks é desigual — e isso é útil porque mostra onde os ganhos realmente aconteceram.
Tarefas de terminal e programação melhoraram bastante; já o raciocínio em formato de prova quase não mudou.
Confira os números dos docs para desenvolvedores e do anúncio do Google.
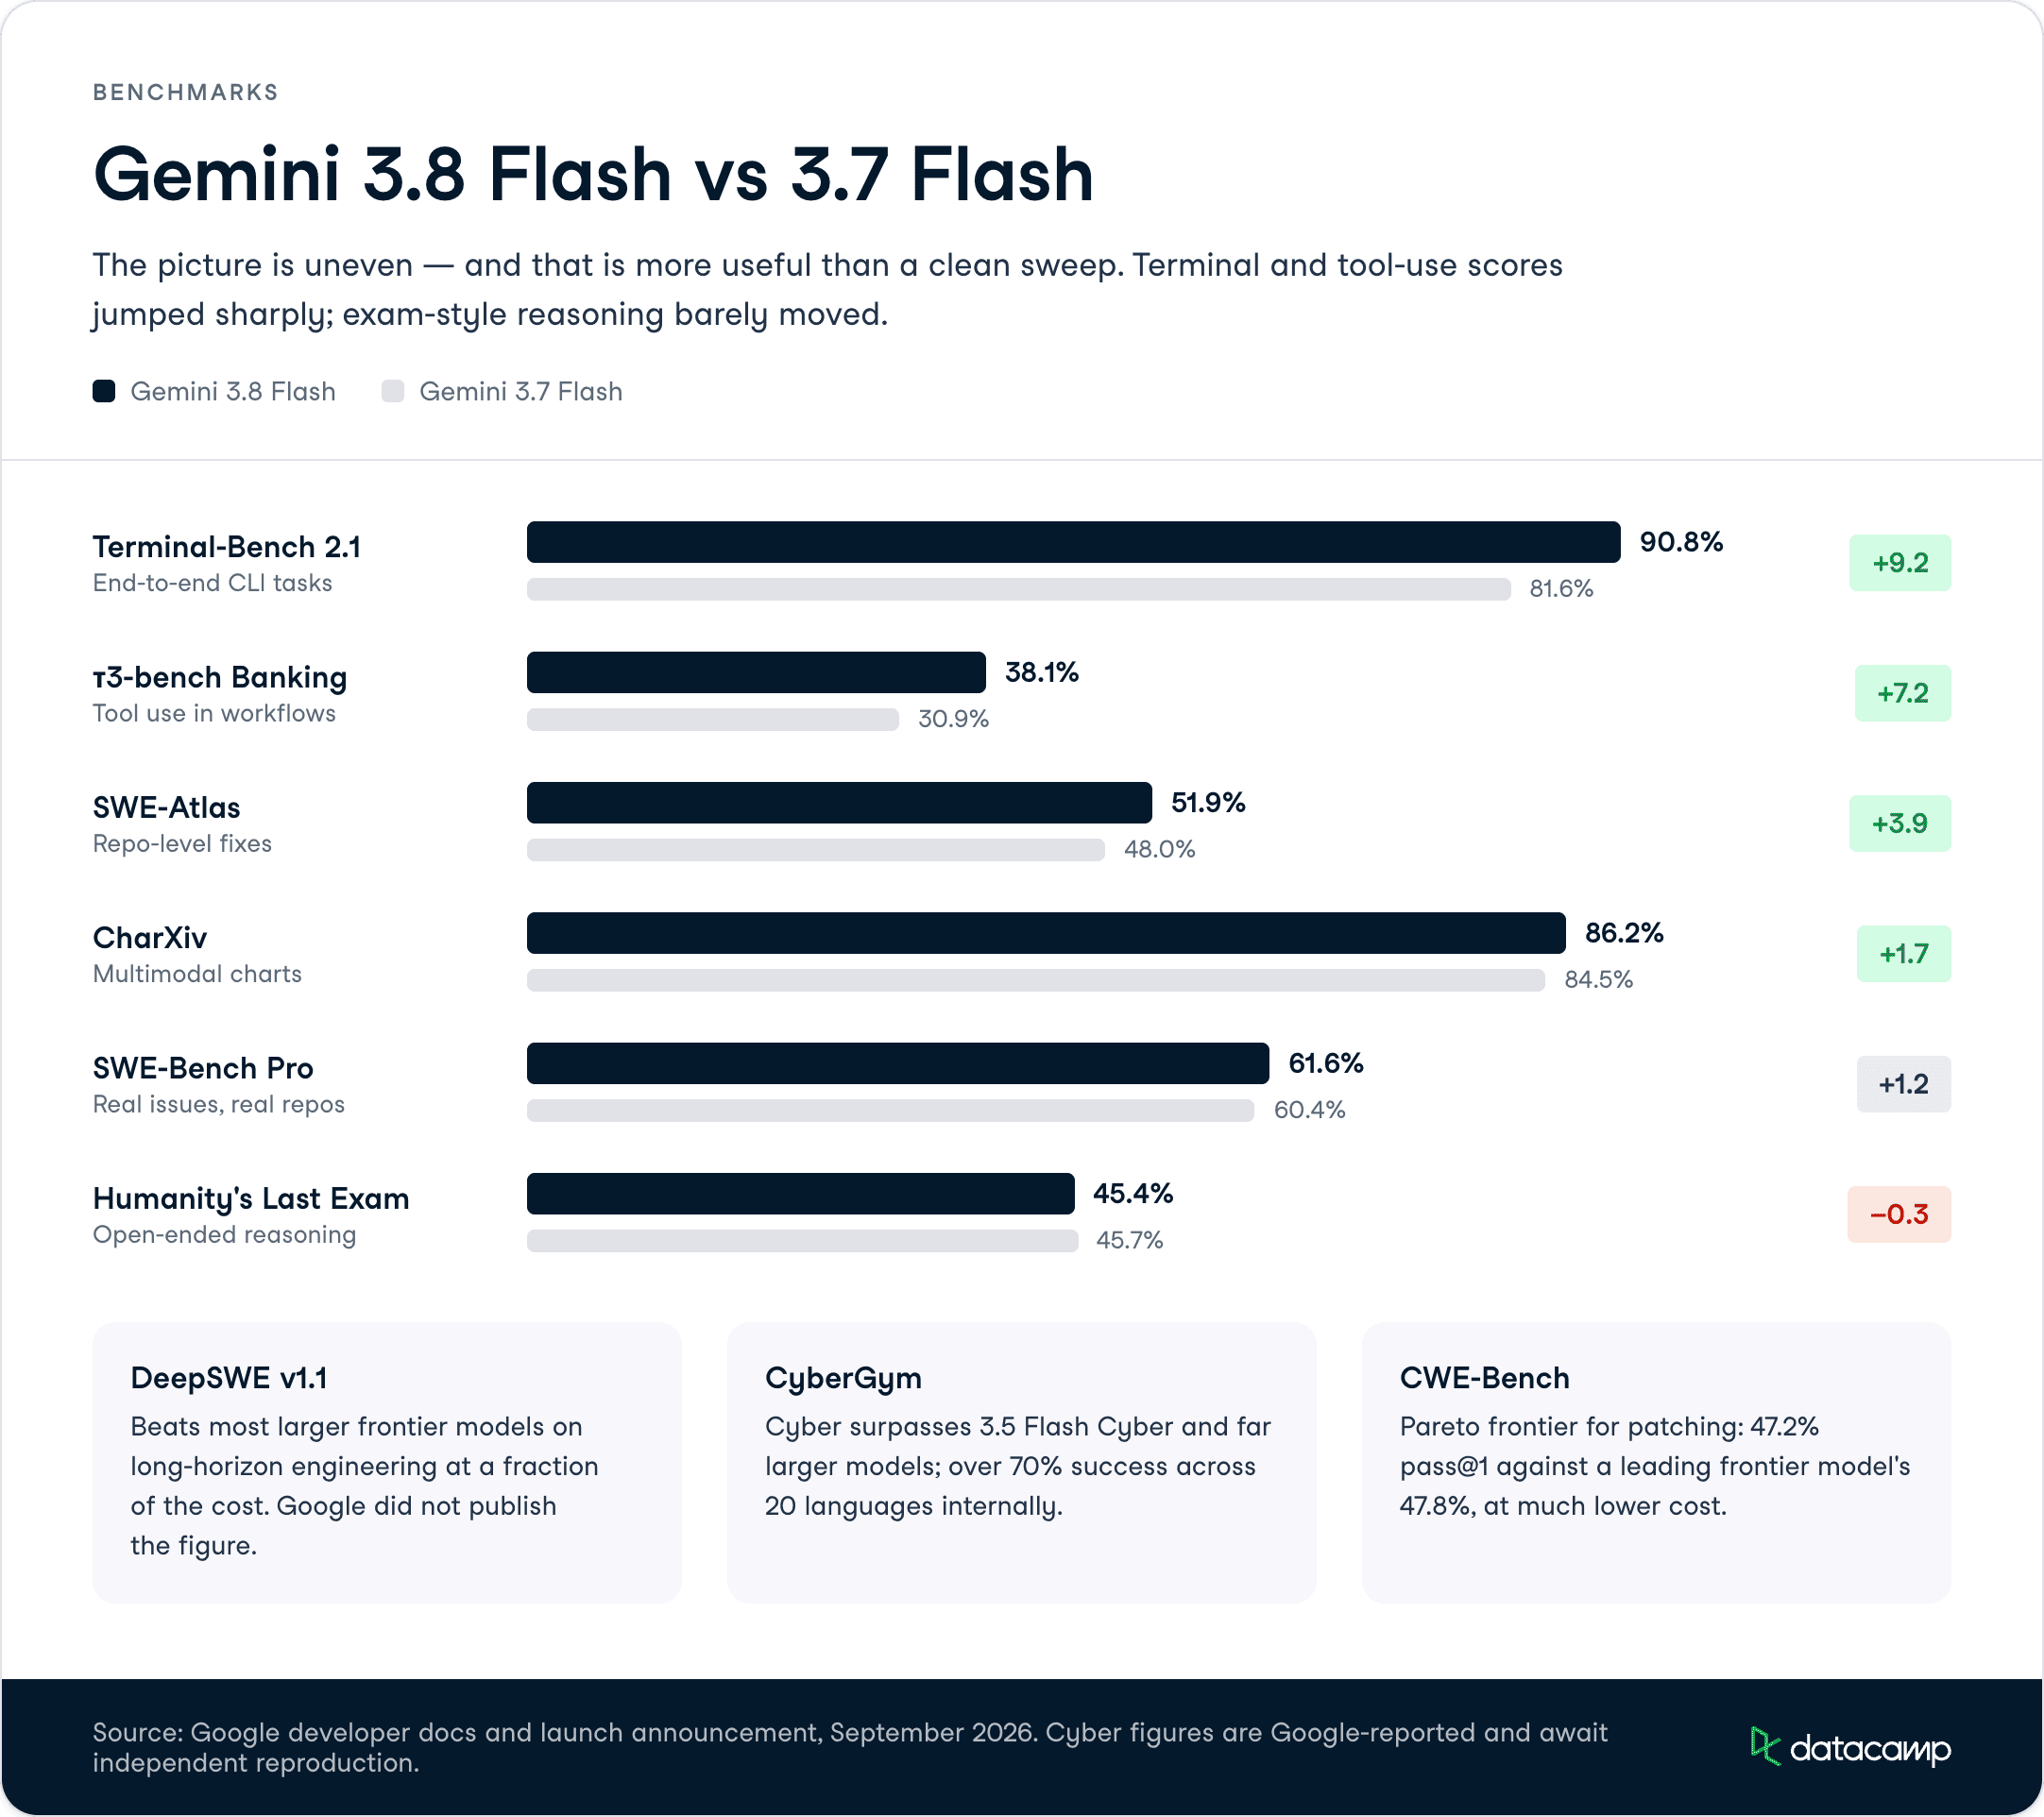
O Gemini 3.8 Flash marcou 90,8% no Terminal-Bench 2.1, contra 81,6% do 3.7 Flash.
Esse benchmark mede quão confiavelmente um modelo completa tarefas reais de linha de comando e programação de ponta a ponta, incluindo rodar ferramentas e se recuperar de erros.
Para contexto frente a modelos intermediários rivais, no nosso comparativo entre GPT-5.6 Terra e Claude Sonnet 5, vimos o Terra com 87,4% no Terminal-Bench 2.1 e o Sonnet 5 com 80,4%. Nesse placar, os 90,8% do 3.8 Flash ficam à frente de ambos — um feito notável para um modelo da faixa Flash a US$ 0,75 de entrada.
No DeepSWE v1.1, benchmark de engenharia de software de longo horizonte, o 3.8 Flash supera a maioria dos modelos de fronteira maiores a uma fração do custo.
O Google não publicou a porcentagem exata nas notas extraídas, mas o resumo é que ele resolve problemas complexos de engenharia de forma autônoma, de ponta a ponta.
Este é o benchmark que sustenta a proposta de "agente que entrega o trabalho".
Se sua carga envolve um agente iterando sobre uma base de código por muitas etapas, o DeepSWE se aproxima mais da sua realidade do que uma pontuação de coding em tiro único.
No SWE-Bench Pro, o 3.8 Flash marcou 61,6% contra 60,4% do 3.7 Flash; no SWE-Atlas, chegou a 51,9% versus 48,0%.
São benchmarks em nível de repositório que medem a correção de issues reais em bases de código reais.
O ganho de pouco mais de 1 ponto no SWE-Bench Pro é modesto — vale notar. Os saltos maiores estão no Terminal-Bench; então, se você se importa com terminal e confiabilidade no uso de ferramentas, é aí que o 3.8 Flash se destaca em relação ao antecessor.
O 3.8 Flash atinge 54,9% no HLE-Verified, um teste de raciocínio em múltiplas etapas em STEM, humanidades e áreas profissionais.
Já no Humanity's Last Exam, mais amplo, a pontuação ficou praticamente estável: 45,4% para o 3.8 Flash contra 45,7% do 3.7 Flash.
O raciocínio em formato de prova geral quase não avançou; então, se seu caso de uso é raciocínio aberto difícil (e não código e ferramentas), talvez a troca do 3.7 para o 3.8 Flash não compense os tokens extras.
O Gemini 3.8 Flash Cyber traz resultados de nível de fronteira em descoberta e correção de vulnerabilidades.
No CyberGym, benchmark padrão do setor para descoberta autônoma de vulnerabilidades, ele supera o 3.5 Flash Cyber e modelos de fronteira bem maiores; e, no benchmark interno do Google cobrindo 20 linguagens de programação, passa de 70% de sucesso.
No CWE-Bench, benchmark externo de correção conduzido pela Collinear, o Cyber fica na fronteira de Pareto com pass@1 de 47,2% contra 47,8% de um modelo líder de fronteira — a um custo muito menor.
O Google priorizou deliberadamente a correção de vulnerabilidades em vez da exploração ofensiva, algo que lembra a Anthropic ao lançar o Sonnet 5 com proteções cibernéticas ativadas por padrão (0,0% em um eval de desenvolvimento de exploit do Firefox, como apontamos na nossa análise de Opus 5 vs Sonnet 5).
Na tabela abaixo, você vê como o novo modelo se compara ao antecessor de poucas semanas:
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90,8% | 81,6% |
| SWE-Bench Pro | 61,6% | 60,4% |
| SWE-Atlas | 51,9% | 48,0% |
| τ³-bench Banking | 38,1% | 30,9% |
| CharXiv (multimodal) | 86,2% | 84,5% |
| Humanity's Last Exam | 45,4% | 45,7% |
O Gemini 3.8 Flash está disponível de forma geral no Google AI Studio e na Gemini Enterprise Agent Platform, lançado em 2 de setembro de 2026, com o ID de modelo da API gemini-3.8-flash.
A variante 3.8 Flash Cyber é restrita a defensores confiáveis via Fairwind Program e não tem disponibilidade geral.
Os preços mantêm as mesmas tarifas de lançamento do 3.7 Flash:
Para comparar com rivais em setembro de 2026: o GPT-5.6 Sol sai por cerca de US$ 5 de entrada e US$ 30 de saída por 1M de tokens, e o novo Claude Fable 5.1 custa US$ 10 de entrada e US$ 50 de saída.
O Gemini 3.8 Flash fica muito abaixo de ambos — essa é justamente a proposta da faixa Flash.
O Gemini 3.8 Flash mostra o Google acelerando no segmento de valor do mercado de modelos para código. A estratégia é clara: entregar desempenho quase de fronteira em coding por US$ 0,75 de entrada, lançando um novo Flash a cada poucas semanas.
Os 90,8% no Terminal-Bench 2.1 e o preço abaixo de US$ 1 o tornam um forte padrão para cargas de trabalho com agentes de código.
Minha leitura é que o lançamento é desigual — e o próprio Google admite.
As pontuações de terminal e uso de ferramentas subiram, o DeepSWE e os benchmarks de finanças e jurídico melhoraram, mas o HLE ficou estável e o SWE-Bench Pro quase não mexeu.
Se você constrói agentes de programação, é um upgrade relevante em relação ao 3.7 Flash.
Se você precisa de raciocínio aberto duro, o caso é mais fraco — e permanecer no 3.7 Flash, priorizando eficiência, é uma decisão razoável.
A variante Cyber é a aposta mais interessante no longo prazo. Uma taxa real de descoberta de vulnerabilidades acima de 70% e correção na fronteira de Pareto, com acesso via Fairwind Program e viés para defesa (em vez de exploração), é uma posição defensável para uma empresa que já usa o modelo para proteger seu próprio código.
Eu aguardaria reproduções independentes antes de tomar os números do CyberGym e do CWE-Bench ao pé da letra, já que quase todos os dados até agora vêm do próprio Google.
Se você quer criar agentes e fluxos de desenvolvimento em torno de modelos como este, nossa trilha de aprendizado AI Agent Fundamentals é um ótimo ponto de partida.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Richie Cotton
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan