Trực quan hóa dữ liệu đang nhanh chóng trở thành một kỹ năng thiết yếu trong phân tích dữ liệu và khoa học dữ liệu, và các kỹ năng trực quan hóa tốt được cần đến trong nhiều ngành như tài chính, giáo dục và chăm sóc sức khỏe. Điều này không có gì ngạc nhiên: khi các nhà phân tích phải xử lý khối lượng dữ liệu phức tạp và đa dạng ngày càng tăng, trực quan hóa dữ liệu cung cấp một tập hợp kỹ thuật để thấu hiểu và truyền đạt hiệu quả các insight.
Từng được coi là một chủ đề nhỏ trong khoa học dữ liệu, ngày nay, trực quan hóa dữ liệu đang được làm giàu bởi nhiều kỹ thuật, công cụ, lý thuyết thú vị và những đóng góp từ các lĩnh vực khác nhau như tâm lý học và thần kinh học. Nếu bạn quan tâm đến việc trở thành “phù thủy” trực quan hóa dữ liệu, DataCamp có thể giúp bạn. Hãy xem danh mục khóa học trực quan hóa dữ liệu của chúng tôi để truy cập hơn 30 khóa học do các chuyên gia hàng đầu giảng dạy, bao phủ nhiều công nghệ phổ biến.
Bài viết này cung cấp cái nhìn tổng quan về hiện trạng của trực quan hóa dữ liệu. Chúng tôi sẽ tập trung vào các phân tích, kỹ thuật và công cụ trực quan hóa dữ liệu phổ biến nhất. Tiếp tục đọc nhé!
Sức mạnh của trực quan hóa dữ liệu tốt
Trực quan hóa dữ liệu liên quan đến việc sử dụng các biểu diễn đồ họa của dữ liệu, như đồ thị, biểu đồ và bản đồ. Hình ảnh trực quan cho phép các nhà khoa học dữ liệu tóm tắt hàng nghìn hàng và cột dữ liệu phức tạp thành định dạng dễ hiểu và dễ tiếp cận. So với thống kê mô tả hoặc bảng biểu, hình ảnh trực quan cung cấp cách phân tích dữ liệu hiệu quả hơn, bao gồm xác định mẫu, phân phối, tương quan và phát hiện ngoại lệ trong các tập dữ liệu phức tạp.
Bằng cách thổi hồn vào dữ liệu với các biểu đồ sâu sắc, trực quan hóa dữ liệu đóng vai trò quan trọng trong các quy trình ra quyết định. Dù là nhà phân tích dữ liệu đang diễn giải phát hiện của mình cho các bên liên quan không chuyên môn, nhà khoa học dữ liệu thực hiện A/B test cho mục đích marketing, hay kỹ sư học máy giải thích các thiên lệch tiềm ẩn trong các mô hình ngôn ngữ lớn phức tạp như ChatGPT, trực quan hóa dữ liệu là chìa khóa để chuyển từ insight sang quyết định.
Dù đã sử dụng trực quan hóa dữ liệu, nhiều phân tích dữ liệu kỹ lưỡng và chi tiết vẫn bị “xếp ngăn kéo” chỉ vì một lý do đơn giản: chúng không thu hút được khán giả, dù là người ra quyết định, bên liên quan hay thành viên khác trong nhóm.
Nhờ những tiến bộ trong các lĩnh vực như thần kinh học, ngày nay chúng ta biết cách một trực quan hóa được thể hiện có thể ảnh hưởng mạnh mẽ đến cách con người nhìn nhận nó. Những lựa chọn bạn đưa ra khi thiết kế đồ thị – ví dụ, màu sắc, bố cục và kích thước – có thể tạo nên khác biệt lớn. Quan tâm đến lý thuyết đằng sau trực quan hóa dữ liệu? Khóa học Understanding Data Visualization của chúng tôi là điểm khởi đầu tuyệt vời.
Dù trực quan hóa dữ liệu đóng vai trò quan trọng khi truyền đạt insight, công thức cho giao tiếp thành công phức tạp hơn thế. Đó là ý tưởng đằng sau kể chuyện bằng dữ liệu (data storytelling), một cách tiếp cận đổi mới khuyến khích sử dụng hình ảnh trực quan, tường thuật và dữ liệu để biến insight thành hành động. Để biết thêm về kể chuyện bằng dữ liệu, hãy nghe podcast DataFramed của chúng tôi, nơi chúng tôi trò chuyện với Brent Dykes, Giám đốc cấp cao mảng Insights & Data Storytelling tại Blast Analytics và tác giả cuốn Effective Data Storytelling.
Các loại phân tích trực quan hóa dữ liệu
Trực quan hóa dữ liệu được dùng để phân tích trực quan hành vi của các biến khác nhau trong một tập dữ liệu, như mối quan hệ giữa các điểm dữ liệu trong một biến hoặc phân phối. Tùy vào số lượng biến bạn muốn nghiên cứu cùng lúc, có thể phân biệt ba loại phân tích trực quan hóa dữ liệu.
- Phân tích đơn biến (Univariate): Dùng để tóm tắt hành vi của chỉ một biến tại một thời điểm.
- Phân tích nhị biến (Bivariate): Giúp nghiên cứu mối quan hệ giữa hai biến.
- Phân tích đa biến (Multivariate): Cho phép phân tích từ hơn hai biến cùng lúc.
Các kỹ thuật trực quan hóa dữ liệu chủ chốt
Hãy cùng xem những kỹ thuật trực quan hóa dữ liệu phổ biến nhất!
Biểu đồ đường (Line plot)
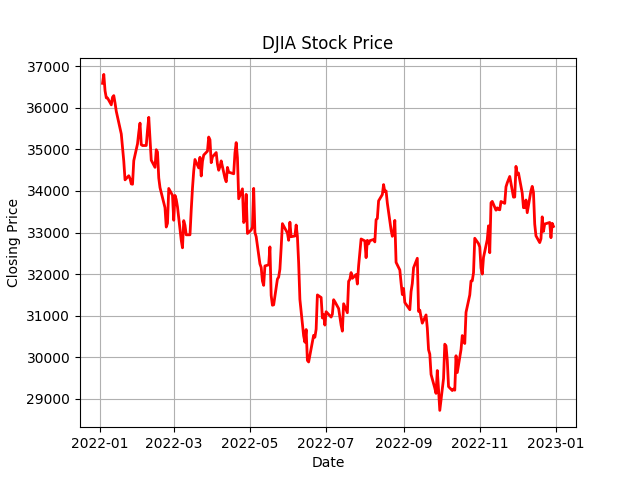
Là một trong những hình trực quan được dùng nhiều nhất, biểu đồ đường rất xuất sắc trong việc theo dõi sự biến thiên của một biến theo thời gian. Thông thường, trục x biểu diễn biến thời gian và trục y là biến bạn muốn phân tích. Ví dụ, biểu đồ đường dưới đây cho thấy diễn biến Giá cổ phiếu DJIA trong năm 2022.
Nguồn. DataCamp
Để học cách tạo biểu đồ đường hấp dẫn, hãy xem hướng dẫn Line Plots in MatplotLib with Python của chúng tôi.
Biểu đồ cột (Bar plot)
Biểu đồ cột xếp hạng dữ liệu theo giá trị của nhiều danh mục. Nó gồm các hình chữ nhật có chiều dài tỷ lệ với giá trị của từng danh mục. Biểu đồ cột rất phổ biến vì dễ đọc. Doanh nghiệp thường dùng để so sánh, như so thị phần của các thương hiệu hoặc doanh thu của các khu vực. Có nhiều loại biểu đồ cột, mỗi loại phù hợp với một mục đích khác nhau.
Có nhiều biến thể biểu đồ cột, mỗi loại phục vụ một mục đích riêng, bao gồm biểu đồ cột dọc, cột ngang và cột nhóm.
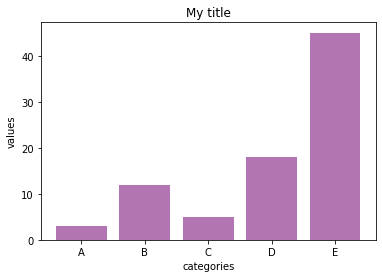
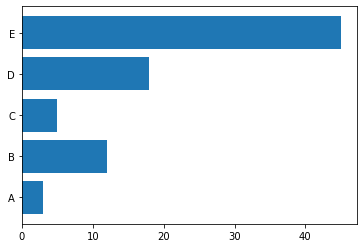
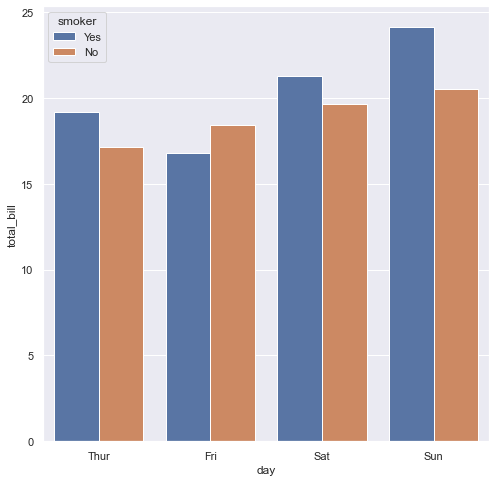
Biểu đồ cột dọc, ngang và nhóm.
Khóa học Introduction to Data Science in Python của chúng tôi bao quát nhiều kỹ thuật trực quan hóa dữ liệu, trong đó có biểu đồ cột.
Histogram
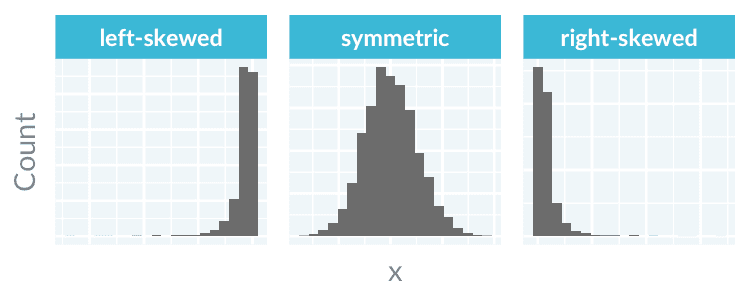
Histogram là một trong những hình trực quan phổ biến để phân tích phân phối dữ liệu. Chúng hiển thị phân phối của biến số bằng các cột.
Để xây dựng histogram, dữ liệu số trước tiên được chia thành các khoảng hoặc “bin”, và đếm tần suất xuất hiện của mỗi khoảng. Trục ngang thể hiện các khoảng, còn trục dọc biểu diễn tần suất hoặc phần trăm xuất hiện của một khoảng.
Histogram cho thấy ngay độ lệch của phân phối biến hoặc vị trí đỉnh. Dưới đây là ví dụ từ Series Data Demystified về các hình trực quan nắm bắt phân phối của chúng tôi.
Boxplot (hộp và râu)
Một biểu đồ tuyệt vời khác để tóm tắt phân phối của một biến là boxplot. Boxplot cung cấp cách直 quan và thuyết phục để nhận diện các thành phần sau:
- Trung vị (Median). Giá trị giữa của tập dữ liệu nơi 50% dữ liệu nhỏ hơn trung vị và 50% lớn hơn trung vị.
- Tứ phân vị trên. Phân vị thứ 75 của tập dữ liệu, nơi 75% dữ liệu nhỏ hơn tứ phân vị trên và 25% dữ liệu lớn hơn tứ phân vị trên.
- Tứ phân vị dưới. Phân vị thứ 25 của tập dữ liệu, nơi 25% dữ liệu nhỏ hơn tứ phân vị dưới và 75% lớn hơn tứ phân vị dưới.
- Khoảng tứ phân vị (IQR). Tứ phân vị trên trừ tứ phân vị dưới.
- Giá trị kề trên. Thường gọi là “giá trị lớn nhất”. Đại diện cho tứ phân vị trên cộng 1,5 lần khoảng tứ phân vị.
- Giá trị kề dưới. Thường gọi là “giá trị nhỏ nhất”. Đại diện cho tứ phân vị dưới trừ 1,5 lần khoảng tứ phân vị.
- Giá trị ngoại lệ. Bất kỳ giá trị nào lớn hơn “giá trị lớn nhất” hoặc nhỏ hơn “giá trị nhỏ nhất”.
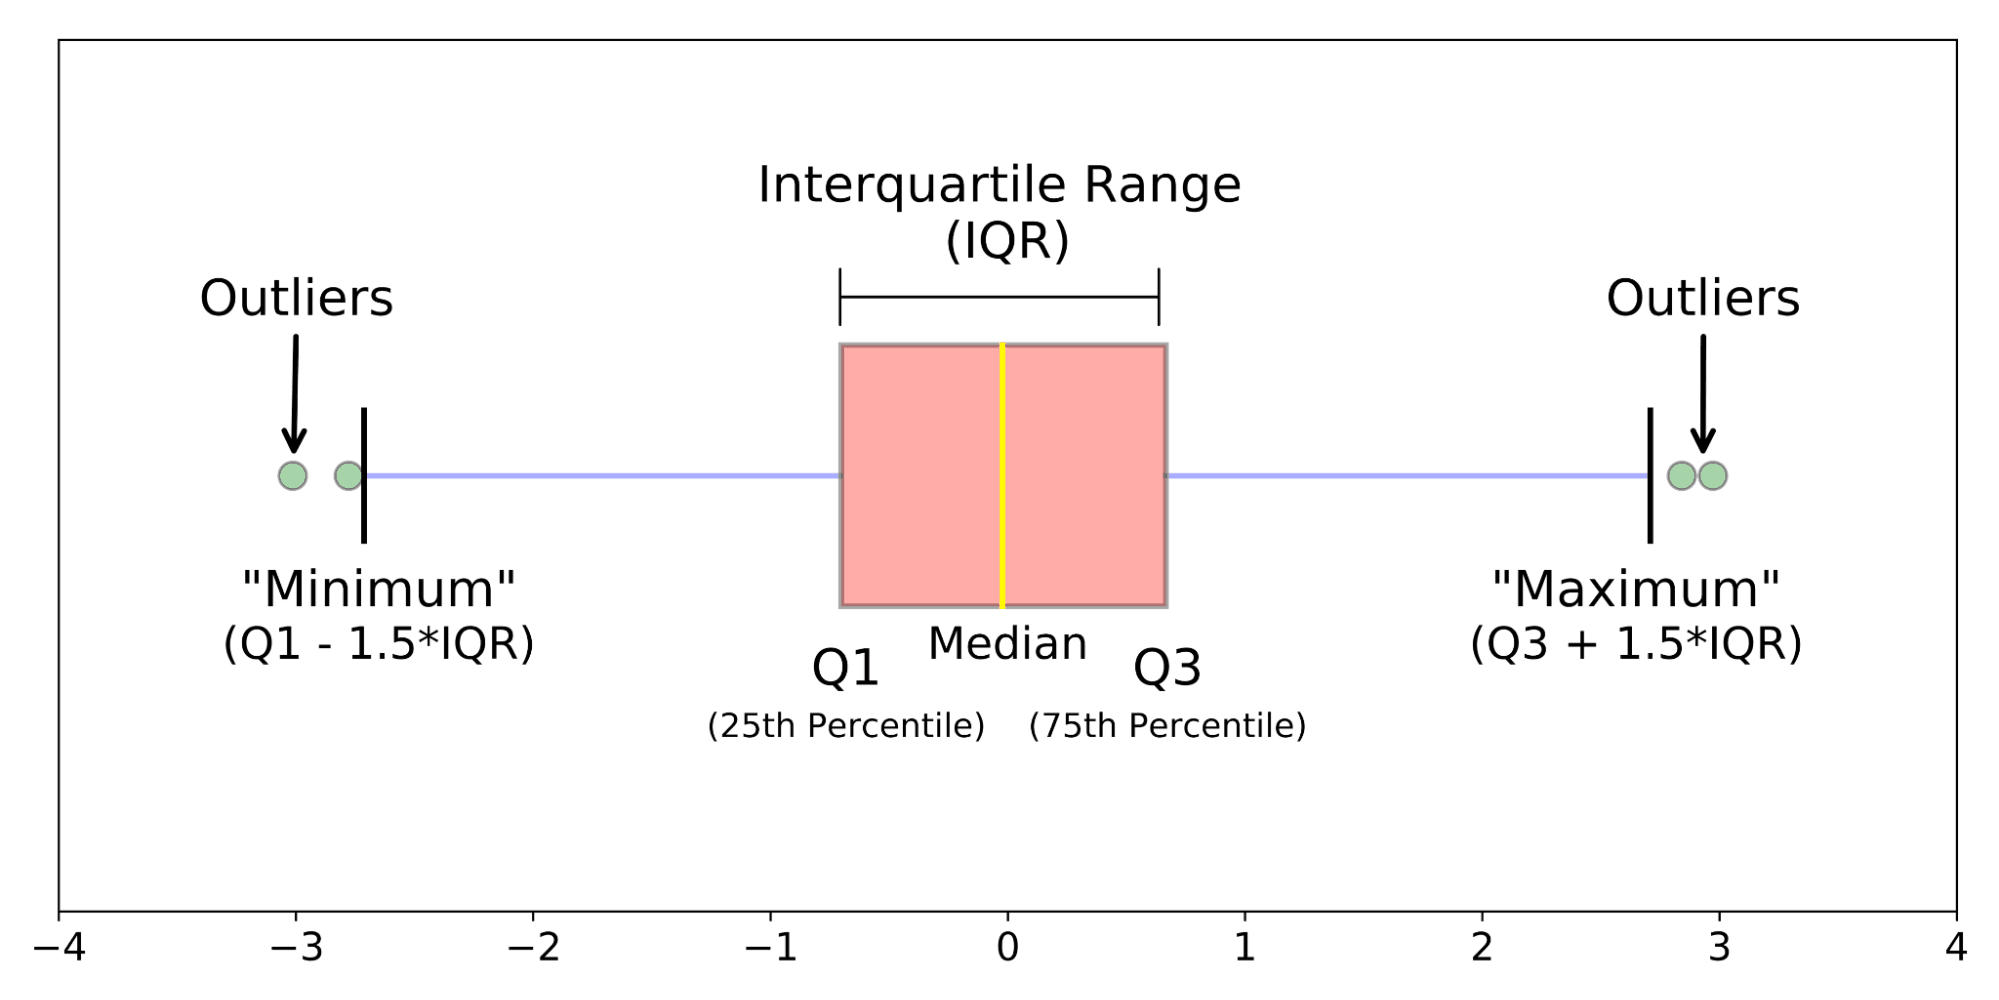
Cấu tạo của boxplot. Nguồn: Galarnyk
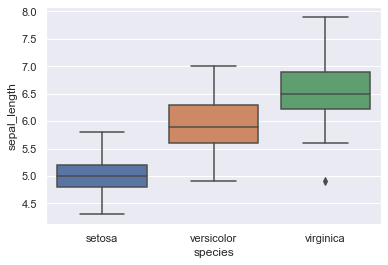
Ví dụ, boxplot dựa trên seaborn sau đây cho thấy phân phối chiều dài đài hoa (sepal length) ở ba loài hoa iris, dựa trên bộ dữ liệu iris nổi tiếng. Hướng dẫn Python Seaborn cho người mới bắt đầu của chúng tôi là tài nguyên hoàn hảo để khám phá cách tạo boxplot và các biểu đồ khác bằng gói trực quan hóa phổ biến Seaborn của Python.
Biểu đồ phân tán (Scatter plot)
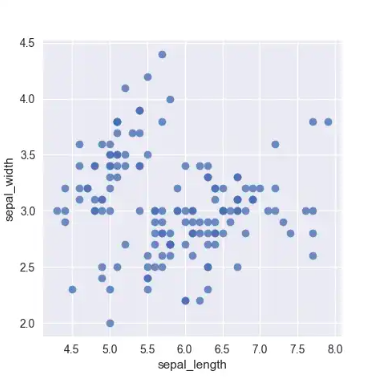
Biểu đồ phân tán dùng để trực quan hóa mối quan hệ giữa hai biến liên tục. Mỗi điểm trên đồ thị đại diện cho một điểm dữ liệu, và vị trí của điểm trên trục x và y biểu diễn giá trị của hai biến. Nó thường được dùng trong khám phá dữ liệu để hiểu dữ liệu và nhanh chóng gợi mở các tương quan tiềm năng.
Ví dụ sau tiếp tục sử dụng bộ dữ liệu iris để vẽ mối quan hệ giữa bề rộng đài hoa (sepal width) và chiều dài đài hoa (sepal length).
Để xem thêm ví dụ về biểu đồ phân tán, hãy đọc Series Data Demystified về các hình trực quan nắm bắt mối quan hệ. Bạn cũng có thể học cách tạo nhiều biểu đồ, bao gồm scatter plot, trong hướng dẫn vẽ với Matplotlib của chúng tôi.
Biểu đồ bong bóng (Bubble plot)
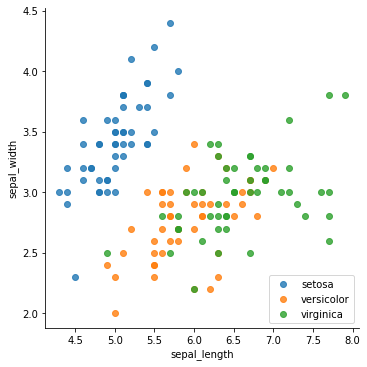
Biểu đồ phân tán có thể dễ dàng được tăng cường bằng cách thêm các yếu tố biểu diễn biến mới. Ví dụ, nếu muốn vẽ mối quan hệ giữa bề rộng và chiều dài đài hoa theo các loài iris khác nhau, ta có thể thêm màu cho các điểm như sau:
Ta cũng có thể thay đổi kích thước điểm theo một biến khác. Đó là đặc trưng của biểu đồ bong bóng. Ví dụ, biểu đồ ấn tượng này thể hiện mối quan hệ giữa tuổi thọ và GDP của các quốc gia, thêm màu để biểu diễn khu vực và kích thước để biểu diễn dân số quốc gia.
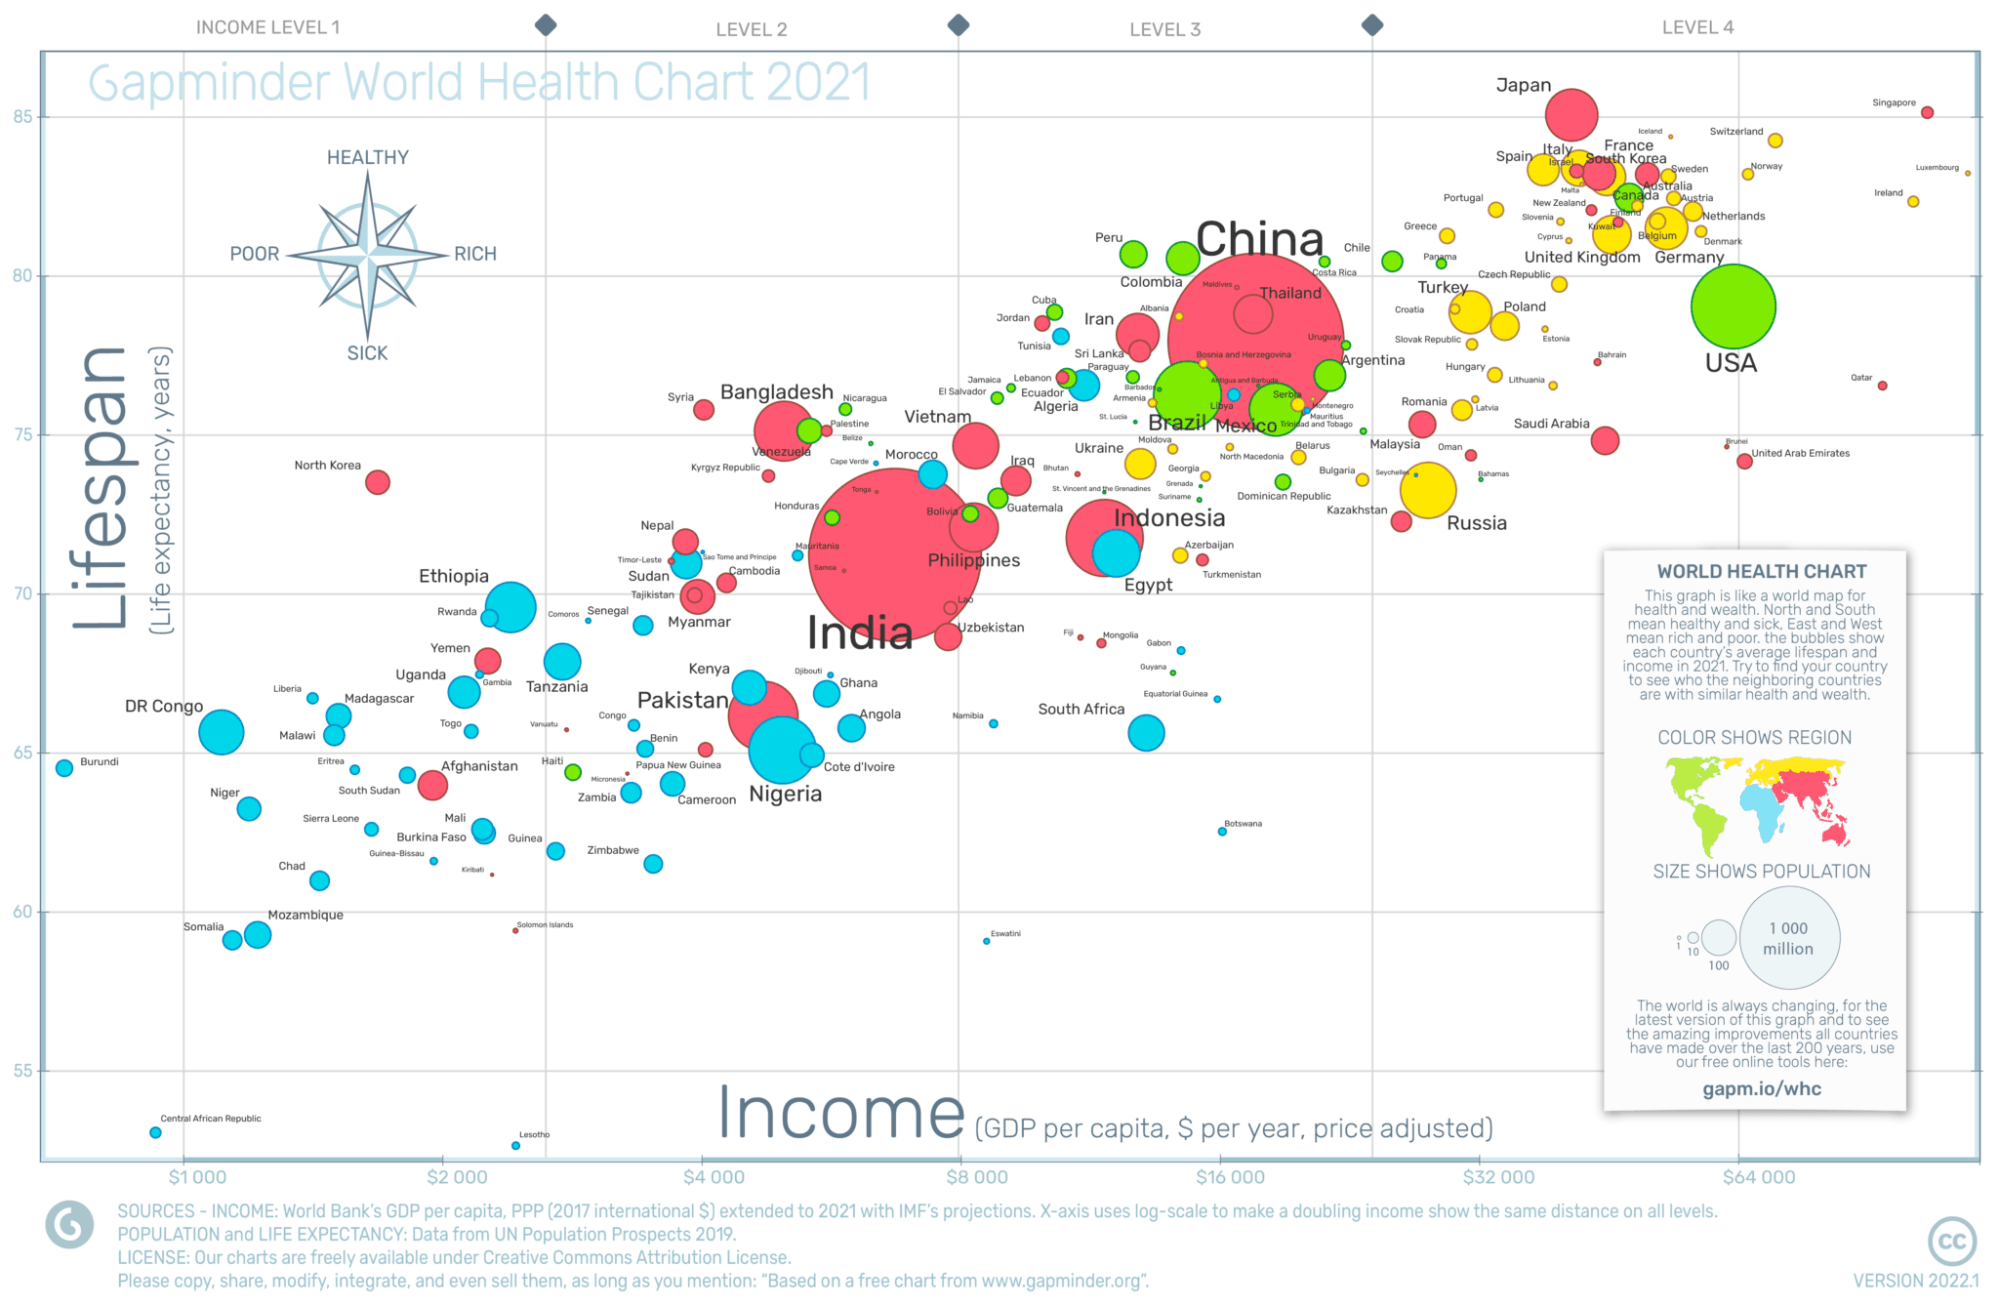
Nguồn. Gapminder
Chúng tôi đề cập đến biểu đồ bong bóng và cách tạo chúng trong khóa học Intermediate Interactive Data Visualization with plotly in R.
Treemap
Treemap phù hợp để thể hiện mối quan hệ bộ phận–tổng thể trong dữ liệu. Chúng hiển thị dữ liệu phân cấp dưới dạng một tập hợp hình chữ nhật. Mỗi hình chữ nhật là một danh mục trong một biến, và diện tích hình chữ nhật tỷ lệ với kích thước danh mục đó. So với các hình trực quan tương tự như biểu đồ tròn, treemap được xem là trực quan và dễ hiểu hơn.
Dưới đây là ví dụ.
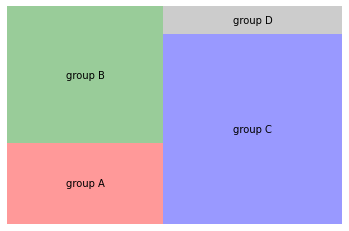
Trong khóa học Sentiment Analysis in R, bạn sẽ học cách dùng treemap để trực quan hóa cảm xúc trong các nhóm tài liệu.
Heatmap
Heatmap là một dạng biểu đồ ma trận phổ biến và đẹp mắt, có thể dùng để tóm tắt trực quan mối quan hệ giữa hai biến. Mức độ tương quan giữa hai biến được biểu diễn bằng mã màu.
Ví dụ, heatmap này trích từ khóa Intermediate Data Visualization with Seaborn của chúng tôi, phân tích nghề nghiệp của khách mời chương trình Daily Show trong giai đoạn 1999–2012. Như dự đoán, khách mời từ ngành diễn xuất và truyền thông xuất hiện thường xuyên nhất.
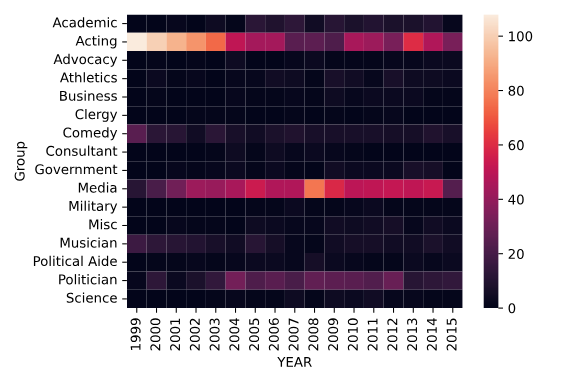
Để tìm hiểu thêm về cách tạo heatmap, bạn có thể xem hướng dẫn của chúng tôi khám phá cách thực hiện bằng Power BI.
Đám mây từ (Word cloud)
Đám mây từ hữu ích để trực quan hóa các từ phổ biến trong văn bản hoặc tập dữ liệu. Chúng tương tự biểu đồ cột nhưng thường hấp dẫn hơn về mặt thị giác. Tuy nhiên, đôi khi đám mây từ có thể khó diễn giải hơn. Đám mây từ hữu ích trong các tình huống sau:
- Nhanh chóng xác định các chủ đề hoặc đề tài quan trọng nhất trong một khối văn bản lớn.
- Hiểu cảm xúc hoặc sắc thái chung của một bài viết.
- Khám phá các mẫu hoặc xu hướng trong dữ liệu có chứa thông tin văn bản.
- Truyền đạt các ý tưởng hoặc khái niệm chính theo cách trực quan lôi cuốn.
Xem hướng dẫn Tạo WordCloud bằng Python để khám phá cách tạo đám mây từ của riêng bạn.
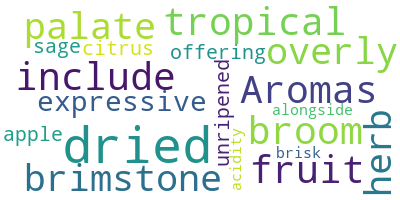
Nguồn. Datacamp
Bản đồ không gian địa lý
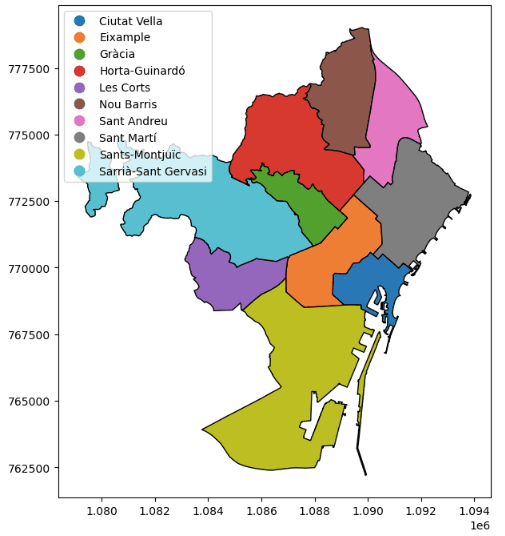
Một tỷ lệ đáng kể dữ liệu được tạo ra mỗi ngày vốn mang tính không gian. Dữ liệu không gian – đôi khi còn gọi là dữ liệu địa lý hoặc thông tin địa lý – là dữ liệu mà mỗi bản ghi gắn liền với một vị trí cụ thể.
Mỗi điểm dữ liệu không gian có thể được định vị trên bản đồ bằng một hệ quy chiếu tọa độ nhất định. Ví dụ, hình dưới đây, trích từ Hướng dẫn GeoPandas của chúng tôi, hiển thị các quận khác nhau của Barcelona.
Phân tích không gian địa lý là một lĩnh vực đang phát triển nhanh trong khoa học dữ liệu. Bản đồ là trung tâm của lĩnh vực này. Hãy xem khóa Working with Geospatial Data in Python để bắt đầu vẽ bản đồ ngay hôm nay!
Sơ đồ mạng
Phần lớn dữ liệu được lưu trong các bảng. Tuy nhiên, đó không phải là định dạng duy nhất. Đồ thị (graph) phù hợp hơn để phân tích dữ liệu được tổ chức theo mạng lưới, từ mạng xã hội trực tuyến như Facebook và Twitter đến mạng lưới giao thông như các tuyến metro. Phân tích mạng là phân ngành của khoa học dữ liệu sử dụng đồ thị để nghiên cứu các mạng.
Đồ thị mạng gồm hai thành phần chính: nút (node) và cạnh (edge), còn gọi là mối quan hệ. Đây là ví dụ về một đồ thị mạng đơn giản.
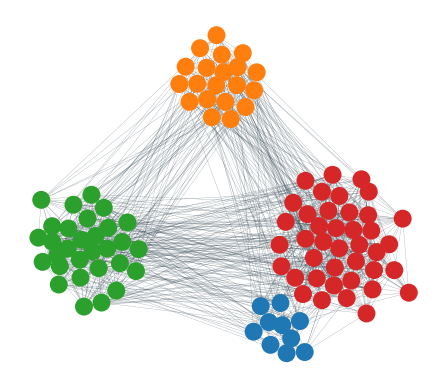
Ngầu đúng không? Khả năng ứng dụng của đồ thị mạng là vô tận. Để có phần giới thiệu nhẹ nhàng về lĩnh vực này, chúng tôi rất khuyến nghị khóa Introduction to Network Analysis in Python.