Datenvisualisierung entwickelt sich rasant zu einer Schlüsselkompetenz in der Datenanalyse und Data Science. Gute Visualisierungskompetenzen werden in vielen Branchen gebraucht – von Finanzen über Bildung bis Gesundheitswesen. Das überrascht kaum: Je mehr komplexe und vielfältige Daten Analysten verarbeiten, desto wichtiger sind Visualisierungstechniken, um sie zu verstehen und Erkenntnisse überzeugend zu vermitteln.
Früher eher ein Randthema, wird Datenvisualisierung heute durch spannende Techniken, Tools und Theorien bereichert – auch aus Disziplinen wie Psychologie und Neurowissenschaften. Wenn du zur Visualisierungs-Koryphäe werden willst, bist du bei DataCamp richtig. Stöbere in unserem Kurskatalog zur Datenvisualisierung mit über 30 Kursen von führenden Expertinnen und Experten zu beliebten Technologien.
Dieser Artikel gibt einen Überblick zum Status quo der Datenvisualisierung. Wir konzentrieren uns auf die beliebtesten Analysen, Techniken und Tools. Lies weiter!
Die Kraft guter Datenvisualisierung
Datenvisualisierung nutzt grafische Darstellungen wie Diagramme, Charts und Karten. Visuals fassen tausende Zeilen und Spalten komplexer Daten verständlich und zugänglich zusammen. Gegenüber beschreibender Statistik oder Tabellen bieten Visualisierungen oft den wirkungsvolleren Weg, Daten zu analysieren – etwa um Muster, Verteilungen, Korrelationen und Ausreißer in komplexen Datensätzen zu erkennen.
Indem sie Daten mit aussagekräftigen Plots und Charts lebendig macht, ist Visualisierung entscheidend für gute Entscheidungen. Ob Data Analysts ihre Ergebnisse für nicht-technische Stakeholder aufbereiten, Data Scientists A/B-Tests fürs Marketing durchführen oder Machine-Learning-Engineers potenzielle Verzerrungen in komplexen Large Language Models wie ChatGPT erklären – Datenvisualisierung schlägt die Brücke von der Insight zur Entscheidung.
Trotz Visualisierungen landen fundierte Analysen oft in der Schublade – schlicht, weil sie ihr Publikum nicht fesseln konnten, seien es Entscheidungstragende, Stakeholder oder Teammitglieder.
Dank Fortschritten etwa in der Neurowissenschaft wissen wir heute: Wie eine Visualisierung gestaltet ist, prägt ihre Wahrnehmung stark. Deine Designentscheidungen – Farben, Layout, Größen – machen einen großen Unterschied. Interessiert dich die Theorie dahinter? Unser Kurs Understanding Data Visualization ist ein idealer Einstieg.
Visualisierung ist beim Kommunizieren von Daten zentral, doch erfolgreiche Kommunikation ist mehr als das. Genau hier setzt Data Storytelling an: ein Ansatz, der Visuals, Narrativ und Daten verbindet, um Erkenntnisse in Handeln zu überführen. Mehr dazu im DataFramed-Podcast mit Brent Dykes, Senior Director of Insights & Data Storytelling bei Blast Analytics und Autor von Effective Data Storytelling.
Arten der Visualisierungsanalyse
Mit Datenvisualisierung analysierst du visuell das Verhalten von Variablen in einem Datensatz – etwa Beziehungen zwischen Datenpunkten oder deren Verteilung. Je nach Anzahl der gleichzeitig betrachteten Variablen unterscheidet man drei Analysearten.
- Univariate Analyse: Fasst das Verhalten genau einer Variablen zusammen.
- Bivariate Analyse: Untersucht die Beziehung zwischen zwei Variablen.
- Multivariate Analyse: Ermöglicht die gleichzeitige Analyse von mehr als zwei Variablen.
Zentrale Techniken der Datenvisualisierung
Schauen wir uns nun die beliebtesten Visualisierungstechniken an!
Liniendiagramme
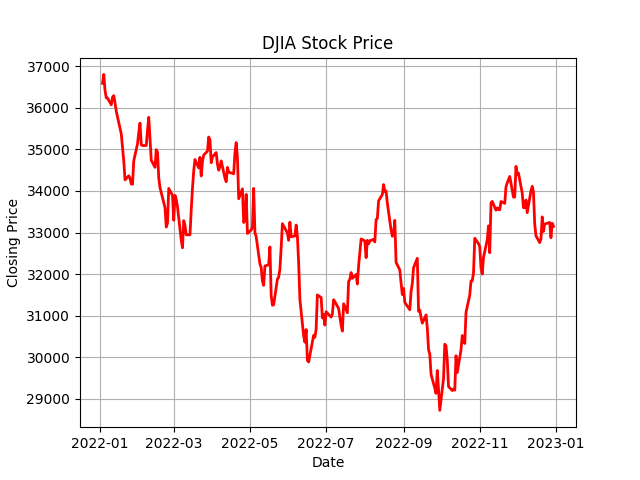
Liniendiagramme gehören zu den am häufigsten genutzten Visualisierungen und eignen sich hervorragend, um die Entwicklung einer Variablen über die Zeit zu verfolgen. Auf der x-Achse steht üblicherweise die Zeit, auf der y-Achse die zu analysierende Variable. Das folgende Liniendiagramm zeigt zum Beispiel die Entwicklung des DJIA-Aktienkurses im Jahr 2022.
Quelle: DataCamp
Wie du überzeugende Liniendiagramme erstellst, erfährst du in unserem Line Plots in MatplotLib with Python Tutorial.
Balkendiagramme
Balkendiagramme ordnen Kategorien nach ihrem Wert. Sie bestehen aus Rechtecken, deren Länge proportional zum Kategorienwert ist. Sie sind weit verbreitet, weil sie leicht zu lesen sind. Unternehmen nutzen sie häufig für Vergleiche, etwa Marktanteile von Marken oder Umsätze nach Regionen. Es gibt verschiedene Typen – jeweils für andere Zwecke geeignet.
Dazu zählen unter anderem vertikale und horizontale Balkendiagramme sowie gruppierte Balkendiagramme.
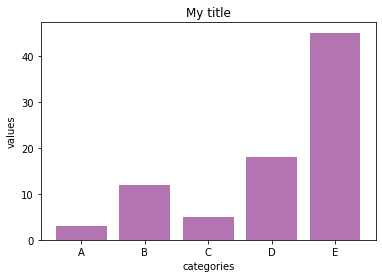
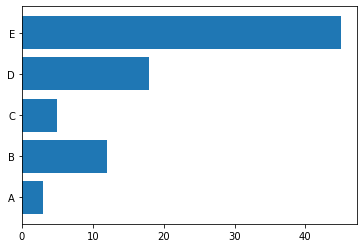
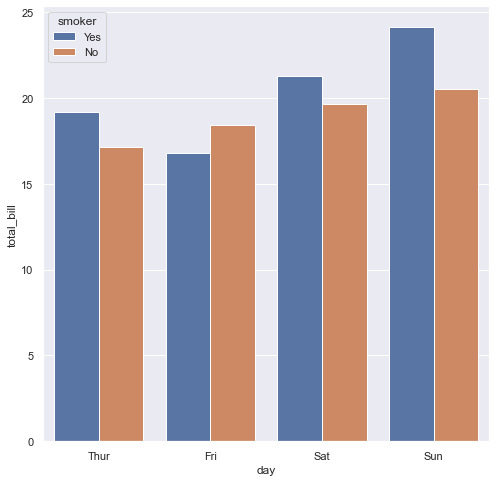
Vertikale, horizontale und gruppierte Balkendiagramme.
Unser Kurs Introduction to Data Science in Python behandelt eine Reihe von Visualisierungstechniken, darunter Balkendiagramme.
Histogramme
Histogramme sind eine der beliebtesten Visualisierungen zur Analyse von Verteilungen. Sie zeigen die Verteilung einer numerischen Variable mittels Balken.
Dafür werden die numerischen Daten in Intervalle (Bins) aufgeteilt und die Häufigkeit pro Intervall gezählt. Die horizontale Achse zeigt die Intervalle, die vertikale Achse die Häufigkeit oder den prozentualen Anteil.
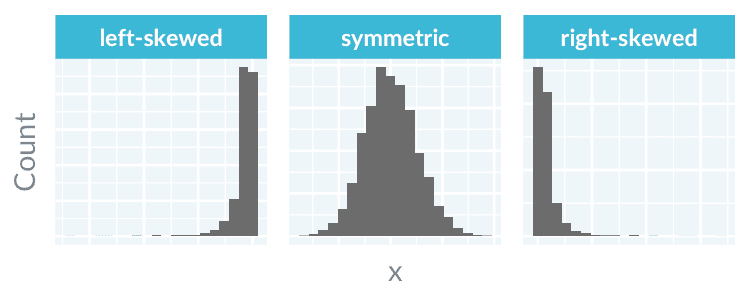
Histogramme machen sofort sichtbar, ob und wie eine Verteilung schief ist oder wo sie ihren Höhepunkt hat. Hier siehst du Beispiele aus unserer Data Demystified Serie zu Visualisierungen von Verteilungen.
Boxplots
Boxplots sind ein weiteres starkes Mittel, um die Verteilung einer Variable zusammenzufassen. Sie machen folgende Elemente intuitiv sichtbar:
- Median. Der mittlere Wert eines Datensatzes: 50 % der Daten liegen darunter, 50 % darüber.
- Oberes Quartil. Das 75. Perzentil: 75 % der Daten liegen darunter, 25 % darüber.
- Unteres Quartil. Das 25. Perzentil: 25 % der Daten liegen darunter, 75 % darüber.
- Interquartilsabstand (IQA). Oberes minus unteres Quartil.
- Oberer Ausreißergrenzwert. Umgangssprachlich „Maximum“: Oberes Quartil plus 1,5 mal IQA.
- Unterer Ausreißergrenzwert. Umgangssprachlich „Minimum“: Unteres Quartil minus 1,5 mal IQA.
- Ausreißer. Werte oberhalb des „Maximums“ oder unterhalb des „Minimums“.
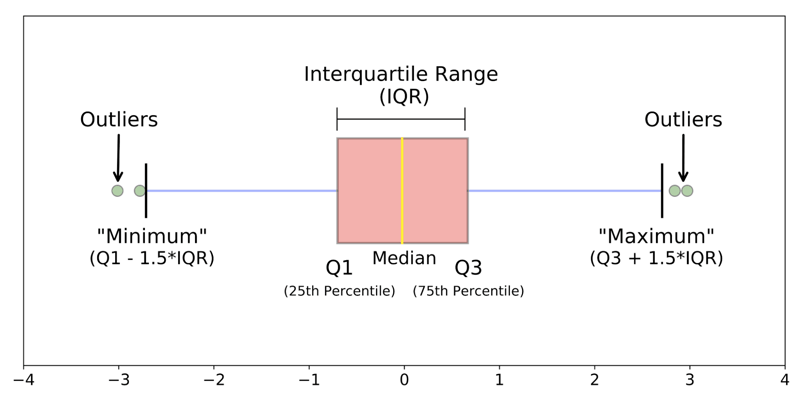
Anatomie eines Boxplots. Quelle: Galarnyk
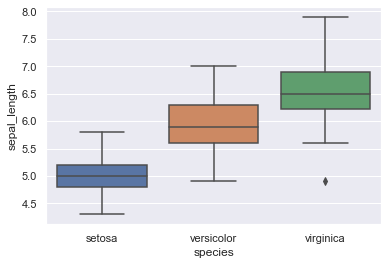
Das folgende, mit seaborn erstellte Boxplot zeigt zum Beispiel die Verteilung der Kelchblattlänge in drei Iris-Varianten auf Basis des bekannten Iris-Datensatzes. Unser Python Seaborn Tutorial für Einsteiger zeigt dir, wie du Boxplots und andere Grafiken mit Seaborn erstellst.
Streudiagramme
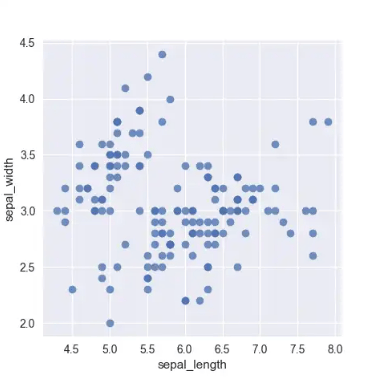
Streudiagramme visualisieren die Beziehung zwischen zwei kontinuierlichen Variablen. Jeder Punkt steht für einen Datenpunkt, seine x- und y-Position für die jeweiligen Werte. Sie sind in der Exploration hilfreich, um das Datenbild zu verstehen und mögliche Korrelationen schnell zu erkennen.
Im folgenden Beispiel wird erneut der Iris-Datensatz genutzt, um die Beziehung zwischen Kelchblattbreite und -länge zu zeigen.
Mehr Beispiele für Streudiagramme findest du in unserer Data Demystified Serie zu Beziehungen. In unserem Matplotlib-Tutorial lernst du außerdem, verschiedene Diagrammtypen – inklusive Streudiagramme – zu erstellen.
Bubble-Charts
Streudiagramme lassen sich leicht erweitern, um zusätzliche Variablen abzubilden. Möchtest du zum Beispiel die Beziehung zwischen Kelchblattbreite und -länge für verschiedene Iris-Arten zeigen, kannst du die Punkte einfärben – so wie hier:
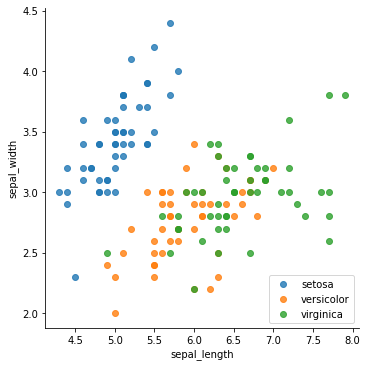
Zusätzlich kann die Punktgröße eine weitere Variable darstellen – das Kennzeichen von Bubble-Charts. Dieses eindrucksvolle Diagramm zeigt zum Beispiel die Beziehung zwischen Lebenserwartung und BIP eines Landes; Farbe steht für die Region, Größe für die Bevölkerung.
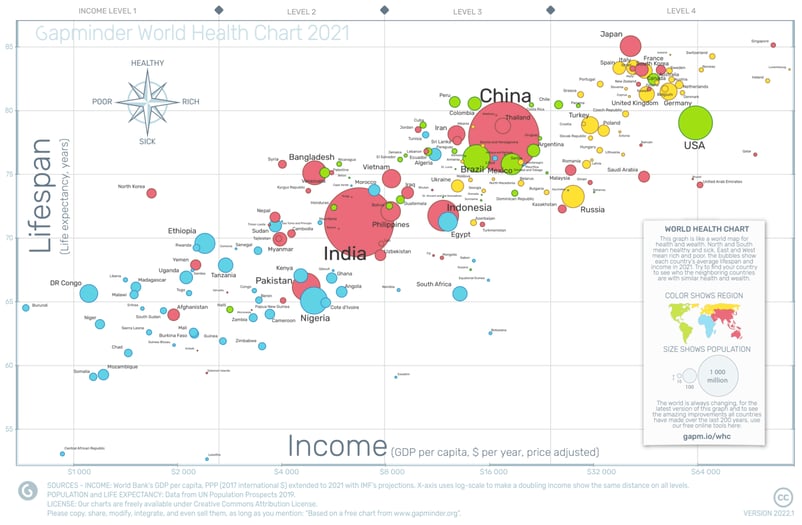
Quelle: Gapminder
Bubble-Charts und ihre Erstellung behandeln wir im Kurs Intermediate Interactive Data Visualization with plotly in R.
Treemaps
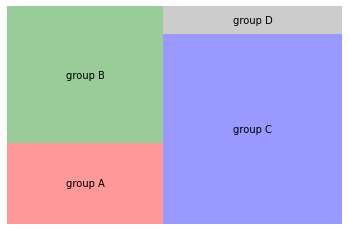
Treemaps eignen sich, um Teile-vom-Ganzen-Beziehungen zu zeigen. Sie stellen hierarchische Daten als Rechtecke dar. Jedes Rechteck steht für eine Kategorie innerhalb einer Variablen; seine Fläche ist proportional zur Größe der Kategorie. Im Vergleich zu ähnlichen Visualisierungen wie Kreisdiagrammen gelten Treemaps oft als intuitiver und vorzuziehen.
Unten findest du ein Beispiel.
Im Kurs Sentiment Analysis in R lernst du, Treemaps zur Visualisierung von Stimmungen in Dokumentengruppen zu nutzen.
Heatmaps
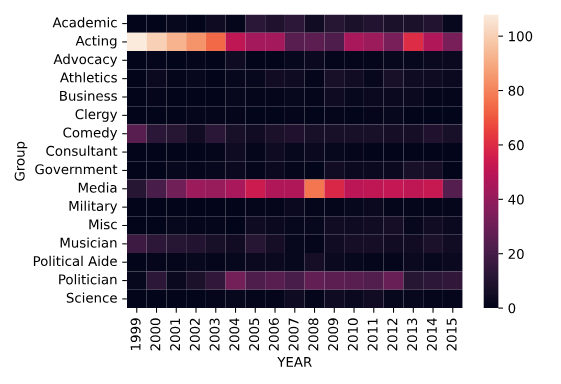
Eine Heatmap ist ein gängiges, visuell ansprechendes Matrix-Plot, das die Beziehung zwischen zwei Variablen zusammenfasst. Der Grad der Korrelation wird per Farbskala dargestellt.
Dieses Beispiel aus unserem Kurs Intermediate Data Visualization with Seaborn analysiert etwa die Berufe der Gäste der Daily Show zwischen 1999 und 2012. Wie erwartet, sind Gäste aus Schauspielerei und Medien am häufigsten vertreten.
Mehr über die Erstellung von Heatmaps erfährst du in unserem Tutorial mit Power BI.
Wordclouds
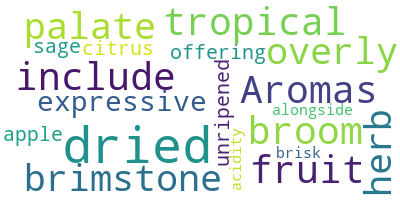
Wordclouds sind hilfreich, um häufige Wörter in Texten oder Datensätzen zu visualisieren. Sie sind den Balkendiagrammen ähnlich, wirken aber oft visuell ansprechender. Manchmal sind sie jedoch schwerer zu interpretieren. Nützlich sind Wordclouds insbesondere in folgenden Fällen:
- Wichtige Themen oder Motive in großen Textmengen schnell erkennen.
- Die Grundstimmung oder Tonalität eines Textes einschätzen.
- Muster oder Trends in Daten mit Textanteilen erkunden.
- Schlüsselideen visuell ansprechend kommunizieren.
Im Tutorial zu Wordclouds in Python erfährst du, wie du deine eigene Wordcloud erstellst.
Quelle: Datacamp
Geodaten-Karten
Ein beträchtlicher Teil der täglich entstehenden Daten ist räumlich. Räumliche Daten – auch Geodaten oder geografische Informationen – verknüpfen jeden Datensatz mit einem konkreten Ort.
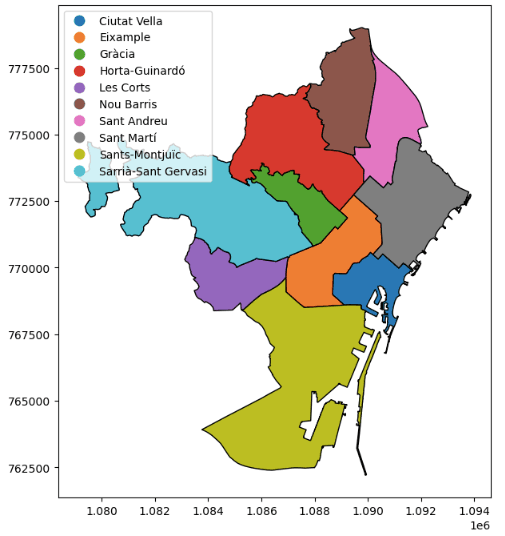
Jeder räumliche Datenpunkt lässt sich mithilfe eines Koordinatenreferenzsystems auf einer Karte verorten. Das folgende Bild aus unserem GeoPandas-Tutorial zeigt beispielsweise die Stadtbezirke von Barcelona.
Geodatenanalyse ist ein dynamisch wachsendes Feld der Data Science. Karten stehen dabei im Zentrum. Starte mit unserem Kurs Working with Geospatial Data in Python und zeichne deine ersten Karten!
Netzwerkdiagramme
Viele Daten liegen tabellarisch vor – aber längst nicht alle. Für Netzwerke, etwa soziale Netzwerke wie Facebook oder Twitter bis hin zu Verkehrsnetzen wie U-Bahn-Linien, eignen sich Graphen deutlich besser. Network Analytics ist das Teilgebiet der Data Science, das Netzwerke mit Graphen untersucht.
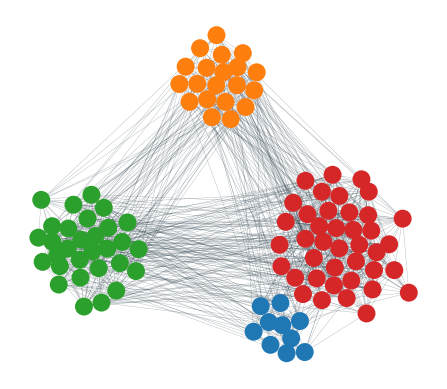
Netzwerkgraphen bestehen im Kern aus Knoten und Kanten (Beziehungen). Hier ein einfaches Beispiel:
Ziemlich cool, oder? Die Möglichkeiten sind nahezu endlos. Eine sanfte Einführung bekommst du in unserem Kurs Introduction to Network Analysis in Python.









Datenvisualisierung entwickelt sich rasant zu einer Schlüsselkompetenz in der Datenanalyse und Data Science. Gute Visualisierungskompetenzen werden in vielen Branchen gebraucht – von Finanzen über Bildung bis Gesundheitswesen. Das überrascht kaum: Je mehr komplexe und vielfältige Daten Analysten verarbeiten, desto wichtiger sind Visualisierungstechniken, um sie zu verstehen und Erkenntnisse überzeugend zu vermitteln.
Früher eher ein Randthema, wird Datenvisualisierung heute durch spannende Techniken, Tools und Theorien bereichert – auch aus Disziplinen wie Psychologie und Neurowissenschaften. Wenn du zur Visualisierungs-Koryphäe werden willst, bist du bei DataCamp richtig. Stöbere in unserem Kurskatalog zur Datenvisualisierung mit über 30 Kursen von führenden Expertinnen und Experten zu beliebten Technologien.
Dieser Artikel gibt einen Überblick zum Status quo der Datenvisualisierung. Wir konzentrieren uns auf die beliebtesten Analysen, Techniken und Tools. Lies weiter!
Die Kraft guter Datenvisualisierung
Datenvisualisierung nutzt grafische Darstellungen wie Diagramme, Charts und Karten. Visuals fassen tausende Zeilen und Spalten komplexer Daten verständlich und zugänglich zusammen. Gegenüber beschreibender Statistik oder Tabellen bieten Visualisierungen oft den wirkungsvolleren Weg, Daten zu analysieren – etwa um Muster, Verteilungen, Korrelationen und Ausreißer in komplexen Datensätzen zu erkennen.
Indem sie Daten mit aussagekräftigen Plots und Charts lebendig macht, ist Visualisierung entscheidend für gute Entscheidungen. Ob Data Analysts ihre Ergebnisse für nicht-technische Stakeholder aufbereiten, Data Scientists A/B-Tests fürs Marketing durchführen oder Machine-Learning-Engineers potenzielle Verzerrungen in komplexen Large Language Models wie ChatGPT erklären – Datenvisualisierung schlägt die Brücke von der Insight zur Entscheidung.
Trotz Visualisierungen landen fundierte Analysen oft in der Schublade – schlicht, weil sie ihr Publikum nicht fesseln konnten, seien es Entscheidungstragende, Stakeholder oder Teammitglieder.
Dank Fortschritten etwa in der Neurowissenschaft wissen wir heute: Wie eine Visualisierung gestaltet ist, prägt ihre Wahrnehmung stark. Deine Designentscheidungen – Farben, Layout, Größen – machen einen großen Unterschied. Interessiert dich die Theorie dahinter? Unser Kurs Understanding Data Visualization ist ein idealer Einstieg.
Visualisierung ist beim Kommunizieren von Daten zentral, doch erfolgreiche Kommunikation ist mehr als das. Genau hier setzt Data Storytelling an: ein Ansatz, der Visuals, Narrativ und Daten verbindet, um Erkenntnisse in Handeln zu überführen. Mehr dazu im DataFramed-Podcast mit Brent Dykes, Senior Director of Insights & Data Storytelling bei Blast Analytics und Autor von Effective Data Storytelling.
Arten der Visualisierungsanalyse
Mit Datenvisualisierung analysierst du visuell das Verhalten von Variablen in einem Datensatz – etwa Beziehungen zwischen Datenpunkten oder deren Verteilung. Je nach Anzahl der gleichzeitig betrachteten Variablen unterscheidet man drei Analysearten.
Zentrale Techniken der Datenvisualisierung
Schauen wir uns nun die beliebtesten Visualisierungstechniken an!
Liniendiagramme
Liniendiagramme gehören zu den am häufigsten genutzten Visualisierungen und eignen sich hervorragend, um die Entwicklung einer Variablen über die Zeit zu verfolgen. Auf der x-Achse steht üblicherweise die Zeit, auf der y-Achse die zu analysierende Variable. Das folgende Liniendiagramm zeigt zum Beispiel die Entwicklung des DJIA-Aktienkurses im Jahr 2022.
Quelle: DataCamp
Wie du überzeugende Liniendiagramme erstellst, erfährst du in unserem Line Plots in MatplotLib with Python Tutorial.
Balkendiagramme
Balkendiagramme ordnen Kategorien nach ihrem Wert. Sie bestehen aus Rechtecken, deren Länge proportional zum Kategorienwert ist. Sie sind weit verbreitet, weil sie leicht zu lesen sind. Unternehmen nutzen sie häufig für Vergleiche, etwa Marktanteile von Marken oder Umsätze nach Regionen. Es gibt verschiedene Typen – jeweils für andere Zwecke geeignet.
Dazu zählen unter anderem vertikale und horizontale Balkendiagramme sowie gruppierte Balkendiagramme.
Vertikale, horizontale und gruppierte Balkendiagramme.
Unser Kurs Introduction to Data Science in Python behandelt eine Reihe von Visualisierungstechniken, darunter Balkendiagramme.
Histogramme
Histogramme sind eine der beliebtesten Visualisierungen zur Analyse von Verteilungen. Sie zeigen die Verteilung einer numerischen Variable mittels Balken.
Dafür werden die numerischen Daten in Intervalle (Bins) aufgeteilt und die Häufigkeit pro Intervall gezählt. Die horizontale Achse zeigt die Intervalle, die vertikale Achse die Häufigkeit oder den prozentualen Anteil.
Histogramme machen sofort sichtbar, ob und wie eine Verteilung schief ist oder wo sie ihren Höhepunkt hat. Hier siehst du Beispiele aus unserer Data Demystified Serie zu Visualisierungen von Verteilungen.
Boxplots
Boxplots sind ein weiteres starkes Mittel, um die Verteilung einer Variable zusammenzufassen. Sie machen folgende Elemente intuitiv sichtbar:
Anatomie eines Boxplots. Quelle: Galarnyk
Das folgende, mit seaborn erstellte Boxplot zeigt zum Beispiel die Verteilung der Kelchblattlänge in drei Iris-Varianten auf Basis des bekannten Iris-Datensatzes. Unser Python Seaborn Tutorial für Einsteiger zeigt dir, wie du Boxplots und andere Grafiken mit Seaborn erstellst.
Streudiagramme
Streudiagramme visualisieren die Beziehung zwischen zwei kontinuierlichen Variablen. Jeder Punkt steht für einen Datenpunkt, seine x- und y-Position für die jeweiligen Werte. Sie sind in der Exploration hilfreich, um das Datenbild zu verstehen und mögliche Korrelationen schnell zu erkennen.
Im folgenden Beispiel wird erneut der Iris-Datensatz genutzt, um die Beziehung zwischen Kelchblattbreite und -länge zu zeigen.
Mehr Beispiele für Streudiagramme findest du in unserer Data Demystified Serie zu Beziehungen. In unserem Matplotlib-Tutorial lernst du außerdem, verschiedene Diagrammtypen – inklusive Streudiagramme – zu erstellen.
Bubble-Charts
Streudiagramme lassen sich leicht erweitern, um zusätzliche Variablen abzubilden. Möchtest du zum Beispiel die Beziehung zwischen Kelchblattbreite und -länge für verschiedene Iris-Arten zeigen, kannst du die Punkte einfärben – so wie hier:
Zusätzlich kann die Punktgröße eine weitere Variable darstellen – das Kennzeichen von Bubble-Charts. Dieses eindrucksvolle Diagramm zeigt zum Beispiel die Beziehung zwischen Lebenserwartung und BIP eines Landes; Farbe steht für die Region, Größe für die Bevölkerung.
Quelle: Gapminder
Bubble-Charts und ihre Erstellung behandeln wir im Kurs Intermediate Interactive Data Visualization with plotly in R.
Treemaps
Treemaps eignen sich, um Teile-vom-Ganzen-Beziehungen zu zeigen. Sie stellen hierarchische Daten als Rechtecke dar. Jedes Rechteck steht für eine Kategorie innerhalb einer Variablen; seine Fläche ist proportional zur Größe der Kategorie. Im Vergleich zu ähnlichen Visualisierungen wie Kreisdiagrammen gelten Treemaps oft als intuitiver und vorzuziehen.
Unten findest du ein Beispiel.
Im Kurs Sentiment Analysis in R lernst du, Treemaps zur Visualisierung von Stimmungen in Dokumentengruppen zu nutzen.
Heatmaps
Eine Heatmap ist ein gängiges, visuell ansprechendes Matrix-Plot, das die Beziehung zwischen zwei Variablen zusammenfasst. Der Grad der Korrelation wird per Farbskala dargestellt.
Dieses Beispiel aus unserem Kurs Intermediate Data Visualization with Seaborn analysiert etwa die Berufe der Gäste der Daily Show zwischen 1999 und 2012. Wie erwartet, sind Gäste aus Schauspielerei und Medien am häufigsten vertreten.
Mehr über die Erstellung von Heatmaps erfährst du in unserem Tutorial mit Power BI.
Wordclouds
Wordclouds sind hilfreich, um häufige Wörter in Texten oder Datensätzen zu visualisieren. Sie sind den Balkendiagrammen ähnlich, wirken aber oft visuell ansprechender. Manchmal sind sie jedoch schwerer zu interpretieren. Nützlich sind Wordclouds insbesondere in folgenden Fällen:
Im Tutorial zu Wordclouds in Python erfährst du, wie du deine eigene Wordcloud erstellst.
Quelle: Datacamp
Geodaten-Karten
Ein beträchtlicher Teil der täglich entstehenden Daten ist räumlich. Räumliche Daten – auch Geodaten oder geografische Informationen – verknüpfen jeden Datensatz mit einem konkreten Ort.
Jeder räumliche Datenpunkt lässt sich mithilfe eines Koordinatenreferenzsystems auf einer Karte verorten. Das folgende Bild aus unserem GeoPandas-Tutorial zeigt beispielsweise die Stadtbezirke von Barcelona.
Geodatenanalyse ist ein dynamisch wachsendes Feld der Data Science. Karten stehen dabei im Zentrum. Starte mit unserem Kurs Working with Geospatial Data in Python und zeichne deine ersten Karten!
Netzwerkdiagramme
Viele Daten liegen tabellarisch vor – aber längst nicht alle. Für Netzwerke, etwa soziale Netzwerke wie Facebook oder Twitter bis hin zu Verkehrsnetzen wie U-Bahn-Linien, eignen sich Graphen deutlich besser. Network Analytics ist das Teilgebiet der Data Science, das Netzwerke mit Graphen untersucht.
Netzwerkgraphen bestehen im Kern aus Knoten und Kanten (Beziehungen). Hier ein einfaches Beispiel:
Ziemlich cool, oder? Die Möglichkeiten sind nahezu endlos. Eine sanfte Einführung bekommst du in unserem Kurs Introduction to Network Analysis in Python.