跳至内容

AnythingLLM:搭建、功能与应用场景完整指南

学习如何使用 Docker 和 Ollama 安装 AnythingLLM,搭建用于私有文档对话的 RAG 流水线,并在 AnythingLLM、ChatGPT 与 Open WebUI 之间做出选择。
已更新 2026年10月6日  · 11分钟 阅读

使用 AI 探索

ChatGPTClaudePerplexity

在自建 AI 领域,一个常见问题是:如何在不将文档发送到云端 API 的情况下,与私有文档进行对话? 

AnythingLLM 是一个常见答案。它在一个界面中处理一切(文档上传、向量化、搜索与对话),并可连接到广泛的 LLM 提供商。它让您在不依赖云服务的情况下构建私有 AI 工作流。

在本指南中,我将解释 AnythingLLM 是什么,带您了解其架构,演示如何配合 Docker 和 Ollama 进行安装,并展示一个可运行的 检索增强生成(RAG) 流水线。我还会把它与 Open WebUI 和 ChatGPT 做比较。

AnythingLLM 是什么?

AnythingLLM 是 Mintplex Labs 在 MIT 许可下构建的开源应用。它拥有活跃的 GitHub 社区和频繁的发布版本,并在自建 AI 圈被广泛使用。

它的作用是:把您的文档转化为大语言模型(LLM) 在对话中可用的上下文。您上传文件,系统处理并存储,然后 LLM 可基于您的数据回答问题。该项目发展迅速,拥有活跃的 Discord 社区,并通过每月更新加入新的 LLM 提供商与功能。

先说明两点。第一,AnythingLLM 本身不是模型。它是连接外部 LLM 提供商的桥梁,无论是本地(如 Ollama)还是云端(如 OpenAI 或 Anthropic)。 

第二,平台将一切组织为工作区。可以把它们理解为不同项目的独立房间。每个工作区都有自己的文档与对话,彼此隔离,除非您明确配置共享。
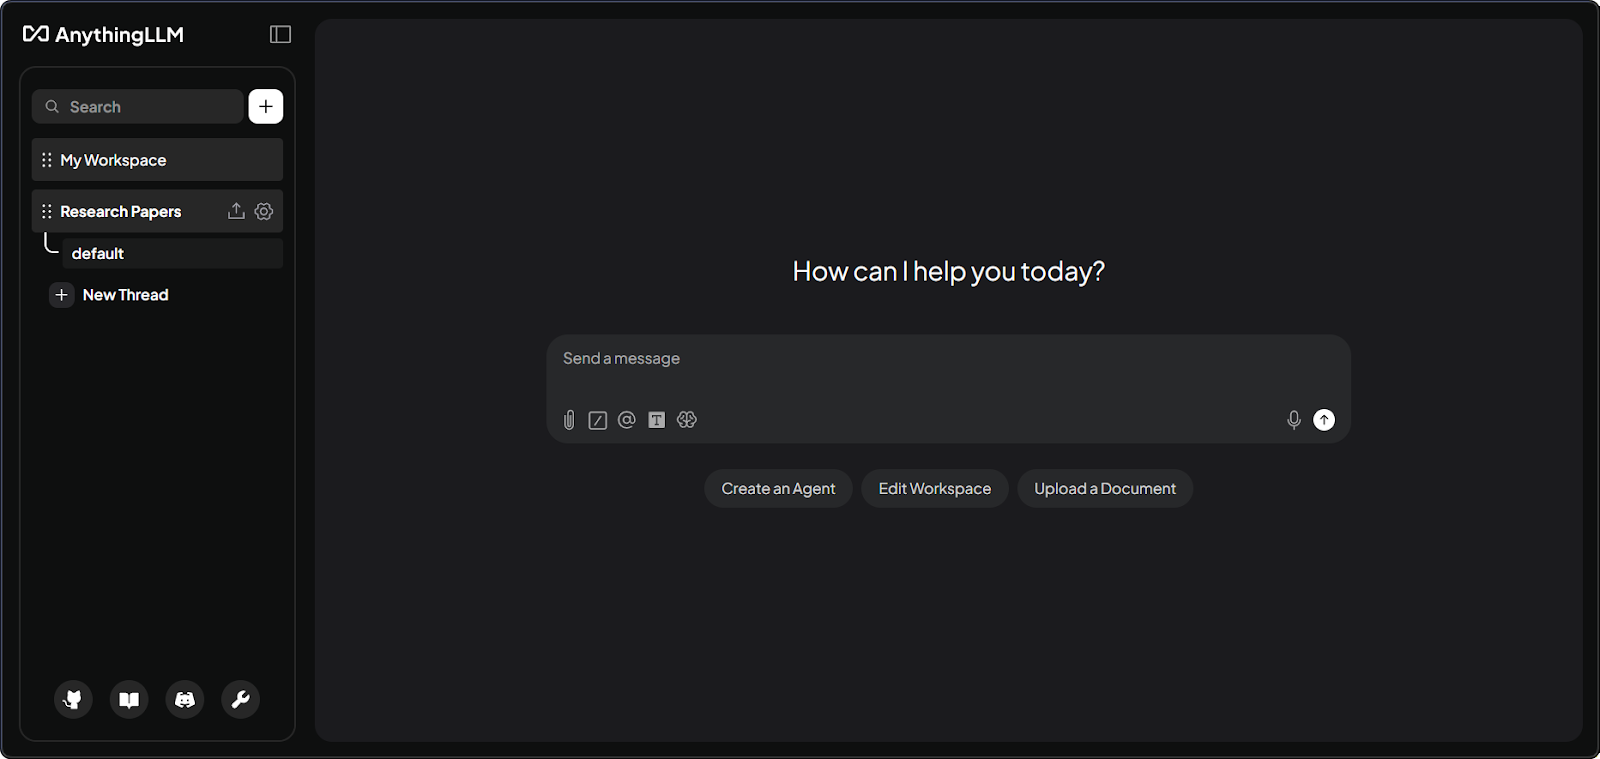
AnythingLLM 工作区界面,显示聊天面板和文档侧栏。

带文档的 AnythingLLM 工作区界面。图片由作者提供。

桌面版 vs. Docker 版

该桌面应用(macOS、Windows、Linux)面向在本地运行的一名用户。它内置 LLM 引擎、基于 CPU 的嵌入器以及捆绑的 LanceDB。一键安装,无需配置。

而Docker 版本面向团队与服务器。它提供完善的访问控制(管理员、管理者与默认角色),并支持网站可嵌入的聊天小部件与白标。如果您需要团队访问或面向公众的聊天小部件,Docker 是唯一选择。

功能

桌面版

Docker 版

多用户支持

否

是(管理员、管理者、默认角色)

内置 LLM 引擎

是

否(连接外部提供商)

可嵌入聊天小部件

否

是

白标

否

是

部署复杂度

一键安装

需要 Docker 知识

AnythingLLM 的核心功能

现在您已了解 AnythingLLM,以及如何在桌面版和 Docker 版之间选择,下面来看看它在文档类 AI 工作流中的实用功能。

文档摄取

支持 PDF、DOCX、TXT、Markdown、CSV、XLSX、PPTX、HTML、50+ 种代码文件类型,以及音频文件(使用 Whisper 转写)。您也可以通过内置爬虫直接从 GitHub 仓库、YouTube 字幕、Confluence 页面和网站抓取内容。

向量数据库

内置 LanceDB,零配置可用。若需企业特性,可切换至 Chroma、Milvus、Pinecone、Qdrant、Weaviate、Zilliz、AstraDB 或 PGVector。

多 LLM 支持

支持众多提供商,包括 Ollama、LM Studio、OpenAI、Anthropic、Azure OpenAI、Google Gemini、AWS Bedrock、Groq 与 DeepSeek。您可按工作区选择模型:某个工作区可用本地 Ollama 处理敏感内容,另一个则通过 OpenAI 使用 GPT-4o。

AI 代理

在任意聊天中输入 @agent 可启用零代码代理构建器。它内置了文档搜索、摘要与网页抓取等技能。Agent Flows 提供可视化画布,用于串联 API 调用、LLM 指令与文件操作。它还支持 Model Context Protocol(MCP) 连接外部工具。

API 访问

开发者 API 位于 /api/docs (Swagger 文档)。您可以以编程方式管理工作区、嵌入文档并发送聊天消息。

AnythingLLM 的工作原理(架构概览)

应用由三部分构成:前端(React/ViteJS)提供可见且可交互的界面;服务器(Express 后端)负责所有 LLM 交互、向量数据库操作与 API 请求,并使用 SQLite 存储配置;采集器 是独立服务,负责解析与处理您上传的文档。上传 PDF 后,采集器会抽取文本,随后服务器将其切块、向量化并存储。

RAG 流水线

该流水线分为两个阶段。

摄取:您的文档进入采集器,由其抽取文本。服务器随后将文本拆分为片段(最多 1,000 个字符,并有少量重叠以保持上下文)。每个片段由嵌入模型转换为向量,再存入向量数据库。一个 vector-cache/ 文件夹在许多情况下可减少不必要的重复嵌入。

查询:您的问题会使用相同的嵌入模型转为向量。系统随后检索最相似的片段(通常 4 至 6 个)。在按相似度阈值筛选后,匹配文本会与您的问题和聊天历史一起加入到 LLM 提示中。LLM 会阅读这些内容(系统指令、检索到的上下文、您的问题及历史消息)并生成答案。
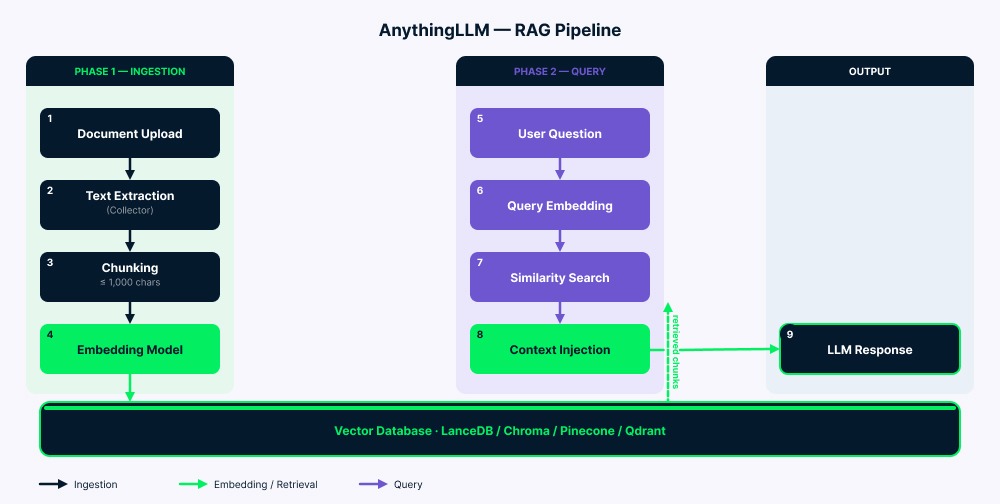
AnythingLLM RAG 流水线流程图,从文档上传到 LLM 响应。

AnythingLLM RAG 流水线架构概览。图片由作者提供。

使用 Docker 安装 AnythingLLM

正如在常见问题中所见,AnythingLLM 本体较轻量:约 2GB 内存、2 核 CPU、约 5GB 存储。若同时运行本地 LLM,需求更高(7B 模型通常需要 8GB+ RAM/VRAM)。本教程使用可在低配硬件上运行的 3B 模型。开始前请确保已安装并运行 Docker。Windows 用户还需 WSL。

步骤 1:安装 Ollama 并拉取模型

从 ollama.com/download 下载 Ollama,然后拉取一个聊天模型和一个嵌入模型:

ollama pull llama3.2:3b
ollama pull nomic-embed-text
ollama serve

我使用 llama3.2:3b,因为它在显存有限的机器上运行良好(如 6GB 显存的 RTX 3050)。若需更高质量,可尝试 llama3.2:8b 或 deepseek-r1:7b(若硬件允许)。更多模型选项请参见我们的本地运行 LLM 指南。

步骤 2:创建 Docker Compose 文件

mkdir anythingllm-setup && cd anythingllm-setup
touch .env

创建 docker-compose.yml:

services:
  anythingllm:
    image: mintplexlabs/anythingllm:latest
    container_name: anythingllm
    ports:
      - "3001:3001"
    cap_add:
      - SYS_ADMIN
    volumes:
      - anythingllm_storage:/app/server/storage
      - ./.env:/app/server/.env
    environment:
      - STORAGE_DIR=/app/server/storage
    extra_hosts:
      - "host.docker.internal:host-gateway"
    restart: unless-stopped

volumes:
  anythingllm_storage:

关于该配置的几点说明。cap_add: SYS_ADMIN 标志是内置 PuppeteerJS 网页爬虫所必需的,它使用沙箱化的 Chromium 浏览器。 

此外,extra_hosts 行解决了最常见的 Docker 网络问题:它允许容器访问运行在宿主机上的 Ollama。否则,从容器内部连接 localhost:11434 的尝试会失败,因为 Docker 容器有独立的网络命名空间。 

我使用命名的 Docker 卷(anythingllm_storage)而不是绑定挂载,以获得更好的跨平台兼容性,尤其是在 Windows 和 macOS 上,绑定挂载的权限可能会有问题。

步骤 3:启动与配置

等待约 30 秒让容器初始化,然后打开 http://localhost:3001。您将看到首次运行的设置向导。但在此之前,先运行以下命令:

docker compose up -d
Docker 安装后,AnythingLLM 首次运行设置向导。

Docker 上的 AnythingLLM 初始设置向导。图片由作者提供。

在设置向导中,将 LLM 与嵌入提供商均选择 Ollama,将基础 URL 设为 http://host.docker.internal:11434,聊天模型选择 llama3.2:3b,嵌入模型选择 nomic-embed-text。向量数据库保持默认的 LanceDB。

将 Ollama 配置为 LLM 提供商。视频由作者提供。

若选择桌面版替代方案,请从 anythingllm.com 下载应用。它打包了一切,开箱即用,无需任何配置。非常适合个人使用,但如前所述,它不具备 Docker 版本提供的多用户与企业功能。

连接 LLM 提供商

除了 Ollama,您还可以在设置中连接云端提供商(如常见问题 1 所述,当硬件受限时很有用)。

OpenAI

选择 OpenAI 作为 LLM 提供商,输入来自 platform.openai.com 的 API 密钥,并选择模型(GPT-4o、GPT-4o-mini 等)。您的账号需要完成计费设置,否则无法使用(且报错信息并不明显)。

Anthropic

输入来自 console.anthropic.com 的密钥。所有 Claude 模型都可用于对话,但 Anthropic 没有嵌入模型,因此仍需单独的嵌入器,如 Ollama 的 nomic-embed-text。

Ollama 配置

如果在安装过程中按上文所示配置了 Ollama,则已经就绪。其他环境下,Windows/macOS 使用 http://host.docker.internal:11434,Linux 使用 http://172.17.0.1:11434。若 Ollama 不可达,请在启动前设置 OLLAMA_HOST=0.0.0.0:11434。

使用 AnythingLLM 进行文档对话

单击侧栏中的“New Workspace”并命名。通过侧栏上传按钮或拖放来上传文件。

AnythingLLM 支持两种文档模式。附件(拖入聊天)会将全文放入该对话,但仅限该会话线程使用。模型可见全部内容,但受限于 token 容量。嵌入(标准 RAG 方式)会将文档切分为片段、转换为向量,并存入工作区。完成嵌入后,文档可在该工作区的所有聊天中使用。大多数情况下,嵌入是更佳选择。单击“Move to Workspace”开始嵌入流程。

在工作区上传并嵌入文档。视频由作者提供。

调优检索质量

输入问题后,系统会自动查找相关片段并发送给 LLM。若答案不理想,可调整以下关键设置:

相似度阈值

如常见问题 5 所述,遇到问题时可先从“No Restriction(不限制)”开始,然后逐步提高以过滤噪声。

最大上下文片段数

默认是 4 到 6 个片段。对于上下文窗口较大的模型(如 Claude),可提升到 10 或 12。

搜索偏好

在 LanceDB 上启用“Accuracy Optimized(精度优化)”会开启重排序,可提升结果质量,但可能视模型与硬件带来额外延迟。

文档固定

将关键文档“固定”可完全跳过分片。其全文会被加入到每次查询中(前提是符合 token 限制)。

带有 RAG 上下文的文档对话响应。视频由作者提供。

AnythingLLM vs. Open WebUI

两者都很不错,但它们面向不同用户。

维度

AnythingLLM

Open WebUI

主要受众

商务用户、小型团队

开发者、技术用户

桌面应用

是(macOS、Windows、Linux)

否(仅 Web)

部署复杂度

桌面版:一键;Docker:较为直接

需要 Docker 或服务器部署

RAG 实现

内置,多向量库支持,重排序

功能广泛的 RAG,基于插件的可扩展性

多用户

仅 Docker;三种 RBAC 角色

有限的协作功能

插件生态

在成长;通过 Node.js 自定义技能

更成熟且更广泛

许可协议

MIT

自 v0.6.6 起为带品牌保护的修改版 BSD-3-Clause

AnythingLLM 通常适合优先关注工作区管理与可嵌入小部件的团队;而 Open WebUI 则更适合需要更大插件生态与更偏开发者向扩展性的用户。一些团队会同时运行两者:Open WebUI 提供给追求精细控制的开发者,AnythingLLM 则供商务用户快速搭建文档工作区。

AnythingLLM vs. ChatGPT

这个对比关注的是侧重点,而非哪个工具“更好”。

维度

AnythingLLM

ChatGPT

数据隐私

配合本地模型实现完全自有

数据发送至 OpenAI 服务器

成本

自建免费;云端起价 $50/月

免费层;Plus $20/月;Pro $200/月

自定义

任意 LLM、嵌入器、向量库与代理

仅限 OpenAI 模型

离线能力

是(配合本地模型)

否

部署工作量

需要安装

零部署,基于浏览器

文档对话

完整 RAG 控制(阈值、切片、重排序)

文件上传但有使用限制

ChatGPT 更强调全托管体验与出色的默认模型质量,而 AnythingLLM 更强调隐私、灵活性与对 RAG 设置的掌控。您也可以通过 OpenAI API 将 GPT-4o 接入 AnythingLLM,从而在保留 AnythingLLM 的工作区与 RAG 功能的同时,获得 ChatGPT 级别的模型能力。

AnythingLLM 的应用场景

以下场景中,AnythingLLM 表现最佳:

内部知识库

员工可就公司文档直接提问,而无需在文件夹中逐一查找。上传政策、流程与文档,让大家用自然语言搜索。

研究型工作流

学术人员可在数百篇论文中即刻检索。嵌入您的文献库,无需手动关键词搜索即可找到相关发现。

私有化企业部署

医疗、金融与法务团队可在自有服务器上使用 AI。常见于要求数据必须本地部署的受监管行业。

开发者测试

在相同文档上切换不同 LLM(Ollama、OpenAI、Claude),按工作区更换模型,无需改动基础设施。

客服聊天小部件

通过 Docker 将聊天界面嵌入网站。为公开使用配置域名白名单与会话限额。

会议转写

会议助手功能类似云端笔记工具,但在本地运行。流畅使用通常需要约 16GB 内存。

局限性

如前所述,桌面版与 Docker 版功能差异会让新用户困惑。 

RAG 质量需要调优(关键设置已在前文覆盖),因为相似度搜索基于数学度量,本质上并不真正“理解”含义。 

插件系统小于 Open WebUI,且构建自定义代理技能需要 Node.js 知识。 

最后,暂无内置微调能力。只能通过系统提示、温度与 token 限制进行自定义。

AnythingLLM 的安全与隐私

本地部署会将所有数据保留在您的设备上(更详细内容见下方第三条常见问题)。使用云提供商时,推理阶段仅会发送提示与检索到的上下文。向量与嵌入保留在您的服务器上。请谨慎决定哪些工作区使用云模型,哪些使用本地模型。

Docker 版包含通过 SIMPLE_SSO_ENABLED 启用的 Simple SSO,会创建临时访问令牌。API 密钥具备完全访问权限,缺少细粒度授权,因此请将其视为管理员密码并定期更换。若将 AnythingLLM 暴露到公网,请在前面加上带 SSL 的 Nginx 反向代理(应用本身不处理 HTTPS)。可在 .env 文件中通过 DISABLE_TELEMETRY=true 禁用遥测。

结论

AnythingLLM 解决了自建 AI 领域的真实问题。它提供与文档对话的界面,几乎可连接任意 LLM 提供商,并让您掌控数据。正如前文所述,个人使用选择桌面版,团队部署选择 Docker 版。

与任何工具一样,它也有取舍。RAG 质量取决于您的配置,而桌面版/Docker 版的功能差异可能会让新手困惑。 

下一步,欢迎查看我们的 AI Fundamentals 学习路径,或我们的教程 使用 Docker 与 n8n 构建本地 AI。


Khalid Abdelaty's photo
Author
Khalid Abdelaty
LinkedIn

我是一名数据工程师兼社区建设者,专注于数据管道、云端与 AI 工具链,同时为 DataCamp 和新兴开发者撰写实用且高影响力的教程。

常见问题

没有 GPU 的旧笔记本可以运行吗?

可以!AnythingLLM 本体很轻量:约 2GB 内存、2 核 CPU、约 5GB 存储。较重的是通过 Ollama 在本地运行 LLM。若硬件受限,可改为连接 OpenAI 或 Groq 等云提供商。您将获得相同的工作区与 RAG 功能,但推理在云端进行。换言之,AnythingLLM 负责管理工作流,模型运行位置由您选择(本地或云端)。

如果我之后更换向量数据库会怎样?

请提前规划。向量数据库之间没有自动迁移。从 LanceDB 切换到 Pinecone 意味着需要对所有文档重新嵌入。您的原始文件会保持安全,但向量需要重新生成。实用建议:除非有明确的企业级需求,否则请坚持使用 LanceDB。它通常低配置、适合许多小团队部署。

如果我用 OpenAI 作为 LLM,我的数据真的隐私吗?

关键点在于:您的文档与嵌入永远不会离开您的服务器。但当您提问时,检索到的文本片段与您的提示会发送至 OpenAI 的 API 进行推理。对于真正敏感的数据,请使用 Ollama,一切都会保留在本地。对于一般工作文档,将 AnythingLLM 与 OpenAI 搭配使用,仍然比直接把文件上传到 ChatGPT 更注重隐私。

我的团队能共享同一个 AnythingLLM 部署吗?

可以,但仅限 Docker 版本。它支持多用户和三种角色:Admin、Manager 与 Default。桌面版仅支持单用户。重要提示:多用户模式被设计为单向的配置变更,请在启用前确定是否需要团队访问。

为什么有时回答会忽略我的文档?

通常有三种原因:相似度阈值过高、查询过于模糊、或非英文文档却使用默认英文嵌入器。快速解决:先尝试将阈值设为“No Restriction(不限制)”。如果您的文档不是英文,请切换到 Ollama 中可用的多语言嵌入模型(例如某个 e5 系列模型),效果会好很多。

主题
人工智能
大语言模型

与 DataCamp 一起学习

课程

理解 Artificial Intelligence

2 小时
428.9K
了解人工智能基础概念,如机器学习、深度学习、NLP、生成式 AI 等。
查看详情Right Arrow
开始课程
查看更多Right Arrow