कोर्स
सेल्फ-होस्टेड AI स्पेस में एक आम सवाल है: अपने निजी डॉक्युमेंट्स के साथ कैसे चैट करें बिना उन्हें किसी क्लाउड API पर भेजे।
AnythingLLM इसका लोकप्रिय उत्तर है। यह एक ही इंटरफ़ेस में सब कुछ संभालता है (डॉक्युमेंट अपलोड, एंबेडिंग, सर्च, और चैट) और कई तरह के LLM प्रदाताओं से कनेक्ट होता है। यह आपको क्लाउड सेवाओं पर निर्भर हुए बिना निजी AI वर्कफ़्लो बनाने देता है।
इस गाइड में, मैं बताऊंगा कि AnythingLLM क्या है, इसकी आर्किटेक्चर समझाऊंगा, Docker और Ollama के साथ इसे कैसे इंस्टॉल करें, और एक काम करता हुआ Retrieval-Augmented Generation (RAG) पाइपलाइन दिखाऊंगा। मैं इसे Open WebUI और ChatGPT के साथ भी तुलना करूंगा।
AnythingLLM क्या है?
AnythingLLM एक ओपन-सोर्स एप्लिकेशन है जिसे Mintplex Labs ने MIT लाइसेंस के तहत बनाया है। इसका GitHub समुदाय सक्रिय है, रिलीज़ अक्सर आते हैं, और यह सेल्फ-होस्टेड AI स्पेस में व्यापक रूप से उपयोग होता है।
यह क्या करता है: यह आपके डॉक्युमेंट्स को उस संदर्भ में बदल देता है जिसे लार्ज लैंग्वेज मॉडल (LLM) बातचीत के दौरान उपयोग कर सके। आप फाइलें अपलोड करते हैं, सिस्टम उन्हें प्रोसेस और स्टोर करता है, और फिर LLM आपके डेटा के आधार पर प्रश्नों के उत्तर दे सकता है। प्रोजेक्ट तेज़ी से बढ़ा है, एक सक्रिय Discord समुदाय और मासिक अपडेट्स के साथ जो नए LLM प्रदाता और फीचर्स जोड़ते हैं।
दो बातें शुरू में समझ लें। पहली, AnythingLLM स्वयं कोई मॉडल नहीं है। यह आपको बाहरी LLM प्रदाताओं से जोड़ने वाला पुल है—चाहे स्थानीय (जैसे Ollama) हों या क्लाउड-आधारित (जैसे OpenAI या Anthropic)।
दूसरी, यह प्लेटफ़ॉर्म हर चीज़ को वर्कस्पेस में व्यवस्थित करता है। इन्हें अलग-अलग प्रोजेक्ट्स के लिए अलग कमरों की तरह समझें। हर वर्कस्पेस के अपने डॉक्युमेंट्स और बातचीतें होती हैं, जो अलग-अलग रहती हैं जब तक आप उन्हें साझा करने के लिए स्पष्ट रूप से कॉन्फ़िगर न करें।
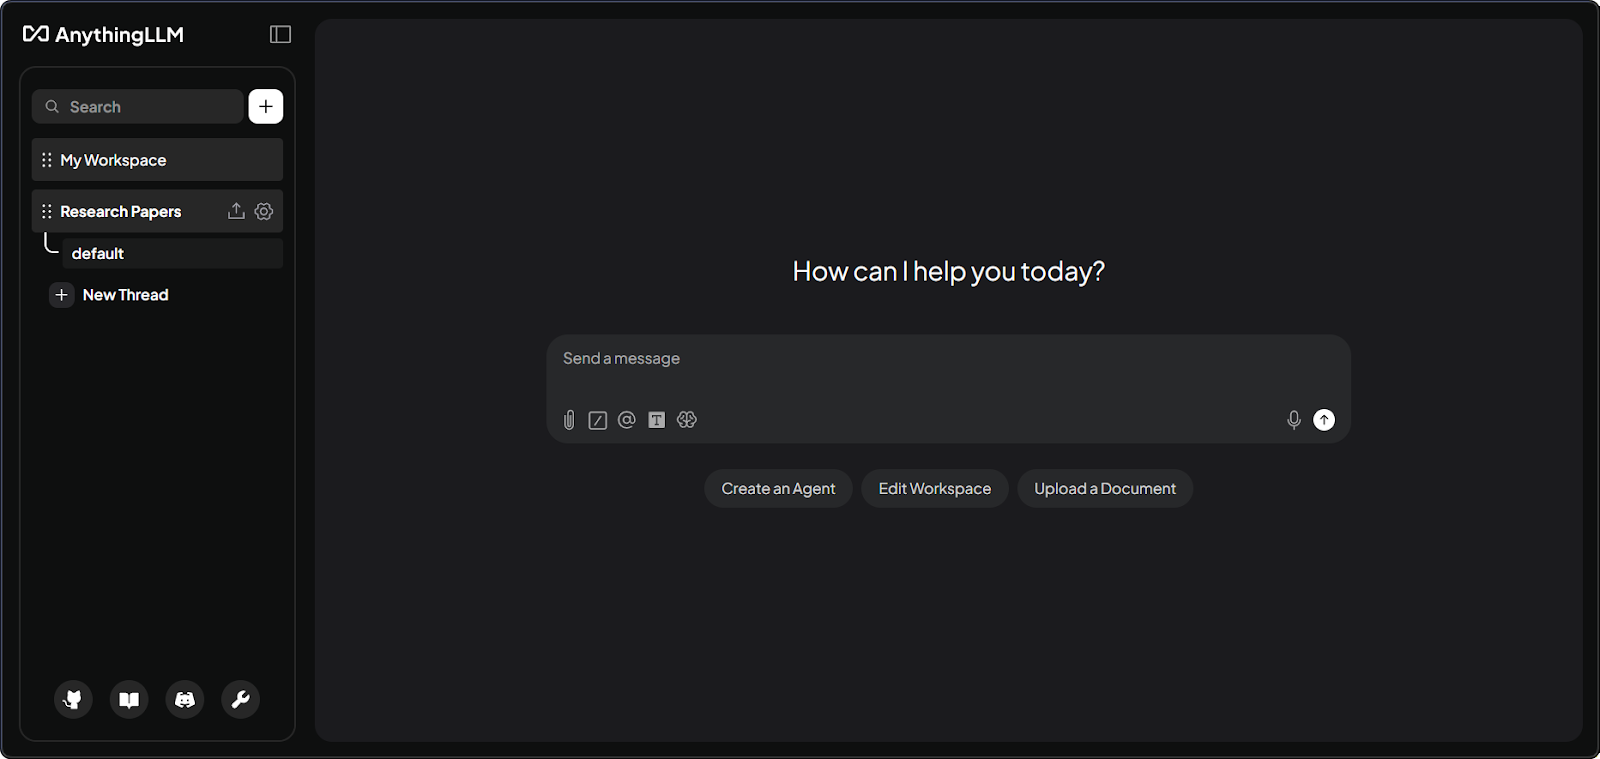
डॉक्युमेंट्स के साथ AnythingLLM वर्कस्पेस इंटरफ़ेस। चित्र: लेखक।
डेस्कटॉप बनाम Docker पर AnythingLLM
यह डेस्कटॉप ऐप (macOS, Windows, Linux) एकल उपयोगकर्ताओं के लिए है जो सब कुछ लोकली चलाना चाहते हैं। इसमें बिल्ट-इन LLM इंजन, CPU-आधारित एंबेडर, और बंडल्ड LanceDB आता है। एक-क्लिक इंस्टॉल, किसी कॉन्फ़िगरेशन की जरूरत नहीं।
यह Docker वर्ज़न टीमों और सर्वरों के लिए बना है। यह Admin, Manager, और Default रोल्स के साथ ठीक-ठाक एक्सेस कंट्रोल जोड़ता है, साथ ही वेबसाइटों के लिए एम्बेडेबल चैट विजेट्स और व्हाइट-लेबलिंग भी देता है। यदि आपको टीम एक्सेस या सार्वजनिक-उन्मुख चैट विजेट्स चाहिए, तो Docker ही आपका एकमात्र विकल्प है।
|
फ़ीचर |
डेस्कटॉप |
Docker |
|
मल्टी-यूज़र सपोर्ट |
नहीं |
हाँ (Admin, Manager, Default रोल्स) |
|
बिल्ट-इन LLM इंजन |
हाँ |
नहीं (बाहरी प्रदाताओं से कनेक्ट करें) |
|
एम्बेडेबल चैट विजेट्स |
नहीं |
हाँ |
|
व्हाइट-लेबलिंग |
नहीं |
हाँ |
|
सेटअप जटिलता |
वन-क्लिक इंस्टॉल |
Docker का ज्ञान आवश्यक |
AnythingLLM की मुख्य विशेषताएँ
अब जब आप जान गए हैं कि AnythingLLM क्या है और Desktop तथा Docker में कैसे चुनें, तो आइए उन विशेषताओं पर नज़र डालें जो इसे डॉक्युमेंट-आधारित AI वर्कफ़्लोज़ के लिए उपयोगी बनाती हैं।
डॉक्युमेंट इनजेशन
PDF, DOCX, TXT, Markdown, CSV, XLSX, PPTX, HTML, 50+ कोड फाइल प्रकार, और ऑडियो फाइलों (Whisper ट्रांसक्रिप्शन का उपयोग करते हुए) के साथ काम करता है। आप GitHub रिपोज़, YouTube ट्रांसक्रिप्ट्स, Confluence पेजों और वेबसाइटों से कंटेंट सीधे खींच सकते हैं, बिल्ट-इन स्क्रेपर का उपयोग करके।
वेक्टर डेटाबेस
LanceDB बिल्ट-इन आता है और किसी सेटअप की जरूरत नहीं। यदि आपको एंटरप्राइज़ फीचर्स चाहिए, तो आप Chroma, Milvus, Pinecone, Qdrant, Weaviate, Zilliz, AstraDB, या PGVector पर स्विच कर सकते हैं।
मल्टीपल LLM सपोर्ट
Ollama, LM Studio, OpenAI, Anthropic, Azure OpenAI, Google Gemini, AWS Bedrock, Groq, और DeepSeek सहित कई प्रदाताओं का समर्थन करता है। आप प्रति वर्कस्पेस मॉडल चुनते हैं, ताकि एक वर्कस्पेस संवेदनशील कार्यों के लिए स्थानीय Ollama मॉडल का उपयोग कर सके, जबकि दूसरा OpenAI के माध्यम से GPT-4o उपयोग करे।
AI एजेंट्स
किसी भी चैट में @agent टाइप करें और नो-कोड एजेंट बिल्डर सक्रिय करें। इसमें डॉक्युमेंट सर्च, सारांश, और वेब स्क्रैपिंग के लिए बिल्ट-इन स्किल्स हैं। Agent Flows आपको API कॉल्स, LLM निर्देश, और फाइल ऑपरेशंस को एक साथ जोड़ने के लिए विज़ुअल कैनवस देता है। यह Model Context Protocol (MCP) के माध्यम से बाहरी टूल्स से कनेक्ट करने का समर्थन भी करता है।
API एक्सेस
डेवलपर API यहां उपलब्ध है /api/docs (Swagger docs)। आप प्रोग्रामेटिक तरीके से वर्कस्पेस मैनेज कर सकते हैं, डॉक्युमेंट्स एंबेड कर सकते हैं, और चैट संदेश भेज सकते हैं।
AnythingLLM कैसे काम करता है (आर्किटेक्चर ओवरव्यू)
एप्लिकेशन के तीन भाग हैं: फ्रंटएंड (React/ViteJS) आपको दिखने वाला और उपयोग करने वाला इंटरफ़ेस देता है। सर्वर (Express बैकएंड) सभी LLM इंटरैक्शंस, वेक्टर डेटाबेस का काम, और API रिक्वेस्ट्स संभालता है। यह कॉन्फ़िगरेशन स्टोर करने के लिए SQLite का उपयोग करता है। कलेक्टर एक अलग सर्विस है जो आपके अपलोड किए गए डॉक्युमेंट्स को पार्स और प्रोसेस करता है। जब आप कोई PDF अपलोड करते हैं, तो कलेक्टर टेक्स्ट निकालता है, फिर सर्वर उसे छोटे हिस्सों में तोड़ता है, एंबेड करता है, और स्टोर करता है।
RAG पाइपलाइन
यह पाइपलाइन दो चरणों में काम करती है।
इनजेशन: आपके डॉक्युमेंट्स कलेक्टर के पास जाते हैं, जो टेक्स्ट निकालता है। फिर सर्वर इस टेक्स्ट को हिस्सों में बाँटता है (अधिकतम 1,000 कैरेक्टर तक, संदर्भ बनाए रखने के लिए थोड़े ओवरलैप के साथ)। हर हिस्से को एंबेडिंग मॉडल द्वारा वेक्टर में बदला जाता है, फिर वेक्टर डेटाबेस में स्टोर किया जाता है। एक vector-cache/ फ़ोल्डर कई मामलों में अनावश्यक री-एंबेडिंग कम करता है।
क्वेरी: आपका सवाल उसी एंबेडिंग मॉडल का उपयोग करके एक वेक्टर में बदला जाता है। फिर सिस्टम सबसे मिलते-जुलते हिस्सों की खोज करता है (आमतौर पर चार से छह)। समानता स्कोर से फ़िल्टर करने के बाद, मिला हुआ टेक्स्ट आपके सवाल और चैट हिस्ट्री के साथ LLM प्रॉम्प्ट में जोड़ा जाता है। LLM यह सब पढ़ता है (सिस्टम इंस्ट्रक्शंस, रिट्रीव्ड संदर्भ, आपका सवाल, और पिछले संदेश) और अपना उत्तर जनरेट करता है।
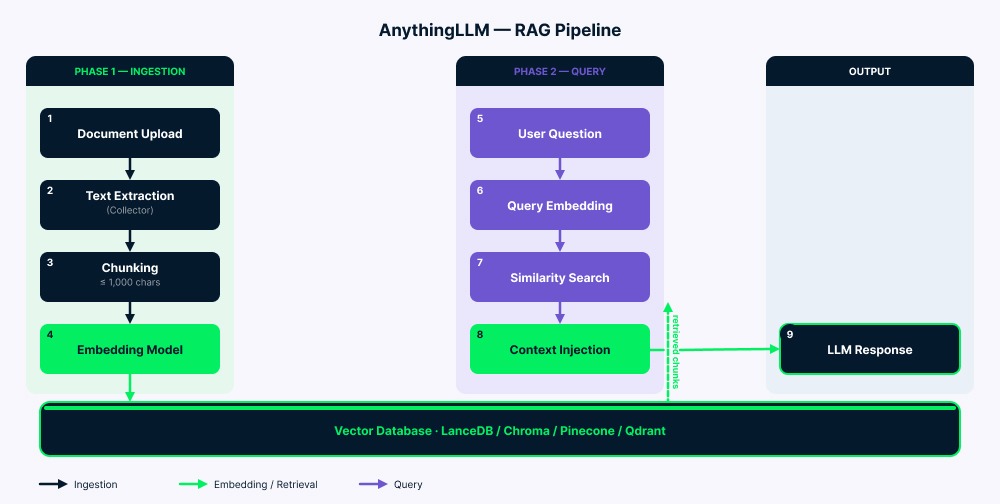
AnythingLLM RAG पाइपलाइन आर्किटेक्चर ओवरव्यू। चित्र: लेखक।
Docker के साथ AnythingLLM इंस्टॉल करना
जैसा कि आप FAQ में देखेंगे, AnythingLLM हल्का है: लगभग 2GB RAM, 2-कोर CPU, और लगभग 5GB स्टोरेज। इसके साथ लोकल LLM चलाना ज़्यादा संसाधन मांगता है (7B मॉडल को आमतौर पर 8GB+ RAM/VRAM चाहिए)। इस ट्यूटोरियल में, मैं 3B मॉडल का उपयोग करता हूँ जो सीमित हार्डवेयर पर चलता है। शुरू करने से पहले सुनिश्चित करें कि Docker इंस्टॉल और रन हो रहा है। Windows उपयोगकर्ताओं को WSL भी चाहिए।
स्टेप 1: Ollama इंस्टॉल करें और मॉडल्स पुल करें
Ollama को यहां से डाउनलोड करें ollama.com/download, फिर एक चैट मॉडल और एक एंबेडिंग मॉडल पुल करें:
ollama pull llama3.2:3b
ollama pull nomic-embed-text
ollama serve
मैं llama3.2:3b का उपयोग करता हूँ क्योंकि यह सीमित VRAM वाली मशीनों पर अच्छा चलता है (जैसे 6GB वाले RTX 3050 पर)। बेहतर गुणवत्ता के लिए, llama3.2:8b या deepseek-r1:7b आज़माएँ यदि आपका हार्डवेयर अनुमति दे। और मॉडल विकल्पों के लिए हमारा लोकली LLMs चलाना गाइड देखें।
स्टेप 2: Docker Compose फाइल बनाएं
mkdir anythingllm-setup && cd anythingllm-setup
touch .env
docker-compose.yml बनाएं:
services:
anythingllm:
image: mintplexlabs/anythingllm:latest
container_name: anythingllm
ports:
- "3001:3001"
cap_add:
- SYS_ADMIN
volumes:
- anythingllm_storage:/app/server/storage
- ./.env:/app/server/.env
environment:
- STORAGE_DIR=/app/server/storage
extra_hosts:
- "host.docker.internal:host-gateway"
restart: unless-stopped
volumes:
anythingllm_storage:
इस कॉन्फ़िगरेशन के बारे में कुछ बातें ध्यान देने योग्य हैं। cap_add: SYS_ADMIN फ़्लैग बिल्ट-इन PuppeteerJS वेब स्क्रेपर के लिए आवश्यक है, जो सैंडबॉक्स्ड Chromium ब्राउज़र का उपयोग करता है।
यह extra_hosts लाइन सबसे आम Docker नेटवर्किंग समस्या का समाधान करती है: यह कंटेनर को आपके होस्ट मशीन पर चल रहे Ollama तक पहुंचने देती है। इसके बिना, कंटेनर के अंदर से localhost:11434 से कनेक्ट करने का कोई भी प्रयास विफल होगा क्योंकि Docker कंटेनरों का अपना नेटवर्क नेमस्पेस होता है।
मैं एक नामित Docker वॉल्यूम (anythingllm_storage) का उपयोग करता हूँ, बाइंड माउंट के बजाय, बेहतर क्रॉस-प्लेटफ़ॉर्म संगतता के लिए—खासकर Windows और macOS पर, जहाँ बाइंड माउंट परमिशंस समस्याग्रस्त हो सकते हैं।
स्टेप 3: लॉन्च करें और कॉन्फ़िगर करें
कंटेनर को इनिशियलाइज़ होने के लिए लगभग 30 सेकंड प्रतीक्षा करें, फिर http://localhost:3001 खोलें। आपको फ़र्स्ट-रन सेटअप विज़ार्ड दिखेगा। लेकिन पहले, यह कमांड चलाएँ:
docker compose up -d
Docker पर AnythingLLM का प्रारंभिक सेटअप विज़ार्ड। चित्र: लेखक।
सेटअप विज़ार्ड के दौरान, LLM और एंबेडिंग प्रदाता दोनों के रूप में Ollama चुनें, बेस URL को http://host.docker.internal:11434 पर सेट करें, चैट मॉडल के रूप में llama3.2:3b चुनें, और एंबेडर के रूप में nomic-embed-text चुनें। LanceDB को डिफ़ॉल्ट वेक्टर डेटाबेस के रूप में रखें।
डेस्कटॉप विकल्प के लिए, ऐप यहां से डाउनलोड करें anythingllm.com। यह सब कुछ बंडल करता है और बिना किसी कॉन्फ़िगरेशन के तुरंत काम करता है। व्यक्तिगत उपयोग के लिए आदर्श, लेकिन जैसा पहले बताया, इसमें Docker में उपलब्ध मल्टी-यूज़र और एंटरप्राइज़ फीचर्स नहीं हैं।
LLM प्रदाताओं को कनेक्ट करना
Ollama से आगे, आप Settings के माध्यम से क्लाउड प्रदाताओं को कनेक्ट कर सकते हैं (जैसा कि FAQ 1 में बताया गया है, यह तब उपयोगी है जब आपका हार्डवेयर सीमित हो)।
OpenAI
OpenAI को अपने LLM प्रदाता के रूप में चुनें, अपनी API कुंजी platform.openai.com से दर्ज करें, और एक मॉडल चुनें (GPT-4o, GPT-4o-mini, आदि)। आपके खाते में बिलिंग सेटअप होना चाहिए, वरना यह काम नहीं करेगा (और त्रुटि संदेश स्पष्ट नहीं होगा)।
Anthropic
अपनी कुंजी console.anthropic.com से दर्ज करें। सभी Claude मॉडल चैट के लिए काम करते हैं, लेकिन Anthropic के पास एंबेडिंग मॉडल नहीं हैं, इसलिए आपको फिर भी Ollama के nomic-embed-text जैसे अलग एंबेडर की जरूरत होगी।
Ollama कॉन्फ़िगरेशन
यदि आपने ऊपर दिखाए अनुसार इंस्टॉलेशन के दौरान Ollama कॉन्फ़िगर कर लिया है, तो सब तैयार है। अन्य सेटअप के लिए, Windows/macOS पर http://host.docker.internal:11434 या Linux पर http://172.17.0.1:11434 का उपयोग करें। यदि Ollama पहुँच में नहीं है, तो उसे शुरू करने से पहले OLLAMA_HOST=0.0.0.0:11434 सेट करें।
डॉक्युमेंट चैट के लिए AnythingLLM का उपयोग
साइडबार में "New Workspace" पर क्लिक करें और नाम दें। फाइलें साइडबार अपलोड बटन से या ड्रैग-एंड-ड्रॉप द्वारा अपलोड करें।
AnythingLLM दो डॉक्युमेंट मोड्स सपोर्ट करता है। Attaching (चैट में ड्रैग करना) पूरे टेक्स्ट को बातचीत में जोड़ता है, लेकिन केवल उसी चैट थ्रेड के लिए। मॉडल सब कुछ देखता है, पर आप टोकन क्षमता से सीमित होते हैं। Embedding (मानक RAG तरीका) डॉक्युमेंट को हिस्सों में तोड़ता है, उन्हें वेक्टर में बदलता है, और वर्कस्पेस में स्टोर करता है। एंबेड होने के बाद, डॉक्युमेंट्स उस वर्कस्पेस की सभी चैट्स में काम करते हैं। अधिकांश मामलों में, एंबेडिंग बेहतर विकल्प है। एंबेडिंग प्रक्रिया शुरू करने के लिए "Move to Workspace" पर क्लिक करें।
रिट्रीवल गुणवत्ता ट्यून करना
अपना प्रश्न टाइप करें और सिस्टम अपने-आप संबंधित हिस्से ढूंढकर LLM को भेज देता है। यदि उत्तर अच्छे नहीं हैं, तो ये मुख्य सेटिंग्स समायोजित करें:
सिमिलैरिटी थ्रेशहोल्ड
जैसा कि FAQ 5 में बताया गया है, यदि समस्या आ रही हो तो "No Restriction" से शुरू करें, फिर धीरे-धीरे बढ़ाएँ ताकि शोर फ़िल्टर हो।
मैक्स कॉन्टेक्स्ट स्निपेट्स
डिफ़ॉल्ट चार से छह हिस्से हैं। बड़ी कॉन्टेक्स्ट विंडो वाले मॉडलों (जैसे Claude) के लिए इसे 10 या 12 तक बढ़ाएँ।
सर्च प्रेफ़रेंस
LanceDB पर "Accuracy Optimized" रीरैंकिंग चालू करता है, जो परिणामों में सुधार करता है पर मॉडल और हार्डवेयर के अनुसार अतिरिक्त विलंब ला सकता है।
डॉक्युमेंट पिनिंग
महत्वपूर्ण डॉक्युमेंट्स को पिन करें ताकि चंकिंग पूरी तरह से स्किप हो जाए। पूरा टेक्स्ट हर क्वेरी में जोड़ दिया जाता है (बशर्ते वह टोकन सीमा में फिट हो)।
AnythingLLM बनाम Open WebUI
दोनों टूल मजबूत हैं, लेकिन वे अलग उपयोगकर्ताओं के लिए बने हैं।
|
आयाम |
AnythingLLM |
Open WebUI |
|
प्राथमिक ऑडियंस |
बिज़नेस यूज़र्स, छोटी टीमें |
डेवलपर्स, तकनीकी उपयोगकर्ता |
|
डेस्कटॉप ऐप |
हाँ (macOS, Windows, Linux) |
नहीं (केवल वेब-आधारित) |
|
सेटअप जटिलता |
डेस्कटॉप: वन-क्लिक; Docker: सीधा-सादा |
Docker या सर्वर सेटअप आवश्यक |
|
RAG इम्प्लीमेंटेशन |
मल्टी-वेक्टर DB सपोर्ट, रीरैंकिंग के साथ बिल्ट-इन |
विस्तृत RAG, प्लगइन-आधारित विस्तारशीलता |
|
मल्टी-यूज़र |
केवल Docker; तीन RBAC रोल्स |
सीमित सहयोग सुविधाएँ |
|
प्लगइन इकोसिस्टम |
बढ़ता हुआ; Node.js के जरिए कस्टम स्किल्स |
अधिक परिपक्व और व्यापक |
|
लाइसेंस |
MIT |
संस्करण v0.6.6 से ब्रांडिंग प्रोटेक्शन के साथ संशोधित BSD-3-Clause |
AnythingLLM आम तौर पर उन टीमों के लिए उपयुक्त है जो वर्कस्पेस मैनेजमेंट और एम्बेडेबल विजेट्स को प्राथमिकता देती हैं, जबकि Open WebUI आम तौर पर उन उपयोगकर्ताओं के लिए अनुकूल है जो बड़ा प्लगइन इकोसिस्टम और डेवलपर-उन्मुख विस्तारशीलता चाहते हैं। कुछ टीमें दोनों चलाती हैं: डेवलपर्स के लिए Open WebUI जो सूक्ष्म नियंत्रण चाहते हैं, और बिज़नेस उपयोगकर्ताओं के लिए AnythingLLM जो त्वरित डॉक्युमेंट वर्कस्पेस चाहते हैं।
AnythingLLM बनाम ChatGPT
यह तुलना प्राथमिकताओं के बारे में है, न कि कौन सा टूल "बेहतर" है।
|
आयाम |
AnythingLLM |
ChatGPT |
|
डाटा प्राइवेसी |
लोकल मॉडल्स के साथ पूर्ण स्वामित्व |
डाटा OpenAI सर्वरों पर भेजा जाता है |
|
लागत |
फ्री (सेल्फ-होस्टेड); क्लाउड $50/माह से |
फ्री टियर; Plus $20/माह; Pro $200/माह |
|
कस्टमाइजेशन |
कोई भी LLM, एंबेडर, वेक्टर DB, एजेंट्स |
केवल OpenAI मॉडल्स तक सीमित |
|
ऑफ़लाइन क्षमता |
हाँ (लोकल मॉडल्स के साथ) |
नहीं |
|
सेटअप प्रयास |
इंस्टॉलेशन आवश्यक |
शून्य सेटअप, ब्राउज़र-आधारित |
|
डॉक्युमेंट चैट |
पूर्ण RAG नियंत्रण (थ्रेशहोल्ड, चंकिंग, रीरैंकिंग) |
फाइल अपलोड्स सीमाओं के साथ |
ChatGPT पूरी तरह से होस्टेड अनुभव और मज़बूत डिफ़ॉल्ट मॉडल क्वालिटी पर ज़ोर देता है, जबकि AnythingLLM प्राइवेसी, लचीलापन, और RAG सेटिंग्स पर नियंत्रण पर ज़ोर देता है। आप OpenAI API के जरिए GPT-4o को AnythingLLM से भी जोड़ सकते हैं। इससे आपको ChatGPT-गुणवत्ता वाले मॉडल्स मिलते हैं, AnythingLLM के वर्कस्पेस और RAG फीचर्स के साथ।
AnythingLLM के उपयोग के मामले
यहाँ AnythingLLM सबसे अच्छा काम करता है:
आंतरिक नॉलेज बेस
कर्मचारी फोल्डर्स में खोजने की बजाय कंपनी डॉक्युमेंट्स के बारे में सवाल पूछ सकते हैं। अपनी नीतियाँ, प्रक्रियाएँ, और डाक्यूमेंटेशन अपलोड करें, फिर लोगों को नैचुरल लैंग्वेज में सर्च करने दें।
रिसर्च वर्कफ़्लोज़
अकादमिक सैकड़ों पेपर्स में तुरंत खोज कर सकते हैं। अपनी रिसर्च लाइब्रेरी एंबेड करें और मैनुअल कीवर्ड सर्च के बिना प्रासंगिक निष्कर्ष सामने लाएँ।
प्राइवेट एंटरप्राइज़ डिप्लॉयमेंट्स
हेल्थकेयर, फाइनेंस, और लीगल टीमें अपना सारा डाटा अपने सर्वरों पर रखते हुए AI का उपयोग कर सकती हैं। विनियमित उद्योगों में आम जहाँ डाटा ऑन-प्रिमाइसेस रहना चाहिए।
डेवलपर टेस्टिंग
एक ही डॉक्युमेंट्स पर अलग-अलग LLMs (Ollama, OpenAI, Claude) आज़माएँ, प्रति वर्कस्पेस मॉडल्स स्विच करके। किसी इन्फ्रास्ट्रक्चर बदलाव की जरूरत नहीं।
कस्टमर चैट विजेट्स
Docker का उपयोग करके अपनी वेबसाइट पर चैट इंटरफ़ेस एंबेड करें। पब्लिक उपयोग के लिए डोमेन अलाउलिस्ट्स और प्रति-सेशन लिमिट्स कॉन्फ़िगर करें।
मीटिंग ट्रांसक्रिप्शन
Meeting Assistant फीचर क्लाउड नोट-टेकिंग टूल्स जैसा काम करता है, लेकिन लोकली चलता है। स्मूद संचालन के लिए लगभग 16GB RAM चाहिए।
सीमाएँ
जैसा पहले चर्चा की, डेस्कटॉप और Docker में अलग-अलग फीचर्स हैं, जो नए उपयोगकर्ताओं को भ्रमित कर सकते हैं।
RAG गुणवत्ता को ट्यूनिंग की जरूरत होती है (मुख्य सेटिंग्स मैंने पहले कवर की हैं) क्योंकि सिमिलैरिटी सर्च गणित-आधारित है और वास्तव में अर्थ नहीं समझती।
प्लगइन सिस्टम Open WebUI जितना बड़ा नहीं है, और कस्टम एजेंट स्किल्स बनाना Node.js का ज्ञान मांगता है।
अंततः, बिल्ट-इन फाइन-ट्यूनिंग नहीं है। आप केवल सिस्टम प्रॉम्प्ट्स, टेम्परेचर, और टोकन लिमिट्स से कस्टमाइज़ कर सकते हैं।
AnythingLLM की सुरक्षा और गोपनीयता
लोकल डिप्लॉयमेंट आपका सारा डाटा आपके डिवाइस पर रखता है। (नीचे तीसरे FAQ में और विवरण हैं।) क्लाउड प्रदाताओं का उपयोग करते समय, केवल प्रॉम्प्ट्स और रिट्रीव्ड संदर्भ इन्फ़्रेंस के दौरान भेजे जाते हैं। वेक्टर्स और एंबेडिंग्स आपके सर्वर पर रहती हैं। किन वर्कस्पेसेस में क्लाउड बनाम लोकल मॉडल्स का उपयोग हो—इस बारे में सावधान रहें।
Docker वर्ज़न में SIMPLE_SSO_ENABLED के जरिए Simple SSO शामिल है, जो अस्थायी एक्सेस टोकन बनाता है। API कुंजियाँ बिना ग्रैन्युलर परमिशंस के पूर्ण एक्सेस देती हैं, इसलिए उन्हें एडमिन पासवर्ड की तरह ट्रीट करें और नियमित रूप से बदलें। यदि आप AnythingLLM को इंटरनेट पर एक्सपोज़ करते हैं, तो उसके सामने SSL के साथ एक Nginx रिवर्स प्रॉक्सी लगाएँ (ऐप अपने आप HTTPS हैंडल नहीं करता)। टेलीमेट्री को अपनी .env फाइल में DISABLE_TELEMETRY=true से डिसेबल किया जा सकता है।
निष्कर्ष
AnythingLLM सेल्फ-होस्टेड AI स्पेस में एक वास्तविक समस्या का समाधान करता है। यह आपको अपने डॉक्युमेंट्स के साथ चैट करने के लिए इंटरफ़ेस देता है, लगभग किसी भी LLM प्रदाता से कनेक्ट होता है, और आपका डाटा आपके नियंत्रण में रखता है। जैसा कि पहले चर्चा हुई, व्यक्तिगत उपयोग के लिए Desktop चुनें या टीम डिप्लॉयमेंट्स के लिए Docker।
किसी भी टूल की तरह, इसके भी ट्रेड-ऑफ़्स हैं। RAG की गुणवत्ता इस पर निर्भर करती है कि आप इसे कैसे कॉन्फ़िगर करते हैं, और Desktop/Docker के फीचर अंतर नए उपयोगकर्ताओं को उलझा सकते हैं।
अगले चरण के रूप में, हमारा AI Fundamentals ट्रैक या Docker और n8n के साथ लोकल AI बनाने पर ट्यूटोरियल देखें।
मैं एक डेटा इंजीनियर और कम्युनिटी बिल्डर हूँ, जो डेटा पाइपलाइनों, क्लाउड, और AI टूलिंग के साथ काम करता/करती हूँ, साथ ही DataCamp और उभरते डेवलपर्स के लिए व्यावहारिक, असरदार ट्यूटोरियल लिखता/लिखती हूँ।
FAQs
क्या मैं इसे बिना GPU वाले पुराने लैपटॉप पर चला सकता/सकती हूँ?
हाँ! AnythingLLM स्वयं हल्का है: लगभग 2GB RAM, 2-कोर CPU, और लगभग 5GB स्टोरेज। भारी हिस्सा Ollama के जरिए लोकल LLM चलाना है। यदि आपका हार्डवेयर सीमित है, तो OpenAI या Groq जैसे क्लाउड प्रदाता से कनेक्ट करें। आपको वही वर्कस्पेस और RAG फीचर्स मिलते हैं, पर इन्फ़्रेंस क्लाउड में होता है। दूसरे शब्दों में, AnythingLLM वर्कफ़्लो मैनेज करता है, और आप चुनते हैं कि मॉडल लोकल चले या क्लाउड में।
यदि मैं बाद में अपना वेक्टर डेटाबेस बदल दूँ तो क्या होगा?
इस पर पहले से योजना बनाएं। वेक्टर डेटाबेस के बीच कोई स्वचालित माइग्रेशन नहीं है। LanceDB से Pinecone पर स्विच करने का मतलब है कि सभी डॉक्युमेंट्स को फिर से एंबेड करना होगा। आपकी मूल फाइलें सुरक्षित रहती हैं, लेकिन वेक्टर्स को फिर से जनरेट करना पड़ता है। व्यावहारिक सलाह: जब तक कोई विशेष एंटरप्राइज़ आवश्यकता न हो, LanceDB पर ही टिके रहें। यह आमतौर पर कम कॉन्फ़िगरेशन मांगता है और कई छोटी टीमों की डिप्लॉयमेंट्स के लिए उपयुक्त है।
यदि मैं LLM के लिए OpenAI का उपयोग करूँ, तो क्या मेरा डाटा सच में प्राइवेट रहता है?
मुख्य बात यह है: आपके डॉक्युमेंट्स और एंबेडिंग्स कभी आपके सर्वर से बाहर नहीं जाते। लेकिन जब आप प्रश्न पूछते हैं, तो रिट्रीव किए गए टेक्स्ट हिस्से और आपका प्रॉम्प्ट इन्फ़्रेंस के लिए OpenAI की API को भेजे जाते हैं। वास्तव में संवेदनशील डाटा के लिए, Ollama का उपयोग करें। सब कुछ लोकल रहता है। सामान्य कार्य डॉक्युमेंट्स के लिए, AnythingLLM के साथ OpenAI का उपयोग करना फिर भी सीधे ChatGPT में फाइलें अपलोड करने से अधिक निजी है।
क्या मेरी टीम एक ही AnythingLLM सेटअप साझा कर सकती है?
हाँ, लेकिन केवल Docker वर्ज़न के साथ। यह तीन रोल्स—Admin, Manager, और Default—के साथ मल्टी-यूज़र सपोर्ट करता है। डेस्कटॉप ऐप केवल एकल उपयोगकर्ता के लिए है। महत्वपूर्ण: मल्टी-यूज़र मोड एक-तरफ़ा कॉन्फ़िगरेशन बदलाव के रूप में डिज़ाइन किया गया है। इसे सक्षम करने से पहले तय करें कि क्या आपको टीम एक्सेस चाहिए।
कभी-कभी यह उत्तर देते समय मेरे डॉक्युमेंट्स की अनदेखी क्यों करता है?
आमतौर पर तीन कारण: सिमिलैरिटी थ्रेशहोल्ड बहुत ऊँचा, अस्पष्ट क्वेरीज़, या नॉन-इंग्लिश डॉक्युमेंट्स के साथ डिफ़ॉल्ट इंग्लिश एंबेडर। त्वरित समाधान: पहले थ्रेशहोल्ड पर "No Restriction" आज़माएँ। यदि आपके डॉक्युमेंट्स इंग्लिश में नहीं हैं, तो Ollama में उपलब्ध किसी मल्टीलिंगुअल एंबेडिंग मॉडल (उदाहरण के लिए किसी e5-आधारित मॉडल) पर स्विच करें—परिणाम काफी बेहतर होंगे।
