Microsoft Synapse Analytics(前称 Azure SQL Data Warehouse)是一项集成分析服务,为大数据与数据仓库提供统一平台。
通过无缝融合企业数据仓库与大数据分析,Synapse 让用户能够摄取、准备、管理并提供数据,以满足即时的商业智能与机器学习需求。此强大的服务支持 SQL、Python 和 Spark 等多种语言,覆盖广泛的数据处理与转换能力。此外,其无服务器架构可按需扩展以处理任何规模的数据,成为现代数据从业者不可或缺的工具。
本指南汇总了帮助您准备 Synapse 面试的重点主题与问题。这些问题来自我在面试和与使用 Synapse 的数据专业人士合作时的亲身经验,能为您提供招聘经理关注点的实用洞察。
除阅读本面试指南外,建议您浏览Microsoft Azure Synapse Analytics 文档,以解答准备过程中遇到的具体问题。
基础类 Synapse 面试题
基础层面的问题会考察您对 Synapse 的入门认知,包括在 Synapse Studio 中的导航、核心组件理解以及简单的数据探索。如果您 Synapse 经验有限,或面试官在评估您的基本理解能力,请预期这些问题。
您应熟悉哪些关键主题?
若被要求做 Synapse 的高层概述,您应能说明 Synapse Analytics 及其在现代数据版图中的角色。
- 核心特性与用户界面:了解 Synapse Studio、其不同的工作区(Data、Develop、Integrate、Monitor、Manage)及其功能。
- 简单用例:举例说明组织如何使用 Synapse,并提供基础架构方面的见解。
什么是 Microsoft Synapse Analytics?它有哪些关键特性?
Synapse Analytics 是一项“无限制”的分析服务,整合了企业数据仓库与大数据分析。其关键特性包括:
- SQL Pool(数据仓库):面向结构化数据的分布式查询引擎,支持高性能分析。
- Spark Pool:与 Apache Spark 集成,用于大数据处理与机器学习。
- Data Lake 支持:与 Azure Data Lake Storage Gen2 原生集成,可就地分析数据。
- Synapse Studio:用于数据准备、数据仓库、大数据分析与 AI 任务的统一工作区。
- 数据集成:内置与 Azure Data Factory 的数据集成功能。
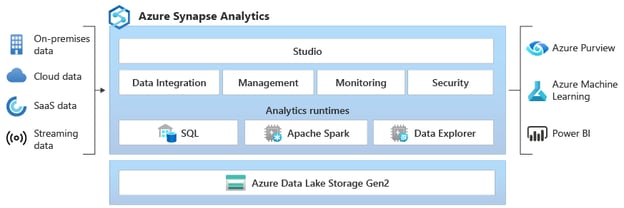
请解释 Synapse Analytics 的核心架构。
核心架构包括:
- Synapse Studio:Synapse 所有活动的中心化 UI。
- SQL Pools:为结构化数据提供基于 T-SQL 的查询能力。Dedicated SQL pool 提供有保障的资源;Serverless SQL pool 则支持对数据湖中数据进行按需查询。
- Spark Pools:以服务形式提供 Apache Spark,用于大数据处理、数据工程与机器学习任务。
- Data Lake Storage:Azure Data Lake Storage Gen2 作为基础,用于存储大量结构化、半结构化与非结构化数据。
- Pipelines:由 Azure Data Factory 驱动的数据集成管道,用于 ETL/ELT 流程。
如何在 Synapse Analytics 中查询数据?
您可以通过以下方式在 Synapse 中查询数据:
- T-SQL:使用 SQL Pool 查询结构化数据。
- Spark SQL:使用 Spark Pool 查询数据湖中的数据。
- Serverless SQL Pool:无需预配资源,直接用 T-SQL 查询数据湖中的数据。
进阶类 Synapse 面试题
这些问题评估您对 Synapse 及其配置的更深入理解。您需要展示管理资源、实现数据处理工作流与优化性能的能力。
在基础知识之上,您还需理解:
- 资源管理:如何预配并管理 SQL Pool 与 Spark Pool。
- 数据集成:使用 Synapse Pipelines(Azure Data Factory)创建并管理数据管道。
- 性能调优:理解查询优化技术与数据分区策略。
如何在 Synapse Analytics 中创建和管理 SQL Pool?
要创建 SQL Pool,进入 Synapse Studio,选择“Manage”工作区,再选择“SQL pools”。随后可根据工作负载需求配置池的性能级别(Data Warehouse Units - DWUs)。
管理工作包括监控性能、扩缩资源,以及按需暂停/恢复池。
请解释 Spark 在 Synapse Analytics 中的用法。
Synapse 通过 Spark Pool 以服务形式提供 Apache Spark,这使您可以:
- 使用 Spark DataFrame 处理大规模数据集。
- 用 Python、Scala、Java 等语言开展数据工程任务。
- 使用 Spark MLlib 构建并训练机器学习模型。
什么是数据管道?如何在 Synapse 中创建?
数据管道是用于数据摄取、转换与加载的自动化工作流。在 Synapse 中,您可在“Integrate”工作区使用可视化界面(Azure Data Factory)设计与管理管道。
这些管道可连接多种数据源,利用数据流或存储过程执行等活动完成转换,并将数据加载至目标系统。
如何在 Synapse Analytics 中监控与管理资源?
您可通过 Synapse Studio 中的“Monitor”工作区监控资源。该工作区提供对 SQL Pool 与 Spark Pool 性能、管道执行以及整体系统健康状况的洞察。您还可使用 Azure Monitor 获取更详细的监控与告警能力。
请描述 Synapse Analytics 中可用的数据存储选项。
Synapse Analytics 提供多种数据存储选项,以适配不同需求与场景,确保在处理多样化数据集时的灵活与高效。这些选项包括:
- Azure Data Lake Storage Gen2:数据湖的主要存储,针对大规模分析进行优化。
- SQL pool 存储:在数据仓库内存储结构化数据。
- Azure Blob Storage:可用于存储数据,但对分析型工作负载通常更推荐使用 Data Lake Storage Gen2。
高级类 Synapse 面试题
高级用户需要能够进行性能优化、构建复杂工作流,并实施复杂的分析与机器学习模型。这类问题常见于资深数据岗位或包含 DevOps 职能的角色。
在基础与进阶知识之上,要求具备以下实践经验:
- 性能优化:调优 SQL Pool 与 Spark Pool 配置、优化查询、管理数据分区。
- 机器学习:与 Azure Machine Learning 集成、部署模型并管理模型生命周期。
- CI/CD 管道:为 Synapse 解决方案实施持续集成与持续部署。
在 Synapse 中,您采用哪些性能优化策略?
正确的索引:通过使用聚集列存储索引与合适的非聚集索引优化 SQL Pool 性能。
- 数据分区:基于查询模式对 SQL Pool 与 Data Lake Storage 中的数据进行分区,以提升性能。
- 查询优化:使用查询提示、重写复杂查询,并分析执行计划以定位瓶颈。
- 资源分配:根据工作负载需求为 SQL Pool 与 Spark Pool 合理定型。
如何为 Synapse Analytics 实现 CI/CD 管道?
使用 Azure DevOps 或 GitHub Actions 自动化 Synapse 解决方案的构建、测试与部署。这包括:
- 源代码管理:将 Synapse 工件(SQL 脚本、Spark 笔记本、管道)存入版本控制系统。
- 自动化测试:为 SQL 脚本与数据管道实施单元测试与集成测试。
- 自动化部署:使用 Azure Resource Manager(ARM)模板或 Synapse API 将变更部署到不同环境(开发、测试、生产)。
如何在 Synapse Analytics 中处理复杂分析?
在 Synapse Analytics 中处理复杂分析、确保数据操作顺畅需要多管齐下,包括自动化测试、部署策略与高级分析技术。
下列方法是有效实现上述目标的关键:
- 高级 SQL 查询:在 SQL Pool 中使用窗口函数、公共表表达式(CTE)等高级 T-SQL 特性进行复杂数据分析。
- Spark 进行大数据处理:使用 Spark Pool 处理大型数据集、执行复杂转换并构建机器学习模型。
- 与 Azure Machine Learning 集成:利用 Azure Machine Learning 实现预测建模与异常检测等高级分析场景。
如何在 Synapse Analytics 中部署机器学习模型?
在 Synapse Analytics 中部署机器学习模型需经历多个关键步骤,从训练与注册到实际部署。以下是成功部署模型的结构化路径:
- 训练模型:在 Synapse 中使用 Spark MLlib 或在 Azure Machine Learning 中训练模型。
- 注册模型:将训练完成的模型注册到 Azure Machine Learning 的模型注册库。
- 部署模型:通过 Azure Machine Learning 将模型部署为 REST 端点,或将其集成到 Synapse 管道中进行批量评分。
面向数据工程师岗位的 Synapse 面试题
数据工程师负责设计、构建与维护数据管道,确保数据质量并优化性能。针对以 Synapse 为重点的数据工程师职位,您应理解:
- 数据管道架构:为 ETL/ELT 流程设计可扩展且可靠的数据管道。
- 实时处理:使用 Azure Event Hubs、Azure Stream Analytics 与 Synapse 实现实时数据摄取与处理。
- 数据安全:实施静态与传输中数据的安全措施。
如何在 Synapse Analytics 中设计数据管道?
在 Synapse Analytics 中设计数据管道时,需要考虑多个关键要素以确保高效且可靠的数据处理:
- 识别数据源:确定数据源(如数据库、API、文件)及其摄取方式。
- 设计 ETL/ELT 流程:使用 Synapse Pipelines(Azure Data Factory)构建抽取、转换与加载的数据管道。
- 实施数据质量检查:添加数据校验与错误处理步骤,确保数据质量。
- 自动化管道运行:使用触发器与基于计划的执行,安排管道自动运行。
在 Synapse Analytics 中开展 ETL 的最佳实践有哪些?
在 Synapse Analytics 语境下,实施高效的 ETL(抽取、转换、加载)流程对数据管理与分析至关重要。以下最佳实践有助于优化 ETL 流程:
- 使用 Delta Lake:将数据存储在数据湖中的 Delta Lake,以实现 ACID 事务与数据版本管理。
- 模块化代码:在 Synapse 笔记本与 SQL 脚本中编写模块化、可复用的代码。
- 参数化:对管道与 SQL 脚本进行参数化,提高灵活性与复用性。
- 监控:通过 Synapse Studio 与 Azure Monitor 监控管道运行与性能。
如何在 Synapse 中处理实时数据处理?
作为数据工程师,实时数据处理充满挑战,需要创新方案与可靠方法。以下是常用的经验与技术:
- 摄取实时数据:使用 Azure Event Hubs 或 Azure IoT Hub 摄取实时数据流。
- 流式分析处理:使用 Azure Stream Analytics 执行实时转换与聚合。
- 加载至 Synapse:将处理后的数据加载到 SQL Pool 或 Data Lake Storage,用于实时分析。
如何在 Synapse Analytics 中确保数据安全?
在 Synapse Analytics 中确保数据安全至关重要,以保护敏感信息并满足合规要求。可实施以下关键策略以保障 Synapse 环境中的数据安全:
- 访问控制:实施基于角色的访问控制(RBAC),管理对 Synapse 资源的访问。
- 数据 加密:启用静态与传输中加密,并使用 Azure Key Vault 管理密钥。
- 网络 安全:使用虚拟网络(VNet)集成与专用终结点,保障网络访问安全。
- 审计:启用审计以跟踪用户活动与数据访问。
- 数据脱敏:实施数据脱敏以保护敏感数据。
结语
无论您是数据工程师还是软件工程师,本指南都为您自信迎战 Microsoft Synapse Analytics 面试提供了关键要点。
请务必展示您的理论理解与实践经验,包括数据管道设计、性能优化与稳健的数据安全保障。
除技术之外,也要凸显您的问题解决能力与持续学习能力。Synapse Analytics 平台迭代迅速,请保持好奇心,多探索微软资源,并展现您以数据驱动业务成效的热情。祝您好运!


Microsoft Synapse Analytics(前称 Azure SQL Data Warehouse)是一项集成分析服务,为大数据与数据仓库提供统一平台。
通过无缝融合企业数据仓库与大数据分析,Synapse 让用户能够摄取、准备、管理并提供数据,以满足即时的商业智能与机器学习需求。此强大的服务支持 SQL、Python 和 Spark 等多种语言,覆盖广泛的数据处理与转换能力。此外,其无服务器架构可按需扩展以处理任何规模的数据,成为现代数据从业者不可或缺的工具。
本指南汇总了帮助您准备 Synapse 面试的重点主题与问题。这些问题来自我在面试和与使用 Synapse 的数据专业人士合作时的亲身经验,能为您提供招聘经理关注点的实用洞察。
除阅读本面试指南外,建议您浏览Microsoft Azure Synapse Analytics 文档,以解答准备过程中遇到的具体问题。
基础类 Synapse 面试题
基础层面的问题会考察您对 Synapse 的入门认知,包括在 Synapse Studio 中的导航、核心组件理解以及简单的数据探索。如果您 Synapse 经验有限,或面试官在评估您的基本理解能力,请预期这些问题。
您应熟悉哪些关键主题?
若被要求做 Synapse 的高层概述,您应能说明 Synapse Analytics 及其在现代数据版图中的角色。
什么是 Microsoft Synapse Analytics?它有哪些关键特性?
Synapse Analytics 是一项“无限制”的分析服务,整合了企业数据仓库与大数据分析。其关键特性包括:
请解释 Synapse Analytics 的核心架构。
核心架构包括:
如何在 Synapse Analytics 中查询数据?
您可以通过以下方式在 Synapse 中查询数据:
进阶类 Synapse 面试题
这些问题评估您对 Synapse 及其配置的更深入理解。您需要展示管理资源、实现数据处理工作流与优化性能的能力。
在基础知识之上,您还需理解:
如何在 Synapse Analytics 中创建和管理 SQL Pool?
要创建 SQL Pool,进入 Synapse Studio,选择“Manage”工作区,再选择“SQL pools”。随后可根据工作负载需求配置池的性能级别(Data Warehouse Units - DWUs)。
管理工作包括监控性能、扩缩资源,以及按需暂停/恢复池。
请解释 Spark 在 Synapse Analytics 中的用法。
Synapse 通过 Spark Pool 以服务形式提供 Apache Spark,这使您可以:
什么是数据管道?如何在 Synapse 中创建?
数据管道是用于数据摄取、转换与加载的自动化工作流。在 Synapse 中,您可在“Integrate”工作区使用可视化界面(Azure Data Factory)设计与管理管道。
这些管道可连接多种数据源,利用数据流或存储过程执行等活动完成转换,并将数据加载至目标系统。
如何在 Synapse Analytics 中监控与管理资源?
您可通过 Synapse Studio 中的“Monitor”工作区监控资源。该工作区提供对 SQL Pool 与 Spark Pool 性能、管道执行以及整体系统健康状况的洞察。您还可使用 Azure Monitor 获取更详细的监控与告警能力。
请描述 Synapse Analytics 中可用的数据存储选项。
Synapse Analytics 提供多种数据存储选项,以适配不同需求与场景,确保在处理多样化数据集时的灵活与高效。这些选项包括:
高级类 Synapse 面试题
高级用户需要能够进行性能优化、构建复杂工作流,并实施复杂的分析与机器学习模型。这类问题常见于资深数据岗位或包含 DevOps 职能的角色。
在基础与进阶知识之上,要求具备以下实践经验:
在 Synapse 中,您采用哪些性能优化策略?
正确的索引:通过使用聚集列存储索引与合适的非聚集索引优化 SQL Pool 性能。
如何为 Synapse Analytics 实现 CI/CD 管道?
使用 Azure DevOps 或 GitHub Actions 自动化 Synapse 解决方案的构建、测试与部署。这包括:
如何在 Synapse Analytics 中处理复杂分析?
在 Synapse Analytics 中处理复杂分析、确保数据操作顺畅需要多管齐下,包括自动化测试、部署策略与高级分析技术。
下列方法是有效实现上述目标的关键:
如何在 Synapse Analytics 中部署机器学习模型?
在 Synapse Analytics 中部署机器学习模型需经历多个关键步骤,从训练与注册到实际部署。以下是成功部署模型的结构化路径:
面向数据工程师岗位的 Synapse 面试题
数据工程师负责设计、构建与维护数据管道,确保数据质量并优化性能。针对以 Synapse 为重点的数据工程师职位,您应理解:
如何在 Synapse Analytics 中设计数据管道?
在 Synapse Analytics 中设计数据管道时,需要考虑多个关键要素以确保高效且可靠的数据处理:
在 Synapse Analytics 中开展 ETL 的最佳实践有哪些?
在 Synapse Analytics 语境下,实施高效的 ETL(抽取、转换、加载)流程对数据管理与分析至关重要。以下最佳实践有助于优化 ETL 流程:
如何在 Synapse 中处理实时数据处理?
作为数据工程师,实时数据处理充满挑战,需要创新方案与可靠方法。以下是常用的经验与技术:
如何在 Synapse Analytics 中确保数据安全?
在 Synapse Analytics 中确保数据安全至关重要,以保护敏感信息并满足合规要求。可实施以下关键策略以保障 Synapse 环境中的数据安全:
结语
无论您是数据工程师还是软件工程师,本指南都为您自信迎战 Microsoft Synapse Analytics 面试提供了关键要点。
请务必展示您的理论理解与实践经验,包括数据管道设计、性能优化与稳健的数据安全保障。
除技术之外,也要凸显您的问题解决能力与持续学习能力。Synapse Analytics 平台迭代迅速,请保持好奇心,多探索微软资源,并展现您以数据驱动业务成效的热情。祝您好运!