Microsoft Synapse Analytics, जिसे पहले Azure SQL Data Warehouse के रूप में जाना जाता था, एक एकीकृत एनालिटिक्स सेवा है जो बिग डेटा और डेटा वेयरहाउसिंग के लिए एक एकीकृत प्लेटफॉर्म प्रदान करती है।
एंटरप्राइज डेटा वेयरहाउसिंग और बिग डेटा एनालिटिक्स को सहजता से जोड़कर, Synapse उपयोगकर्ताओं को डेटा को इनजेस्ट, तैयार, प्रबंधित और सर्व करने में सक्षम बनाता है ताकि तुरंत बिज़नेस इंटेलिजेंस और मशीन लर्निंग की आवश्यकताओं को पूरा किया जा सके। यह शक्तिशाली सेवा SQL, Python और Spark जैसी कई भाषाओं का समर्थन करती है, जो व्यापक डेटा प्रोसेसिंग और ट्रांसफॉर्मेशन क्षमताएँ सक्षम करती हैं। साथ ही, इसका सर्वरलेस आर्किटेक्चर किसी भी मात्रा के डेटा को संभालने के लिए स्केलेबिलिटी सुनिश्चित करता है, जिससे यह आधुनिक डेटा प्रोफेशनल्स के लिए एक अनिवार्य उपकरण बन जाता है।
यह गाइड आपके Synapse इंटरव्यू की तैयारी में मदद के लिए आवश्यक विषयों और प्रश्नों को प्रस्तुत करती है। ये प्रश्न Synapse के साथ काम करने और इंटरव्यू लेने के मेरे अपने अनुभव को दर्शाते हैं, जो यह समझने में मूल्यवान अंतर्दृष्टि देते हैं कि हायरिंग मैनेजर क्या देखते हैं।
इस इंटरव्यू गाइड के साथ-साथ, मैं सुझाव देता/देती हूँ कि आप Microsoft Azure Synapse Analytics Documentation भी देखें ताकि रास्ते में आने वाले विशेष प्रश्नों के उत्तर मिल सकें।
बुनियादी Synapse इंटरव्यू प्रश्न
बुनियादी स्तर पर, प्रश्न आपके Synapse के आधारभूत ज्ञान को कवर करेंगे, जिनमें Synapse Studio में नेविगेट करना, इसके मुख्य घटकों को समझना और सरल डेटा एक्सप्लोरेशन करना शामिल है। यदि आपका Synapse अनुभव सीमित है या इंटरव्यूअर आपकी मूलभूत समझ का आकलन कर रहा/रही है, तो ऐसे प्रश्नों की अपेक्षा करें।
कौन-से प्रमुख विषयों से आप परिचित होने चाहिए?
यदि आपसे Synapse का उच्च-स्तरीय अवलोकन देने के लिए कहा जाए, तो आपको Synapse Analytics और आधुनिक डेटा परिदृश्य में उसकी भूमिका का वर्णन करने में सक्षम होना चाहिए।
- कोर फीचर्स और यूज़र इंटरफ़ेस: Synapse Studio, इसके विभिन्न हब (Data, Develop, Integrate, Monitor, Manage) और उनकी कार्यक्षमताओं को समझें।
- सरल उपयोग के मामले: यह बताएं कि संगठन Synapse का कैसे उपयोग करते हैं, जिसमें बुनियादी आर्किटेक्चर की झलकियाँ शामिल हों।
Microsoft Synapse Analytics क्या है, और इसकी प्रमुख विशेषताएँ क्या हैं?
Synapse Analytics एक असीमित एनालिटिक्स सेवा है जो एंटरप्राइज डेटा वेयरहाउसिंग और बिग डेटा एनालिटिक्स को एक साथ लाती है। प्रमुख विशेषताएँ शामिल हैं:
- SQL Pool (Data Warehouse): संरचित डेटा पर उच्च-प्रदर्शन एनालिटिक्स के लिए एक वितरित क्वेरी इंजन।
- Spark Pool: बिग डेटा प्रोसेसिंग और मशीन लर्निंग के लिए Apache Spark का इंटीग्रेशन।
- Data Lake Support: Azure Data Lake Storage Gen2 के साथ नेटिव इंटीग्रेशन, ताकि डेटा को वहीं विश्लेषित किया जा सके।
- Synapse Studio: डेटा तैयारी, डेटा वेयरहाउसिंग, बिग डेटा एनालिटिक्स और AI कार्यों के लिए एक एकीकृत कार्यक्षेत्र।
- Data Integration: Azure Data Factory के साथ बिल्ट-इन डेटा इंटीग्रेशन क्षमताएँ।
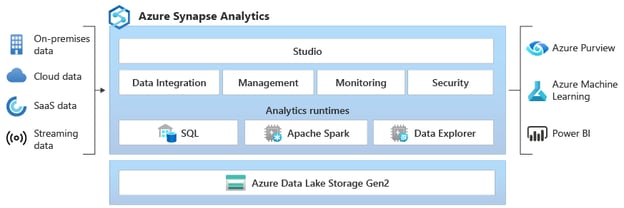
Synapse Analytics की कोर आर्किटेक्चर समझाएँ।
कोर आर्किटेक्चर में शामिल हैं:
- Synapse Studio: सभी Synapse गतिविधियों के लिए केंद्रीय UI।
- SQL Pools: संरचित डेटा के लिए T-SQL आधारित क्वेरी क्षमताएँ प्रदान करते हैं। डेडिकेटेड SQL पूल गारंटीकृत संसाधन देते हैं, जबकि सर्वरलेस SQL पूल डेटा लेक में डेटा पर ऑन-डिमांड क्वेरींग प्रदान करते हैं।
- Spark Pools: बिग डेटा प्रोसेसिंग, डेटा इंजीनियरिंग और मशीन लर्निंग कार्यों के लिए सेवा के रूप में Apache Spark प्रदान करते हैं।
- Data Lake Storage: Azure Data Lake Storage Gen2 संरचित, अर्ध-संरचित और असंरचित डेटा की बड़ी मात्रा को स्टोर करने की नींव का काम करता है।
- Pipelines: ETL/ELT प्रक्रियाओं के लिए Azure Data Factory द्वारा संचालित डेटा इंटीग्रेशन पाइपलाइन्स।
Synapse Analytics में आप डेटा को कैसे क्वेरी करते हैं?
आप Synapse में डेटा को निम्न तरीकों से क्वेरी कर सकते हैं:
- T-SQL: संरचित डेटा के लिए SQL Pool का उपयोग करके।
- Spark SQL: डेटा लेक में मौजूद डेटा के लिए Spark Pools का उपयोग करके।
- Serverless SQL Pool: बिना संसाधन प्रोविज़न किए, T-SQL के साथ डेटा लेक में सीधे डेटा को क्वेरी करें।
मध्यम-स्तरीय Synapse इंटरव्यू प्रश्न
ये प्रश्न Synapse और उसकी कॉन्फ़िगरेशन की आपकी गहरी समझ का आकलन करते हैं। आपको संसाधनों का प्रबंधन करने, डेटा प्रोसेसिंग वर्कफ़्लो लागू करने और प्रदर्शन को अनुकूलित करने की क्षमता दिखानी होगी।
यह आपके बुनियादी ज्ञान पर आधारित है और इसके लिए इनकी समझ आवश्यक है:
- रिसोर्स मैनेजमेंट: SQL Pools और Spark Pools को प्रोविज़न और प्रबंधित कैसे करें।
- डेटा इंटीग्रेशन: Synapse Pipelines (Azure Data Factory) का उपयोग करके डेटा पाइपलाइन्स बनाना और प्रबंधित करना।
- परफॉर्मेंस ट्यूनिंग: क्वेरी ऑप्टिमाइज़ेशन तकनीकों और डेटा पार्टिशनिंग रणनीतियों की समझ।
Synapse Analytics में आप SQL Pools कैसे बनाते और प्रबंधित करते हैं?
SQL Pool बनाने के लिए, आप Synapse Studio में जाएँ, "Manage" हब चुनें, और फिर "SQL pools" पर जाएँ। इसके बाद आप अपने वर्कलोड आवश्यकताओं के आधार पर पूल के प्रदर्शन स्तर (Data Warehouse Units - DWUs) को कॉन्फ़िगर कर सकते हैं।
प्रबंधन में प्रदर्शन की मॉनिटरिंग, संसाधनों का स्केल करना, और आवश्यकता अनुसार पूल को रोकना/फिर शुरू करना शामिल है।
Synapse Analytics में Spark का उपयोग कैसे होता है?
Synapse, Spark Pools के माध्यम से सेवा के रूप में Apache Spark प्रदान करता है। इससे आप निम्न कर सकते हैं:
- Spark DataFrames का उपयोग करके बड़े डेटासेट प्रोसेस करना।
- Python, Scala, और Java जैसी भाषाओं के साथ डेटा इंजीनियरिंग कार्य करना।
- Spark MLlib का उपयोग करके मशीन लर्निंग मॉडल बनाना और ट्रेन करना।
डेटा पाइपलाइन्स क्या हैं, और आप Synapse में उन्हें कैसे बनाते हैं?
डेटा पाइपलाइन्स डेटा इनजेशन, ट्रांसफॉर्मेशन और लोडिंग के लिए स्वचालित वर्कफ़्लो होते हैं। Synapse में, आप "Integrate" हब का उपयोग करके इन्हें बनाते हैं, जो पाइपलाइन्स को डिज़ाइन और प्रबंधित करने के लिए एक विज़ुअल इंटरफ़ेस (Azure Data Factory) प्रदान करता है।
ये पाइपलाइन्स विभिन्न डेटा सोर्सेज़ से कनेक्ट हो सकती हैं, डेटा फ्लो या स्टोरड प्रोसीजर एक्ज़िक्यूशन जैसी गतिविधियों के माध्यम से ट्रांसफॉर्मेशन कर सकती हैं, और डेटा को लक्ष्य प्रणालियों में लोड कर सकती हैं।
Synapse Analytics में आप संसाधनों की मॉनिटरिंग और प्रबंधन कैसे करते हैं?
आप Synapse Studio के "Monitor" हब के माध्यम से संसाधनों की मॉनिटरिंग कर सकते हैं। यह हब SQL Pool और Spark Pool के प्रदर्शन, पाइपलाइन एक्ज़िक्यूशंस और संपूर्ण सिस्टम हेल्थ की जानकारी देता है। अधिक विस्तृत मॉनिटरिंग और अलर्टिंग क्षमताओं के लिए आप Azure Monitor का भी उपयोग कर सकते हैं।
Synapse Analytics में उपलब्ध डेटा स्टोरेज विकल्पों का वर्णन करें?
Synapse Analytics विविध आवश्यकताओं और परिदृश्यों के अनुरूप विभिन्न डेटा स्टोरेज विकल्प प्रदान करता है, जिससे विविध डेटासेट्स को संभालने में लचीलापन और दक्षता मिलती है। इनमें शामिल हैं:
- Azure Data Lake Storage Gen2: डेटा लेक के लिए प्राथमिक स्टोरेज, बड़े पैमाने के एनालिटिक्स के लिए अनुकूलित।
- SQL pool storage: डेटा वेयरहाउस के भीतर संरचित डेटा को स्टोर करता है।
- Azure Blob Storage: डेटा स्टोर करने के लिए उपयोग किया जा सकता है, हालाँकि एनालिटिक्स वर्कलोड्स के लिए आमतौर पर Data Lake Storage Gen2 को प्राथमिकता दी जाती है।
उन्नत Synapse इंटरव्यू प्रश्न
एडवांस्ड उपयोगकर्ताओं से प्रदर्शन अनुकूलन संभालने, जटिल वर्कफ़्लो बनाने और परिष्कृत एनालिटिक्स व मशीन लर्निंग मॉडल लागू करने की अपेक्षा की जाती है। ये प्रश्न आमतौर पर सीनियर डेटा पदों या DevOps घटक वाली भूमिकाओं के लिए होते हैं।
यह बुनियादी और मध्यम-स्तरीय ज्ञान पर आधारित है, और निम्न में व्यावहारिक अनुभव की आवश्यकता होती है:
- प्रदर्शन अनुकूलन: SQL Pool और Spark Pool कॉन्फ़िगरेशन ट्यून करना, क्वेरीज़ को ऑप्टिमाइज़ करना, और डेटा पार्टिशनिंग प्रबंधन।
- मशीन लर्निंग: Synapse को Azure Machine Learning के साथ एकीकृत करना, मॉडल तैनात करना और मॉडल जीवनचक्र प्रबंधन।
- CI/CD पाइपलाइन्स: Synapse समाधानों के लिए सतत एकीकरण और सतत परिनियोजन लागू करना।
Synapse में प्रदर्शन अनुकूलन के लिए आप कौन-सी रणनीतियाँ अपनाते हैं?
उचित इंडेक्सिंग: क्लस्टर्ड कॉलमनस्टोर इंडेक्स और उपयुक्त नॉन-क्लस्टर्ड इंडेक्स का उपयोग करके SQL Pool के प्रदर्शन को ऑप्टिमाइज़ करें।
- डेटा पार्टिशनिंग: प्रदर्शन सुधारने के लिए क्वेरी पैटर्न के आधार पर SQL Pools और Data Lake Storage में डेटा को पार्टिशन करें।
- क्वेरी ऑप्टिमाइज़ेशन: क्वेरी हिंट्स का उपयोग करें, जटिल क्वेरियों को पुनर्लेखित करें, और बाधाओं की पहचान करने के लिए क्वेरी एक्ज़िक्यूशन प्लान का विश्लेषण करें।
- संसाधन आवंटन: वर्कलोड आवश्यकताओं के आधार पर SQL Pools और Spark Pools का सही आकार तय करें।
Synapse Analytics के लिए CI/CD पाइपलाइन्स आप कैसे लागू कर सकते हैं?
Azure DevOps या GitHub Actions का उपयोग करके Synapse समाधानों के बिल्ड, टेस्ट और डिप्लॉयमेंट को स्वचालित करें। इसमें शामिल हैं:
- सोर्स कंट्रोल: Synapse आर्टिफैक्ट्स (SQL स्क्रिप्ट्स, Spark नोटबुक्स, पाइपलाइन्स) को वर्ज़न कंट्रोल सिस्टम में स्टोर करें।
- स्वचालित परीक्षण: SQL स्क्रिप्ट्स और डेटा पाइपलाइन्स के लिए यूनिट और इंटीग्रेशन टेस्ट लागू करें।
- स्वचालित परिनियोजन: विभिन्न परिवेशों (dev, test, prod) में बदलाव डिप्लॉय करने के लिए Azure Resource Manager (ARM) टेम्पलेट्स या Synapse APIs का उपयोग करें।
Synapse Analytics में जटिल एनालिटिक्स को कैसे संभालते हैं?
Synapse Analytics के भीतर जटिल एनालिटिक्स को संभालना और निर्बाध डेटा संचालन सुनिश्चित करना बहुआयामी दृष्टिकोण मांगता है। इसमें स्वचालित परीक्षण, परिनियोजन रणनीतियाँ और उन्नत विश्लेषण तकनीकें शामिल हैं।
नीचे, आप इन लक्ष्यों को प्रभावी ढंग से प्राप्त करने के आवश्यक तरीकों को पाएँगे:
- एडवांस्ड SQL क्वेरियाँ: SQL Pools में जटिल डेटा विश्लेषण के लिए विंडो फ़ंक्शंस, कॉमन टेबल एक्सप्रेशंस (CTEs) और अन्य उन्नत T-SQL सुविधाओं का उपयोग करें।
- बिग डेटा प्रोसेसिंग के लिए Spark: बड़े डेटासेट प्रोसेस करने, जटिल ट्रांसफॉर्मेशन करने और मशीन लर्निंग मॉडल बनाने के लिए Spark Pools का उपयोग करें।
- Azure Machine Learning के साथ इंटीग्रेशन: प्रेडिक्टिव मॉडलिंग और विसंगति जाँच जैसे उन्नत एनालिटिक्स परिदृश्यों के लिए Azure Machine Learning का लाभ उठाएँ।
Synapse Analytics में मशीन लर्निंग मॉडल्स को आप कैसे डिप्लॉय करते हैं?
Synapse Analytics में मशीन लर्निंग मॉडल्स को डिप्लॉय करना कई प्रमुख चरणों में होता है—मॉडल्स को ट्रेन और रजिस्टर करने से लेकर उन्हें व्यावहारिक उपयोग के लिए तैनात करने तक। यहाँ सफलतापूर्वक मशीन लर्निंग मॉडल्स डिप्लॉय करने का एक संरचित तरीका है:
- मॉडल्स को ट्रेन करें: Synapse में Spark MLlib या Azure Machine Learning का उपयोग करके मशीन लर्निंग मॉडल्स को ट्रेन करें।
- मॉडल्स को रजिस्टर करें: प्रशिक्षित मॉडल्स को Azure Machine Learning Model Registry में रजिस्टर करें।
- मॉडल्स को डिप्लॉय करें: Azure Machine Learning का उपयोग करके मॉडल्स को REST एंडपॉइंट्स के रूप में डिप्लॉय करें या बैच स्कोरिंग के लिए उन्हें Synapse पाइपलाइन्स में इंटीग्रेट करें।
डेटा इंजीनियर भूमिकाओं के लिए Synapse इंटरव्यू प्रश्न
डेटा इंजीनियर्स, डेटा पाइपलाइन्स को डिज़ाइन, बनाना और मेंटेन करने, डेटा गुणवत्ता सुनिश्चित करने और प्रदर्शन को अनुकूलित करने के लिए ज़िम्मेदार होते हैं। Synapse पर केंद्रित डेटा इंजीनियर पदों के लिए, आपको इन बातों की समझ होनी चाहिए:
- डेटा पाइपलाइन आर्किटेक्चर: ETL/ELT प्रक्रियाओं के लिए स्केलेबल और विश्वसनीय डेटा पाइपलाइन्स डिज़ाइन करें।
- रीयल-टाइम प्रोसेसिंग: Azure Event Hubs, Azure Stream Analytics और Synapse का उपयोग करके रीयल-टाइम डेटा इनजेशन और प्रोसेसिंग लागू करें।
- डेटा सुरक्षा: स्थिर और संचरण में डेटा की सुरक्षा के लिए उपाय लागू करें।
Synapse Analytics में आप डेटा पाइपलाइन्स कैसे डिज़ाइन करते हैं?
Synapse Analytics में डेटा पाइपलाइन्स डिज़ाइन करते समय, कुशल और विश्वसनीय डेटा प्रोसेसिंग सुनिश्चित करने के लिए कई प्रमुख घटकों पर विचार करना आवश्यक है:
- डेटा सोर्सेज़ की पहचान करें: डेटा सोर्सेज़ (जैसे, डेटाबेस, APIs, फ़ाइलें) और उनकी इनजेशन विधियों को निर्धारित करें।
- ETL/ELT प्रक्रियाओं को डिज़ाइन करें: डेटा निकालने, ट्रांसफॉर्म करने और लोड करने के लिए Synapse Pipelines (Azure Data Factory) का उपयोग करें।
- डेटा गुणवत्ता जाँच लागू करें: डेटा वैलिडेशन और एरर हैंडलिंग चरण जोड़ें ताकि डेटा गुणवत्ता सुनिश्चित हो।
- पाइपलाइन एक्ज़िक्यूशन को स्वचालित करें: ट्रिगर्स और अनुसूची-आधारित एक्ज़िक्यूशन का उपयोग करके पाइपलाइन्स को स्वतः चलने के लिए शेड्यूल करें।
Synapse Analytics में ETL प्रक्रियाओं के लिए सर्वोत्तम प्रथाएँ क्या हैं?
Synapse Analytics के संदर्भ में, प्रभावी ETL (Extract, Transform, Load) प्रक्रियाएँ लागू करना कुशल डेटा प्रबंधन और एनालिटिक्स के लिए महत्वपूर्ण है। Synapse Analytics के भीतर ETL प्रक्रियाओं को ऑप्टिमाइज़ करने के लिए निम्न सर्वोत्तम प्रथाओं की अनुशंसा की जाती है:
- Delta Lake का उपयोग करें: डेटा लेक में डेटा स्टोर करने के लिए Delta Lake का उपयोग करें ताकि ACID ट्रांज़ैक्शंस और डेटा वर्ज़निंग सक्षम हो।
- मॉड्यूलर कोड: Synapse नोटबुक्स और SQL स्क्रिप्ट्स में मॉड्यूलर और पुन: प्रयोज्य कोड लिखें।
- पैरामीटराइज़ेशन: पाइपलाइन्स और SQL स्क्रिप्ट्स को पैरामीटराइज़ करें ताकि वे अधिक लचीली और पुन: प्रयोज्य बनें।
- मॉनिटरिंग: Synapse Studio और Azure Monitor का उपयोग करके पाइपलाइन एक्ज़िक्यूशंस और प्रदर्शन की निगरानी करें।
आप Synapse में रीयल-टाइम डेटा प्रोसेसिंग कैसे संभालते हैं?
एक डेटा इंजीनियर के रूप में, कई चुनौतियाँ सामने आती हैं जिनके लिए नवोन्मेषी समाधान और मजबूत कार्यप्रणालियाँ चाहिए होती हैं। रीयल-टाइम डेटा के साथ काम करना और उसे संभालना उनमें से एक है। यहाँ कुछ अनुभव और आम तौर पर अपनाई जाने वाली तकनीकें दी गई हैं:
- रीयल-टाइम डेटा इनजेस्ट करें: रीयल-टाइम डेटा स्ट्रीम्स को इनजेस्ट करने के लिए Azure Event Hubs या Azure IoT Hub का उपयोग करें।
- Stream Analytics से डेटा प्रोसेस करें: रीयल-टाइम ट्रांसफॉर्मेशन और एग्रीगेशन करने के लिए Azure Stream Analytics का उपयोग करें।
- डेटा को Synapse में लोड करें: रीयल-टाइम एनालिटिक्स के लिए प्रोसेस्ड डेटा को SQL Pools या Data Lake Storage में लोड करें।
Synapse Analytics में आप डेटा सुरक्षा कैसे सुनिश्चित करते हैं?
Synapse Analytics में डेटा सुरक्षा सुनिश्चित करना संवेदनशील जानकारी की रक्षा करने और नियामक मानकों के अनुपालन को बनाए रखने के लिए अत्यंत महत्वपूर्ण है। Synapse वातावरण के भीतर डेटा को सुरक्षित रखने के लिए कई प्रमुख रणनीतियाँ लागू की जा सकती हैं:
- एक्सेस कंट्रोल: Synapse संसाधनों तक पहुँच प्रबंधित करने के लिए भूमिका-आधारित एक्सेस कंट्रोल (RBAC) लागू करें।
- डेटा एन्क्रिप्शन: Azure Key Vault का उपयोग करके स्थिर और संचरण में एन्क्रिप्शन सक्षम करें।
- नेटवर्क सुरक्षा: नेटवर्क एक्सेस को सुरक्षित करने के लिए वर्चुअल नेटवर्क (VNet) इंटीग्रेशन और प्राइवेट एंडपॉइंट्स का उपयोग करें।
- ऑडिटिंग: उपयोगकर्ता गतिविधि और डेटा एक्सेस को ट्रैक करने के लिए ऑडिटिंग सक्षम करें।
- डेटा मास्किंग: संवेदनशील डेटा की सुरक्षा के लिए डेटा मास्किंग लागू करें।
अंतिम विचार
यह गाइड आपको Microsoft Synapse Analytics इंटरव्यू को आत्मविश्वास के साथ देने के लिए प्रमुख अंतर्दृष्टियों से लैस करती है, चाहे आप डेटा इंजीनियर हों या सॉफ्टवेयर इंजीनियर।
ध्यान रखें कि आप अपने सैद्धांतिक ज्ञान के साथ-साथ डेटा पाइपलाइन्स डिज़ाइन करने, प्रदर्शन को अनुकूलित करने और मज़बूत डेटा सुरक्षा सुनिश्चित करने के व्यावहारिक अनुभव को भी प्रदर्शित करें।
तकनीकी पहलुओं से आगे, अपनी समस्या-समाधान क्षमता और निरंतर सीखने की योग्यता को उजागर करें, क्योंकि Synapse Analytics एक तेजी से विकसित होने वाला प्लेटफ़ॉर्म है। उत्सुक बने रहें, Microsoft के संसाधनों का अन्वेषण करते रहें, और यह दिखाएँ कि आप डेटा का उपयोग प्रभावशाली व्यावसायिक परिणाम दिलाने के लिए कैसे करते हैं। शुभकामनाएँ!


Microsoft Synapse Analytics, जिसे पहले Azure SQL Data Warehouse के रूप में जाना जाता था, एक एकीकृत एनालिटिक्स सेवा है जो बिग डेटा और डेटा वेयरहाउसिंग के लिए एक एकीकृत प्लेटफॉर्म प्रदान करती है।
एंटरप्राइज डेटा वेयरहाउसिंग और बिग डेटा एनालिटिक्स को सहजता से जोड़कर, Synapse उपयोगकर्ताओं को डेटा को इनजेस्ट, तैयार, प्रबंधित और सर्व करने में सक्षम बनाता है ताकि तुरंत बिज़नेस इंटेलिजेंस और मशीन लर्निंग की आवश्यकताओं को पूरा किया जा सके। यह शक्तिशाली सेवा SQL, Python और Spark जैसी कई भाषाओं का समर्थन करती है, जो व्यापक डेटा प्रोसेसिंग और ट्रांसफॉर्मेशन क्षमताएँ सक्षम करती हैं। साथ ही, इसका सर्वरलेस आर्किटेक्चर किसी भी मात्रा के डेटा को संभालने के लिए स्केलेबिलिटी सुनिश्चित करता है, जिससे यह आधुनिक डेटा प्रोफेशनल्स के लिए एक अनिवार्य उपकरण बन जाता है।
यह गाइड आपके Synapse इंटरव्यू की तैयारी में मदद के लिए आवश्यक विषयों और प्रश्नों को प्रस्तुत करती है। ये प्रश्न Synapse के साथ काम करने और इंटरव्यू लेने के मेरे अपने अनुभव को दर्शाते हैं, जो यह समझने में मूल्यवान अंतर्दृष्टि देते हैं कि हायरिंग मैनेजर क्या देखते हैं।
इस इंटरव्यू गाइड के साथ-साथ, मैं सुझाव देता/देती हूँ कि आप Microsoft Azure Synapse Analytics Documentation भी देखें ताकि रास्ते में आने वाले विशेष प्रश्नों के उत्तर मिल सकें।
बुनियादी Synapse इंटरव्यू प्रश्न
बुनियादी स्तर पर, प्रश्न आपके Synapse के आधारभूत ज्ञान को कवर करेंगे, जिनमें Synapse Studio में नेविगेट करना, इसके मुख्य घटकों को समझना और सरल डेटा एक्सप्लोरेशन करना शामिल है। यदि आपका Synapse अनुभव सीमित है या इंटरव्यूअर आपकी मूलभूत समझ का आकलन कर रहा/रही है, तो ऐसे प्रश्नों की अपेक्षा करें।
कौन-से प्रमुख विषयों से आप परिचित होने चाहिए?
यदि आपसे Synapse का उच्च-स्तरीय अवलोकन देने के लिए कहा जाए, तो आपको Synapse Analytics और आधुनिक डेटा परिदृश्य में उसकी भूमिका का वर्णन करने में सक्षम होना चाहिए।
Microsoft Synapse Analytics क्या है, और इसकी प्रमुख विशेषताएँ क्या हैं?
Synapse Analytics एक असीमित एनालिटिक्स सेवा है जो एंटरप्राइज डेटा वेयरहाउसिंग और बिग डेटा एनालिटिक्स को एक साथ लाती है। प्रमुख विशेषताएँ शामिल हैं:
Synapse Analytics की कोर आर्किटेक्चर समझाएँ।
कोर आर्किटेक्चर में शामिल हैं:
Synapse Analytics में आप डेटा को कैसे क्वेरी करते हैं?
आप Synapse में डेटा को निम्न तरीकों से क्वेरी कर सकते हैं:
मध्यम-स्तरीय Synapse इंटरव्यू प्रश्न
ये प्रश्न Synapse और उसकी कॉन्फ़िगरेशन की आपकी गहरी समझ का आकलन करते हैं। आपको संसाधनों का प्रबंधन करने, डेटा प्रोसेसिंग वर्कफ़्लो लागू करने और प्रदर्शन को अनुकूलित करने की क्षमता दिखानी होगी।
यह आपके बुनियादी ज्ञान पर आधारित है और इसके लिए इनकी समझ आवश्यक है:
Synapse Analytics में आप SQL Pools कैसे बनाते और प्रबंधित करते हैं?
SQL Pool बनाने के लिए, आप Synapse Studio में जाएँ, "Manage" हब चुनें, और फिर "SQL pools" पर जाएँ। इसके बाद आप अपने वर्कलोड आवश्यकताओं के आधार पर पूल के प्रदर्शन स्तर (Data Warehouse Units - DWUs) को कॉन्फ़िगर कर सकते हैं।
प्रबंधन में प्रदर्शन की मॉनिटरिंग, संसाधनों का स्केल करना, और आवश्यकता अनुसार पूल को रोकना/फिर शुरू करना शामिल है।
Synapse Analytics में Spark का उपयोग कैसे होता है?
Synapse, Spark Pools के माध्यम से सेवा के रूप में Apache Spark प्रदान करता है। इससे आप निम्न कर सकते हैं:
डेटा पाइपलाइन्स क्या हैं, और आप Synapse में उन्हें कैसे बनाते हैं?
डेटा पाइपलाइन्स डेटा इनजेशन, ट्रांसफॉर्मेशन और लोडिंग के लिए स्वचालित वर्कफ़्लो होते हैं। Synapse में, आप "Integrate" हब का उपयोग करके इन्हें बनाते हैं, जो पाइपलाइन्स को डिज़ाइन और प्रबंधित करने के लिए एक विज़ुअल इंटरफ़ेस (Azure Data Factory) प्रदान करता है।
ये पाइपलाइन्स विभिन्न डेटा सोर्सेज़ से कनेक्ट हो सकती हैं, डेटा फ्लो या स्टोरड प्रोसीजर एक्ज़िक्यूशन जैसी गतिविधियों के माध्यम से ट्रांसफॉर्मेशन कर सकती हैं, और डेटा को लक्ष्य प्रणालियों में लोड कर सकती हैं।
Synapse Analytics में आप संसाधनों की मॉनिटरिंग और प्रबंधन कैसे करते हैं?
आप Synapse Studio के "Monitor" हब के माध्यम से संसाधनों की मॉनिटरिंग कर सकते हैं। यह हब SQL Pool और Spark Pool के प्रदर्शन, पाइपलाइन एक्ज़िक्यूशंस और संपूर्ण सिस्टम हेल्थ की जानकारी देता है। अधिक विस्तृत मॉनिटरिंग और अलर्टिंग क्षमताओं के लिए आप Azure Monitor का भी उपयोग कर सकते हैं।
Synapse Analytics में उपलब्ध डेटा स्टोरेज विकल्पों का वर्णन करें?
Synapse Analytics विविध आवश्यकताओं और परिदृश्यों के अनुरूप विभिन्न डेटा स्टोरेज विकल्प प्रदान करता है, जिससे विविध डेटासेट्स को संभालने में लचीलापन और दक्षता मिलती है। इनमें शामिल हैं:
उन्नत Synapse इंटरव्यू प्रश्न
एडवांस्ड उपयोगकर्ताओं से प्रदर्शन अनुकूलन संभालने, जटिल वर्कफ़्लो बनाने और परिष्कृत एनालिटिक्स व मशीन लर्निंग मॉडल लागू करने की अपेक्षा की जाती है। ये प्रश्न आमतौर पर सीनियर डेटा पदों या DevOps घटक वाली भूमिकाओं के लिए होते हैं।
यह बुनियादी और मध्यम-स्तरीय ज्ञान पर आधारित है, और निम्न में व्यावहारिक अनुभव की आवश्यकता होती है:
Synapse में प्रदर्शन अनुकूलन के लिए आप कौन-सी रणनीतियाँ अपनाते हैं?
उचित इंडेक्सिंग: क्लस्टर्ड कॉलमनस्टोर इंडेक्स और उपयुक्त नॉन-क्लस्टर्ड इंडेक्स का उपयोग करके SQL Pool के प्रदर्शन को ऑप्टिमाइज़ करें।
Synapse Analytics के लिए CI/CD पाइपलाइन्स आप कैसे लागू कर सकते हैं?
Azure DevOps या GitHub Actions का उपयोग करके Synapse समाधानों के बिल्ड, टेस्ट और डिप्लॉयमेंट को स्वचालित करें। इसमें शामिल हैं:
Synapse Analytics में जटिल एनालिटिक्स को कैसे संभालते हैं?
Synapse Analytics के भीतर जटिल एनालिटिक्स को संभालना और निर्बाध डेटा संचालन सुनिश्चित करना बहुआयामी दृष्टिकोण मांगता है। इसमें स्वचालित परीक्षण, परिनियोजन रणनीतियाँ और उन्नत विश्लेषण तकनीकें शामिल हैं।
नीचे, आप इन लक्ष्यों को प्रभावी ढंग से प्राप्त करने के आवश्यक तरीकों को पाएँगे:
Synapse Analytics में मशीन लर्निंग मॉडल्स को आप कैसे डिप्लॉय करते हैं?
Synapse Analytics में मशीन लर्निंग मॉडल्स को डिप्लॉय करना कई प्रमुख चरणों में होता है—मॉडल्स को ट्रेन और रजिस्टर करने से लेकर उन्हें व्यावहारिक उपयोग के लिए तैनात करने तक। यहाँ सफलतापूर्वक मशीन लर्निंग मॉडल्स डिप्लॉय करने का एक संरचित तरीका है:
डेटा इंजीनियर भूमिकाओं के लिए Synapse इंटरव्यू प्रश्न
डेटा इंजीनियर्स, डेटा पाइपलाइन्स को डिज़ाइन, बनाना और मेंटेन करने, डेटा गुणवत्ता सुनिश्चित करने और प्रदर्शन को अनुकूलित करने के लिए ज़िम्मेदार होते हैं। Synapse पर केंद्रित डेटा इंजीनियर पदों के लिए, आपको इन बातों की समझ होनी चाहिए:
Synapse Analytics में आप डेटा पाइपलाइन्स कैसे डिज़ाइन करते हैं?
Synapse Analytics में डेटा पाइपलाइन्स डिज़ाइन करते समय, कुशल और विश्वसनीय डेटा प्रोसेसिंग सुनिश्चित करने के लिए कई प्रमुख घटकों पर विचार करना आवश्यक है:
Synapse Analytics में ETL प्रक्रियाओं के लिए सर्वोत्तम प्रथाएँ क्या हैं?
Synapse Analytics के संदर्भ में, प्रभावी ETL (Extract, Transform, Load) प्रक्रियाएँ लागू करना कुशल डेटा प्रबंधन और एनालिटिक्स के लिए महत्वपूर्ण है। Synapse Analytics के भीतर ETL प्रक्रियाओं को ऑप्टिमाइज़ करने के लिए निम्न सर्वोत्तम प्रथाओं की अनुशंसा की जाती है:
आप Synapse में रीयल-टाइम डेटा प्रोसेसिंग कैसे संभालते हैं?
एक डेटा इंजीनियर के रूप में, कई चुनौतियाँ सामने आती हैं जिनके लिए नवोन्मेषी समाधान और मजबूत कार्यप्रणालियाँ चाहिए होती हैं। रीयल-टाइम डेटा के साथ काम करना और उसे संभालना उनमें से एक है। यहाँ कुछ अनुभव और आम तौर पर अपनाई जाने वाली तकनीकें दी गई हैं:
Synapse Analytics में आप डेटा सुरक्षा कैसे सुनिश्चित करते हैं?
Synapse Analytics में डेटा सुरक्षा सुनिश्चित करना संवेदनशील जानकारी की रक्षा करने और नियामक मानकों के अनुपालन को बनाए रखने के लिए अत्यंत महत्वपूर्ण है। Synapse वातावरण के भीतर डेटा को सुरक्षित रखने के लिए कई प्रमुख रणनीतियाँ लागू की जा सकती हैं:
अंतिम विचार
यह गाइड आपको Microsoft Synapse Analytics इंटरव्यू को आत्मविश्वास के साथ देने के लिए प्रमुख अंतर्दृष्टियों से लैस करती है, चाहे आप डेटा इंजीनियर हों या सॉफ्टवेयर इंजीनियर।
ध्यान रखें कि आप अपने सैद्धांतिक ज्ञान के साथ-साथ डेटा पाइपलाइन्स डिज़ाइन करने, प्रदर्शन को अनुकूलित करने और मज़बूत डेटा सुरक्षा सुनिश्चित करने के व्यावहारिक अनुभव को भी प्रदर्शित करें।
तकनीकी पहलुओं से आगे, अपनी समस्या-समाधान क्षमता और निरंतर सीखने की योग्यता को उजागर करें, क्योंकि Synapse Analytics एक तेजी से विकसित होने वाला प्लेटफ़ॉर्म है। उत्सुक बने रहें, Microsoft के संसाधनों का अन्वेषण करते रहें, और यह दिखाएँ कि आप डेटा का उपयोग प्रभावशाली व्यावसायिक परिणाम दिलाने के लिए कैसे करते हैं। शुभकामनाएँ!