Microsoft Synapse Analytics, sebelumnya dikenal sebagai Azure SQL Data Warehouse, adalah layanan analitik terpadu yang menawarkan platform menyeluruh untuk big data dan data warehousing.
Dengan menggabungkan data warehousing tingkat enterprise dan analitik big data secara mulus, Synapse memungkinkan pengguna untuk mengakuisisi, menyiapkan, mengelola, dan menyajikan data untuk kebutuhan business intelligence dan machine learning secara langsung. Layanan yang kuat ini mendukung berbagai bahasa seperti SQL, Python, dan Spark, sehingga memungkinkan beragam kemampuan pemrosesan dan transformasi data. Selain itu, arsitektur serverless-nya memastikan skalabilitas untuk menangani volume data berapa pun, menjadikannya alat yang tak tergantikan bagi para profesional data modern.
Panduan ini menghadirkan topik dan pertanyaan penting untuk membantu Anda mempersiapkan wawancara Synapse. Pertanyaan-pertanyaan ini mencerminkan pengalaman saya sendiri dalam mewawancarai dan bekerja dengan profesional data yang menggunakan Synapse, memberikan wawasan berharga tentang apa yang dicari oleh manajer perekrutan.
Selain mempelajari panduan wawancara ini, saya menyarankan Anda menelusuri Dokumentasi Microsoft Azure Synapse Analytics untuk pertanyaan spesifik yang mungkin Anda miliki selama proses persiapan.
Pertanyaan Wawancara Synapse Dasar
Pada tingkat dasar, pertanyaan akan mencakup pengetahuan fundamental Anda tentang Synapse, termasuk tugas seperti menavigasi Synapse Studio, memahami komponen intinya, dan melakukan eksplorasi data sederhana. Harapkan pertanyaan ini jika Anda memiliki pengalaman Synapse terbatas atau jika pewawancara menilai pemahaman mendasar Anda.
Topik kunci apa yang harus Anda kuasai?
Jika diminta memberikan gambaran tingkat tinggi tentang Synapse, Anda harus dapat mendeskripsikan Synapse Analytics dan perannya dalam lanskap data modern.
- Fitur inti dan antarmuka pengguna: Pahami Synapse Studio, berbagai hub-nya (Data, Develop, Integrate, Monitor, Manage), dan fungsionalitasnya.
- Kasus penggunaan sederhana: Berikan contoh bagaimana organisasi menggunakan Synapse, termasuk wawasan arsitektur dasar.
Apa itu Microsoft Synapse Analytics, dan apa saja fitur utamanya?
Synapse Analytics adalah layanan analitik tanpa batas yang memadukan data warehousing tingkat enterprise dan analitik big data. Fitur utamanya meliputi:
- SQL Pool (Data Warehouse): Mesin kueri terdistribusi untuk analitik berkinerja tinggi pada data terstruktur.
- Spark Pool: Integrasi dengan Apache Spark untuk pemrosesan big data dan machine learning.
- Dukungan Data Lake: Integrasi native dengan Azure Data Lake Storage Gen2 untuk menganalisis data di tempat.
- Synapse Studio: Ruang kerja terpadu untuk persiapan data, data warehousing, analitik big data, dan tugas AI.
- Integrasi Data: Kemampuan integrasi data bawaan dengan Azure Data Factory.
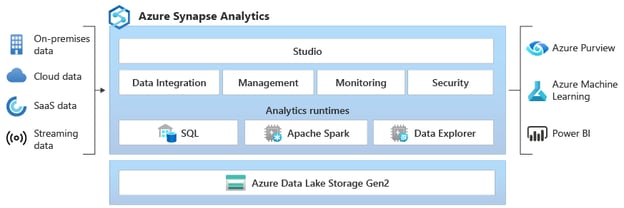
Jelaskan arsitektur inti Synapse Analytics.
Arsitektur inti mencakup:
- Synapse Studio: UI pusat untuk semua aktivitas Synapse.
- SQL Pools: Menyediakan kemampuan kueri berbasis T-SQL untuk data terstruktur. Dedicated SQL pool memberikan sumber daya terjamin, sedangkan serverless SQL pool menawarkan kueri on-demand terhadap data di data lake.
- Spark Pools: Menyediakan Apache Spark sebagai layanan untuk pemrosesan big data, rekayasa data, dan tugas machine learning.
- Data Lake Storage: Azure Data Lake Storage Gen2 berfungsi sebagai fondasi untuk menyimpan data terstruktur, semi-terstruktur, dan tidak terstruktur dalam jumlah besar.
- Pipelines: Pipeline integrasi data yang didukung oleh Azure Data Factory untuk proses ETL/ELT.
Bagaimana Anda melakukan kueri data di Synapse Analytics?
Anda dapat melakukan kueri data di Synapse menggunakan:
- T-SQL: Menggunakan SQL Pool untuk data terstruktur.
- Spark SQL: Menggunakan Spark Pools untuk data di data lake.
- Serverless SQL Pool: Mengkueri data langsung di data lake menggunakan T-SQL tanpa perlu melakukan provisioning sumber daya.
Pertanyaan Wawancara Synapse Tingkat Menengah
Pertanyaan-pertanyaan ini mengukur pemahaman Anda yang lebih mendalam tentang Synapse dan konfigurasinya. Anda perlu menunjukkan kemampuan mengelola sumber daya, menerapkan alur kerja pemrosesan data, dan mengoptimalkan kinerja.
Ini membangun di atas pengetahuan dasar Anda dan memerlukan pemahaman tentang:
- Manajemen sumber daya: Cara melakukan provisioning dan mengelola SQL Pools dan Spark Pools.
- Integrasi data: Membuat dan mengelola pipeline data menggunakan Synapse Pipelines (Azure Data Factory).
- Penyetelan kinerja: Memahami teknik optimasi kueri dan strategi partisi data.
Bagaimana cara membuat dan mengelola SQL Pools di Synapse Analytics?
Untuk membuat SQL Pool, buka Synapse Studio, pilih hub "Manage", lalu "SQL pools." Anda kemudian dapat mengonfigurasi level kinerja pool (Data Warehouse Units - DWUs) berdasarkan kebutuhan beban kerja Anda.
Pengelolaan mencakup memantau kinerja, melakukan penskalaan sumber daya, serta menjeda/melanjutkan pool sesuai kebutuhan.
Jelaskan bagaimana Spark digunakan di Synapse Analytics.
Synapse menggunakan Spark Pools untuk menyediakan Apache Spark sebagai layanan. Ini memungkinkan Anda untuk:
- Memproses dataset besar menggunakan Spark DataFrames.
- Melakukan tugas rekayasa data menggunakan bahasa seperti Python, Scala, dan Java.
- Membangun dan melatih model machine learning menggunakan Spark MLlib.
Apa itu data pipeline, dan bagaimana cara membuatnya di Synapse?
Data pipeline adalah alur kerja otomatis untuk akuisisi, transformasi, dan pemuatan data. Di Synapse, Anda membuatnya menggunakan hub "Integrate", yang menyediakan antarmuka visual (Azure Data Factory) untuk merancang dan mengelola pipeline.
Pipeline ini dapat terhubung ke berbagai sumber data, melakukan transformasi menggunakan aktivitas seperti data flow atau eksekusi stored procedure, dan memuat data ke sistem target.
Bagaimana Anda memantau dan mengelola sumber daya di Synapse Analytics?
Anda dapat memantau sumber daya melalui hub "Monitor" di Synapse Studio. Hub ini memberikan wawasan tentang kinerja SQL Pool dan Spark Pool, eksekusi pipeline, dan kesehatan sistem secara keseluruhan. Anda juga dapat menggunakan Azure Monitor untuk pemantauan dan kemampuan peringatan yang lebih mendetail.
Jelaskan opsi penyimpanan data yang tersedia di Synapse Analytics?
Synapse Analytics menawarkan beragam opsi penyimpanan data untuk memenuhi berbagai kebutuhan dan skenario, memastikan fleksibilitas dan efisiensi dalam menangani dataset yang beragam. Opsi-opsi tersebut meliputi:
- Azure Data Lake Storage Gen2: Penyimpanan utama untuk data lake, dioptimalkan untuk analitik skala besar.
- Penyimpanan SQL pool: Menyimpan data terstruktur di dalam data warehouse.
- Azure Blob Storage: Dapat digunakan untuk menyimpan data, meskipun Data Lake Storage Gen2 umumnya lebih disukai untuk beban kerja analitik.
Pertanyaan Wawancara Synapse Tingkat Lanjut
Pengguna tingkat lanjut diharapkan mampu menangani optimasi kinerja, membuat alur kerja yang kompleks, serta menerapkan analitik dan model machine learning yang canggih. Pertanyaan-pertanyaan ini umum untuk posisi data senior atau peran dengan komponen DevOps.
Ini membangun di atas pengetahuan dasar dan menengah, memerlukan pengalaman praktis dalam:
- Optimasi kinerja: Menyetel konfigurasi SQL Pool dan Spark Pool, mengoptimalkan kueri, dan mengelola partisi data.
- Machine learning: Mengintegrasikan Synapse dengan Azure Machine Learning, menerapkan model, dan mengelola siklus hidup model.
- Pipeline CI/CD: Menerapkan continuous integration dan continuous deployment untuk solusi Synapse.
Strategi apa yang Anda gunakan untuk optimasi kinerja di Synapse?
Pengindeksan yang tepat: Optimalkan kinerja SQL Pool dengan menggunakan clustered columnstore index dan non-clustered index yang sesuai.
- Partisi data: Partisikan data di SQL Pools dan Data Lake Storage berdasarkan pola kueri untuk meningkatkan kinerja.
- Optimasi kueri: Gunakan hint kueri, tulis ulang kueri kompleks, dan analisis rencana eksekusi kueri untuk mengidentifikasi bottleneck.
- Alokasi sumber daya: Menentukan ukuran yang tepat untuk SQL Pools dan Spark Pools berdasarkan kebutuhan beban kerja.
Bagaimana Anda dapat menerapkan pipeline CI/CD untuk Synapse Analytics?
Gunakan Azure DevOps atau GitHub Actions untuk mengotomatiskan build, pengujian, dan deployment solusi Synapse. Ini mencakup:
- Kendali versi: Simpan artefak Synapse (skrip SQL, notebook Spark, pipeline) dalam sistem version control.
- Pengujian otomatis: Terapkan unit test dan integration test untuk skrip SQL dan pipeline data.
- Deployment otomatis: Gunakan Azure Resource Manager (ARM) template atau Synapse API untuk menerapkan perubahan ke berbagai lingkungan (dev, test, prod).
Jelaskan cara menangani analitik kompleks di Synapse Analytics?
Menangani analitik kompleks dan memastikan operasi data berjalan mulus di Synapse Analytics memerlukan pendekatan multifaset. Ini melibatkan pengujian otomatis, strategi deployment, dan teknik analitik lanjutan.
Di bawah ini, Anda akan menemukan metode penting untuk mencapai tujuan tersebut secara efektif:
- Kueri SQL Lanjutan: Manfaatkan window function, common table expressions (CTE), dan fitur T-SQL lanjutan lainnya untuk analisis data kompleks di SQL Pools.
- Spark untuk Pemrosesan Big Data: Gunakan Spark Pools untuk memproses dataset besar, melakukan transformasi kompleks, dan membangun model machine learning.
- Integrasi dengan Azure Machine Learning: Manfaatkan Azure Machine Learning untuk skenario analitik lanjutan, seperti pemodelan prediktif dan deteksi anomali.
Bagaimana Anda menerapkan model machine learning di Synapse Analytics?
Menerapkan model machine learning di Synapse Analytics melibatkan beberapa langkah kunci, mulai dari pelatihan dan pendaftaran model hingga deployment untuk penggunaan praktis. Berikut pendekatan terstruktur untuk berhasil menerapkan model machine learning:
- Melatih model: Latih model machine learning menggunakan Spark MLlib di Synapse atau Azure Machine Learning.
- Mendaftarkan model: Daftarkan model yang telah dilatih di Azure Machine Learning Model Registry.
- Menerapkan model: Terapkan model sebagai endpoint REST menggunakan Azure Machine Learning atau integrasikan ke dalam pipeline Synapse untuk batch scoring.
Pertanyaan Wawancara Synapse untuk Peran Data Engineer
Data Engineer bertanggung jawab merancang, membangun, dan memelihara pipeline data, memastikan kualitas data, serta mengoptimalkan kinerja. Untuk posisi Data Engineer yang berfokus pada Synapse, Anda harus memahami:
- Arsitektur Pipeline Data: Merancang pipeline data yang skalabel dan andal untuk proses ETL/ELT.
- Pemrosesan real-time: Menerapkan akuisisi dan pemrosesan data real-time menggunakan Azure Event Hubs, Azure Stream Analytics, dan Synapse.
- Keamanan data: Menerapkan langkah-langkah keamanan untuk melindungi data saat tersimpan maupun saat ditransmisikan.
Bagaimana Anda merancang data pipeline di Synapse Analytics?
Saat merancang data pipeline di Synapse Analytics, beberapa komponen kunci harus dipertimbangkan untuk memastikan pemrosesan data yang efisien dan andal:
- Identifikasi sumber data: Tentukan sumber data (misalnya, database, API, file) dan metode akuisisinya.
- Rancang proses ETL/ELT: Buat data pipeline menggunakan Synapse Pipelines (Azure Data Factory) untuk mengekstrak, mentransformasi, dan memuat data.
- Terapkan pemeriksaan kualitas data: Tambahkan validasi data dan langkah penanganan kesalahan untuk memastikan kualitas data.
- Otomatisasi eksekusi pipeline: Jadwalkan pipeline agar berjalan otomatis menggunakan trigger dan eksekusi berbasis jadwal.
Apa praktik terbaik untuk proses ETL di Synapse Analytics?
Dalam konteks Synapse Analytics, menerapkan proses ETL (Extract, Transform, Load) yang efektif sangat penting untuk memastikan manajemen data dan analitik yang efisien. Praktik terbaik berikut direkomendasikan untuk mengoptimalkan proses ETL di Synapse Analytics:
- Gunakan Delta Lake: Gunakan Delta Lake untuk menyimpan data di data lake guna memungkinkan transaksi ACID dan versi data.
- Kode modular: Tulis kode yang modular dan dapat digunakan kembali di notebook Synapse dan skrip SQL.
- Parameterisasi: Parameterisasi pipeline dan skrip SQL agar lebih fleksibel dan dapat digunakan kembali.
- Pemantauan: Pantau eksekusi dan kinerja pipeline menggunakan Synapse Studio dan Azure Monitor.
Bagaimana Anda menangani pemrosesan data real-time di Synapse?
Sebagai data engineer, banyak tantangan yang membutuhkan solusi inovatif dan metodologi yang andal. Bekerja dengan dan menangani data real-time adalah salah satunya. Berikut beberapa pengalaman dan teknik yang umum diterapkan:
- Mengakuisisi data real-time: Gunakan Azure Event Hubs atau Azure IoT Hub untuk mengakuisisi aliran data real-time.
- Memproses data dengan Stream Analytics: Gunakan Azure Stream Analytics untuk melakukan transformasi dan agregasi secara real-time.
- Memuat data ke Synapse: Muat data yang telah diproses ke SQL Pools atau Data Lake Storage untuk analitik real-time.
Bagaimana Anda memastikan keamanan data di Synapse Analytics?
Memastikan keamanan data di Synapse Analytics sangat penting untuk melindungi informasi sensitif dan menjaga kepatuhan terhadap standar regulasi. Beberapa strategi kunci dapat diterapkan untuk mengamankan data dalam lingkungan Synapse:
- Kontrol akses: Terapkan role-based access control (RBAC) untuk mengelola akses ke sumber daya Synapse.
- Enkripsi data: Aktifkan enkripsi saat tersimpan dan saat transit menggunakan Azure Key Vault.
- Keamanan jaringan: Gunakan integrasi virtual network (VNet) dan private endpoint untuk mengamankan akses jaringan.
- Audit: Aktifkan auditing untuk melacak aktivitas pengguna dan akses data.
- Data masking: Terapkan data masking untuk melindungi data sensitif.
Penutup
Panduan ini telah membekali Anda dengan wawasan kunci untuk menghadapi wawancara Microsoft Synapse Analytics dengan percaya diri, baik Anda seorang data engineer maupun software engineer.
Ingatlah untuk menonjolkan tidak hanya pengetahuan teoretis, tetapi juga pengalaman praktis Anda dalam merancang pipeline data, mengoptimalkan kinerja, dan memastikan keamanan data yang tangguh.
Di luar aspek teknis, soroti keterampilan pemecahan masalah dan kemampuan belajar berkelanjutan Anda, karena Synapse Analytics adalah platform yang berkembang pesat. Tetaplah ingin tahu, terus jelajahi sumber daya Microsoft, dan tunjukkan semangat Anda dalam memanfaatkan data untuk mendorong hasil bisnis yang berdampak. Semoga sukses!





Microsoft Synapse Analytics, sebelumnya dikenal sebagai Azure SQL Data Warehouse, adalah layanan analitik terpadu yang menawarkan platform menyeluruh untuk big data dan data warehousing.
Dengan menggabungkan data warehousing tingkat enterprise dan analitik big data secara mulus, Synapse memungkinkan pengguna untuk mengakuisisi, menyiapkan, mengelola, dan menyajikan data untuk kebutuhan business intelligence dan machine learning secara langsung. Layanan yang kuat ini mendukung berbagai bahasa seperti SQL, Python, dan Spark, sehingga memungkinkan beragam kemampuan pemrosesan dan transformasi data. Selain itu, arsitektur serverless-nya memastikan skalabilitas untuk menangani volume data berapa pun, menjadikannya alat yang tak tergantikan bagi para profesional data modern.
Panduan ini menghadirkan topik dan pertanyaan penting untuk membantu Anda mempersiapkan wawancara Synapse. Pertanyaan-pertanyaan ini mencerminkan pengalaman saya sendiri dalam mewawancarai dan bekerja dengan profesional data yang menggunakan Synapse, memberikan wawasan berharga tentang apa yang dicari oleh manajer perekrutan.
Selain mempelajari panduan wawancara ini, saya menyarankan Anda menelusuri Dokumentasi Microsoft Azure Synapse Analytics untuk pertanyaan spesifik yang mungkin Anda miliki selama proses persiapan.
Pertanyaan Wawancara Synapse Dasar
Pada tingkat dasar, pertanyaan akan mencakup pengetahuan fundamental Anda tentang Synapse, termasuk tugas seperti menavigasi Synapse Studio, memahami komponen intinya, dan melakukan eksplorasi data sederhana. Harapkan pertanyaan ini jika Anda memiliki pengalaman Synapse terbatas atau jika pewawancara menilai pemahaman mendasar Anda.
Topik kunci apa yang harus Anda kuasai?
Jika diminta memberikan gambaran tingkat tinggi tentang Synapse, Anda harus dapat mendeskripsikan Synapse Analytics dan perannya dalam lanskap data modern.
Apa itu Microsoft Synapse Analytics, dan apa saja fitur utamanya?
Synapse Analytics adalah layanan analitik tanpa batas yang memadukan data warehousing tingkat enterprise dan analitik big data. Fitur utamanya meliputi:
Jelaskan arsitektur inti Synapse Analytics.
Arsitektur inti mencakup:
Bagaimana Anda melakukan kueri data di Synapse Analytics?
Anda dapat melakukan kueri data di Synapse menggunakan:
Pertanyaan Wawancara Synapse Tingkat Menengah
Pertanyaan-pertanyaan ini mengukur pemahaman Anda yang lebih mendalam tentang Synapse dan konfigurasinya. Anda perlu menunjukkan kemampuan mengelola sumber daya, menerapkan alur kerja pemrosesan data, dan mengoptimalkan kinerja.
Ini membangun di atas pengetahuan dasar Anda dan memerlukan pemahaman tentang:
Bagaimana cara membuat dan mengelola SQL Pools di Synapse Analytics?
Untuk membuat SQL Pool, buka Synapse Studio, pilih hub "Manage", lalu "SQL pools." Anda kemudian dapat mengonfigurasi level kinerja pool (Data Warehouse Units - DWUs) berdasarkan kebutuhan beban kerja Anda.
Pengelolaan mencakup memantau kinerja, melakukan penskalaan sumber daya, serta menjeda/melanjutkan pool sesuai kebutuhan.
Jelaskan bagaimana Spark digunakan di Synapse Analytics.
Synapse menggunakan Spark Pools untuk menyediakan Apache Spark sebagai layanan. Ini memungkinkan Anda untuk:
Apa itu data pipeline, dan bagaimana cara membuatnya di Synapse?
Data pipeline adalah alur kerja otomatis untuk akuisisi, transformasi, dan pemuatan data. Di Synapse, Anda membuatnya menggunakan hub "Integrate", yang menyediakan antarmuka visual (Azure Data Factory) untuk merancang dan mengelola pipeline.
Pipeline ini dapat terhubung ke berbagai sumber data, melakukan transformasi menggunakan aktivitas seperti data flow atau eksekusi stored procedure, dan memuat data ke sistem target.
Bagaimana Anda memantau dan mengelola sumber daya di Synapse Analytics?
Anda dapat memantau sumber daya melalui hub "Monitor" di Synapse Studio. Hub ini memberikan wawasan tentang kinerja SQL Pool dan Spark Pool, eksekusi pipeline, dan kesehatan sistem secara keseluruhan. Anda juga dapat menggunakan Azure Monitor untuk pemantauan dan kemampuan peringatan yang lebih mendetail.
Jelaskan opsi penyimpanan data yang tersedia di Synapse Analytics?
Synapse Analytics menawarkan beragam opsi penyimpanan data untuk memenuhi berbagai kebutuhan dan skenario, memastikan fleksibilitas dan efisiensi dalam menangani dataset yang beragam. Opsi-opsi tersebut meliputi:
Pertanyaan Wawancara Synapse Tingkat Lanjut
Pengguna tingkat lanjut diharapkan mampu menangani optimasi kinerja, membuat alur kerja yang kompleks, serta menerapkan analitik dan model machine learning yang canggih. Pertanyaan-pertanyaan ini umum untuk posisi data senior atau peran dengan komponen DevOps.
Ini membangun di atas pengetahuan dasar dan menengah, memerlukan pengalaman praktis dalam:
Strategi apa yang Anda gunakan untuk optimasi kinerja di Synapse?
Pengindeksan yang tepat: Optimalkan kinerja SQL Pool dengan menggunakan clustered columnstore index dan non-clustered index yang sesuai.
Bagaimana Anda dapat menerapkan pipeline CI/CD untuk Synapse Analytics?
Gunakan Azure DevOps atau GitHub Actions untuk mengotomatiskan build, pengujian, dan deployment solusi Synapse. Ini mencakup:
Jelaskan cara menangani analitik kompleks di Synapse Analytics?
Menangani analitik kompleks dan memastikan operasi data berjalan mulus di Synapse Analytics memerlukan pendekatan multifaset. Ini melibatkan pengujian otomatis, strategi deployment, dan teknik analitik lanjutan.
Di bawah ini, Anda akan menemukan metode penting untuk mencapai tujuan tersebut secara efektif:
Bagaimana Anda menerapkan model machine learning di Synapse Analytics?
Menerapkan model machine learning di Synapse Analytics melibatkan beberapa langkah kunci, mulai dari pelatihan dan pendaftaran model hingga deployment untuk penggunaan praktis. Berikut pendekatan terstruktur untuk berhasil menerapkan model machine learning:
Pertanyaan Wawancara Synapse untuk Peran Data Engineer
Data Engineer bertanggung jawab merancang, membangun, dan memelihara pipeline data, memastikan kualitas data, serta mengoptimalkan kinerja. Untuk posisi Data Engineer yang berfokus pada Synapse, Anda harus memahami:
Bagaimana Anda merancang data pipeline di Synapse Analytics?
Saat merancang data pipeline di Synapse Analytics, beberapa komponen kunci harus dipertimbangkan untuk memastikan pemrosesan data yang efisien dan andal:
Apa praktik terbaik untuk proses ETL di Synapse Analytics?
Dalam konteks Synapse Analytics, menerapkan proses ETL (Extract, Transform, Load) yang efektif sangat penting untuk memastikan manajemen data dan analitik yang efisien. Praktik terbaik berikut direkomendasikan untuk mengoptimalkan proses ETL di Synapse Analytics:
Bagaimana Anda menangani pemrosesan data real-time di Synapse?
Sebagai data engineer, banyak tantangan yang membutuhkan solusi inovatif dan metodologi yang andal. Bekerja dengan dan menangani data real-time adalah salah satunya. Berikut beberapa pengalaman dan teknik yang umum diterapkan:
Bagaimana Anda memastikan keamanan data di Synapse Analytics?
Memastikan keamanan data di Synapse Analytics sangat penting untuk melindungi informasi sensitif dan menjaga kepatuhan terhadap standar regulasi. Beberapa strategi kunci dapat diterapkan untuk mengamankan data dalam lingkungan Synapse:
Penutup
Panduan ini telah membekali Anda dengan wawasan kunci untuk menghadapi wawancara Microsoft Synapse Analytics dengan percaya diri, baik Anda seorang data engineer maupun software engineer.
Ingatlah untuk menonjolkan tidak hanya pengetahuan teoretis, tetapi juga pengalaman praktis Anda dalam merancang pipeline data, mengoptimalkan kinerja, dan memastikan keamanan data yang tangguh.
Di luar aspek teknis, soroti keterampilan pemecahan masalah dan kemampuan belajar berkelanjutan Anda, karena Synapse Analytics adalah platform yang berkembang pesat. Tetaplah ingin tahu, terus jelajahi sumber daya Microsoft, dan tunjukkan semangat Anda dalam memanfaatkan data untuk mendorong hasil bisnis yang berdampak. Semoga sukses!