Microsoft Synapse Analytics, voorheen bekend als Azure SQL Data Warehouse, is een geïntegreerde analysetool die een uniform platform biedt voor big data en datawarehousing.
Door enterprise datawarehousing en bigdata-analyse naadloos te combineren, stelt Synapse gebruikers in staat om data in te laden, voor te bereiden, te beheren en beschikbaar te maken voor directe business intelligence- en machinelearningbehoeften. Deze krachtige service ondersteunt meerdere talen zoals SQL, Python en Spark, waardoor een breed scala aan dataprocestaken en transformaties mogelijk is. Bovendien zorgt de serverloze architectuur voor schaalbaarheid om elk datavolume aan te kunnen, waardoor het een onmisbare tool is voor moderne dataprofessionals.
Deze gids behandelt essentiële onderwerpen en vragen om je voor te bereiden op je Synapse-sollicitatie. De vragen zijn gebaseerd op mijn eigen ervaring met het interviewen en samenwerken met dataprofessionals die Synapse gebruiken, en geven waardevol inzicht in waar hiring managers op letten.
Naast het doornemen van deze interviewgids raad ik aan om de Microsoft Azure Synapse Analytics-documentatie te bekijken voor specifieke vragen die je onderweg kunt hebben.
Basisvragen over Synapse tijdens sollicitaties
Op basaal niveau gaan de vragen over je fundamentele kennis van Synapse, zoals navigeren in Synapse Studio, de kernonderdelen begrijpen en eenvoudige data-exploratie uitvoeren. Reken op dit soort vragen als je beperkte Synapse-ervaring hebt of als de interviewer je basisbegrip wil toetsen.
Met welke kernthema's moet je bekend zijn?
Als je wordt gevraagd om een high-level overzicht van Synapse te geven, moet je Synapse Analytics en de rol ervan in een modern datalandschap kunnen beschrijven.
- Kernfuncties en gebruikersinterface: Begrijp Synapse Studio, de verschillende hubs (Data, Develop, Integrate, Monitor, Manage) en hun functionaliteiten.
- Eenvoudige use-cases: Geef voorbeelden van hoe organisaties Synapse gebruiken, inclusief inzichten in basisarchitecturen.
Wat is Microsoft Synapse Analytics en wat zijn de belangrijkste functies?
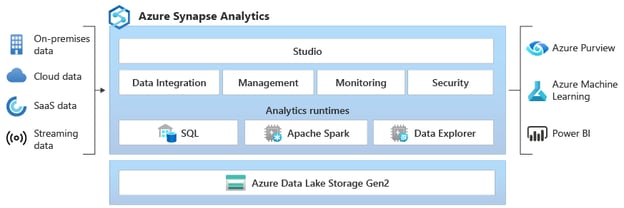
Synapse Analytics is een grenzeloze analysetool die enterprise datawarehousing en bigdata-analyse samenbrengt. Belangrijke functies zijn onder meer:
- SQL Pool (Data Warehouse): Een gedistribueerde query-engine voor high-performance analyse op gestructureerde data.
- Spark Pool: Integratie met Apache Spark voor bigdataverwerking en machine learning.
- Ondersteuning voor Data Lake: Native integratie met Azure Data Lake Storage Gen2 voor analyse in place.
- Synapse Studio: Een uniforme werkruimte voor datapreparatie, datawarehousing, bigdata-analyse en AI-taken.
- Dataintegratie: Ingebouwde integratiemogelijkheden met Azure Data Factory.
Leg de kernarchitectuur van Synapse Analytics uit.
De kernarchitectuur omvat:
- Synapse Studio: De centrale UI voor alle Synapse-activiteiten.
- SQL Pools: Bieden T-SQL-gebaseerde querymogelijkheden voor gestructureerde data. Dedicated SQL Pools bieden gegarandeerde resources, terwijl serverloze SQL Pools on-demand queries op data in de data lake mogelijk maken.
- Spark Pools: Bieden Apache Spark as-a-service voor bigdataverwerking, data-engineering en machinelearningtaken.
- Data Lake Storage: Azure Data Lake Storage Gen2 vormt de basis voor het opslaan van grote volumes gestructureerde, semi-gestructureerde en ongestructureerde data.
- Pipelines: Dataintegratiepipelines aangedreven door Azure Data Factory voor ETL/ELT-processen.
Hoe query je data in Synapse Analytics?
Je kunt data in Synapse opvragen met:
- T-SQL: Met de SQL Pool voor gestructureerde data.
- Spark SQL: Met Spark Pools voor data in de data lake.
- Serverloze SQL Pool: Query data rechtstreeks in de data lake met T-SQL zonder resources te provisionen.
Gevorderde Synapse-sollicitatievragen (middenniveau)
Deze vragen toetsen je diepere begrip van Synapse en de configuratie ervan. Je moet kunnen laten zien dat je resources beheert, dataverwerkingsworkflows implementeert en prestaties optimaliseert.
Dit bouwt voort op je basiskennis en vereist begrip van:
- Resourcebeheer: Hoe je SQL Pools en Spark Pools inricht en beheert.
- Dataintegratie: Het maken en beheren van datapipelines met Synapse Pipelines (Azure Data Factory).
- Performance tuning: Inzicht in queryoptimalisatietechnieken en strategieën voor datapartitionering.
Hoe maak en beheer je SQL Pools in Synapse Analytics?
Om een SQL Pool te maken, ga je naar Synapse Studio, kies je de hub "Manage" en vervolgens "SQL pools". Je kunt daarna het prestatieniveau (Data Warehouse Units - DWU's) configureren op basis van de vereisten van je workload.
Beheer omvat het monitoren van prestaties, het opschalen van resources en het pauzeren/hervatten van de pool indien nodig.
Leg uit hoe Spark wordt gebruikt in Synapse Analytics.
Synapse gebruikt Spark Pools om Apache Spark as-a-service te bieden. Dit stelt je in staat om:
- Grote datasets te verwerken met Spark DataFrames.
- Data-engineeringtaken uit te voeren met talen zoals Python, Scala en Java.
- Machinelearningmodellen te bouwen en trainen met Spark MLlib.
Wat zijn datapipelines en hoe maak je ze in Synapse?
Datapipelines zijn geautomatiseerde workflows voor data-inname, transformatie en laden. In Synapse maak je ze via de hub "Integrate", die een visuele interface (Azure Data Factory) biedt om pipelines te ontwerpen en beheren.
Deze pipelines kunnen verbinding maken met diverse databronnen, transformaties uitvoeren met activiteiten zoals data flow of het uitvoeren van stored procedures, en data inlaadden in doelsystemen.
Hoe monitor en beheer je resources in Synapse Analytics?
Je kunt resources monitoren via de hub "Monitor" in Synapse Studio. Deze hub biedt inzicht in de prestaties van SQL Pools en Spark Pools, pipeline-uitvoeringen en de algehele systeemgezondheid. Voor meer gedetailleerde monitoring en waarschuwingen kun je ook Azure Monitor gebruiken.
Beschrijf de beschikbare dataopslagopties in Synapse Analytics?
Synapse Analytics biedt verschillende dataopslagopties voor uiteenlopende behoeften en scenario's, zodat je flexibel en efficiënt met diverse datasets kunt omgaan. Deze opties omvatten:
- Azure Data Lake Storage Gen2: Primaire opslag voor de data lake, geoptimaliseerd voor grootschalige analyses.
- SQL pool-opslag: Slaat gestructureerde data op binnen het datawarehouse.
- Azure Blob Storage: Kan worden gebruikt voor dataopslag, al heeft Data Lake Storage Gen2 doorgaans de voorkeur voor analytics-workloads.
Geavanceerde Synapse-sollicitatievragen
Van gevorderde gebruikers wordt verwacht dat ze prestatieoptimalisatie aankunnen, complexe workflows maken en geavanceerde analyses en machinelearningmodellen implementeren. Deze vragen zijn typisch voor senior datarollen of functies met een DevOps-component.
Dit bouwt voort op basis- en middenniveaukennis en vereist praktijkervaring met:
- Prestatieoptimalisatie: Het tunen van SQL Pool- en Spark Pool-configuraties, het optimaliseren van queries en het beheren van datapartitionering.
- Machine learning: Integratie van Synapse met Azure Machine Learning, het uitrollen van modellen en het beheren van de modellevenscyclus.
- CI/CD-pipelines: Implementatie van continuous integration en continuous deployment voor Synapse-oplossingen.
Welke strategieën gebruik je voor prestatieoptimalisatie in Synapse?
Juiste indexering: Optimaliseer de prestaties van SQL Pools met clustered columnstore-indexen en passende non-clustered indexen.
- Datapartitionering: Partitioneer data in SQL Pools en Data Lake Storage op basis van querypatronen om prestaties te verbeteren.
- Queryoptimalisatie: Gebruik query hints, herschrijf complexe queries en analyseer query-uitvoeringsplannen om knelpunten te identificeren.
- Resource-toewijzing: Kies de juiste omvang voor SQL Pools en Spark Pools op basis van workloadvereisten.
Hoe kun je CI/CD-pipelines implementeren voor Synapse Analytics?
Gebruik Azure DevOps of GitHub Actions om de build, tests en deployment van Synapse-oplossingen te automatiseren. Dit omvat:
- Versiebeheer: Sla Synapse-artefacten (SQL-scripts, Spark-notebooks, pipelines) op in een versiebeheersysteem.
- Geautomatiseerd testen: Implementeer unit- en integratietests voor SQL-scripts en datapipelines.
- Geautomatiseerde deployment: Gebruik Azure Resource Manager (ARM)-templates of Synapse-API's om wijzigingen naar verschillende omgevingen (dev, test, prod) te deployen.
Leg uit hoe je complexe analyses afhandelt in Synapse Analytics?
Het afhandelen van complexe analyses en het waarborgen van soepele data-operaties binnen Synapse Analytics vereist een veelzijdige aanpak. Dit omvat geautomatiseerd testen, deploymentstrategieën en geavanceerde analysetechnieken.
Hieronder vind je essentiële methoden om deze doelen effectief te bereiken:
- Geavanceerde SQL-queries: Gebruik windowfuncties, common table expressions (CTE's) en andere geavanceerde T-SQL-functies voor complexe data-analyse in SQL Pools.
- Spark voor bigdataverwerking: Gebruik Spark Pools om grote datasets te verwerken, complexe transformaties uit te voeren en machinelearningmodellen te bouwen.
- Integratie met Azure Machine Learning: Zet Azure Machine Learning in voor geavanceerde analysecases, zoals voorspellend modelleren en anomaliedetectie.
Hoe rol je machinelearningmodellen uit in Synapse Analytics?
Het uitrollen van machinelearningmodellen in Synapse Analytics omvat meerdere stappen, van trainen en registreren tot deployment voor praktisch gebruik. Hier is een gestructureerde aanpak om ML-modellen succesvol uit te rollen:
- Modellen trainen: Train machinelearningmodellen met Spark MLlib in Synapse of met Azure Machine Learning.
- Modellen registreren: Registreer getrainde modellen in de Azure Machine Learning Model Registry.
- Modellen uitrollen: Rol modellen uit als REST-endpoints met Azure Machine Learning of integreer ze in Synapse-pipelines voor batchscoring.
Synapse-sollicitatievragen voor Data Engineer-rollen
Data Engineers zijn verantwoordelijk voor het ontwerpen, bouwen en onderhouden van datapipelines, het waarborgen van datakwaliteit en het optimaliseren van prestaties. Voor Data Engineer-posities met focus op Synapse moet je het volgende begrijpen:
- Architectuur van datapipelines: Ontwerp schaalbare en betrouwbare datapipelines voor ETL/ELT-processen.
- Realtime verwerking: Implementeer realtime data-inname en -verwerking met Azure Event Hubs, Azure Stream Analytics en Synapse.
- Databeveiliging: Implementeer beveiligingsmaatregelen om data in rust en tijdens transport te beschermen.
Hoe ontwerp je datapipelines in Synapse Analytics?
Bij het ontwerpen van datapipelines in Synapse Analytics moet je met verschillende kernelementen rekening houden om efficiënte en betrouwbare dataverwerking te waarborgen:
- Identificeer databronnen: Bepaal de databronnen (bijv. databases, API's, bestanden) en hun innamemethoden.
- Ontwerp ETL/ELT-processen: Maak datapipelines met Synapse Pipelines (Azure Data Factory) om data te extraheren, transformeren en laden.
- Implementeer datakwaliteitscontroles: Voeg datavalidatie en foutafhandeling toe om datakwaliteit te garanderen.
- Automatiseer pipeline-uitvoering: Plan pipelines om automatisch te draaien met triggers en schema-gebaseerde uitvoering.
Wat zijn best practices voor ETL-processen in Synapse Analytics?
Binnen Synapse Analytics is het implementeren van effectieve ETL-processen (Extract, Transform, Load) cruciaal voor efficiënte datamanagement en analyses. De volgende best practices worden aanbevolen om ETL-processen in Synapse te optimaliseren:
- Gebruik Delta Lake: Gebruik Delta Lake voor opslag in de data lake om ACID-transacties en dataversiebeheer mogelijk te maken.
- Modulaire code: Schrijf modulaire en herbruikbare code in Synapse-notebooks en SQL-scripts.
- Parameterisatie: Parameteriseer pipelines en SQL-scripts om ze flexibeler en herbruikbaarder te maken.
- Monitoring: Monitor pipeline-uitvoeringen en prestaties met Synapse Studio en Azure Monitor.
Hoe ga je om met realtime dataverwerking in Synapse?
Als data engineer kom je tal van uitdagingen tegen die om innovatieve oplossingen en robuuste methoden vragen. Werken met en omgaan met realtime data is er daar één van. Hier zijn enkele ervaringen en technieken die vaak worden toegepast:
- Realtime data innemen: Gebruik Azure Event Hubs of Azure IoT Hub om realtime datastromen in te nemen.
- Data verwerken met Stream Analytics: Gebruik Azure Stream Analytics om realtime transformaties en aggregaties uit te voeren.
- Data laden in Synapse: Laad verwerkte data in SQL Pools of Data Lake Storage voor realtime analytics.
Hoe borg je databeveiliging in Synapse Analytics?
Databeveiliging in Synapse Analytics is cruciaal om gevoelige informatie te beschermen en te voldoen aan wet- en regelgeving. Je kunt verschillende sleutelstrategieën implementeren om data binnen de Synapse-omgeving te beveiligen:
- Toegangsbeheer: Implementeer role-based access control (RBAC) om toegang tot Synapse-resources te beheren.
- Data versleuteling: Schakel versleuteling in voor data in rust en tijdens transport met Azure Key Vault.
- Netwerk beveiliging: Gebruik virtual network (VNet)-integratie en private endpoints om netwerktoegang te beveiligen.
- Auditing: Schakel auditing in om gebruikersactiviteit en data-toegang te volgen.
- Data masking: Implementeer data masking om gevoelige data te beschermen.
Tot slot
Deze gids heeft je voorzien van belangrijke inzichten om vol vertrouwen je Microsoft Synapse Analytics-sollicitatie aan te gaan, of je nu data engineer of software engineer bent.
Vergeet niet om niet alleen je theoretische kennis te laten zien, maar ook je praktijkervaring met het ontwerpen van datapipelines, het optimaliseren van prestaties en het waarborgen van solide databeveiliging.
Benadruk naast de technische aspecten ook je probleemoplossend vermogen en je leergierigheid, aangezien Synapse Analytics een snel evoluerend platform is. Blijf nieuwsgierig, blijf de resources van Microsoft verkennen en laat je passie zien om data in te zetten voor impactvolle zakelijke resultaten. Succes!




Microsoft Synapse Analytics, voorheen bekend als Azure SQL Data Warehouse, is een geïntegreerde analysetool die een uniform platform biedt voor big data en datawarehousing.
Door enterprise datawarehousing en bigdata-analyse naadloos te combineren, stelt Synapse gebruikers in staat om data in te laden, voor te bereiden, te beheren en beschikbaar te maken voor directe business intelligence- en machinelearningbehoeften. Deze krachtige service ondersteunt meerdere talen zoals SQL, Python en Spark, waardoor een breed scala aan dataprocestaken en transformaties mogelijk is. Bovendien zorgt de serverloze architectuur voor schaalbaarheid om elk datavolume aan te kunnen, waardoor het een onmisbare tool is voor moderne dataprofessionals.
Deze gids behandelt essentiële onderwerpen en vragen om je voor te bereiden op je Synapse-sollicitatie. De vragen zijn gebaseerd op mijn eigen ervaring met het interviewen en samenwerken met dataprofessionals die Synapse gebruiken, en geven waardevol inzicht in waar hiring managers op letten.
Naast het doornemen van deze interviewgids raad ik aan om de Microsoft Azure Synapse Analytics-documentatie te bekijken voor specifieke vragen die je onderweg kunt hebben.
Basisvragen over Synapse tijdens sollicitaties
Op basaal niveau gaan de vragen over je fundamentele kennis van Synapse, zoals navigeren in Synapse Studio, de kernonderdelen begrijpen en eenvoudige data-exploratie uitvoeren. Reken op dit soort vragen als je beperkte Synapse-ervaring hebt of als de interviewer je basisbegrip wil toetsen.
Met welke kernthema's moet je bekend zijn?
Als je wordt gevraagd om een high-level overzicht van Synapse te geven, moet je Synapse Analytics en de rol ervan in een modern datalandschap kunnen beschrijven.
Wat is Microsoft Synapse Analytics en wat zijn de belangrijkste functies?
Synapse Analytics is een grenzeloze analysetool die enterprise datawarehousing en bigdata-analyse samenbrengt. Belangrijke functies zijn onder meer:
Leg de kernarchitectuur van Synapse Analytics uit.
De kernarchitectuur omvat:
Hoe query je data in Synapse Analytics?
Je kunt data in Synapse opvragen met:
Gevorderde Synapse-sollicitatievragen (middenniveau)
Deze vragen toetsen je diepere begrip van Synapse en de configuratie ervan. Je moet kunnen laten zien dat je resources beheert, dataverwerkingsworkflows implementeert en prestaties optimaliseert.
Dit bouwt voort op je basiskennis en vereist begrip van:
Hoe maak en beheer je SQL Pools in Synapse Analytics?
Om een SQL Pool te maken, ga je naar Synapse Studio, kies je de hub "Manage" en vervolgens "SQL pools". Je kunt daarna het prestatieniveau (Data Warehouse Units - DWU's) configureren op basis van de vereisten van je workload.
Beheer omvat het monitoren van prestaties, het opschalen van resources en het pauzeren/hervatten van de pool indien nodig.
Leg uit hoe Spark wordt gebruikt in Synapse Analytics.
Synapse gebruikt Spark Pools om Apache Spark as-a-service te bieden. Dit stelt je in staat om:
Wat zijn datapipelines en hoe maak je ze in Synapse?
Datapipelines zijn geautomatiseerde workflows voor data-inname, transformatie en laden. In Synapse maak je ze via de hub "Integrate", die een visuele interface (Azure Data Factory) biedt om pipelines te ontwerpen en beheren.
Deze pipelines kunnen verbinding maken met diverse databronnen, transformaties uitvoeren met activiteiten zoals data flow of het uitvoeren van stored procedures, en data inlaadden in doelsystemen.
Hoe monitor en beheer je resources in Synapse Analytics?
Je kunt resources monitoren via de hub "Monitor" in Synapse Studio. Deze hub biedt inzicht in de prestaties van SQL Pools en Spark Pools, pipeline-uitvoeringen en de algehele systeemgezondheid. Voor meer gedetailleerde monitoring en waarschuwingen kun je ook Azure Monitor gebruiken.
Beschrijf de beschikbare dataopslagopties in Synapse Analytics?
Synapse Analytics biedt verschillende dataopslagopties voor uiteenlopende behoeften en scenario's, zodat je flexibel en efficiënt met diverse datasets kunt omgaan. Deze opties omvatten:
Geavanceerde Synapse-sollicitatievragen
Van gevorderde gebruikers wordt verwacht dat ze prestatieoptimalisatie aankunnen, complexe workflows maken en geavanceerde analyses en machinelearningmodellen implementeren. Deze vragen zijn typisch voor senior datarollen of functies met een DevOps-component.
Dit bouwt voort op basis- en middenniveaukennis en vereist praktijkervaring met:
Welke strategieën gebruik je voor prestatieoptimalisatie in Synapse?
Juiste indexering: Optimaliseer de prestaties van SQL Pools met clustered columnstore-indexen en passende non-clustered indexen.
Hoe kun je CI/CD-pipelines implementeren voor Synapse Analytics?
Gebruik Azure DevOps of GitHub Actions om de build, tests en deployment van Synapse-oplossingen te automatiseren. Dit omvat:
Leg uit hoe je complexe analyses afhandelt in Synapse Analytics?
Het afhandelen van complexe analyses en het waarborgen van soepele data-operaties binnen Synapse Analytics vereist een veelzijdige aanpak. Dit omvat geautomatiseerd testen, deploymentstrategieën en geavanceerde analysetechnieken.
Hieronder vind je essentiële methoden om deze doelen effectief te bereiken:
Hoe rol je machinelearningmodellen uit in Synapse Analytics?
Het uitrollen van machinelearningmodellen in Synapse Analytics omvat meerdere stappen, van trainen en registreren tot deployment voor praktisch gebruik. Hier is een gestructureerde aanpak om ML-modellen succesvol uit te rollen:
Synapse-sollicitatievragen voor Data Engineer-rollen
Data Engineers zijn verantwoordelijk voor het ontwerpen, bouwen en onderhouden van datapipelines, het waarborgen van datakwaliteit en het optimaliseren van prestaties. Voor Data Engineer-posities met focus op Synapse moet je het volgende begrijpen:
Hoe ontwerp je datapipelines in Synapse Analytics?
Bij het ontwerpen van datapipelines in Synapse Analytics moet je met verschillende kernelementen rekening houden om efficiënte en betrouwbare dataverwerking te waarborgen:
Wat zijn best practices voor ETL-processen in Synapse Analytics?
Binnen Synapse Analytics is het implementeren van effectieve ETL-processen (Extract, Transform, Load) cruciaal voor efficiënte datamanagement en analyses. De volgende best practices worden aanbevolen om ETL-processen in Synapse te optimaliseren:
Hoe ga je om met realtime dataverwerking in Synapse?
Als data engineer kom je tal van uitdagingen tegen die om innovatieve oplossingen en robuuste methoden vragen. Werken met en omgaan met realtime data is er daar één van. Hier zijn enkele ervaringen en technieken die vaak worden toegepast:
Hoe borg je databeveiliging in Synapse Analytics?
Databeveiliging in Synapse Analytics is cruciaal om gevoelige informatie te beschermen en te voldoen aan wet- en regelgeving. Je kunt verschillende sleutelstrategieën implementeren om data binnen de Synapse-omgeving te beveiligen:
Tot slot
Deze gids heeft je voorzien van belangrijke inzichten om vol vertrouwen je Microsoft Synapse Analytics-sollicitatie aan te gaan, of je nu data engineer of software engineer bent.
Vergeet niet om niet alleen je theoretische kennis te laten zien, maar ook je praktijkervaring met het ontwerpen van datapipelines, het optimaliseren van prestaties en het waarborgen van solide databeveiliging.
Benadruk naast de technische aspecten ook je probleemoplossend vermogen en je leergierigheid, aangezien Synapse Analytics een snel evoluerend platform is. Blijf nieuwsgierig, blijf de resources van Microsoft verkennen en laat je passie zien om data in te zetten voor impactvolle zakelijke resultaten. Succes!