Microsoft Synapse Analytics, trước đây gọi là Azure SQL Data Warehouse, là một dịch vụ phân tích tích hợp cung cấp nền tảng thống nhất cho dữ liệu lớn và kho dữ liệu.
Bằng cách kết hợp liền mạch kho dữ liệu doanh nghiệp và phân tích dữ liệu lớn, Synapse cho phép người dùng nạp, chuẩn bị, quản lý và cung cấp dữ liệu để đáp ứng ngay các nhu cầu về trí tuệ doanh nghiệp và học máy. Dịch vụ mạnh mẽ này hỗ trợ nhiều ngôn ngữ như SQL, Python và Spark, giúp mở rộng khả năng xử lý và chuyển đổi dữ liệu. Hơn nữa, kiến trúc serverless của nó đảm bảo khả năng mở rộng để xử lý mọi khối lượng dữ liệu, khiến đây trở thành công cụ không thể thiếu đối với các chuyên gia dữ liệu hiện đại.
Hướng dẫn này cung cấp các chủ đề và câu hỏi trọng yếu giúp bạn chuẩn bị cho buổi phỏng vấn về Synapse. Những câu hỏi này phản ánh kinh nghiệm của chính tôi trong việc phỏng vấn và làm việc với các chuyên gia dữ liệu sử dụng Synapse, mang đến góc nhìn giá trị về những gì nhà tuyển dụng tìm kiếm.
Bên cạnh việc ôn tập theo hướng dẫn này, tôi khuyên bạn nên xem qua Tài liệu Microsoft Azure Synapse Analytics cho các câu hỏi cụ thể bạn có thể gặp trong quá trình học.
Câu hỏi phỏng vấn Synapse cơ bản
Ở mức cơ bản, câu hỏi sẽ bao quát kiến thức nền tảng của bạn về Synapse, gồm các tác vụ như điều hướng trong Synapse Studio, hiểu các thành phần cốt lõi và thực hiện khám phá dữ liệu đơn giản. Hãy kỳ vọng những câu hỏi này nếu bạn có ít kinh nghiệm với Synapse hoặc nếu người phỏng vấn đang đánh giá mức hiểu biết nền tảng của bạn.
Bạn cần nắm vững những chủ đề chính nào?
Nếu được yêu cầu trình bày tổng quan cấp cao về Synapse, bạn nên có khả năng mô tả Synapse Analytics và vai trò của nó trong bức tranh dữ liệu hiện đại.
- Tính năng cốt lõi và giao diện người dùng: Hiểu Synapse Studio, các hub khác nhau (Data, Develop, Integrate, Monitor, Manage) và chức năng của chúng.
- Các trường hợp sử dụng đơn giản: Đưa ra ví dụ về cách các tổ chức dùng Synapse, bao gồm một số hiểu biết kiến trúc cơ bản.
Microsoft Synapse Analytics là gì và các tính năng chính của nó là gì?
Synapse Analytics là một dịch vụ phân tích không giới hạn, kết hợp kho dữ liệu doanh nghiệp và phân tích dữ liệu lớn. Các tính năng chính bao gồm:
- SQL Pool (Data Warehouse): Công cụ truy vấn phân tán cho phân tích hiệu năng cao trên dữ liệu có cấu trúc.
- Spark Pool: Tích hợp với Apache Spark để xử lý dữ liệu lớn và học máy.
- Hỗ trợ Data Lake: Tích hợp gốc với Azure Data Lake Storage Gen2 để phân tích dữ liệu tại chỗ.
- Synapse Studio: Không gian làm việc hợp nhất cho chuẩn bị dữ liệu, kho dữ liệu, phân tích dữ liệu lớn và tác vụ AI.
- Tích hợp dữ liệu: Khả năng tích hợp dữ liệu tích hợp sẵn với Azure Data Factory.
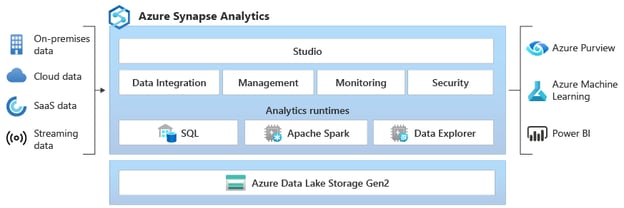
Giải thích kiến trúc cốt lõi của Synapse Analytics.
Kiến trúc cốt lõi bao gồm:
- Synapse Studio: Giao diện trung tâm cho mọi hoạt động của Synapse.
- SQL Pools: Cung cấp khả năng truy vấn dựa trên T-SQL cho dữ liệu có cấu trúc. Dedicated SQL pools cung cấp tài nguyên được đảm bảo, trong khi serverless SQL pools cho phép truy vấn theo nhu cầu dữ liệu trong data lake.
- Spark Pools: Cung cấp Apache Spark dưới dạng dịch vụ cho xử lý dữ liệu lớn, kỹ thuật dữ liệu và tác vụ học máy.
- Data Lake Storage: Azure Data Lake Storage Gen2 là nền tảng lưu trữ khối lượng lớn dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc.
- Pipelines: Các đường ống tích hợp dữ liệu do Azure Data Factory cung cấp cho quy trình ETL/ELT.
Bạn truy vấn dữ liệu trong Synapse Analytics như thế nào?
Bạn có thể truy vấn dữ liệu trong Synapse bằng:
- T-SQL: Sử dụng SQL Pool cho dữ liệu có cấu trúc.
- Spark SQL: Sử dụng Spark Pools cho dữ liệu trong data lake.
- Serverless SQL Pool: Truy vấn trực tiếp dữ liệu trong data lake bằng T-SQL mà không cần cấp phát tài nguyên.
Câu hỏi phỏng vấn Synapse trung cấp
Những câu hỏi này đánh giá hiểu biết sâu hơn của bạn về Synapse và cách cấu hình. Bạn cần thể hiện khả năng quản lý tài nguyên, triển khai quy trình xử lý dữ liệu và tối ưu hiệu năng.
Điều này xây dựng dựa trên kiến thức cơ bản và đòi hỏi hiểu biết về:
- Quản lý tài nguyên: Cách cấp phát và quản lý SQL Pools và Spark Pools.
- Tích hợp dữ liệu: Tạo và quản lý đường ống dữ liệu bằng Synapse Pipelines (Azure Data Factory).
- Tinh chỉnh hiệu năng: Hiểu kỹ thuật tối ưu truy vấn và chiến lược phân vùng dữ liệu.
Bạn tạo và quản lý SQL Pools trong Synapse Analytics như thế nào?
Để tạo SQL Pool, bạn điều hướng đến Synapse Studio, chọn hub "Manage", rồi "SQL pools." Sau đó bạn có thể cấu hình mức hiệu năng của pool (Đơn vị Kho Dữ liệu - DWUs) dựa trên yêu cầu khối lượng công việc.
Việc quản lý bao gồm theo dõi hiệu năng, co giãn tài nguyên và tạm dừng/tiếp tục pool khi cần.
Giải thích cách Spark được sử dụng trong Synapse Analytics.
Synapse sử dụng Spark Pools để cung cấp Apache Spark dưới dạng dịch vụ. Điều này cho phép bạn:
- Xử lý các tập dữ liệu lớn bằng Spark DataFrames.
- Thực hiện các tác vụ kỹ thuật dữ liệu bằng các ngôn ngữ như Python, Scala và Java.
- Xây dựng và huấn luyện mô hình học máy bằng Spark MLlib.
Data pipelines là gì và bạn tạo chúng trong Synapse như thế nào?
Data pipelines là các quy trình tự động để nạp, chuyển đổi và tải dữ liệu. Trong Synapse, bạn tạo chúng bằng hub "Integrate", nơi cung cấp giao diện trực quan (Azure Data Factory) để thiết kế và quản lý pipelines.
Các pipeline này có thể kết nối đến nhiều nguồn dữ liệu, thực hiện chuyển đổi bằng các hoạt động như data flow hoặc thực thi stored procedure, và tải dữ liệu vào hệ thống đích.
Bạn theo dõi và quản lý tài nguyên trong Synapse Analytics như thế nào?
Bạn có thể giám sát tài nguyên qua hub "Monitor" trong Synapse Studio. Hub này cung cấp thông tin chuyên sâu về hiệu năng của SQL Pool và Spark Pool, các lần thực thi pipeline, và tình trạng tổng thể của hệ thống. Bạn cũng có thể dùng Azure Monitor để theo dõi chi tiết hơn và thiết lập cảnh báo.
Mô tả các tùy chọn lưu trữ dữ liệu có sẵn trong Synapse Analytics?
Synapse Analytics cung cấp nhiều tùy chọn lưu trữ dữ liệu để đáp ứng các nhu cầu và kịch bản khác nhau, đảm bảo tính linh hoạt và hiệu quả khi xử lý tập dữ liệu đa dạng. Các tùy chọn này bao gồm:
- Azure Data Lake Storage Gen2: Lưu trữ chính cho data lake, được tối ưu cho phân tích quy mô lớn.
- Lưu trữ SQL pool: Lưu trữ dữ liệu có cấu trúc trong kho dữ liệu.
- Azure Blob Storage: Có thể dùng để lưu trữ dữ liệu, mặc dù Data Lake Storage Gen2 thường được ưa chuộng hơn cho khối lượng công việc phân tích.
Câu hỏi phỏng vấn Synapse nâng cao
Người dùng nâng cao được kỳ vọng xử lý tối ưu hiệu năng, tạo quy trình làm việc phức tạp và triển khai các mô hình phân tích, học máy tinh vi. Những câu hỏi này thường dành cho vị trí dữ liệu cấp cao hoặc vai trò có thành phần DevOps.
Điều này xây dựng trên kiến thức cơ bản và trung cấp, đòi hỏi kinh nghiệm thực tiễn về:
- Tối ưu hiệu năng: Tinh chỉnh cấu hình SQL Pool và Spark Pool, tối ưu truy vấn và quản lý phân vùng dữ liệu.
- Học máy: Tích hợp Synapse với Azure Machine Learning, triển khai mô hình và quản lý vòng đời mô hình.
- Pipeline CI/CD: Triển khai tích hợp liên tục và triển khai liên tục cho các giải pháp Synapse.
Bạn sử dụng những chiến lược nào để tối ưu hiệu năng trong Synapse?
Lập chỉ mục phù hợp: Tối ưu hiệu năng SQL Pool bằng cách sử dụng clustered columnstore index và các non-clustered index phù hợp.
- Phân vùng dữ liệu: Phân vùng dữ liệu trong SQL Pools và Data Lake Storage dựa trên mẫu truy vấn để cải thiện hiệu năng.
- Tối ưu truy vấn: Dùng gợi ý truy vấn, viết lại các truy vấn phức tạp và phân tích kế hoạch thực thi để xác định nút nghẽn.
- Phân bổ tài nguyên: Chọn kích thước phù hợp cho SQL Pools và Spark Pools dựa trên yêu cầu tải công việc.
Bạn có thể triển khai pipeline CI/CD cho Synapse Analytics như thế nào?
Sử dụng Azure DevOps hoặc GitHub Actions để tự động hóa việc xây dựng, kiểm thử và triển khai các giải pháp Synapse. Điều này bao gồm:
- Quản lý mã nguồn: Lưu trữ các artifact của Synapse (script SQL, notebook Spark, pipeline) trong hệ thống quản lý phiên bản.
- Kiểm thử tự động: Triển khai kiểm thử đơn vị và kiểm thử tích hợp cho script SQL và pipeline dữ liệu.
- Triển khai tự động: Dùng Azure Resource Manager (ARM) templates hoặc Synapse APIs để triển khai thay đổi lên các môi trường khác nhau (dev, test, prod).
Giải thích cách xử lý phân tích phức tạp trong Synapse Analytics?
Xử lý phân tích phức tạp và đảm bảo vận hành dữ liệu trơn tru trong Synapse Analytics đòi hỏi một cách tiếp cận đa chiều. Điều này bao gồm kiểm thử tự động, chiến lược triển khai và các kỹ thuật phân tích nâng cao.
Dưới đây là những phương pháp thiết yếu để đạt được các mục tiêu này một cách hiệu quả:
- Truy vấn SQL nâng cao: Tận dụng window functions, common table expressions (CTE) và các tính năng T-SQL nâng cao khác cho phân tích dữ liệu phức tạp trong SQL Pools.
- Spark cho xử lý dữ liệu lớn: Sử dụng Spark Pools để xử lý tập dữ liệu lớn, thực hiện các biến đổi phức tạp và xây dựng mô hình học máy.
- Tích hợp với Azure Machine Learning: Tận dụng Azure Machine Learning cho các kịch bản phân tích nâng cao, như mô hình dự đoán và phát hiện bất thường.
Bạn triển khai các mô hình học máy trong Synapse Analytics như thế nào?
Triển khai mô hình học máy trong Synapse Analytics bao gồm một số bước chủ chốt, từ huấn luyện và đăng ký mô hình đến triển khai để sử dụng thực tế. Dưới đây là cách tiếp cận có cấu trúc để triển khai mô hình học máy thành công:
- Huấn luyện mô hình: Huấn luyện mô hình học máy bằng Spark MLlib trong Synapse hoặc Azure Machine Learning.
- Đăng ký mô hình: Đăng ký các mô hình đã huấn luyện trong Azure Machine Learning Model Registry.
- Triển khai mô hình: Triển khai mô hình dưới dạng các endpoint REST bằng Azure Machine Learning hoặc tích hợp vào các pipeline Synapse để chấm điểm theo lô.
Câu hỏi phỏng vấn Synapse cho vai trò Kỹ sư Dữ liệu
Kỹ sư Dữ liệu chịu trách nhiệm thiết kế, xây dựng và duy trì các pipeline dữ liệu, đảm bảo chất lượng dữ liệu và tối ưu hiệu năng. Đối với các vị trí Kỹ sư Dữ liệu tập trung vào Synapse, bạn nên hiểu:
- Kiến trúc Pipeline dữ liệu: Thiết kế các pipeline dữ liệu có thể mở rộng và đáng tin cậy cho quy trình ETL/ELT.
- Xử lý thời gian thực: Triển khai nạp và xử lý dữ liệu thời gian thực bằng Azure Event Hubs, Azure Stream Analytics và Synapse.
- Bảo mật dữ liệu: Triển khai các biện pháp bảo mật để bảo vệ dữ liệu khi lưu trữ và khi truyền.
Bạn thiết kế các pipeline dữ liệu trong Synapse Analytics như thế nào?
Khi thiết kế các pipeline dữ liệu trong Synapse Analytics, cần xem xét một số thành phần quan trọng để đảm bảo xử lý dữ liệu hiệu quả và đáng tin cậy:
- Xác định nguồn dữ liệu: Xác định các nguồn dữ liệu (ví dụ: cơ sở dữ liệu, API, tệp) và phương thức nạp của chúng.
- Thiết kế quy trình ETL/ELT: Tạo các pipeline dữ liệu bằng Synapse Pipelines (Azure Data Factory) để trích xuất, chuyển đổi và tải dữ liệu.
- Triển khai kiểm tra chất lượng dữ liệu: Thêm các bước xác thực dữ liệu và xử lý lỗi để đảm bảo chất lượng dữ liệu.
- Tự động hóa thực thi pipeline: Lên lịch cho các pipeline chạy tự động bằng triggers và lịch thực thi.
Các thực tiễn tốt nhất cho quy trình ETL trong Synapse Analytics là gì?
Trong bối cảnh Synapse Analytics, triển khai các quy trình ETL (Extract, Transform, Load) hiệu quả là điều tối quan trọng để đảm bảo quản lý và phân tích dữ liệu hiệu quả. Các thực tiễn tốt nhất sau đây được khuyến nghị để tối ưu quy trình ETL trong Synapse Analytics:
- Sử dụng Delta Lake: Dùng Delta Lake để lưu trữ dữ liệu trong data lake nhằm hỗ trợ giao dịch ACID và phiên bản dữ liệu.
- Mã nguồn dạng mô-đun: Viết mã mang tính mô-đun và có thể tái sử dụng trong notebook Synapse và script SQL.
- Tham số hóa: Tham số hóa pipeline và script SQL để linh hoạt và tái sử dụng tốt hơn.
- Giám sát: Theo dõi các lần thực thi và hiệu năng của pipeline bằng Synapse Studio và Azure Monitor.
Bạn xử lý xử lý dữ liệu thời gian thực trong Synapse như thế nào?
Là một kỹ sư dữ liệu, bạn sẽ gặp nhiều thách thức đòi hỏi giải pháp sáng tạo và phương pháp vững vàng. Làm việc với dữ liệu thời gian thực là một trong số đó. Dưới đây là một số kinh nghiệm và kỹ thuật thường được áp dụng:
- Nạp dữ liệu thời gian thực: Sử dụng Azure Event Hubs hoặc Azure IoT Hub để nạp các luồng dữ liệu thời gian thực.
- Xử lý dữ liệu với Stream Analytics: Dùng Azure Stream Analytics để thực hiện biến đổi và tổng hợp theo thời gian thực.
- Tải dữ liệu vào Synapse: Tải dữ liệu đã xử lý vào SQL Pools hoặc Data Lake Storage để phục vụ phân tích thời gian thực.
Bạn đảm bảo bảo mật dữ liệu trong Synapse Analytics như thế nào?
Đảm bảo bảo mật dữ liệu trong Synapse Analytics là tối quan trọng để bảo vệ thông tin nhạy cảm và tuân thủ các tiêu chuẩn quy định. Có thể triển khai một số chiến lược chủ chốt để bảo vệ dữ liệu trong môi trường Synapse:
- Kiểm soát truy cập: Áp dụng kiểm soát truy cập dựa trên vai trò (RBAC) để quản lý quyền với tài nguyên Synapse.
- Mã hóa dữ liệu: Bật mã hóa khi lưu trữ và khi truyền bằng Azure Key Vault.
- Bảo mật mạng: Dùng tích hợp mạng ảo (VNet) và private endpoint để bảo mật truy cập mạng.
- Ghi nhật ký kiểm toán: Bật auditing để theo dõi hoạt động người dùng và truy cập dữ liệu.
- Che giấu dữ liệu: Triển khai data masking để bảo vệ dữ liệu nhạy cảm.
Lời kết
Hướng dẫn này đã trang bị cho bạn những hiểu biết then chốt để tự tin đối mặt với buổi phỏng vấn Microsoft Synapse Analytics, dù bạn là kỹ sư dữ liệu hay kỹ sư phần mềm.
Hãy nhớ thể hiện không chỉ kiến thức lý thuyết mà còn cả kinh nghiệm thực tế trong thiết kế pipeline dữ liệu, tối ưu hiệu năng và đảm bảo bảo mật dữ liệu vững chắc.
Vượt lên trên khía cạnh kỹ thuật, hãy nhấn mạnh kỹ năng giải quyết vấn đề và khả năng học hỏi liên tục của bạn, vì Synapse Analytics là một nền tảng phát triển nhanh chóng. Luôn tò mò, tiếp tục khám phá tài nguyên của Microsoft và thể hiện niềm đam mê khai thác dữ liệu để tạo ra tác động kinh doanh rõ rệt. Chúc bạn may mắn!


Microsoft Synapse Analytics, trước đây gọi là Azure SQL Data Warehouse, là một dịch vụ phân tích tích hợp cung cấp nền tảng thống nhất cho dữ liệu lớn và kho dữ liệu.
Bằng cách kết hợp liền mạch kho dữ liệu doanh nghiệp và phân tích dữ liệu lớn, Synapse cho phép người dùng nạp, chuẩn bị, quản lý và cung cấp dữ liệu để đáp ứng ngay các nhu cầu về trí tuệ doanh nghiệp và học máy. Dịch vụ mạnh mẽ này hỗ trợ nhiều ngôn ngữ như SQL, Python và Spark, giúp mở rộng khả năng xử lý và chuyển đổi dữ liệu. Hơn nữa, kiến trúc serverless của nó đảm bảo khả năng mở rộng để xử lý mọi khối lượng dữ liệu, khiến đây trở thành công cụ không thể thiếu đối với các chuyên gia dữ liệu hiện đại.
Hướng dẫn này cung cấp các chủ đề và câu hỏi trọng yếu giúp bạn chuẩn bị cho buổi phỏng vấn về Synapse. Những câu hỏi này phản ánh kinh nghiệm của chính tôi trong việc phỏng vấn và làm việc với các chuyên gia dữ liệu sử dụng Synapse, mang đến góc nhìn giá trị về những gì nhà tuyển dụng tìm kiếm.
Bên cạnh việc ôn tập theo hướng dẫn này, tôi khuyên bạn nên xem qua Tài liệu Microsoft Azure Synapse Analytics cho các câu hỏi cụ thể bạn có thể gặp trong quá trình học.
Câu hỏi phỏng vấn Synapse cơ bản
Ở mức cơ bản, câu hỏi sẽ bao quát kiến thức nền tảng của bạn về Synapse, gồm các tác vụ như điều hướng trong Synapse Studio, hiểu các thành phần cốt lõi và thực hiện khám phá dữ liệu đơn giản. Hãy kỳ vọng những câu hỏi này nếu bạn có ít kinh nghiệm với Synapse hoặc nếu người phỏng vấn đang đánh giá mức hiểu biết nền tảng của bạn.
Bạn cần nắm vững những chủ đề chính nào?
Nếu được yêu cầu trình bày tổng quan cấp cao về Synapse, bạn nên có khả năng mô tả Synapse Analytics và vai trò của nó trong bức tranh dữ liệu hiện đại.
Microsoft Synapse Analytics là gì và các tính năng chính của nó là gì?
Synapse Analytics là một dịch vụ phân tích không giới hạn, kết hợp kho dữ liệu doanh nghiệp và phân tích dữ liệu lớn. Các tính năng chính bao gồm:
Giải thích kiến trúc cốt lõi của Synapse Analytics.
Kiến trúc cốt lõi bao gồm:
Bạn truy vấn dữ liệu trong Synapse Analytics như thế nào?
Bạn có thể truy vấn dữ liệu trong Synapse bằng:
Câu hỏi phỏng vấn Synapse trung cấp
Những câu hỏi này đánh giá hiểu biết sâu hơn của bạn về Synapse và cách cấu hình. Bạn cần thể hiện khả năng quản lý tài nguyên, triển khai quy trình xử lý dữ liệu và tối ưu hiệu năng.
Điều này xây dựng dựa trên kiến thức cơ bản và đòi hỏi hiểu biết về:
Bạn tạo và quản lý SQL Pools trong Synapse Analytics như thế nào?
Để tạo SQL Pool, bạn điều hướng đến Synapse Studio, chọn hub "Manage", rồi "SQL pools." Sau đó bạn có thể cấu hình mức hiệu năng của pool (Đơn vị Kho Dữ liệu - DWUs) dựa trên yêu cầu khối lượng công việc.
Việc quản lý bao gồm theo dõi hiệu năng, co giãn tài nguyên và tạm dừng/tiếp tục pool khi cần.
Giải thích cách Spark được sử dụng trong Synapse Analytics.
Synapse sử dụng Spark Pools để cung cấp Apache Spark dưới dạng dịch vụ. Điều này cho phép bạn:
Data pipelines là gì và bạn tạo chúng trong Synapse như thế nào?
Data pipelines là các quy trình tự động để nạp, chuyển đổi và tải dữ liệu. Trong Synapse, bạn tạo chúng bằng hub "Integrate", nơi cung cấp giao diện trực quan (Azure Data Factory) để thiết kế và quản lý pipelines.
Các pipeline này có thể kết nối đến nhiều nguồn dữ liệu, thực hiện chuyển đổi bằng các hoạt động như data flow hoặc thực thi stored procedure, và tải dữ liệu vào hệ thống đích.
Bạn theo dõi và quản lý tài nguyên trong Synapse Analytics như thế nào?
Bạn có thể giám sát tài nguyên qua hub "Monitor" trong Synapse Studio. Hub này cung cấp thông tin chuyên sâu về hiệu năng của SQL Pool và Spark Pool, các lần thực thi pipeline, và tình trạng tổng thể của hệ thống. Bạn cũng có thể dùng Azure Monitor để theo dõi chi tiết hơn và thiết lập cảnh báo.
Mô tả các tùy chọn lưu trữ dữ liệu có sẵn trong Synapse Analytics?
Synapse Analytics cung cấp nhiều tùy chọn lưu trữ dữ liệu để đáp ứng các nhu cầu và kịch bản khác nhau, đảm bảo tính linh hoạt và hiệu quả khi xử lý tập dữ liệu đa dạng. Các tùy chọn này bao gồm:
Câu hỏi phỏng vấn Synapse nâng cao
Người dùng nâng cao được kỳ vọng xử lý tối ưu hiệu năng, tạo quy trình làm việc phức tạp và triển khai các mô hình phân tích, học máy tinh vi. Những câu hỏi này thường dành cho vị trí dữ liệu cấp cao hoặc vai trò có thành phần DevOps.
Điều này xây dựng trên kiến thức cơ bản và trung cấp, đòi hỏi kinh nghiệm thực tiễn về:
Bạn sử dụng những chiến lược nào để tối ưu hiệu năng trong Synapse?
Lập chỉ mục phù hợp: Tối ưu hiệu năng SQL Pool bằng cách sử dụng clustered columnstore index và các non-clustered index phù hợp.
Bạn có thể triển khai pipeline CI/CD cho Synapse Analytics như thế nào?
Sử dụng Azure DevOps hoặc GitHub Actions để tự động hóa việc xây dựng, kiểm thử và triển khai các giải pháp Synapse. Điều này bao gồm:
Giải thích cách xử lý phân tích phức tạp trong Synapse Analytics?
Xử lý phân tích phức tạp và đảm bảo vận hành dữ liệu trơn tru trong Synapse Analytics đòi hỏi một cách tiếp cận đa chiều. Điều này bao gồm kiểm thử tự động, chiến lược triển khai và các kỹ thuật phân tích nâng cao.
Dưới đây là những phương pháp thiết yếu để đạt được các mục tiêu này một cách hiệu quả:
Bạn triển khai các mô hình học máy trong Synapse Analytics như thế nào?
Triển khai mô hình học máy trong Synapse Analytics bao gồm một số bước chủ chốt, từ huấn luyện và đăng ký mô hình đến triển khai để sử dụng thực tế. Dưới đây là cách tiếp cận có cấu trúc để triển khai mô hình học máy thành công:
Câu hỏi phỏng vấn Synapse cho vai trò Kỹ sư Dữ liệu
Kỹ sư Dữ liệu chịu trách nhiệm thiết kế, xây dựng và duy trì các pipeline dữ liệu, đảm bảo chất lượng dữ liệu và tối ưu hiệu năng. Đối với các vị trí Kỹ sư Dữ liệu tập trung vào Synapse, bạn nên hiểu:
Bạn thiết kế các pipeline dữ liệu trong Synapse Analytics như thế nào?
Khi thiết kế các pipeline dữ liệu trong Synapse Analytics, cần xem xét một số thành phần quan trọng để đảm bảo xử lý dữ liệu hiệu quả và đáng tin cậy:
Các thực tiễn tốt nhất cho quy trình ETL trong Synapse Analytics là gì?
Trong bối cảnh Synapse Analytics, triển khai các quy trình ETL (Extract, Transform, Load) hiệu quả là điều tối quan trọng để đảm bảo quản lý và phân tích dữ liệu hiệu quả. Các thực tiễn tốt nhất sau đây được khuyến nghị để tối ưu quy trình ETL trong Synapse Analytics:
Bạn xử lý xử lý dữ liệu thời gian thực trong Synapse như thế nào?
Là một kỹ sư dữ liệu, bạn sẽ gặp nhiều thách thức đòi hỏi giải pháp sáng tạo và phương pháp vững vàng. Làm việc với dữ liệu thời gian thực là một trong số đó. Dưới đây là một số kinh nghiệm và kỹ thuật thường được áp dụng:
Bạn đảm bảo bảo mật dữ liệu trong Synapse Analytics như thế nào?
Đảm bảo bảo mật dữ liệu trong Synapse Analytics là tối quan trọng để bảo vệ thông tin nhạy cảm và tuân thủ các tiêu chuẩn quy định. Có thể triển khai một số chiến lược chủ chốt để bảo vệ dữ liệu trong môi trường Synapse:
Lời kết
Hướng dẫn này đã trang bị cho bạn những hiểu biết then chốt để tự tin đối mặt với buổi phỏng vấn Microsoft Synapse Analytics, dù bạn là kỹ sư dữ liệu hay kỹ sư phần mềm.
Hãy nhớ thể hiện không chỉ kiến thức lý thuyết mà còn cả kinh nghiệm thực tế trong thiết kế pipeline dữ liệu, tối ưu hiệu năng và đảm bảo bảo mật dữ liệu vững chắc.
Vượt lên trên khía cạnh kỹ thuật, hãy nhấn mạnh kỹ năng giải quyết vấn đề và khả năng học hỏi liên tục của bạn, vì Synapse Analytics là một nền tảng phát triển nhanh chóng. Luôn tò mò, tiếp tục khám phá tài nguyên của Microsoft và thể hiện niềm đam mê khai thác dữ liệu để tạo ra tác động kinh doanh rõ rệt. Chúc bạn may mắn!