Microsoft Synapse Analytics, in precedenza noto come Azure SQL Data Warehouse, è un servizio di analisi integrato che offre una piattaforma unificata per big data e data warehousing.
Combinando senza soluzione di continuità l’enterprise data warehousing con l’analisi dei big data, Synapse ti consente di acquisire, preparare, gestire e fornire dati per esigenze immediate di business intelligence e machine learning. Questo potente servizio supporta più linguaggi come SQL, Python e Spark, abilitando un’ampia gamma di capacità di elaborazione e trasformazione dei dati. Inoltre, la sua architettura serverless garantisce la scalabilità per gestire qualsiasi volume di dati, rendendolo uno strumento indispensabile per i professionisti dei dati moderni.
Questa guida propone argomenti e domande essenziali per aiutarti a prepararti al colloquio su Synapse. Le domande riflettono la mia esperienza diretta nel colloquiare e lavorare con professionisti dei dati che usano Synapse, offrendo indicazioni utili su cosa cercano i responsabili delle assunzioni.
Oltre a seguire questa guida al colloquio, ti consiglio di consultare la Documentazione di Microsoft Azure Synapse Analytics per eventuali domande specifiche che potresti avere lungo il percorso.
Domande di base su Synapse
A livello base, le domande copriranno le tue conoscenze fondamentali di Synapse, incluse attività come la navigazione in Synapse Studio, la comprensione dei suoi componenti principali e l’esecuzione di semplici esplorazioni dei dati. Aspettati queste domande se hai un’esperienza limitata con Synapse o se l’intervistatore sta valutando la tua comprensione di base.
Quali sono gli argomenti chiave con cui dovresti avere familiarità?
Se ti viene chiesto di fornire una panoramica ad alto livello di Synapse, dovresti essere in grado di descrivere Synapse Analytics e il suo ruolo nel moderno panorama dei dati.
- Funzionalità di base e interfaccia utente: Comprendere Synapse Studio, i suoi diversi hub (Data, Develop, Integrate, Monitor, Manage) e le rispettive funzionalità.
- Casi d’uso semplici: Fornire esempi di come le organizzazioni utilizzano Synapse, inclusi cenni all’architettura di base.
Che cos’è Microsoft Synapse Analytics e quali sono le sue funzionalità chiave?
Synapse Analytics è un servizio di analisi illimitato che unisce data warehousing aziendale e big data analytics. Le funzionalità chiave includono:
- SQL Pool (Data Warehouse): Un motore di query distribuito per analisi ad alte prestazioni su dati strutturati.
- Spark Pool: Integrazione con Apache Spark per l’elaborazione di big data e il machine learning.
- Supporto Data Lake: Integrazione nativa con Azure Data Lake Storage Gen2 per analizzare i dati in-place.
- Synapse Studio: Uno workspace unificato per preparazione dei dati, data warehousing, big data analytics e attività di AI.
- Integrazione dei dati: Capacità di integrazione dati integrate con Azure Data Factory.
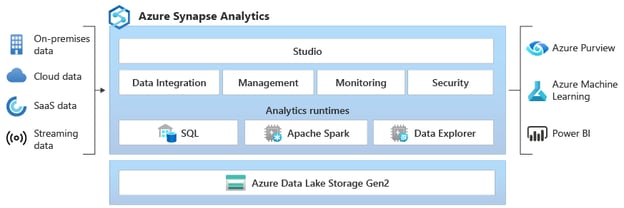
Spiega l’architettura di base di Synapse Analytics.
L’architettura di base include:
- Synapse Studio: L’interfaccia centrale per tutte le attività in Synapse.
- SQL Pools: Forniscono capacità di interrogazione basate su T-SQL per dati strutturati. I pool SQL dedicati garantiscono risorse, mentre i pool SQL serverless offrono query on-demand dei dati nel data lake.
- Spark Pools: Offrono Apache Spark come servizio per big data processing, data engineering e attività di machine learning.
- Data Lake Storage: Azure Data Lake Storage Gen2 funge da base per archiviare grandi volumi di dati strutturati, semi-strutturati e non strutturati.
- Pipelines: Pipeline di integrazione dati basate su Azure Data Factory per processi ETL/ELT.
Come interroghi i dati in Synapse Analytics?
Puoi interrogare i dati in Synapse usando:
- T-SQL: Usando il SQL Pool per dati strutturati.
- Spark SQL: Usando gli Spark Pool per i dati nel data lake.
- Serverless SQL Pool: Interroga direttamente i dati nel data lake usando T-SQL senza effettuare il provisioning di risorse.
Domande intermedie su Synapse
Queste domande valutano la tua comprensione più approfondita di Synapse e della sua configurazione. Dovrai dimostrare la capacità di gestire risorse, implementare workflow di elaborazione dati e ottimizzare le prestazioni.
Questo livello si basa sulle conoscenze di base e richiede comprensione di:
- Gestione delle risorse: Come effettuare il provisioning e gestire SQL Pool e Spark Pool.
- Integrazione dei dati: Creare e gestire pipeline dati usando Synapse Pipelines (Azure Data Factory).
- Ottimizzazione delle prestazioni: Comprendere tecniche di ottimizzazione delle query e strategie di partizionamento dei dati.
Come crei e gestisci i SQL Pool in Synapse Analytics?
Per creare un SQL Pool, vai in Synapse Studio, seleziona l’hub "Manage" e poi "SQL pools". Puoi quindi configurare il livello di prestazioni del pool (Data Warehouse Units - DWU) in base ai requisiti del carico di lavoro.
La gestione prevede il monitoraggio delle prestazioni, la scalabilità delle risorse e la sospensione/ripresa del pool secondo necessità.
Spiega come viene usato Spark in Synapse Analytics.
Synapse utilizza gli Spark Pool per offrire Apache Spark come servizio. Questo ti consente di:
- Elaborare grandi dataset usando gli Spark DataFrame.
- Svolgere attività di data engineering con linguaggi come Python, Scala e Java.
- Creare e addestrare modelli di machine learning usando Spark MLlib.
Cosa sono le data pipeline e come le crei in Synapse?
Le data pipeline sono workflow automatizzati per ingestione, trasformazione e caricamento dei dati. In Synapse le crei usando l’hub "Integrate", che fornisce un’interfaccia visiva (Azure Data Factory) per progettare e gestire le pipeline.
Queste pipeline possono connettersi a varie origini dati, eseguire trasformazioni tramite attività come data flow o esecuzione di stored procedure e caricare i dati nei sistemi di destinazione.
Come monitori e gestisci le risorse in Synapse Analytics?
Puoi monitorare le risorse tramite l’hub "Monitor" in Synapse Studio. Questo hub fornisce insight su prestazioni di SQL Pool e Spark Pool, esecuzioni delle pipeline e stato generale del sistema. Puoi anche usare Azure Monitor per un monitoraggio e un sistema di avvisi più dettagliati.
Descrivi le opzioni di archiviazione dati disponibili in Synapse Analytics?
Synapse Analytics offre diverse opzioni di archiviazione dati per soddisfare esigenze e scenari differenti, garantendo flessibilità ed efficienza nella gestione di dataset eterogenei. Queste opzioni includono:
- Azure Data Lake Storage Gen2: Archiviazione primaria per il data lake, ottimizzata per analisi su larga scala.
- Archiviazione del SQL Pool: Archivia dati strutturati all’interno del data warehouse.
- Azure Blob Storage: Può essere usato per archiviare dati, sebbene per carichi analitici in genere sia preferito Data Lake Storage Gen2.
Domande avanzate su Synapse
Ci si aspetta che gli utenti avanzati gestiscano l’ottimizzazione delle prestazioni, creino workflow complessi e implementino modelli di analisi e machine learning sofisticati. Queste domande sono tipiche per ruoli senior nei dati o posizioni con una componente DevOps.
Questo livello si basa sulle conoscenze di base e intermedie, richiedendo esperienza pratica in:
- Ottimizzazione delle prestazioni: Tuning delle configurazioni di SQL Pool e Spark Pool, ottimizzazione delle query e gestione del partizionamento dei dati.
- Machine learning: Integrazione di Synapse con Azure Machine Learning, deployment dei modelli e gestione del ciclo di vita del modello.
- Pipeline CI/CD: Implementazione di integrazione e distribuzione continue per soluzioni Synapse.
Quali strategie usi per l’ottimizzazione delle prestazioni in Synapse?
Indicizzazione corretta: ottimizza le prestazioni dei SQL Pool usando indici columnstore clusterizzati e appropriati indici non clusterizzati.
- Partizionamento dei dati: Partiziona i dati nei SQL Pool e in Data Lake Storage in base ai pattern di query per migliorare le prestazioni.
- Ottimizzazione delle query: Usa hint di query, riscrivi query complesse e analizza i piani di esecuzione per individuare i colli di bottiglia.
- Allocazione delle risorse: Dimensiona correttamente SQL Pool e Spark Pool in base ai requisiti del carico di lavoro.
Come puoi implementare pipeline CI/CD per Synapse Analytics?
Usa Azure DevOps o GitHub Actions per automatizzare build, test e deployment delle soluzioni Synapse. Questo include:
- Controllo versione: Archivia gli artifact di Synapse (script SQL, notebook Spark, pipeline) in un sistema di versionamento.
- Test automatici: Implementa unit test e test di integrazione per script SQL e pipeline dati.
- Deployment automatico: Usa Azure Resource Manager (ARM) template o le API di Synapse per distribuire le modifiche in diversi ambienti (dev, test, prod).
Spiega come gestire analisi complesse in Synapse Analytics?
Gestire analisi complesse e garantire operazioni sui dati senza intoppi in Synapse Analytics richiede un approccio multifattoriale. Ciò comporta test automatici, strategie di deployment e tecniche analitiche avanzate.
Di seguito trovi metodi essenziali per raggiungere efficacemente questi obiettivi:
- Query SQL avanzate: utilizza funzioni finestra, common table expression (CTE) e altre funzionalità T-SQL avanzate per analisi complesse nei SQL Pool.
- Spark per l’elaborazione big data: usa gli Spark Pool per elaborare grandi dataset, eseguire trasformazioni complesse e costruire modelli di machine learning.
- Integrazione con Azure Machine Learning: sfrutta Azure Machine Learning per scenari di analisi avanzata, come modellazione predittiva e rilevamento anomalie.
Come distribuisci modelli di machine learning in Synapse Analytics?
La distribuzione di modelli di machine learning in Synapse Analytics prevede diversi passaggi chiave, dall’addestramento e registrazione alla messa in produzione. Ecco un approccio strutturato per distribuire con successo i modelli di machine learning:
- Addestra i modelli: Addestra modelli di machine learning usando Spark MLlib in Synapse o Azure Machine Learning.
- Registra i modelli: Registra i modelli addestrati nell’Azure Machine Learning Model Registry.
- Distribuisci i modelli: Distribuisci i modelli come endpoint REST usando Azure Machine Learning o integrali nelle pipeline Synapse per lo scoring batch.
Domande su Synapse per ruoli di Data Engineer
I Data Engineer sono responsabili della progettazione, costruzione e manutenzione delle pipeline dati, garantendo la qualità dei dati e ottimizzando le prestazioni. Per posizioni di Data Engineer focalizzate su Synapse, dovresti comprendere:
- Architettura delle pipeline dati: progettare pipeline dati scalabili e affidabili per processi ETL/ELT.
- Elaborazione in tempo reale: Implementare acquisizione ed elaborazione dei dati in tempo reale usando Azure Event Hubs, Azure Stream Analytics e Synapse.
- Sicurezza dei dati: Implementare misure di sicurezza per proteggere i dati a riposo e in transito.
Come progetti le pipeline dati in Synapse Analytics?
Quando progetti pipeline dati in Synapse Analytics, è necessario considerare diversi componenti chiave per garantire un’elaborazione efficiente e affidabile dei dati:
- Identifica le origini dati: Determina le origini dati (ad es., database, API, file) e i rispettivi metodi di ingestione.
- Progetta processi ETL/ELT: Crea pipeline dati usando Synapse Pipelines (Azure Data Factory) per estrarre, trasformare e caricare i dati.
- Implementa controlli di qualità dei dati: Aggiungi passaggi di validazione dei dati e gestione errori per garantire la qualità dei dati.
- Automatizza l’esecuzione delle pipeline: Pianifica l’esecuzione automatica delle pipeline usando trigger ed esecuzioni basate su schedule.
Quali sono le best practice per i processi ETL in Synapse Analytics?
Nel contesto di Synapse Analytics, implementare processi ETL (Extract, Transform, Load) efficaci è fondamentale per garantire una gestione e un’analisi dei dati efficienti. Si raccomandano le seguenti best practice per ottimizzare i processi ETL in Synapse Analytics:
- Usa Delta Lake: Utilizza Delta Lake per archiviare i dati nel data lake, abilitando transazioni ACID e versioning dei dati.
- Codice modulare: Scrivi codice modulare e riutilizzabile nei notebook di Synapse e negli script SQL.
- Parametrizzazione: Parametrizza pipeline e script SQL per renderli più flessibili e riutilizzabili.
- Monitoraggio: Monitora esecuzioni e prestazioni delle pipeline usando Synapse Studio e Azure Monitor.
Come gestisci l’elaborazione dei dati in tempo reale in Synapse?
Come data engineer, ci si imbatte in numerose sfide che richiedono soluzioni innovative e metodologie solide. Lavorare con dati in tempo reale è una di queste. Ecco alcune esperienze e tecniche comunemente impiegate:
- Acquisisci dati in tempo reale: Usa Azure Event Hubs o Azure IoT Hub per acquisire stream di dati in tempo reale.
- Elabora i dati con Stream Analytics: Usa Azure Stream Analytics per eseguire trasformazioni e aggregazioni in tempo reale.
- Carica i dati in Synapse: Carica i dati elaborati nei SQL Pool o in Data Lake Storage per analisi in tempo reale.
Come garantisci la sicurezza dei dati in Synapse Analytics?
Garantire la sicurezza dei dati in Synapse Analytics è fondamentale per proteggere le informazioni sensibili e mantenere la conformità alle normative. Si possono implementare diverse strategie chiave per salvaguardare i dati nell’ambiente Synapse:
- Controllo degli accessi: Implementa il role-based access control (RBAC) per gestire l’accesso alle risorse Synapse.
- Crittografia dei dati: Abilita la crittografia a riposo e in transito usando Azure Key Vault.
- Sicurezza di rete: Usa l’integrazione con virtual network (VNet) e private endpoint per proteggere l’accesso di rete.
- Auditing: Abilita l’auditing per tracciare l’attività degli utenti e gli accessi ai dati.
- Mascheramento dei dati: Implementa il data masking per proteggere i dati sensibili.
Considerazioni finali
Questa guida ti ha fornito indicazioni chiave per affrontare con sicurezza il colloquio su Microsoft Synapse Analytics, che tu sia un data engineer o un software engineer.
Ricorda di mostrare non solo la conoscenza teorica, ma anche l’esperienza pratica nel progettare pipeline dati, ottimizzare le prestazioni e garantire una solida sicurezza dei dati.
Oltre agli aspetti tecnici, metti in evidenza le tue capacità di problem solving e l’attitudine all’apprendimento continuo, poiché Synapse Analytics è una piattaforma in rapida evoluzione. Rimani curioso, continua a esplorare le risorse Microsoft e dimostra la tua passione per sfruttare i dati per risultati di business concreti. In bocca al lupo!






Microsoft Synapse Analytics, in precedenza noto come Azure SQL Data Warehouse, è un servizio di analisi integrato che offre una piattaforma unificata per big data e data warehousing.
Combinando senza soluzione di continuità l’enterprise data warehousing con l’analisi dei big data, Synapse ti consente di acquisire, preparare, gestire e fornire dati per esigenze immediate di business intelligence e machine learning. Questo potente servizio supporta più linguaggi come SQL, Python e Spark, abilitando un’ampia gamma di capacità di elaborazione e trasformazione dei dati. Inoltre, la sua architettura serverless garantisce la scalabilità per gestire qualsiasi volume di dati, rendendolo uno strumento indispensabile per i professionisti dei dati moderni.
Questa guida propone argomenti e domande essenziali per aiutarti a prepararti al colloquio su Synapse. Le domande riflettono la mia esperienza diretta nel colloquiare e lavorare con professionisti dei dati che usano Synapse, offrendo indicazioni utili su cosa cercano i responsabili delle assunzioni.
Oltre a seguire questa guida al colloquio, ti consiglio di consultare la Documentazione di Microsoft Azure Synapse Analytics per eventuali domande specifiche che potresti avere lungo il percorso.
Domande di base su Synapse
A livello base, le domande copriranno le tue conoscenze fondamentali di Synapse, incluse attività come la navigazione in Synapse Studio, la comprensione dei suoi componenti principali e l’esecuzione di semplici esplorazioni dei dati. Aspettati queste domande se hai un’esperienza limitata con Synapse o se l’intervistatore sta valutando la tua comprensione di base.
Quali sono gli argomenti chiave con cui dovresti avere familiarità?
Se ti viene chiesto di fornire una panoramica ad alto livello di Synapse, dovresti essere in grado di descrivere Synapse Analytics e il suo ruolo nel moderno panorama dei dati.
Che cos’è Microsoft Synapse Analytics e quali sono le sue funzionalità chiave?
Synapse Analytics è un servizio di analisi illimitato che unisce data warehousing aziendale e big data analytics. Le funzionalità chiave includono:
Spiega l’architettura di base di Synapse Analytics.
L’architettura di base include:
Come interroghi i dati in Synapse Analytics?
Puoi interrogare i dati in Synapse usando:
Domande intermedie su Synapse
Queste domande valutano la tua comprensione più approfondita di Synapse e della sua configurazione. Dovrai dimostrare la capacità di gestire risorse, implementare workflow di elaborazione dati e ottimizzare le prestazioni.
Questo livello si basa sulle conoscenze di base e richiede comprensione di:
Come crei e gestisci i SQL Pool in Synapse Analytics?
Per creare un SQL Pool, vai in Synapse Studio, seleziona l’hub "Manage" e poi "SQL pools". Puoi quindi configurare il livello di prestazioni del pool (Data Warehouse Units - DWU) in base ai requisiti del carico di lavoro.
La gestione prevede il monitoraggio delle prestazioni, la scalabilità delle risorse e la sospensione/ripresa del pool secondo necessità.
Spiega come viene usato Spark in Synapse Analytics.
Synapse utilizza gli Spark Pool per offrire Apache Spark come servizio. Questo ti consente di:
Cosa sono le data pipeline e come le crei in Synapse?
Le data pipeline sono workflow automatizzati per ingestione, trasformazione e caricamento dei dati. In Synapse le crei usando l’hub "Integrate", che fornisce un’interfaccia visiva (Azure Data Factory) per progettare e gestire le pipeline.
Queste pipeline possono connettersi a varie origini dati, eseguire trasformazioni tramite attività come data flow o esecuzione di stored procedure e caricare i dati nei sistemi di destinazione.
Come monitori e gestisci le risorse in Synapse Analytics?
Puoi monitorare le risorse tramite l’hub "Monitor" in Synapse Studio. Questo hub fornisce insight su prestazioni di SQL Pool e Spark Pool, esecuzioni delle pipeline e stato generale del sistema. Puoi anche usare Azure Monitor per un monitoraggio e un sistema di avvisi più dettagliati.
Descrivi le opzioni di archiviazione dati disponibili in Synapse Analytics?
Synapse Analytics offre diverse opzioni di archiviazione dati per soddisfare esigenze e scenari differenti, garantendo flessibilità ed efficienza nella gestione di dataset eterogenei. Queste opzioni includono:
Domande avanzate su Synapse
Ci si aspetta che gli utenti avanzati gestiscano l’ottimizzazione delle prestazioni, creino workflow complessi e implementino modelli di analisi e machine learning sofisticati. Queste domande sono tipiche per ruoli senior nei dati o posizioni con una componente DevOps.
Questo livello si basa sulle conoscenze di base e intermedie, richiedendo esperienza pratica in:
Quali strategie usi per l’ottimizzazione delle prestazioni in Synapse?
Indicizzazione corretta: ottimizza le prestazioni dei SQL Pool usando indici columnstore clusterizzati e appropriati indici non clusterizzati.
Come puoi implementare pipeline CI/CD per Synapse Analytics?
Usa Azure DevOps o GitHub Actions per automatizzare build, test e deployment delle soluzioni Synapse. Questo include:
Spiega come gestire analisi complesse in Synapse Analytics?
Gestire analisi complesse e garantire operazioni sui dati senza intoppi in Synapse Analytics richiede un approccio multifattoriale. Ciò comporta test automatici, strategie di deployment e tecniche analitiche avanzate.
Di seguito trovi metodi essenziali per raggiungere efficacemente questi obiettivi:
Come distribuisci modelli di machine learning in Synapse Analytics?
La distribuzione di modelli di machine learning in Synapse Analytics prevede diversi passaggi chiave, dall’addestramento e registrazione alla messa in produzione. Ecco un approccio strutturato per distribuire con successo i modelli di machine learning:
Domande su Synapse per ruoli di Data Engineer
I Data Engineer sono responsabili della progettazione, costruzione e manutenzione delle pipeline dati, garantendo la qualità dei dati e ottimizzando le prestazioni. Per posizioni di Data Engineer focalizzate su Synapse, dovresti comprendere:
Come progetti le pipeline dati in Synapse Analytics?
Quando progetti pipeline dati in Synapse Analytics, è necessario considerare diversi componenti chiave per garantire un’elaborazione efficiente e affidabile dei dati:
Quali sono le best practice per i processi ETL in Synapse Analytics?
Nel contesto di Synapse Analytics, implementare processi ETL (Extract, Transform, Load) efficaci è fondamentale per garantire una gestione e un’analisi dei dati efficienti. Si raccomandano le seguenti best practice per ottimizzare i processi ETL in Synapse Analytics:
Come gestisci l’elaborazione dei dati in tempo reale in Synapse?
Come data engineer, ci si imbatte in numerose sfide che richiedono soluzioni innovative e metodologie solide. Lavorare con dati in tempo reale è una di queste. Ecco alcune esperienze e tecniche comunemente impiegate:
Come garantisci la sicurezza dei dati in Synapse Analytics?
Garantire la sicurezza dei dati in Synapse Analytics è fondamentale per proteggere le informazioni sensibili e mantenere la conformità alle normative. Si possono implementare diverse strategie chiave per salvaguardare i dati nell’ambiente Synapse:
Considerazioni finali
Questa guida ti ha fornito indicazioni chiave per affrontare con sicurezza il colloquio su Microsoft Synapse Analytics, che tu sia un data engineer o un software engineer.
Ricorda di mostrare non solo la conoscenza teorica, ma anche l’esperienza pratica nel progettare pipeline dati, ottimizzare le prestazioni e garantire una solida sicurezza dei dati.
Oltre agli aspetti tecnici, metti in evidenza le tue capacità di problem solving e l’attitudine all’apprendimento continuo, poiché Synapse Analytics è una piattaforma in rapida evoluzione. Rimani curioso, continua a esplorare le risorse Microsoft e dimostra la tua passione per sfruttare i dati per risultati di business concreti. In bocca al lupo!