批处理与流处理是处理与分析数据的两种基本方法。理解这两种方法,有助于在不同的数据驱动场景中各取所长,从历史分析到实时决策皆然。
数据从业者应当了解两种方法的优劣,以及在其ETL 和 ELT 流程中分别该在何处实施。
本文将定义批处理与流处理、阐述它们的差异,并介绍如何为您的特定用例选择合适的方法。
什么是批处理?
批处理是一种方法,将收集到的大量数据分成若干块(批次)进行处理。
这种方法对资源密集型作业、重复性任务以及无需实时处理的超大数据集尤为有效。它非常适合数据仓库、ETL(抽取、转换、加载)以及大规模报表等应用。
由于能灵活满足多样化的业务需求,批处理依然是广泛采用的数据处理选择。
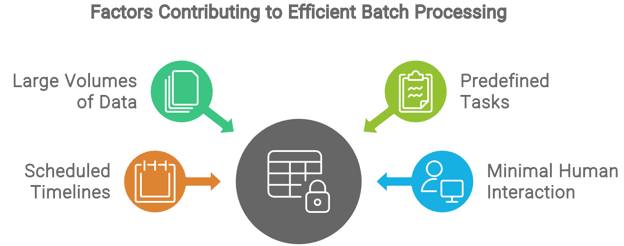
数据批处理主要是自动化的,一旦流程设定完成,几乎不需要人工干预。任务是预先定义好的,系统会按照预定时间表执行,通常选择在资源更充裕的业务低峰期。
人工参与通常仅限于初始参数配置、必要时的故障排查以及结果复核,使批处理成为管理大规模数据任务的高效、低接触方式。
用于批处理的ETL 工具种类繁多。常见工具之一是Apache Airflow,它可帮助用户迅速构建按计划运行、且易于监控的数据编排流水线。多做比较,选择最契合您业务需求的工具!
什么是流处理?
流处理(有时称为流式处理或实时数据处理)是一种数据处理方法,旨在数据在系统中流动的同时进行实时处理与分析。
与在预定时间间隔内收集并成批处理数据的批处理不同,流处理以连续、增量的方式处理数据。
数据来源包括传感器、日志、交易、社交媒体订阅源或其他实时数据源。
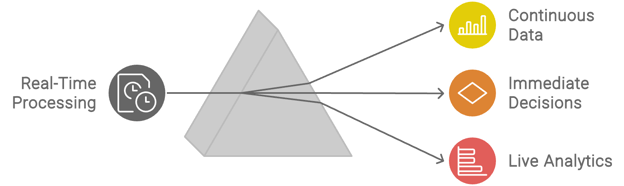
数据流在到达时即被处理,通常涉及过滤、转换、聚合等操作。这使之可用于实时应用,如在线分析、触发告警、实时仪表板,或将结果输送至其他系统以便进一步行动。这些洞察常被用于指导即时决策。
流处理应用包括金融市场的实时分析、欺诈检测、网络流量监控、推荐引擎等。
为支撑高速数据,流式系统通常具备对数据流与处理管道进行持续监控与管理的能力。这包括跟踪系统性能、数据流健康状况以及处理任务的结果。
较为流行的一个框架是AWS Kinesis 搭配 Lambda。Amazon Kinesis 是一项云端服务,可用于采集、处理与分析实时流数据;而 Lambda 支持复杂函数与自动化。
批处理与流处理的差异
在明确了批处理与流处理之后,我们来重点比较它们的差异。
数据延迟
两种方法在数据处理与分析的时效性上有明显不同。
- 流处理:低。
- 随着数据到达即处理,支持近实时的分析与决策,适用于需要即时响应的应用。
- 批处理:高。
- 数据在一段时间内收集,按计划定期成批处理。适合对分析时效性要求不高的场景。
数据量
两种方法在任一时刻可处理的数据量也有显著区别。
- 流处理:实时。
- 可处理高吞吐的连续数据,但可扩展性取决于系统设计与基础设施。要管理海量实时数据,需具备健壮且可扩展的系统。
- 批处理:大批量。
- 通常更适合可分批处理的巨量数据。批处理系统可在处理前聚合海量数据。
复杂度
搭建与维护两种处理方式的复杂度也是一大差异。
- 流处理:高。
- 需要复杂的基础设施来管理持续数据流,确保实时处理,并处理状态管理与容错等问题。
- 批处理:低。
- 批处理系统通常更易于实施与管理,因为数据按预定义的间隔处理,并可针对大规模作业进行优化。
使用场景
不同的处理方式适用于不同类型的应用与场景。
- 流处理: 适用于需要实时洞察与立即行动的场景。
- 例如监测社交媒体的品牌情绪、实时交通管理或直播分析。
- 批处理: 适用于无需立即行动、可分时段处理数据的场景。
基础设施与成本
两种方式在基础设施需求与相关成本上也有差异。
- 流处理:
- 基础设施:需要专门的基础设施以处理持续数据流,包括高吞吐数据管道、实时处理引擎,且常见为复杂的分布式系统。
- 成本:由于需要高性能计算资源、持续监控与弹性扩展以高效管理实时数据,成本可能更高。
- 批处理:
- 基础设施:通常需要支持周期性数据处理与存储的基础设施,如数据仓库或 Hadoop 集群。与流式系统相比,基础设施可相对简单。
- 成本: 大规模处理的整体成本通常更低,因为可利用现有的存储与计算资源,无需持续运行。
| |
批处理
|
流处理
|
|
数据延迟
|
高延迟,按固定计划处理
|
低延迟,实时处理
|
|
数据量
|
一次处理大批量,可良好地按计划处理海量数据
|
持续的大规模数据需谨慎处理
|
|
复杂度
|
由于数据可预测而复杂度较低,且更易管理
|
由于数据速度、规模与多样性更高而复杂度更高
|
|
使用场景
|
按期分析的数据处理,如月度报表或每周绩效指标
|
对数据进行持续分析,如欺诈告警、直播分析与物联网处理
|
|
基础设施与成本
|
较简单的基础设施,侧重支持并行处理;成本较低,因为资源更易共享
|
非常复杂的基础设施,需要持续关注与灵活性;由于持续扩展需求而产生显著成本
|
批处理 vs 流处理:差异总结
批处理的常见用例
批处理可满足多样化业务需求,尤其适用于涉及大数据集或常规操作的情境。以下是批处理作为务实解决方案的若干示例:
数据仓库与 ETL
批处理常用于数据仓库环境中的 ETL 流程。它能在尽量减少对业务系统影响的同时,确保数据仓库持续保持最新。
其重点在于从多源聚合数据、将其转换为合适格式,并按计划高效加载到集中式数据仓库。
定期报表
许多组织使用批处理生成定期报表,如月度销售汇总或季度绩效评估。
通过按固定间隔收集与处理数据,企业可以高效产出全面报表,为运营提供有价值的洞察。
历史数据分析
批处理非常适合分析历史数据,因为它可以定期处理与审视长期累积的大型数据集。
企业可以在一次批处理作业中分析多年的销售数据、客户交互或运营指标。此类全面分析有助于识别趋势与异常,从而发现运营低效或风险。
大规模数据迁移
批处理可高效地将海量数据从一个系统迁移到另一个系统。通过分批执行迁移,组织可以最大限度降低停机时间,在确保数据完整性的同时实现更平滑的过渡。
流处理的常见用例
流处理尤其适合对时效性洞察与即时响应要求严苛的场景。以下是流处理优势突出的具体案例。
实时分析与监控
流处理支持对输入数据的实时分析,可即时洞察趋势、客户行为与潜在问题。
例如,社交媒体上负面提及的突然飙升可被立即发现,使企业能迅速响应。
欺诈检测
通过实时分析交易模式,系统可识别异常或可疑行为——如异常消费模式或来自意外地点的交易——并触发告警或拦截交易以防欺诈。这样既保护消费者也保护企业,降低错误交易风险。
实时数据源与事件处理
电视网络利用流处理在播出过程中提供实时更新与信息。
体育赛事是绝佳示例。比分、球员数据、逐回合动作等实时数据流会被处理,以传递最新信息,并通过现场解说与交互功能提升观众参与度。
物联网数据处理
在智慧城市中,流处理管理嵌入于红绿灯、停车计时器及公共交通系统中的传感器数据。对这些数据的实时分析有助于优化交通流、监测空气质量,并高效管理公共交通系统。
通过检测出行模式中的异常(可能指示潜在问题),城市管理者可主动调整,缓解拥堵。
如何选择合适的方法:需要考虑的因素
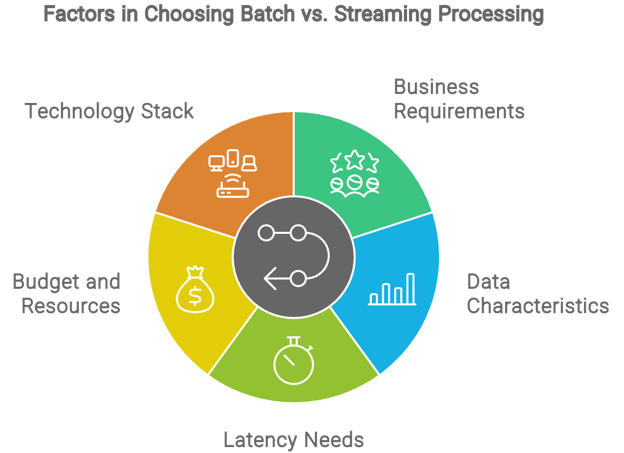
在批处理与流处理之间做选择时,请综合考虑业务需求、数据特性、延迟要求、预算、资源与技术栈。这些要素将决定最契合您业务与数据需求的方法。
业务需求
每家企业都有独特需求,理解数据工作流如何影响业务目标,是实施合适处理框架的关键。
- 批处理: 当您的业务需要生成定期报表、分析历史数据或进行大规模数据转换,且无需立即响应时,选择批处理更合适。此方法适用于月度财务报表、日终数据汇总等场景。
- 流处理: 当业务需要实时洞察与立即行动时,选择流处理更为理想。它适用于欺诈检测、实时交通管理或实时客户互动等应用,在这些场景中,及时的数据分析对决策与运营效率至关重要。
数据特性
了解不同数据适配的处理方法。批处理最适合可预测的数据集;而流处理则针对结构更为多变的数据而设计。
- 批处理最适合无需立即分析的大量历史或聚合数据。如果您的数据是批量收集并定期处理,批处理将高效应对这类负载。
- 流处理适合持续、高速到达且需随到随处理分析的数据。如果数据持续流入并要求实时处理,如物联网传感器或社交媒体直播数据,流处理能满足需求。
延迟需求
理解业务需求很重要,但了解可接受的数据延迟更为关键。数据是否必须实时,或可定期处理,将成为批处理与流处理的决断因素。
- 批处理: 若应用可以容忍一定延迟,且不需要即时洞察,批处理是合适的。其较高延迟可满足生成报表或趋势分析等无需实时性的任务。
- 流处理: 若应用要求低延迟与实时响应,应选择流处理。它适用于需要即时反馈的场景,如监控实时交易或实时异常检测。
预算与资源
预算与资源约束可能会限制您的选择。您的组织或许更倾向于利用现有基础设施,您需要让流水线适配既有环境。
- 批处理: 通常复杂度更低,且在处理海量数据时更具性价比。其运维开销较小,所需专用基础设施也较少,更适合作为大规模数据运营的经济型方案。
- 流处理: 由于需要专门的基础设施与技术以处理持续数据流、实时处理引擎与弹性扩展资源,成本往往更高,请确保预算可承受。
技术栈
不同技术栈的能力各异,工具选择将显著影响批处理或流处理是否更契合您的需求。
- 批处理: 如果您现有技术栈包含现代数据仓库方案,如 Google BigQuery、Amazon Redshift 或 Snowflake,您或许会更倾向于批处理。常用工具包括 Apache Spark(批模式)或 Azure Data Factory,以应对大规模批处理作业。这些平台支持按计划处理海量数据,适用于 ETL/ELT 流水线、定期报表与数据聚合等任务。
- 流处理: 如果您的技术栈包含 Apache Kafka、Apache Flink 或 Amazon Kinesis 等实时处理工具,且基础设施已面向持续数据流而设计,那么流处理可能更合适。这些技术旨在支持低延迟的实时数据分析与决策。Google Cloud Dataflow 与 AWS Lambda 等云原生服务可在现代基础设施中实现流畅的实时数据处理。
结语
将选择与业务需求、数据特性、延迟要求、预算与既有技术对齐,才能为您的数据处理需求选定最有效的方法。
若您需要处理大量历史数据并进行周期性分析,且预算有限,请选择批处理。若实时分析与即时行动至关重要,且具备应对更复杂高性能基础设施的预算与资源,请选择流处理。
以我的经验来看,只有极少数场景真正需要流处理。大多数时候,批处理已足够。
若您想进一步学习 ETL/ELT、流处理、批处理与构建管道,欢迎查阅以下 DataCamp 资源:


批处理与流处理是处理与分析数据的两种基本方法。理解这两种方法,有助于在不同的数据驱动场景中各取所长,从历史分析到实时决策皆然。
数据从业者应当了解两种方法的优劣,以及在其ETL 和 ELT 流程中分别该在何处实施。
本文将定义批处理与流处理、阐述它们的差异,并介绍如何为您的特定用例选择合适的方法。
什么是批处理?
批处理是一种方法,将收集到的大量数据分成若干块(批次)进行处理。
这种方法对资源密集型作业、重复性任务以及无需实时处理的超大数据集尤为有效。它非常适合数据仓库、ETL(抽取、转换、加载)以及大规模报表等应用。
由于能灵活满足多样化的业务需求,批处理依然是广泛采用的数据处理选择。
数据批处理主要是自动化的,一旦流程设定完成,几乎不需要人工干预。任务是预先定义好的,系统会按照预定时间表执行,通常选择在资源更充裕的业务低峰期。
人工参与通常仅限于初始参数配置、必要时的故障排查以及结果复核,使批处理成为管理大规模数据任务的高效、低接触方式。
用于批处理的ETL 工具种类繁多。常见工具之一是Apache Airflow,它可帮助用户迅速构建按计划运行、且易于监控的数据编排流水线。多做比较,选择最契合您业务需求的工具!
什么是流处理?
流处理(有时称为流式处理或实时数据处理)是一种数据处理方法,旨在数据在系统中流动的同时进行实时处理与分析。
与在预定时间间隔内收集并成批处理数据的批处理不同,流处理以连续、增量的方式处理数据。
数据来源包括传感器、日志、交易、社交媒体订阅源或其他实时数据源。
数据流在到达时即被处理,通常涉及过滤、转换、聚合等操作。这使之可用于实时应用,如在线分析、触发告警、实时仪表板,或将结果输送至其他系统以便进一步行动。这些洞察常被用于指导即时决策。
流处理应用包括金融市场的实时分析、欺诈检测、网络流量监控、推荐引擎等。
为支撑高速数据,流式系统通常具备对数据流与处理管道进行持续监控与管理的能力。这包括跟踪系统性能、数据流健康状况以及处理任务的结果。
较为流行的一个框架是AWS Kinesis 搭配 Lambda。Amazon Kinesis 是一项云端服务,可用于采集、处理与分析实时流数据;而 Lambda 支持复杂函数与自动化。
批处理与流处理的差异
在明确了批处理与流处理之后,我们来重点比较它们的差异。
数据延迟
两种方法在数据处理与分析的时效性上有明显不同。
数据量
两种方法在任一时刻可处理的数据量也有显著区别。
复杂度
搭建与维护两种处理方式的复杂度也是一大差异。
使用场景
不同的处理方式适用于不同类型的应用与场景。
基础设施与成本
两种方式在基础设施需求与相关成本上也有差异。
批处理
流处理
数据延迟
高延迟,按固定计划处理
低延迟,实时处理
数据量
一次处理大批量,可良好地按计划处理海量数据
持续的大规模数据需谨慎处理
复杂度
由于数据可预测而复杂度较低,且更易管理
由于数据速度、规模与多样性更高而复杂度更高
使用场景
按期分析的数据处理,如月度报表或每周绩效指标
对数据进行持续分析,如欺诈告警、直播分析与物联网处理
基础设施与成本
较简单的基础设施,侧重支持并行处理;成本较低,因为资源更易共享
非常复杂的基础设施,需要持续关注与灵活性;由于持续扩展需求而产生显著成本
批处理 vs 流处理:差异总结
批处理的常见用例
批处理可满足多样化业务需求,尤其适用于涉及大数据集或常规操作的情境。以下是批处理作为务实解决方案的若干示例:
数据仓库与 ETL
批处理常用于数据仓库环境中的 ETL 流程。它能在尽量减少对业务系统影响的同时,确保数据仓库持续保持最新。
其重点在于从多源聚合数据、将其转换为合适格式,并按计划高效加载到集中式数据仓库。
定期报表
许多组织使用批处理生成定期报表,如月度销售汇总或季度绩效评估。
通过按固定间隔收集与处理数据,企业可以高效产出全面报表,为运营提供有价值的洞察。
历史数据分析
批处理非常适合分析历史数据,因为它可以定期处理与审视长期累积的大型数据集。
企业可以在一次批处理作业中分析多年的销售数据、客户交互或运营指标。此类全面分析有助于识别趋势与异常,从而发现运营低效或风险。
大规模数据迁移
批处理可高效地将海量数据从一个系统迁移到另一个系统。通过分批执行迁移,组织可以最大限度降低停机时间,在确保数据完整性的同时实现更平滑的过渡。
流处理的常见用例
流处理尤其适合对时效性洞察与即时响应要求严苛的场景。以下是流处理优势突出的具体案例。
实时分析与监控
流处理支持对输入数据的实时分析,可即时洞察趋势、客户行为与潜在问题。
例如,社交媒体上负面提及的突然飙升可被立即发现,使企业能迅速响应。
欺诈检测
通过实时分析交易模式,系统可识别异常或可疑行为——如异常消费模式或来自意外地点的交易——并触发告警或拦截交易以防欺诈。这样既保护消费者也保护企业,降低错误交易风险。
实时数据源与事件处理
电视网络利用流处理在播出过程中提供实时更新与信息。
体育赛事是绝佳示例。比分、球员数据、逐回合动作等实时数据流会被处理,以传递最新信息,并通过现场解说与交互功能提升观众参与度。
物联网数据处理
在智慧城市中,流处理管理嵌入于红绿灯、停车计时器及公共交通系统中的传感器数据。对这些数据的实时分析有助于优化交通流、监测空气质量,并高效管理公共交通系统。
通过检测出行模式中的异常(可能指示潜在问题),城市管理者可主动调整,缓解拥堵。
如何选择合适的方法:需要考虑的因素
在批处理与流处理之间做选择时,请综合考虑业务需求、数据特性、延迟要求、预算、资源与技术栈。这些要素将决定最契合您业务与数据需求的方法。
业务需求
每家企业都有独特需求,理解数据工作流如何影响业务目标,是实施合适处理框架的关键。
数据特性
了解不同数据适配的处理方法。批处理最适合可预测的数据集;而流处理则针对结构更为多变的数据而设计。
延迟需求
理解业务需求很重要,但了解可接受的数据延迟更为关键。数据是否必须实时,或可定期处理,将成为批处理与流处理的决断因素。
预算与资源
预算与资源约束可能会限制您的选择。您的组织或许更倾向于利用现有基础设施,您需要让流水线适配既有环境。
技术栈
不同技术栈的能力各异,工具选择将显著影响批处理或流处理是否更契合您的需求。
结语
将选择与业务需求、数据特性、延迟要求、预算与既有技术对齐,才能为您的数据处理需求选定最有效的方法。
若您需要处理大量历史数据并进行周期性分析,且预算有限,请选择批处理。若实时分析与即时行动至关重要,且具备应对更复杂高性能基础设施的预算与资源,请选择流处理。
以我的经验来看,只有极少数场景真正需要流处理。大多数时候,批处理已足够。
若您想进一步学习 ETL/ELT、流处理、批处理与构建管道,欢迎查阅以下 DataCamp 资源: