
Cours
Introduction au data engineering
4 h
129.7K
Le traitement par lots et le traitement en flux sont deux approches fondamentales pour gérer et analyser les données. Comprendre ces deux méthodes est essentiel pour tirer parti des forces de chacune selon les contextes, de l'analyse historique à la prise de décision en temps réel.
Un professionnel des données doit connaître les atouts et limites de chaque approche et savoir où les appliquer au mieux dans ses processus ETL et ELT.
Dans cet article, nous définirons le traitement par lots et le traitement en flux, leurs différences, et comment choisir l'approche la plus adaptée à votre cas d'usage.
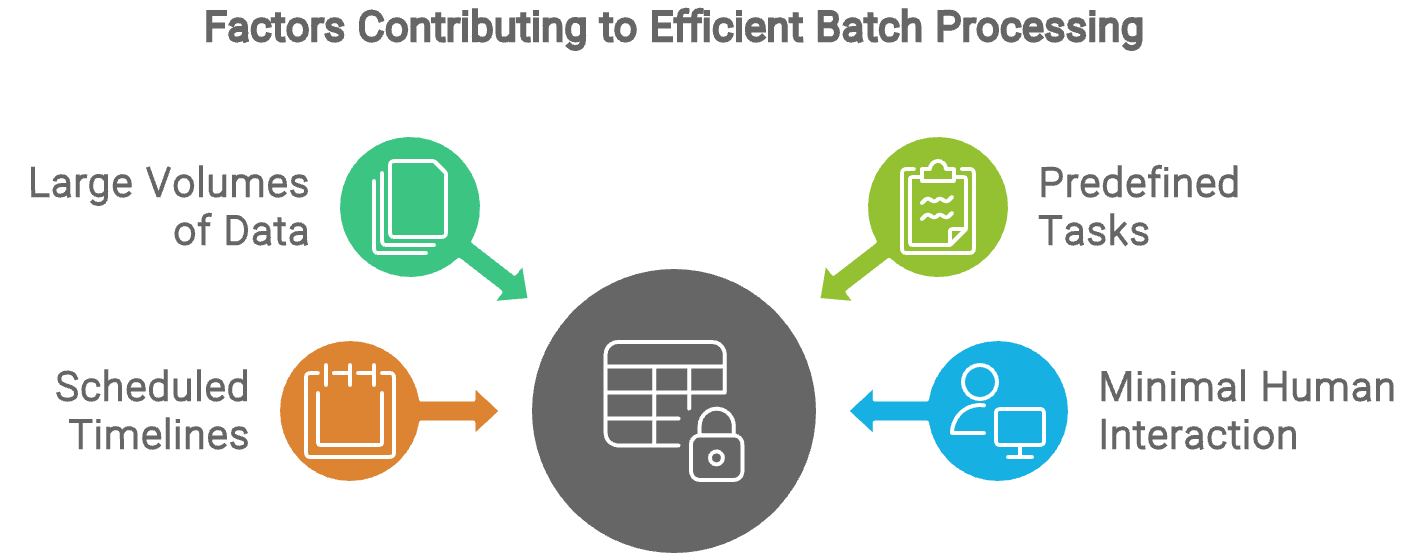
Le traitement par lots consiste à traiter de grands volumes de données collectées sous forme de blocs ou de lots.
Cette approche est particulièrement efficace pour les tâches gourmandes en ressources, répétitives, et pour la gestion de jeux de données volumineux lorsqu'une exécution en temps réel n'est pas nécessaire. Elle est idéale pour des applications comme l'entreposage de données, l'ETL (Extract, Transform, Load) et le reporting à grande échelle.
Grâce à sa polyvalence face à divers besoins métiers, le traitement par lots demeure un choix largement adopté pour le traitement des données.
Le traitement par lots est majoritairement automatisé et requiert peu d'intervention humaine une fois le processus en place. Les tâches sont prédéfinies et le système les exécute selon un calendrier, généralement en heures creuses lorsque les ressources de calcul sont disponibles.
L'intervention humaine se limite en général au paramétrage initial, au dépannage en cas d'erreurs et à la revue des résultats, ce qui fait du traitement par lots une approche efficace et peu intrusive pour gérer des tâches de données à grande échelle.
Il existe une variété d'outils ETL pour le traitement par lots. Un outil courant est Apache Airflow, qui permet de concevoir rapidement des pipelines d'orchestration de données planifiés et facilement supervisés. Explorez différentes options pour trouver celle qui correspond le mieux à vos besoins métiers !
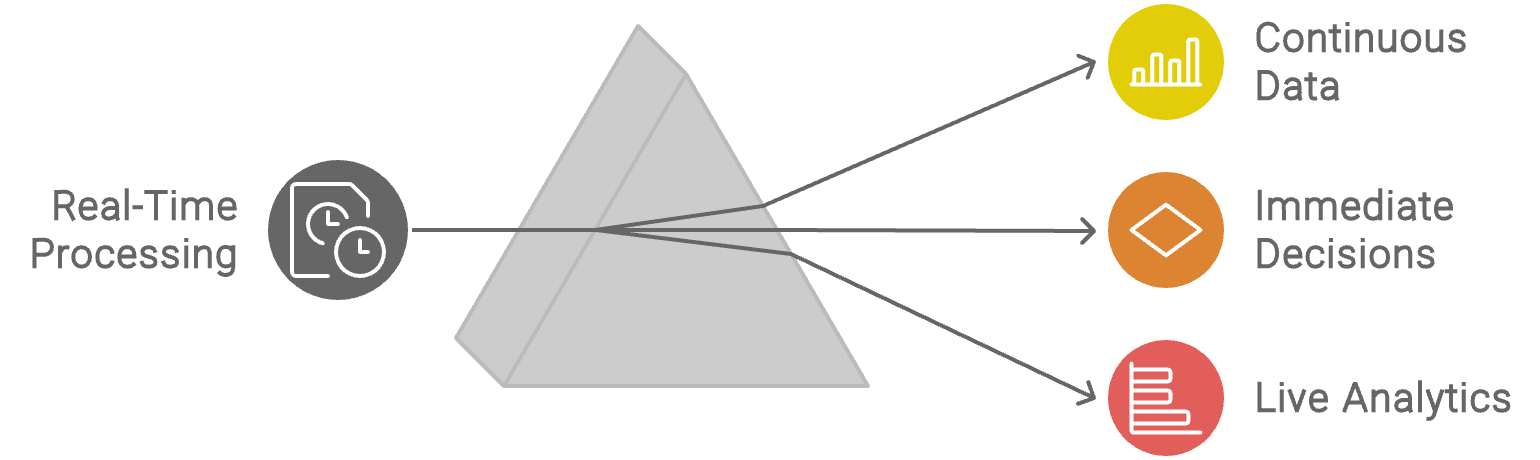
Le traitement en flux, parfois appelé traitement en continu ou traitement des données en temps réel, est une approche conçue pour gérer et analyser les données au fil de l'eau, à mesure qu'elles circulent dans un système.
Contrairement au traitement par lots, qui collecte et traite des données en blocs distincts à intervalles planifiés, le traitement en flux traite les données de manière continue et incrémentale.
Les données sont collectées depuis diverses sources comme des capteurs, des journaux, des transactions, des fils d'actualité des réseaux sociaux ou d'autres sources en direct.
Elles sont ensuite traitées à la volée via des opérations telles que le filtrage, la transformation et l'agrégation. Cela permet des usages en temps réel comme l'analytique live, le déclenchement d'alertes, des tableaux de bord temps réel ou l'alimentation d'autres systèmes pour action immédiate. Ces insights servent souvent à orienter des décisions instantanées.
Les applications incluent l'analytique temps réel pour les marchés financiers, la détection de fraude, la supervision du trafic réseau, les moteurs de recommandation, etc.
Les systèmes de streaming intègrent souvent des capacités de supervision continue des flux et des pipelines de traitement pour supporter des données à grande vélocité : suivi des performances, de la santé des flux et des résultats des tâches de traitement.
Un framework populaire est AWS Kinesis, combiné à Lambda. Amazon Kinesis est un service cloud qui permet de collecter, traiter et analyser des données en continu et en temps réel, tandis que Lambda prend en charge des fonctions complexes et l'automatisation.
Maintenant que nous avons défini les deux approches, passons en revue leurs principales différences.
Le délai de traitement et d'analyse diffère nettement entre les deux méthodes.
La quantité de données que chaque méthode peut gérer à un instant donné varie aussi sensiblement.
La complexité de mise en place et d'exploitation diffère également.
Chaque méthode se prête à des applications et besoins différents.
Les besoins d'infrastructure et les coûts associés diffèrent aussi entre les deux approches.
|
Traitement par lots |
Traitement en flux |
|
|
Latence des données |
Latence élevée, traitements planifiés |
Faible latence, traitements en temps réel |
|
Volume de données |
Grands blocs d'un coup, peut gérer de très gros volumes planifiés |
Grands volumes traités en continu à manier avec précaution |
|
Complexité |
Complexité plus faible grâce à la prévisibilité des données et une gestion facilitée |
Complexité plus élevée due à la vélocité, au volume et à la variété des données |
|
Cas d'usage |
Traitement de données analysées périodiquement, comme des rapports mensuels ou des indicateurs hebdomadaires |
Analyse continue pour des alertes fraude, l'analytique de flux en direct et l'IoT |
|
Infrastructure et coûts |
Infrastructure moins complexe axée sur le parallélisme, coûts plus faibles grâce au partage des ressources |
Infrastructure très complexe nécessitant une attention constante et une grande flexibilité, avec des coûts significatifs dus à la mise à l'échelle continue |
Traitement par lots vs en flux : résumé des différences
Le traitement par lots répond à de nombreux besoins, notamment lorsqu'il s'agit de gros volumes ou d'opérations récurrentes. Voici quelques exemples de scénarios où il s'impose comme une solution pragmatique :
Le traitement par lots est couramment utilisé en data warehousing pour les processus ETL. Il garantit une mise à jour régulière de l'entrepôt de données tout en minimisant l'impact sur les systèmes opérationnels.
Il vise à agréger des données provenant de multiples sources, à les transformer au bon format et à les charger efficacement dans un entrepôt centralisé selon un planning défini.
Beaucoup d'organisations s'appuient sur le traitement par lots pour générer des rapports périodiques, tels que des bilans mensuels de ventes ou des revues de performance trimestrielles.
La collecte et le traitement à intervalles réguliers permettent de produire efficacement des rapports complets offrant une vision utile des opérations.
Le traitement par lots est bien adapté à l'analyse de données historiques, car il peut, à fréquence régulière, ingérer et examiner de grands jeux de données accumulés sur de longues périodes.
On peut ainsi analyser des années de ventes, d'interactions clients ou d'indicateurs opérationnels en un seul job, afin d'identifier tendances et anomalies révélatrices d'inefficacités ou de risques.
Le traitement par lots permet de déplacer efficacement de gros volumes de données d'un système à l'autre. En procédant par paquets, les organisations réduisent les interruptions et assurent une transition plus fluide tout en préservant l'intégrité des données.
Le traitement en flux est particulièrement pertinent lorsque des insights rapides et des réponses immédiates sont indispensables. Voici quelques exemples où il excelle.
Le traitement en flux permet l'analyse en temps réel des données entrantes, pour des insights instantanés sur les tendances, les comportements clients et les signaux faibles.
Par exemple, un pic soudain de mentions négatives sur les réseaux sociaux peut être détecté immédiatement, ce qui permet d'agir sans délai.
En analysant les transactions en temps réel, le système identifie des anomalies ou comportements suspects — comme des schémas de dépenses inhabituels ou des opérations depuis des lieux inattendus — et déclenche des alertes ou bloque les transactions pour prévenir la fraude. Cela protège à la fois les consommateurs et l'entreprise en réduisant les risques.
Les chaînes de télévision utilisent le traitement en flux pour fournir des mises à jour et informations en direct pendant les émissions.
Un excellent exemple est celui des événements sportifs : scores, statistiques des joueurs et actions de jeu sont traités en temps réel pour offrir des informations à jour et renforcer l'engagement grâce aux commentaires live et aux fonctionnalités interactives.
Dans les smart cities, le traitement en flux gère les données de capteurs intégrés aux feux tricolores, horodateurs et réseaux de transport. L'analyse temps réel aide à optimiser la circulation, surveiller la qualité de l'air et piloter efficacement les transports.
En détectant des anomalies de déplacement susceptibles de signaler des incidents, les villes peuvent agir proactivement et limiter les embouteillages.
Pour trancher entre traitement par lots et en flux, prenez en compte les exigences métier, la nature des données, les besoins de latence, le budget, les ressources et votre pile technologique. Ces éléments déterminent l'approche idéale pour votre organisation.
Chaque entreprise a des besoins spécifiques : comprendre l'impact des flux de données sur vos objectifs est clé pour choisir le bon cadre de traitement.
Associez la méthode au type de données. Le traitement par lots convient aux jeux prévisibles ; le traitement en flux gère des structures plus variables.
Au-delà des besoins métier, le niveau de délai acceptable est déterminant. Le caractère temps réel ou non tranchera entre lots et flux.
Les contraintes budgétaires et de ressources peuvent orienter votre choix. Votre organisation peut privilégier l'infrastructure existante, et il faudra adapter vos pipelines en conséquence.
Les capacités de votre pile technologique influencent fortement l'approche la plus adaptée.
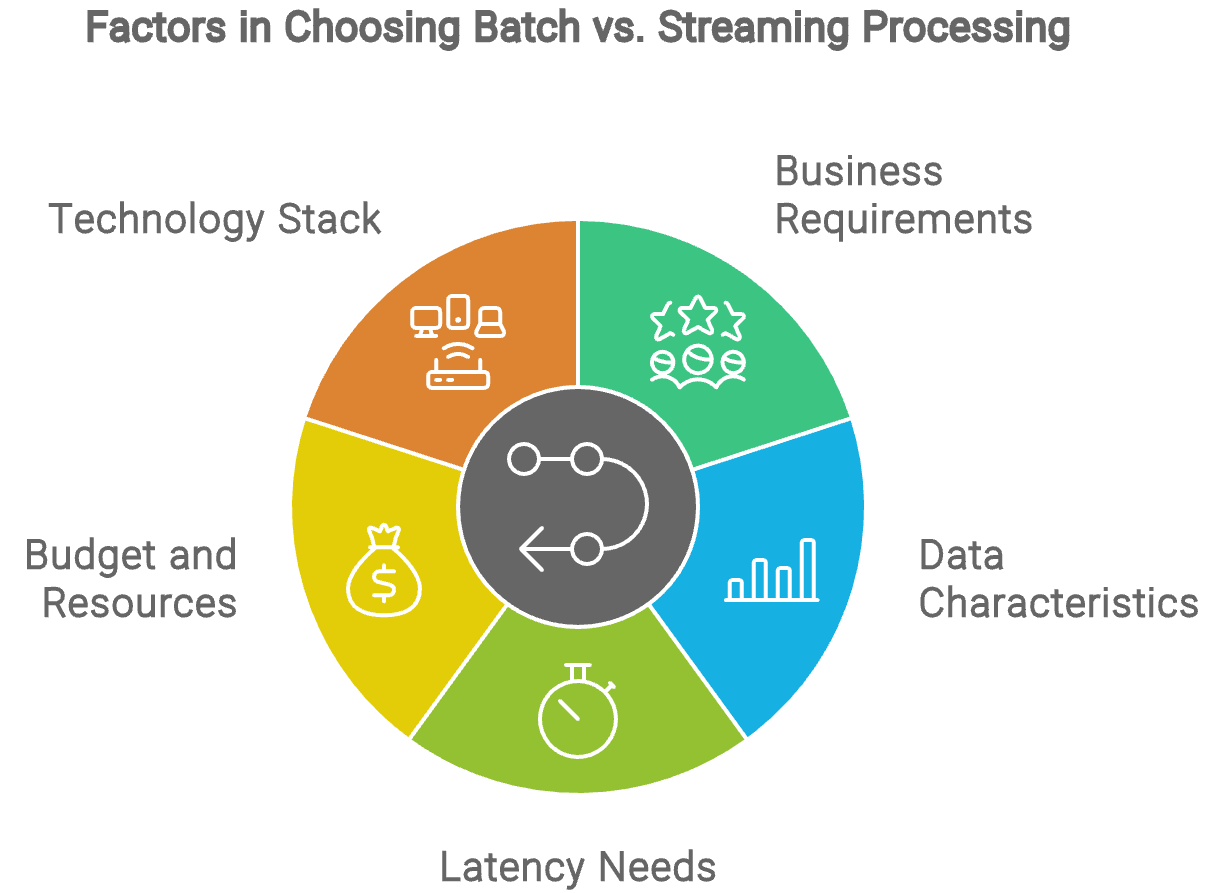
Alignez votre choix avec vos exigences métier, la nature des données, les besoins de latence, le budget et la pile technologique pour retenir l'approche la plus efficace.
Choisissez le traitement par lots si vous devez gérer de grands volumes historiques avec des analyses périodiques et que le budget est contraint. Optez pour le traitement en flux si l'analyse en temps réel et l'action immédiate sont cruciales et que vous disposez des ressources pour une infrastructure plus complexe et performante.
D'expérience, le streaming n'est nécessaire que dans peu de scénarios. La plupart du temps, le batch suffit.
Pour approfondir ETL/ELT, le traitement en flux et par lots, ainsi que la création de pipelines, explorez ces ressources DataCamp :
Approfondissez vos connaissances en data engineering avec ces cours !
Cours
Cursus
Cours