
Corso
Introduzione al Data Engineering
4 ore
130.4K
Pratica and corso your progress.
Continua Con GoogleL’elaborazione batch e quella in streaming sono due approcci fondamentali per gestire e analizzare i dati. Capire entrambi i metodi è importante per sfruttare i punti di forza di ciascuno in diversi scenari data-driven, dall’analisi storica al decision-making in tempo reale.
Un professionista dei dati dovrebbe conoscere i punti di forza e di debolezza di entrambi gli approcci e dove implementarli al meglio nei propri processi ETL ed ELT.
In questo articolo definiremo elaborazione batch e in streaming, le loro differenze e come scegliere l’approccio giusto per il tuo caso d’uso specifico.
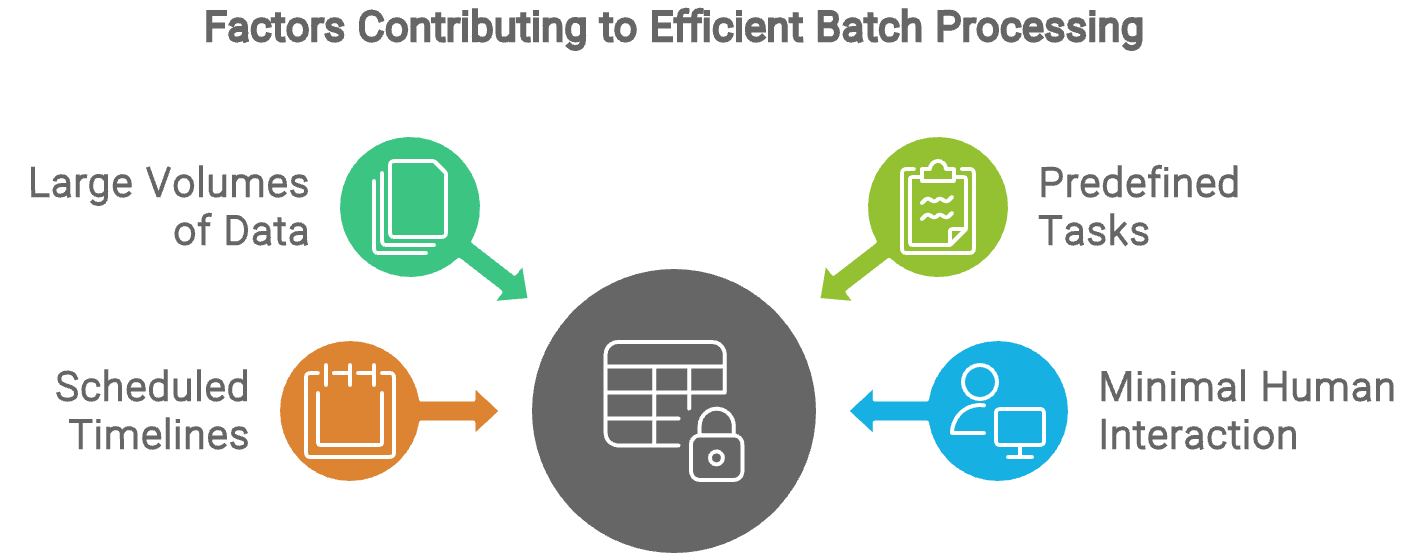
L’elaborazione batch è un metodo in cui grandi volumi di dati raccolti vengono elaborati in blocchi o batch.
Questo approccio è particolarmente efficace per lavori ad alto consumo di risorse, attività ripetitive e la gestione di dataset estesi quando l’elaborazione in tempo reale non è necessaria. È ideale per applicazioni come data warehousing, ETL (Extract, Transform, Load) e reportistica su larga scala.
Grazie alla sua versatilità nel soddisfare varie esigenze di business, l’elaborazione batch rimane una scelta ampiamente adottata per la data processing.
L’elaborazione batch è per lo più automatizzata e richiede un intervento umano minimo una volta impostato il processo. Le attività sono predefinite e il sistema le esegue secondo una pianificazione, tipicamente durante le ore non di punta quando le risorse di calcolo sono più disponibili.
Il coinvolgimento umano si limita solitamente a configurare i parametri iniziali, risolvere eventuali errori e rivedere l’output, rendendo l’elaborazione batch un approccio molto efficiente e “a mani libere” per gestire attività sui dati su larga scala.
Esistono vari strumenti ETL per l’elaborazione batch. Uno strumento comune è Apache Airflow, che consente di creare rapidamente pipeline di orchestrazione dei dati eseguibili a orari prestabiliti e con monitoraggio semplice. Esplora diversi strumenti per trovare quello più adatto alle esigenze del tuo business!
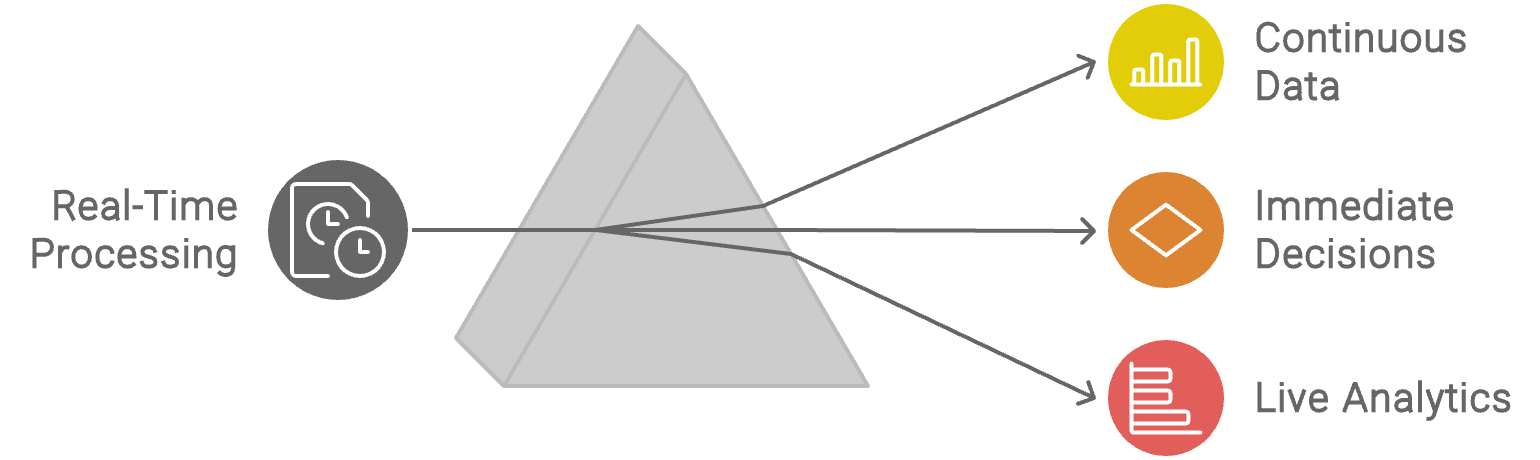
L’elaborazione in streaming, talvolta chiamata elaborazione in flusso o elaborazione dei dati in tempo reale, è un approccio progettato per gestire e analizzare i dati in tempo reale man mano che attraversano un sistema.
A differenza dell’elaborazione batch, che prevede la raccolta e l’elaborazione di dati in grandi blocchi a intervalli pianificati, l’elaborazione in streaming tratta i dati in modo continuo e incrementale.
I dati vengono raccolti da varie fonti come sensori, log, transazioni, feed dei social media o altre sorgenti live.
I flussi di dati vengono poi elaborati man mano che arrivano, con una serie di operazioni come filtraggio, trasformazione e aggregazione. Questo consente implementazioni in tempo reale come analisi live, attivazione di avvisi, dashboard in tempo reale o alimentazione di altri sistemi per ulteriori azioni. Queste insight vengono spesso usate per influenzare decisioni immediate.
Le applicazioni di elaborazione in streaming includono analisi in tempo reale per i mercati finanziari, rilevamento delle frodi, monitoraggio del traffico di rete, motori di raccomandazione e altro.
I sistemi di streaming spesso includono funzionalità per il monitoraggio costante e la gestione dei flussi di dati e delle pipeline di elaborazione per supportare dati ad alta velocità. Ciò include il tracciamento delle prestazioni del sistema, dello stato dei flussi e degli esiti dei task di elaborazione.
Un framework molto diffuso è AWS Kinesis, combinato con Lambda. Amazon Kinesis è un servizio cloud che ti permette di raccogliere, elaborare e analizzare dati in streaming in tempo reale, mentre Lambda supporta funzioni complesse e automazione.
Ora che abbiamo definito processi batch e in streaming, evidenziamo alcune differenze.
I metodi batch e streaming differiscono nettamente in termini di rapidità con cui i dati possono essere elaborati e analizzati.
Anche la quantità di dati che ciascun metodo può gestire in un dato momento varia significativamente.
La complessità di configurazione e manutenzione è un’altra differenza importante tra questi metodi.
Metodi diversi si prestano a tipi diversi di applicazioni e casi d’uso.
Anche i requisiti di infrastruttura e i costi associati differiscono tra elaborazione batch e in streaming.
|
Elaborazione batch |
Elaborazione in streaming |
|
|
Latenza dei dati |
Alta latenza, elabora secondo orari prestabiliti |
Bassa latenza, elabora in tempo reale |
|
Volume dei dati |
Grandi blocchi alla volta e può gestire volumi vasti con una pianificazione adeguata |
Grandi volumi da gestire costantemente con attenzione |
|
Complessità |
Complessità inferiore grazie alla prevedibilità dei dati e gestione più semplice |
Complessità superiore per via di maggiore velocità, volume e varietà dei dati |
|
Casi d’uso |
Elaborazione di dati analizzati periodicamente, come report mensili o metriche settimanali di performance |
Analisi costante dei dati per elementi come avvisi antifrode, analytics di live streaming e processing IoT |
|
Infrastruttura e costi |
Infrastruttura meno complessa focalizzata sul supporto di processi paralleli e costi inferiori poiché le risorse possono essere condivise più facilmente |
Infrastruttura molto complessa che richiede attenzione e flessibilità costanti, con costi significativi dovuti alla necessità di scaling continuo |
Batch vs streaming: riepilogo delle differenze
L’elaborazione batch ha applicazioni diverse che rispondono a differenti esigenze di business, soprattutto in situazioni che coinvolgono grandi dataset o operazioni di routine. Di seguito alcuni esempi di scenari in cui l’elaborazione batch è una soluzione pratica:
L’elaborazione batch è comunemente usata negli ambienti di data warehousing per i processi ETL. Garantisce che il data warehouse sia costantemente aggiornato riducendo al minimo l’impatto sui sistemi operativi.
Si concentra sull’aggregazione dei dati da varie fonti, sulla loro trasformazione in un formato adatto e sul caricamento efficiente in un data warehouse centralizzato a intervalli programmati.
Molte organizzazioni usano l’elaborazione batch per generare report periodici, come i riepiloghi mensili delle vendite o le revisioni trimestrali delle performance.
Raccogliendo ed elaborando i dati a intervalli regolari, le aziende possono produrre efficacemente report completi che offrono insight preziosi sulle loro operazioni.
L’elaborazione batch è adatta all’analisi dei dati storici, poiché può elaborare e esaminare regolarmente grandi dataset accumulati in lunghi periodi.
Le aziende possono analizzare anni di dati di vendita, interazioni con i clienti o metriche operative in un unico job batch. Questa analisi completa aiuta a individuare trend e anomalie che indicano inefficienze operative o rischi.
L’elaborazione batch può spostare in modo efficiente grandi volumi di dati da un sistema a un altro. Elaborando la migrazione a batch, le organizzazioni possono ridurre al minimo i tempi di inattività e garantire una transizione più fluida, mantenendo l’integrità dei dati.
L’elaborazione in streaming è particolarmente adatta a scenari in cui insight tempestivi e risposte immediate sono critici. Ecco alcuni esempi specifici in cui eccelle.
L’elaborazione in streaming abilita l’analisi in tempo reale dei dati in ingresso, fornendo insight istantanei su trend, comportamento dei clienti e potenziali problemi.
Per esempio, un improvviso picco di menzioni negative sui social può essere rilevato immediatamente, consentendo all’azienda di reagire rapidamente.
Analizzando i pattern delle transazioni in tempo reale, il sistema può identificare anomalie o comportamenti sospetti—come schemi di spesa insoliti o transazioni da località inattese—e attivare avvisi o bloccare le transazioni per prevenire le frodi. Questo protegge sia i consumatori sia l’azienda riducendo il rischio di operazioni errate.
Le reti televisive usano l’elaborazione in streaming per fornire aggiornamenti e informazioni live durante le trasmissioni.
Un ottimo esempio sono gli eventi sportivi. Flussi di dati in tempo reale (come punteggi, statistiche dei giocatori e azioni play-by-play) vengono elaborati per offrire informazioni aggiornate e aumentare il coinvolgimento con telecronache live e funzionalità interattive.
Nelle smart city, l’elaborazione in streaming gestisce i dati dei sensori incorporati in semafori, parchimetri e sistemi di trasporto pubblico. L’analisi in tempo reale di questi dati aiuta a ottimizzare il flusso del traffico, monitorare la qualità dell’aria e gestire in modo efficiente i trasporti pubblici.
Rilevando anomalie nei pattern di spostamento che potrebbero indicare potenziali problemi, i responsabili possono intervenire in modo proattivo e ridurre al minimo il traffico.
Quando decidi tra elaborazione batch e in streaming, considera molti fattori come requisiti di business, caratteristiche dei dati, necessità di latenza, budget, risorse e stack tecnologico. Questi elementi determinano l’approccio ideale per il tuo business e le sue esigenze sui dati.
Ogni azienda ha esigenze uniche e capire come il flusso di dati impatta gli obiettivi di business è fondamentale per implementare il framework di elaborazione corretto.
Conosci quali metodi di elaborazione si adattano meglio ai diversi tipi di dati. L’elaborazione batch funziona meglio con dataset prevedibili, mentre lo streaming è progettato per gestire strutture dati più variabili.
Capire le esigenze di business è importante, ma capire quanta latenza è accettabile è cruciale. Che i dati debbano essere in tempo reale o possano essere gestiti periodicamente sarà il fattore decisivo tra batch e streaming.
Vincoli di budget e risorse possono limitare la scelta. La tua organizzazione può dare priorità all’utilizzo dell’infrastruttura esistente, e dovrai far rientrare le pipeline in quell’infrastruttura.
Stack tecnologici diversi hanno capacità diverse e la scelta degli strumenti può incidere molto sul fatto che convenga di più il batch o lo streaming.
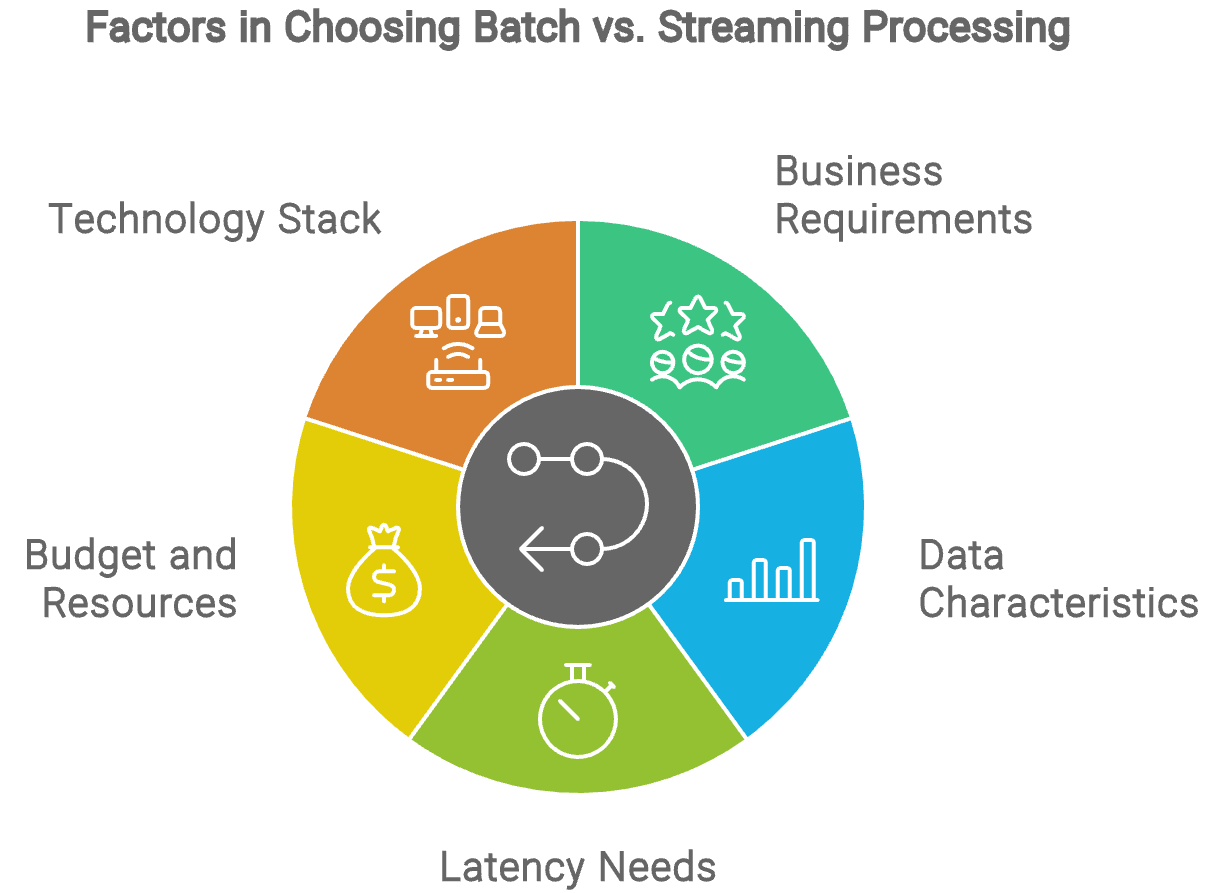
Allineare la scelta a requisiti di business, caratteristiche dei dati, necessità di latenza, budget e tecnologia esistente ti aiuterà a selezionare l’approccio più efficace per le tue esigenze di elaborazione dati.
Scegli l’elaborazione batch se devi gestire grandi volumi di dati storici con analisi periodiche e hai vincoli di budget. Opta per lo streaming se l’analisi in tempo reale e le azioni immediate sono cruciali e disponi del budget e delle risorse necessari per un’infrastruttura più complessa e ad alte prestazioni.
Per esperienza, lo streaming serve solo in pochi scenari. La maggior parte delle volte puoi cavartela con il batch.
Se vuoi approfondire ETL/ELT, elaborazione in streaming, elaborazione batch e la costruzione di pipeline, prova queste risorse di DataCamp:
Approfondisci il data engineering con questi corsi!
Corso
Programma
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



