
Cursus
Introductie tot Data Engineering
4 uur
130.4K
Oefen en volg je voortgang.
Ga Verder Met GoogleBatch- en streamverwerking zijn twee fundamentele benaderingen voor het verwerken en analyseren van data. Beide methoden begrijpen is belangrijk om de sterke punten van elke aanpak te benutten in verschillende datagedreven scenario's, van historische analyses tot realtime besluitvorming.
Een dataprofessional moet de sterke en zwakke punten van beide benaderingen kennen en weten waar je ze het beste inzet voor je ETL- en ELT-processen.
In dit artikel definiëren we batch- en streamverwerking, hun verschillen en hoe je de juiste aanpak kiest voor jouw specifieke use case.
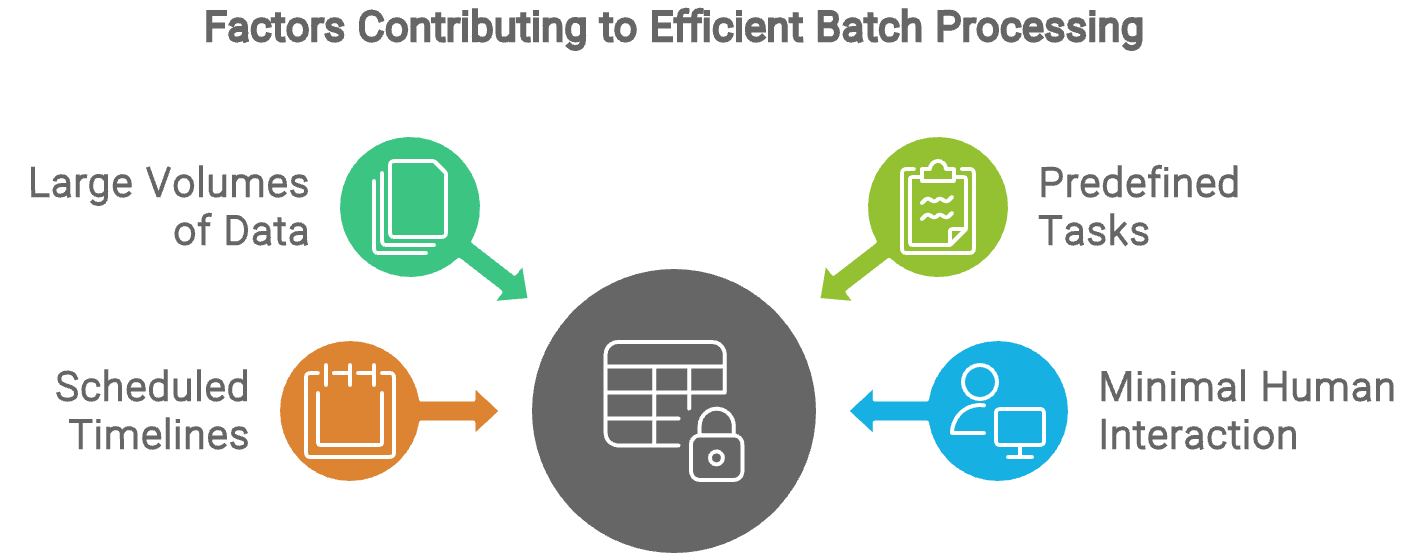
Batchverwerking is een methode waarbij grote hoeveelheden verzamelde data in porties of batches worden verwerkt.
Deze aanpak is vooral effectief voor resource-intensieve jobs, repetitieve taken en het beheren van omvangrijke datasets waarvoor realtime verwerking niet nodig is. Het is ideaal voor toepassingen zoals datawarehousing, ETL (Extract, Transform, Load) en grootschalige rapportage.
Vanwege de veelzijdigheid om aan uiteenlopende bedrijfsbehoeften te voldoen, blijft batchverwerking een veelgekozen optie voor dataverwerking.
Batchverwerking is grotendeels geautomatiseerd en vereist minimale menselijke interactie zodra het proces is opgezet. Taken zijn vooraf gedefinieerd en het systeem voert ze uit volgens een geplande tijdlijn, meestal tijdens daluren wanneer rekenbronnen ruimer beschikbaar zijn.
Menselijke betrokkenheid beperkt zich meestal tot het configureren van de initiële parameters, het oplossen van fouten als die zich voordoen en het beoordelen van de output, waardoor batchverwerking een zeer efficiënte en hands-off aanpak is voor grootschalige datataken.
Er zijn allerlei ETL-tools voor batchverwerking. Een veelgebruikt hulpmiddel is Apache Airflow, waarmee je snel data-orchestratiepijplijnen kunt opzetten die volgens een schema draaien en eenvoudig te monitoren zijn. Verken verschillende tools om te vinden wat het beste bij jouw bedrijfsbehoeften past!
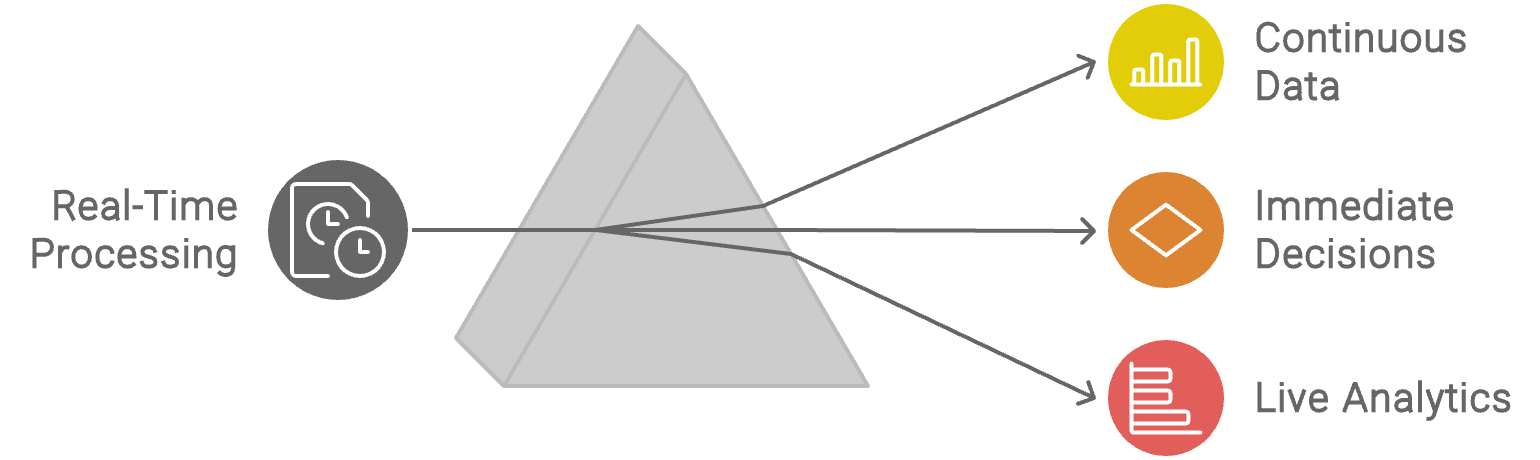
Streamverwerking, ook wel streamingverwerking of realtime dataverwerking genoemd, is een benadering die is ontworpen om data in realtime te verwerken en analyseren terwijl deze door een systeem stroomt.
In tegenstelling tot batchverwerking, waarbij data in grote, discrete blokken op geplande momenten wordt verzameld en verwerkt, gaat streamverwerking continu en incrementeel met data om.
Data wordt verzameld uit verschillende bronnen zoals sensoren, logs, transacties, socialemediastromen of andere live databronnen.
Datastromen worden verwerkt zodra ze binnenkomen, met bewerkingen zoals filteren, transformeren en aggregeren. Dit maakt realtime toepassingen mogelijk zoals live analytics, het triggeren van alerts, realtime dashboards of het voeden van andere systemen voor vervolgacties. Deze inzichten worden vaak gebruikt om directe beslissingen te beïnvloeden.
Toepassingen van streamingverwerking zijn onder meer realtime analytics voor financiële markten, fraudedetectie, monitoring van netwerkverkeer, aanbevelingssystemen en meer.
Streamingsystemen bieden vaak mogelijkheden voor voortdurend monitoren en beheren van datastromen en verwerkingspijplijnen om data met hoge snelheid te ondersteunen. Dit omvat het volgen van de systeemprestaties, de gezondheid van de datastromen en de resultaten van de verwerkingstaken.
Een populair framework is AWS Kinesis, gecombineerd met Lambda. Amazon Kinesis is een cloudservice waarmee je realtime, streamingdata kunt verzamelen, verwerken en analyseren, terwijl Lambda complexe functies en automatisering ondersteunt.
Nu we batch- en streamingprocessen hebben gedefinieerd, lichten we enkele verschillen toe.
Batch- en streamingmethoden verschillen duidelijk in hoe snel data kan worden verwerkt en geanalyseerd.
Ook de hoeveelheid data die elke methode op een bepaald moment aankan, verschilt aanzienlijk.
Ook de complexiteit van het opzetten en onderhouden van deze verwerkingsmethoden verschilt.
Verschillende verwerkingsmethoden lenen zich voor verschillende soorten toepassingen en use cases.
Ook de infrastructuurvereisten en bijbehorende kosten verschillen tussen batch- en streamingverwerking.
|
Batchverwerking |
Streamverwerking |
|
|
Datalatentie |
Hoge latentie, verwerkt op vaste schema's |
Lage latentie, verwerkt in realtime |
|
Datavolume |
Grote porties in één keer en kan zeer grote volumes goed gepland verwerken |
Grote volumes moeten continu zorgvuldig worden afgehandeld |
|
Complexiteit |
Lagere complexiteit door voorspelbaarheid van data en eenvoudiger beheer |
Hogere complexiteit door hogere snelheid, volume en variëteit van data |
|
Use cases |
Data verwerken die periodiek wordt geanalyseerd, zoals maandrapporten of wekelijkse prestatiemetrics |
Constante analyse van data voor zaken als fraudewaarschuwingen, live streaming-analytics en IoT-verwerking |
|
Infrastructuur en kosten |
Minder complexe infrastructuur die zich richt op het ondersteunen van parallelle processen en lagere kosten doordat middelen makkelijker gedeeld kunnen worden |
Zeer complexe infrastructuur die constante aandacht en flexibiliteit vraagt en aanzienlijke kosten met zich meebrengt door de noodzaak van voortdurend opschalen |
Batch versus streamingverwerking: samenvatting van de verschillen
Batchverwerking kent diverse toepassingen die inspelen op verschillende bedrijfsbehoeften, vooral bij grote datasets of routinematige operaties. Hieronder enkele voorbeelden van scenario's waarin batchverwerking een praktische oplossing biedt:
Batchverwerking wordt vaak gebruikt in datawarehousing-omgevingen voor ETL-processen. Zo blijft het datawarehouse consistent up-to-date met minimale impact op operationele systemen.
De focus ligt op het aggregeren van data uit verschillende bronnen, het transformeren naar een geschikt formaat en het efficiënt laden in een gecentraliseerd datawarehouse op geplande intervallen.
Veel organisaties gebruiken batchverwerking om periodieke rapporten te genereren, zoals maandelijkse verkoopoverzichten of kwartaalreviews.
Door data op vaste momenten te verzamelen en te verwerken, kunnen bedrijven efficiënt uitgebreide rapporten produceren die waardevolle inzichten geven in hun operaties.
Batchverwerking leent zich goed voor het analyseren van historische data, omdat regelmatig grote datasets die over langere perioden zijn opgebouwd, verwerkt en onderzocht kunnen worden.
Bedrijven kunnen jaren aan verkoopdata, klantinteracties of operationele metrics in één batchjob analyseren. Deze brede analyse helpt trends en afwijkingen te identificeren die kunnen wijzen op inefficiënties of risico's.
Batchverwerking kan grote hoeveelheden data efficiënt van het ene systeem naar het andere verplaatsen. Door de migratie in batches te verwerken, kunnen organisaties downtime minimaliseren en een soepelere overgang realiseren met behoud van dataintegriteit.
Streamingverwerking is vooral geschikt voor scenario's waarin tijdige inzichten en directe reacties cruciaal zijn. Hier zijn enkele specifieke voorbeelden waarin streamingverwerking uitblinkt.
Streamingverwerking maakt de realtime analyse van binnenkomende data mogelijk en levert direct inzicht in trends, klantgedrag en potentiële issues.
Zo kan een plotselinge piek in negatieve vermeldingen op social media direct worden gedetecteerd, waardoor een bedrijf snel kan reageren.
Door transactiepatronen te analyseren in realtime kan het systeem afwijkingen of verdacht gedrag herkennen—zoals ongebruikelijke bestedingspatronen of transacties vanaf onverwachte locaties—en alerts triggeren of transacties blokkeren om fraude te voorkomen. Dit beschermt zowel consumenten als het bedrijf door het risico op foutieve transacties te verlagen.
Televisiezenders gebruiken streamingverwerking om tijdens uitzendingen live updates en informatie te bieden.
Een goed voorbeeld zijn sportevenementen. Realtime datastromen (zoals scores, spelerstatistieken en play-by-play-acties) worden verwerkt om actuele informatie te leveren en de betrokkenheid van kijkers te vergroten met live commentaar en interactieve features.
In smart cities beheert streamingverwerking data van sensoren in verkeerslichten, parkeermeters en het openbaar vervoer. Realtime analyse van deze data helpt het verkeer te optimaliseren, de luchtkwaliteit te monitoren en het ov efficiënt te beheren.
Door afwijkingen in reispatronen te detecteren die op mogelijke problemen kunnen wijzen, kunnen stadsbestuurders proactief bijsturen en files beperken.
Kies je tussen batch- en streamingverwerking, houd dan rekening met factoren als bedrijfsvereisten, data-eigenschappen, latentiebehoeften, budget, resources en je technologiestack. Deze componenten bepalen de ideale aanpak voor jouw bedrijf en databehoeften.
Elk bedrijf heeft unieke behoeften, en begrijpen hoe de dataworkflow de bedrijfsdoelen beïnvloedt is essentieel om het juiste verwerkingsframework te implementeren.
Weet welke verwerkingsmethoden het best passen bij verschillende soorten data. Batchverwerking werkt het best met voorspelbare datasets, terwijl streamverwerking is ontworpen voor meer variabele datastructuren.
Je bedrijfsbehoeften begrijpen is belangrijk, maar bepalen hoeveel vertraging acceptabel is, is cruciaal. Of data realtime moet zijn of periodiek kan worden afgehandeld, is de doorslaggevende factor bij batch versus streaming.
Budget- en resourcebeperkingen kunnen je keuze beperken. Je organisatie kan prioriteit geven aan het benutten van bestaande infrastructuur, en je moet je pijplijnen daarin inpassen.
Verschillende technologiestacks hebben uiteenlopende mogelijkheden, en de keuze van tools heeft grote invloed op de vraag of batch- of streamingverwerking beter past.
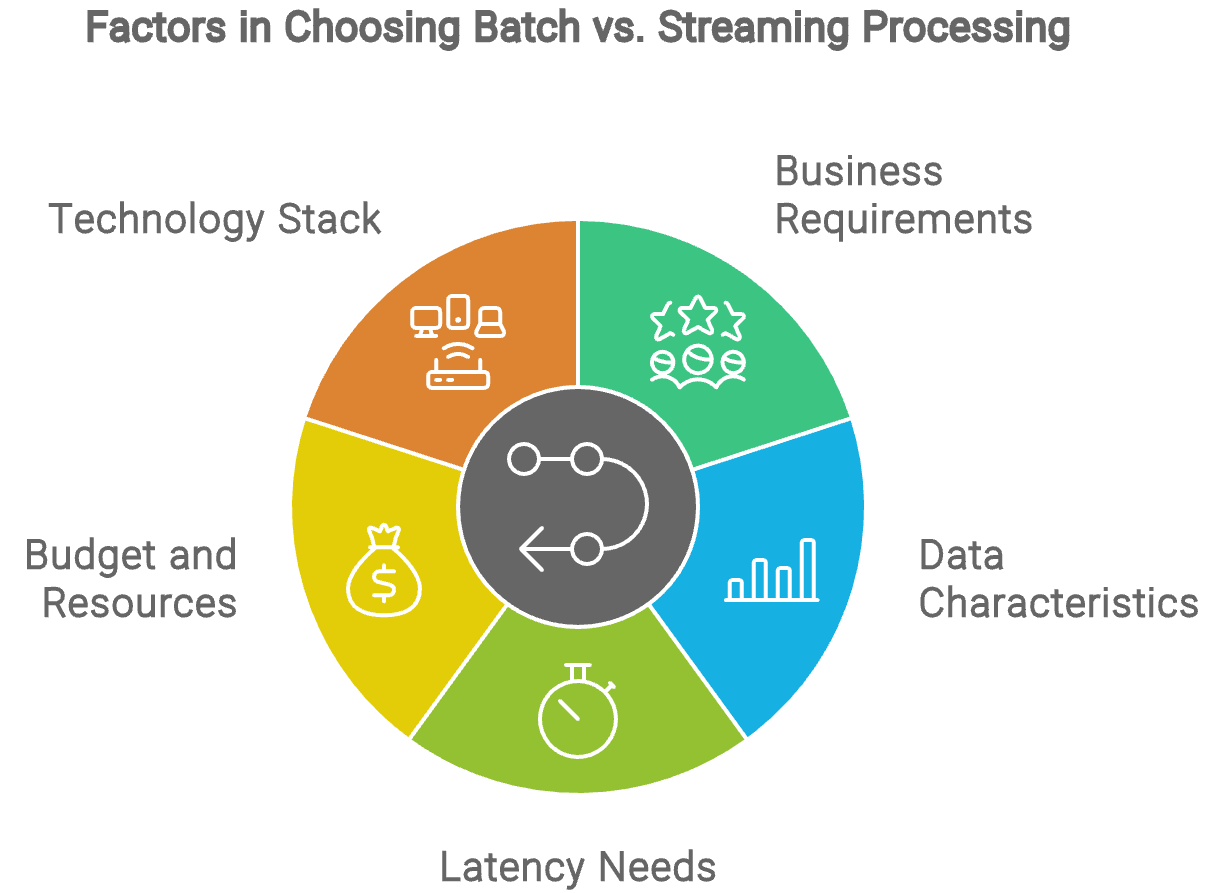
Je keuze afstemmen op bedrijfsvereisten, data-eigenschappen, latentiebehoeften, budget en bestaande technologie zorgt ervoor dat je de meest effectieve aanpak selecteert voor jouw dataverwerking.
Kies batchverwerking als je grote hoeveelheden historische data met periodieke analyses moet verwerken en je budget beperkt is. Kies streamingverwerking als realtime analyse en directe acties cruciaal zijn en je het benodigde budget en resources hebt voor een complexere, high-performance infrastructuur.
Mijn ervaring is dat streaming maar in weinig scenario's echt nodig is. Meestal kom je prima weg met batchverwerking.
Wil je meer leren over ETL/ELT, streamverwerking, batchverwerking en het bouwen van pijplijnen? Bekijk dan deze resources van DataCamp:
Leer meer over data engineering met deze cursussen!
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

