
Kurs
Einführung in das Data Engineering
4 Std.
129.7K
Batch- und Stream-Verarbeitung sind zwei grundlegende Ansätze, um Daten zu verarbeiten und zu analysieren. Beide Methoden zu verstehen, ist wichtig, um ihre jeweiligen Stärken in unterschiedlichen datengestützten Szenarien zu nutzen – von historischer Analyse bis zu Entscheidungen in Echtzeit.
Als Datenprofi solltest du die Stärken und Schwächen beider Ansätze kennen und wissen, wo du sie in deinen ETL- und ELT-Prozessen am besten einsetzt.
In diesem Artikel definieren wir Batch- und Stream-Verarbeitung, zeigen ihre Unterschiede und wie du für deinen konkreten Anwendungsfall die richtige Methode wählst.
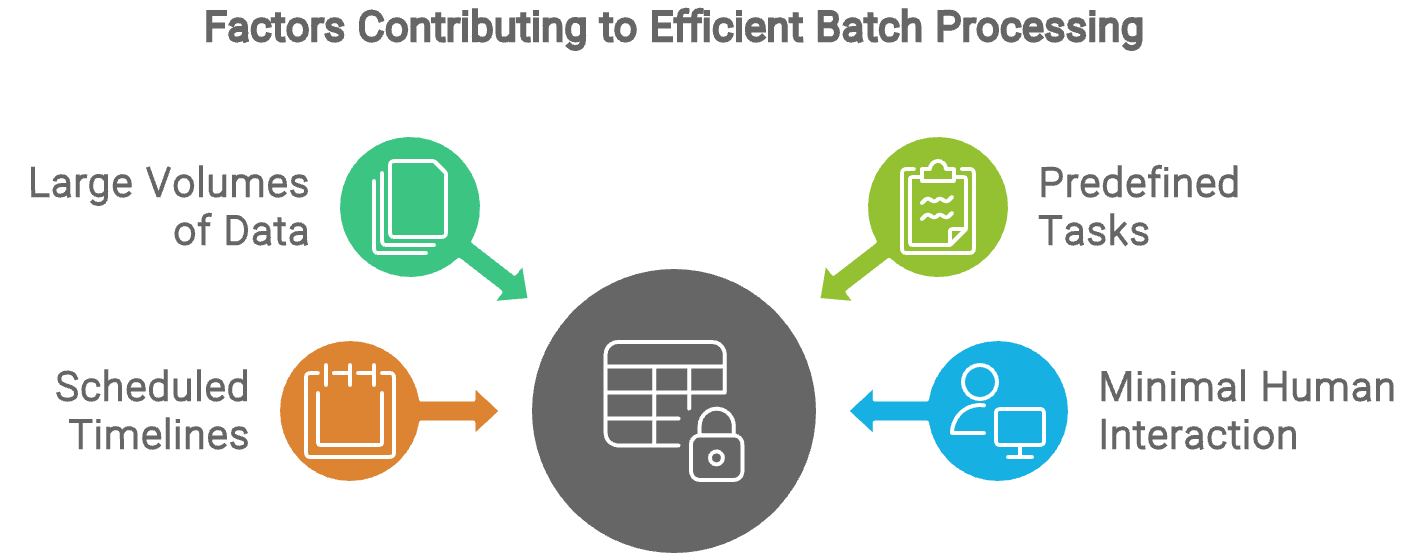
Bei der Batch-Verarbeitung werden große Mengen gesammelter Daten in Blöcken beziehungsweise Batches verarbeitet.
Dieser Ansatz ist besonders effektiv für ressourcenintensive Jobs, wiederkehrende Aufgaben und das Management umfangreicher Datensätze, wenn keine Echtzeitverarbeitung erforderlich ist. Ideal ist er für Anwendungen wie Data Warehousing, ETL (Extract, Transform, Load) und groß angelegte Berichte.
Dank ihrer Vielseitigkeit, verschiedenste Geschäftsanforderungen zu erfüllen, bleibt die Batch-Verarbeitung eine weit verbreitete Option für die Datenverarbeitung.
Die Verarbeitung in Batches ist weitgehend automatisiert und benötigt nach dem Setup nur wenig menschliches Eingreifen. Aufgaben sind vordefiniert, und das System führt sie nach einem Zeitplan aus – typischerweise außerhalb der Stoßzeiten, wenn Rechenressourcen verfügbar sind.
Der menschliche Aufwand beschränkt sich meist auf die anfängliche Konfiguration, das Beheben von Fehlern und die Ergebnisprüfung. Dadurch ist die Batch-Verarbeitung ein sehr effizienter, weitgehend manueller-freier Ansatz für großskalige Datenaufgaben.
Für die Batch-Verarbeitung gibt es diverse ETL-Tools. Ein verbreitetes Tool ist Apache Airflow, mit dem sich Datenorchestrierungs-Pipelines schnell aufsetzen, zeitgesteuert ausführen und einfach überwachen lassen. Probiere verschiedene Tools aus, um das für deine Anforderungen passende zu finden!
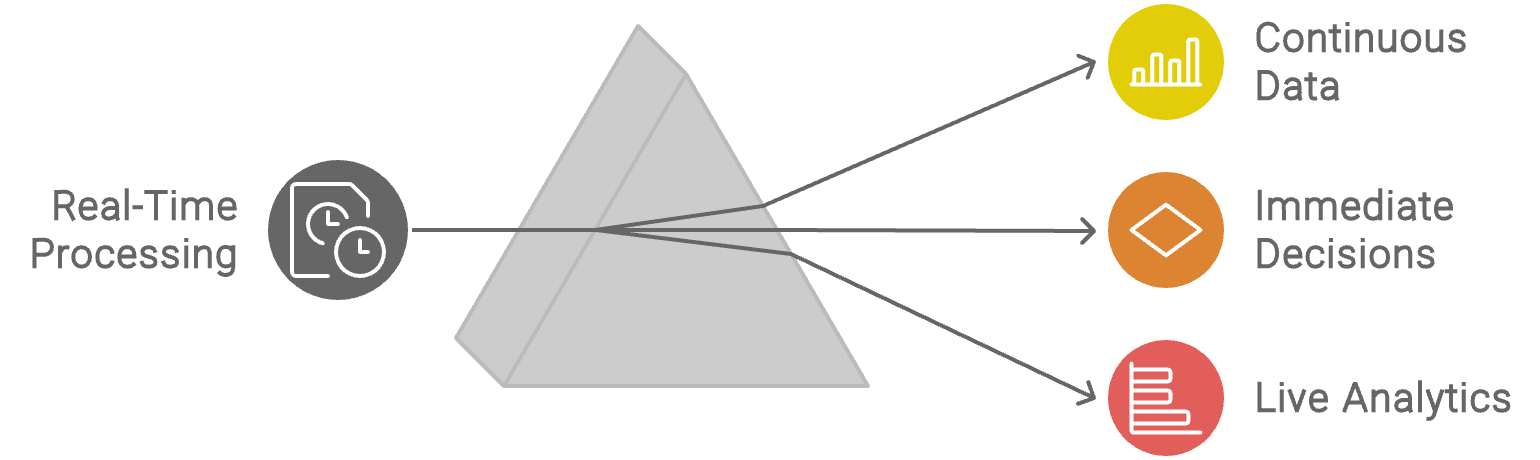
Stream-Verarbeitung, teils auch Streaming oder Echtzeit-Datenverarbeitung genannt, ist ein Ansatz, bei dem Daten in Echtzeit verarbeitet und analysiert werden, während sie durch ein System fließen.
Im Unterschied zur Batch-Verarbeitung, bei der Daten in großen, diskreten Blöcken in geplanten Intervallen gesammelt und verarbeitet werden, arbeitet die Stream-Verarbeitung kontinuierlich und inkrementell.
Daten stammen aus Quellen wie Sensoren, Logs, Transaktionen, Social-Media-Feeds oder anderen Live-Datenströmen.
Diese Datenströme werden bei Eingang verarbeitet – etwa gefiltert, transformiert und aggregiert. So sind Live-Analytics, Alarme, Echtzeit-Dashboards oder die Übergabe in weitere Systeme für Folgeschritte möglich. Die so gewonnenen Erkenntnisse fließen oft direkt in Entscheidungen ein.
Typische Anwendungen sind Echtzeit-Analysen für Finanzmärkte, Betrugserkennung, Monitoring von Netzwerkverkehr, Empfehlungssysteme und mehr.
Streaming-Systeme bieten oft Funktionen zur kontinuierlichen Überwachung und Steuerung von Datenflüssen und Verarbeitungspipelines, um hochfrequente Daten zu unterstützen. Dazu zählen die Performance-Überwachung, die Gesundheit der Datenströme und die Ergebnisse der Verarbeitung.
Ein populäres Framework ist AWS Kinesis in Kombination mit Lambda. Amazon Kinesis ist ein Cloud-Service zum Sammeln, Verarbeiten und Analysieren von Echtzeit-Streaming-Daten, während Lambda komplexe Funktionen und Automatisierung ermöglicht.
Nachdem wir Batch- und Stream-Prozesse definiert haben, schauen wir uns ihre Unterschiede an.
Batch und Stream unterscheiden sich deutlich darin, wie schnell Daten verarbeitet und analysiert werden können.
Auch die Datenmengen, die jeweils zu einem Zeitpunkt verarbeitet werden, unterscheiden sich stark.
Auch der Aufwand für Aufbau und Betrieb unterscheidet sich deutlich.
Je nach Methode eignen sich unterschiedliche Anwendungen und Use Cases.
Auch Infrastrukturbedarf und Kosten unterscheiden sich zwischen Batch- und Stream-Verarbeitung.
|
Batch-Verarbeitung |
Stream-Verarbeitung |
|
|
Datenlatenz |
Hohe Latenz, Verarbeitung nach festen Zeitplänen |
Geringe Latenz, Verarbeitung in Echtzeit |
|
Datenvolumen |
Große Blöcke auf einmal; kann sehr große Datenmengen gut geplant verarbeiten |
Große Volumina müssen kontinuierlich und sorgfältig gehandhabt werden |
|
Komplexität |
Geringere Komplexität durch planbare Daten; einfacher zu managen |
Höhere Komplexität durch höhere Geschwindigkeit, Menge und Vielfalt der Daten |
|
Anwendungsfälle |
Periodisch analysierte Daten, z. B. Monatsberichte oder wöchentliche Leistungskennzahlen |
Ständige Analyse, z. B. Betrugsalarme, Live-Streaming-Analytics und IoT-Verarbeitung |
|
Infrastruktur und Kosten |
Weniger komplexe Infrastruktur mit Fokus auf parallele Prozesse; geringere Kosten durch gemeinsame Ressourcennutzung |
Sehr komplexe Infrastruktur, die ständige Aufmerksamkeit und Flexibilität erfordert; erhebliche Kosten durch kontinuierliche Skalierung |
Batch vs. Stream-Verarbeitung: Zusammenfassung der Unterschiede
Die Batch-Verarbeitung deckt vielfältige Anforderungen ab – vor allem bei großen Datensätzen oder Routineaufgaben. Hier einige typische Szenarien, in denen Batch-Verarbeitung die pragmatische Lösung ist:
Batch-Verarbeitung wird in Data-Warehousing-Umgebungen häufig für ETL-Prozesse eingesetzt. So bleibt das Data Warehouse konsistent aktuell, ohne operative Systeme zu belasten.
Im Fokus steht das Aggregieren aus verschiedenen Quellen, die Transformation in passende Formate und das effiziente Laden in ein zentrales Data Warehouse in festen Intervallen.
Viele Unternehmen generieren damit regelmäßige Reports – etwa monatliche Umsatzübersichten oder quartalsweise Performance-Analysen.
Durch das Sammeln und Verarbeiten in festen Abständen entstehen umfassende Berichte mit wertvollen Einblicken in das Geschäft.
Für die Analyse historischer Daten ist Batch ideal: Große, über längere Zeiträume gewachsene Datensätze lassen sich regelmäßig und effizient auswerten.
So kannst du z. B. Jahre an Verkaufsdaten, Kundeninteraktionen oder operative Kennzahlen in einem Batch-Job analysieren, um Trends und Ausreißer zu erkennen – etwa Hinweise auf Ineffizienzen oder Risiken.
Mit Batch-Verarbeitung lassen sich große Datenmengen effizient von einem System ins andere bewegen. Durch Migration in Batches minimierst du Ausfallzeiten, sicherst einen reibungsloseren Übergang und bewahrst Datenintegrität.
Stream-Verarbeitung eignet sich besonders, wenn zeitnahe Einblicke und unmittelbare Reaktionen kritisch sind. Hier einige Beispiele, in denen Streaming glänzt.
Streaming ermöglicht die Analyse in Echtzeit eingehender Daten – mit sofortigen Einblicken in Trends, Kundenverhalten und potenzielle Probleme.
Ein plötzlicher Anstieg negativer Erwähnungen in sozialen Medien lässt sich etwa sofort erkennen, sodass das Unternehmen schnell reagieren kann.
Durch Analyse von Transaktionsmustern in Echtzeit kann das System Anomalien oder verdächtiges Verhalten – etwa ungewöhnliche Ausgaben oder Transaktionen von unerwarteten Orten – identifizieren und Alarme auslösen oder Buchungen blockieren. Das schützt Verbraucher und Unternehmen, indem das Risiko fehlerhafter Transaktionen sinkt.
TV-Sender nutzen Streaming, um während Sendungen Live-Updates und Informationen bereitzustellen.
Ein gutes Beispiel sind Sportereignisse. Echtzeitdaten wie Spielstände, Spielerstatistiken und Spielzüge werden verarbeitet, um aktuelle Infos zu liefern und mit Live-Kommentaren und interaktiven Features das Erlebnis zu verbessern.
In Smart Cities verarbeitet Streaming Daten von Sensoren in Ampeln, Parkuhren und im ÖPNV. Die Echtzeitanalyse dieser Daten optimiert Verkehrsflüsse, überwacht Luftqualität und verbessert das Management öffentlicher Verkehrssysteme.
Durch das Erkennen von Anomalien in Mobilitätsmustern, die auf Probleme hindeuten, können Verantwortliche proaktiv gegensteuern und Staus reduzieren.
Bei der Entscheidung zwischen Batch und Streaming spielen Geschäftsanforderungen, Dateneigenschaften, Latenzbedarf, Budget, Ressourcen und Tech-Stack eine Rolle. Diese Faktoren bestimmen den idealen Ansatz für dein Unternehmen und seine Datenanforderungen.
Jedes Unternehmen hat eigene Bedürfnisse. Zu verstehen, wie Daten-Workflows die Geschäftsziele beeinflussen, ist entscheidend für die passende Verarbeitungsmethode.
Wähle die Methode passend zur Art der Daten. Batch funktioniert am besten mit planbaren Datensätzen, Streaming ist für variablere Strukturen ausgelegt.
Neben den Geschäftsbedürfnissen ist entscheidend, wie viel Verzögerung akzeptabel ist. Ob Daten in Echtzeit oder periodisch verarbeitet werden können, entscheidet über Batch vs. Streaming.
Budget- und Ressourcengrenzen können die Wahl einschränken. Oft hat die Organisation bestehende Infrastruktur, an die du deine Pipelines anpassen musst.
Verschiedene Stacks haben unterschiedliche Fähigkeiten – die Toolwahl beeinflusst, ob Batch oder Streaming besser passt.
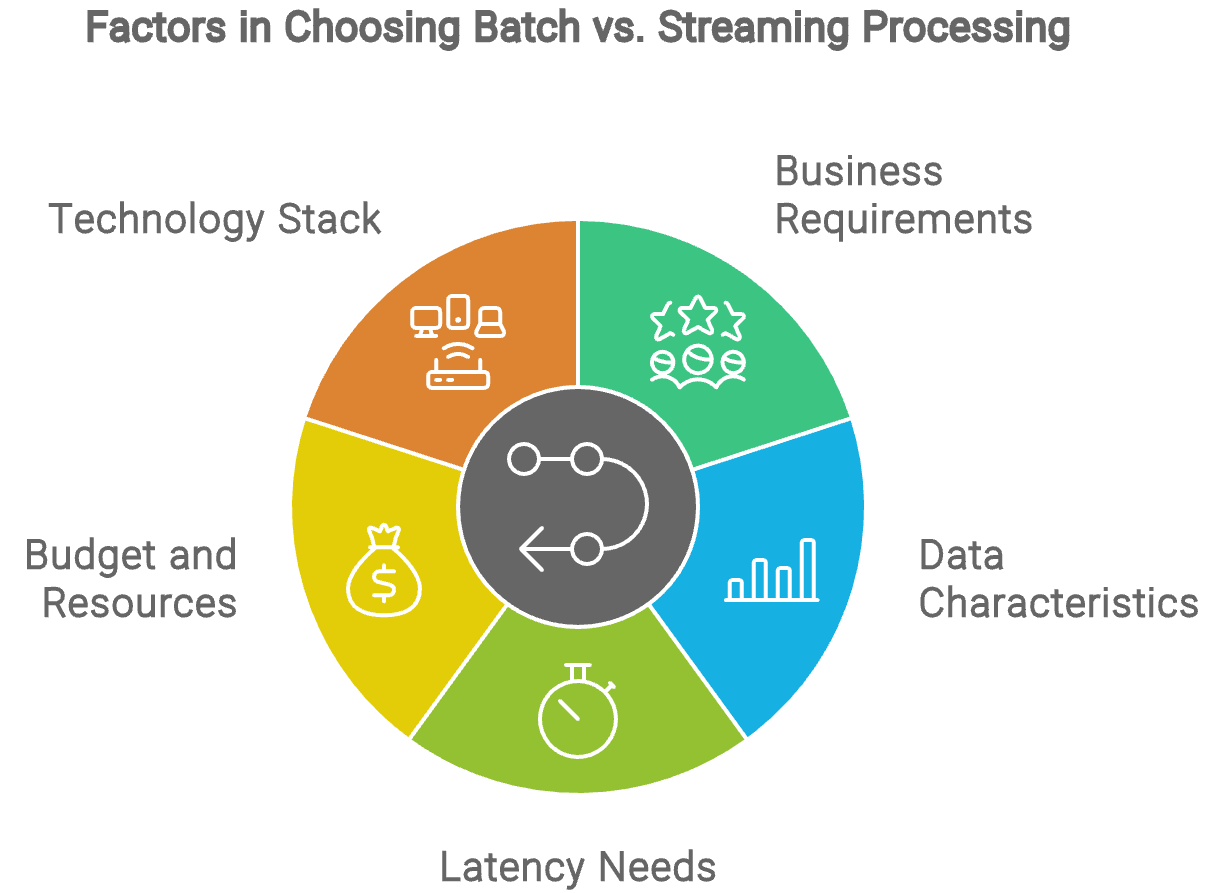
Wenn du deine Wahl an Geschäftsanforderungen, Dateneigenschaften, Latenzbedarf, Budget und bestehender Technologie ausrichtest, triffst du den effektivsten Ansatz für deine Datenverarbeitung.
Wähle Batch-Verarbeitung, wenn du große Mengen historischer Daten mit periodischer Analyse bewältigen willst und Budgetgrenzen hast. Entscheide dich für Stream-Verarbeitung, wenn Echtzeit-Analysen und sofortiges Handeln kritisch sind und du Budget und Ressourcen für komplexe Hochleistungsinfrastruktur mitbringst.
Aus meiner Erfahrung ist Streaming nur in wenigen Szenarien wirklich nötig. Meist kommst du mit Batch-Verarbeitung gut aus.
Wenn du mehr über ETL/ELT, Stream- und Batch-Verarbeitung sowie den Aufbau von Pipelines lernen möchtest, schau dir diese DataCamp-Ressourcen an:
Lerne mehr über Data Engineering mit diesen Kursen!
Kurs
Lernpfad
Kurs