बैच और स्ट्रीम प्रोसेसिंग डेटा को संभालने और विश्लेषित करने के दो बुनियादी तरीके हैं। दोनों विधियों को समझना विभिन्न डेटा-आधारित परिस्थितियों—ऐतिहासिक विश्लेषण से लेकर रीयल-टाइम निर्णय लेने तक—में प्रत्येक तरीके की ताकतों का लाभ उठाने के लिए महत्वपूर्ण है।
किसी भी डेटा प्रोफेशनल को दोनों तरीकों की खूबियों और सीमाओं के साथ-साथ ETL और ELT प्रक्रियाओं के लिए प्रत्येक को कहाँ लागू करना उपयुक्त है, यह समझना चाहिए।
इस लेख में, हम बैच और स्ट्रीम प्रोसेसिंग की परिभाषा, उनके बीच के अंतर, और आपके विशेष उपयोग मामले के लिए सही तरीका कैसे चुनें, यह बतायेंगे।
बैच प्रोसेसिंग क्या है?
बैच प्रोसेसिंग वह तरीका है जिसमें एकत्रित बड़े पैमाने के डेटा को हिस्सों या बैचों में प्रोसेस किया जाता है।
यह तरीका विशेष रूप से संसाधन-गहन कार्यों, दोहराव वाले टास्क, और ऐसे बड़े डेटासेट के लिए प्रभावी है जहाँ रीयल-टाइम प्रोसेसिंग की आवश्यकता नहीं होती। यह डेटा वेयरहाउसिंग, ETL (Extract, Transform, Load), और बड़े पैमाने की रिपोर्टिंग जैसे अनुप्रयोगों के लिए आदर्श है।
विभिन्न व्यावसायिक आवश्यकताओं को पूरा करने में इसकी बहुमुखी प्रतिभा के कारण, बैच प्रोसेसिंग डेटा प्रोसेसिंग के लिए व्यापक रूप से अपनाई जाती है।
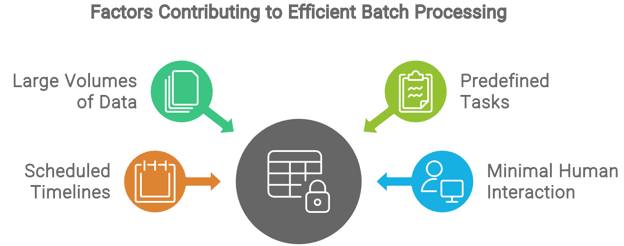
डेटा बैच प्रोसेसिंग मुख्य रूप से स्वचालित होती है, और एक बार सेटअप हो जाने के बाद न्यूनतम मानवीय हस्तक्षेप की आवश्यकता होती है। कार्य पूर्वनिर्धारित होते हैं, और सिस्टम उन्हें निर्धारित समयसारिणी के अनुसार निष्पादित करता है—आमतौर पर ऑफ-पीक घंटों में जब कंप्यूटिंग संसाधन आसानी से उपलब्ध होते हैं।
मानव सहभागिता आमतौर पर प्रारंभिक पैरामीटर कॉन्फ़िगर करने, त्रुटियाँ आने पर ट्रबलशूट करने, और आउटपुट की समीक्षा करने तक सीमित रहती है, जिससे बैच प्रोसेसिंग बड़े पैमाने के डेटा कार्यों के प्रबंधन का अत्यंत कुशल और हैंड्स-ऑफ तरीका बन जाता है।
बैच प्रोसेसिंग के लिए कई प्रकार के ETL टूल उपलब्ध हैं। एक आम टूल Apache Airflow है, जो उपयोगकर्ताओं को डेटा ऑर्केस्ट्रेशन पाइपलाइनों को शीघ्रता से बनाने देता है जो निर्धारित शेड्यूल पर चल सकती हैं और सरल मॉनिटरिंग देती हैं। अपनी व्यावसायिक ज़रूरतों के अनुसार सर्वश्रेष्ठ टूल चुनने के लिए विभिन्न टूल्स का अन्वेषण करें!
स्ट्रीम प्रोसेसिंग क्या है?
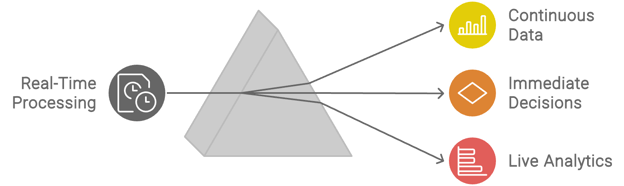
स्ट्रीम प्रोसेसिंग, जिसे कभी-कभी स्ट्रीमिंग प्रोसेसिंग या रीयल-टाइम डेटा प्रोसेसिंग भी कहा जाता है, एक ऐसा दृष्टिकोण है जो डेटा को सिस्टम में प्रवाहित होते ही रीयल-टाइम में संभालने और विश्लेषित करने के लिए बनाया गया है।
बैच प्रोसेसिंग के विपरीत, जिसमें डेटा को बड़े, अलग-अलग हिस्सों में तय अंतराल पर इकट्ठा कर प्रोसेस किया जाता है, स्ट्रीम प्रोसेसिंग डेटा को सतत और क्रमिक रूप से संभालती है।
डेटा विभिन्न स्रोतों जैसे सेंसर, लॉग, ट्रांजैक्शन, सोशल मीडिया फीड, या अन्य लाइव डेटा स्रोतों से एकत्रित किया जाता है।
इसके बाद प्राप्त होते ही डेटा स्ट्रीम्स को प्रोसेस किया जाता है, जिसमें फिल्टरिंग, ट्रांसफ़ॉर्मिंग, और एग्रीगेटिंग जैसी क्रियाएँ शामिल होती हैं। इससे लाइव एनालिटिक्स, अलर्ट ट्रिगर करना, रीयल-टाइम डैशबोर्ड, या आगे की कार्रवाई के लिए अन्य सिस्टम को डेटा भेजने जैसी रीयल-टाइम प्रक्रियाएँ संभव होती हैं। ये इनसाइट्स अक्सर त्वरित निर्णयों को प्रभावित करती हैं।
स्ट्रीमिंग प्रोसेसिंग के अनुप्रयोगों में वित्तीय बाज़ारों के रीयल-टाइम एनालिटिक्स, फ्रॉड डिटेक्शन, नेटवर्क ट्रैफ़िक मॉनिटरिंग, रिकमेंडेशन इंजन, इत्यादि शामिल हैं।
स्ट्रीमिंग सिस्टम अक्सर उच्च-वेलोसिटी डेटा को सपोर्ट करने के लिए डेटा फ्लो और प्रोसेसिंग पाइपलाइनों की लगातार मॉनिटरिंग और प्रबंधन की क्षमताएँ शामिल करते हैं। इसमें सिस्टम के प्रदर्शन, डेटा स्ट्रीम्स के स्वास्थ्य, और प्रोसेसिंग टास्क के परिणामों को ट्रैक करना शामिल है।
एक लोकप्रिय फ्रेमवर्क AWS Kinesis (Lambda के साथ) है। Amazon Kinesis एक क्लाउड-आधारित सेवा है जो आपको रीयल-टाइम स्ट्रीमिंग डेटा को एकत्रित, प्रोसेस और विश्लेषित करने देती है, जबकि Lambda जटिल फ़ंक्शंस और ऑटोमेशन को सपोर्ट करता है।
बैच प्रोसेसिंग और स्ट्रीमिंग प्रोसेसिंग के बीच अंतर
अब जब हमने बैच और स्ट्रीमिंग प्रक्रियाओं को परिभाषित कर लिया है, तो उनके कुछ अंतरों पर प्रकाश डालते हैं।
डेटा लेटेंसी
डेटा को कितनी तेजी से प्रोसेस और विश्लेषित किया जा सकता है, इस पर विचार करने पर बैच और स्ट्रीमिंग तरीकों में स्पष्ट अंतर है।
- स्ट्रीमिंग प्रोसेसिंग: कम।
- स्ट्रीमिंग प्रोसेसिंग डेटा को आते ही संभालती है, जिससे लगभग रीयल-टाइम विश्लेषण और निर्णय संभव होते हैं। यह उन अनुप्रयोगों के लिए आदर्श है जहाँ तुरंत प्रतिक्रिया महत्वपूर्ण है।
- बैच प्रोसेसिंग: अधिक।
- डेटा को एक अवधि में एकत्रित किया जाता है और निर्धारित अंतराल पर बैचों में प्रोसेस किया जाता है। यह तरीका उन परिदृश्यों के लिए उपयुक्त है जहाँ विश्लेषण का समय निर्णायक नहीं है।
डेटा वॉल्यूम
किसी भी समय पर प्रत्येक तरीका जितना डेटा संभाल सकता है, उसमें भी काफी अंतर होता है।
- स्ट्रीमिंग प्रोसेसिंग: रीयल-टाइम।
- यह सतत बड़े वॉल्यूम के डेटा को संभाल सकती है, लेकिन स्केलेबिलिटी सिस्टम के डिज़ाइन और इन्फ्रास्ट्रक्चर पर निर्भर करती है। रीयल-टाइम डेटा के विशाल वॉल्यूम को संभालने के लिए मज़बूत और स्केलेबल सिस्टम की ज़रूरत होती है।
- बैच प्रोसेसिंग: बड़े हिस्से।
- आम तौर पर उन विशाल वॉल्यूम के लिए अधिक उपयुक्त जो हिस्सों में प्रोसेस किए जा सकते हैं। बैच सिस्टम प्रोसेसिंग से पहले बड़े पैमाने पर डेटा को एकत्रित कर सकते हैं।
जटिलता
इन तरीकों को सेटअप और मेंटेन करने में शामिल जटिलता भी एक महत्वपूर्ण अंतर है।
- स्ट्रीमिंग प्रोसेसिंग: अधिक।
- लगातार डेटा स्ट्रीम्स को मैनेज करने, रीयल-टाइम प्रोसेसिंग सुनिश्चित करने, और स्टेट मैनेजमेंट व फॉल्ट टॉलरेंस जैसे मुद्दों को संभालने के लिए जटिल इन्फ्रास्ट्रक्चर की आवश्यकता होती है।
- बैच प्रोसेसिंग: कम।
- बैच प्रोसेसिंग सिस्टम आमतौर पर लागू करने और मैनेज करने में सरल होते हैं, क्योंकि प्रोसेसिंग पूर्वनिर्धारित अंतराल पर होती है और बड़े पैमाने के ऑपरेशनों के लिए अनुकूलित की जा सकती है।
उपयोग के मामले
अलग-अलग प्रोसेसिंग तरीके अलग-अलग प्रकार के अनुप्रयोगों और उपयोग मामलों के लिए उपयुक्त होते हैं।
- स्ट्रीमिंग प्रोसेसिंग: ऐसे परिदृश्य जहाँ रीयल-टाइम इनसाइट्स और तुरंत कार्रवाई आवश्यक हो।
- उदाहरण: ब्रांड सेंटिमेंट के लिए सोशल मीडिया मॉनिटरिंग, रीयल-टाइम ट्रैफ़िक मैनेजमेंट, या लाइव स्ट्रीमिंग एनालिटिक्स।
- बैच प्रोसेसिंग: ऐसे परिदृश्य जहाँ डेटा को बिना तात्कालिक कार्रवाई के अंतराल में प्रोसेस किया जा सकता है।
- उदाहरण: आवधिक रिपोर्टिंग, डेटा वेयरहाउसिंग, और बड़े पैमाने के डेटा ट्रांसफ़ॉर्मेशन।
इन्फ्रास्ट्रक्चर और लागत
बैच और स्ट्रीमिंग प्रोसेसिंग में इन्फ्रास्ट्रक्चर आवश्यकताएँ और संबंधित लागतें भी भिन्न होती हैं।
- स्ट्रीमिंग प्रोसेसिंग:
- इन्फ्रास्ट्रक्चर: सतत डेटा स्ट्रीम्स को संभालने के लिए विशेष इन्फ्रास्ट्रक्चर चाहिए, जिसमें हाई-थ्रूपुट डेटा पाइपलाइनें, रीयल-टाइम प्रोसेसिंग इंजन, और अक्सर जटिल डिस्ट्रीब्यूटेड सिस्टम शामिल होते हैं।
- लागत: संभावित रूप से अधिक, क्योंकि उच्च-प्रदर्शन कंप्यूटिंग संसाधन, निरंतर मॉनिटरिंग, और रीयल-टाइम डेटा को कुशलतापूर्वक मैनेज करने हेतु स्केलिंग की आवश्यकता होती है।
- बैच प्रोसेसिंग:
- इन्फ्रास्ट्रक्चर: आमतौर पर ऐसा इन्फ्रास्ट्रक्चर चाहिए जो आवधिक डेटा प्रोसेसिंग और स्टोरेज को सपोर्ट करता हो, जैसे डेटा वेयरहाउस या Hadoop क्लस्टर। यह इन्फ्रास्ट्रक्चर स्ट्रीमिंग सिस्टम की तुलना में कम जटिल हो सकता है।
- लागत: बड़े पैमाने की प्रोसेसिंग की लागत सामान्यतः कम होती है, क्योंकि मौजूदा स्टोरेज और कंप्यूटिंग संसाधनों का उपयोग किया जा सकता है और निरंतर ऑपरेशन की आवश्यकता नहीं होती।
| |
बैच प्रोसेसिंग
|
स्ट्रीम प्रोसेसिंग
|
|
डेटा लेटेंसी
|
उच्च लेटेंसी, तय शेड्यूल पर प्रोसेसिंग
|
कम लेटेंसी, रीयल-टाइम में प्रोसेसिंग
|
|
डेटा वॉल्यूम
|
एक साथ बड़े हिस्से, और बड़े वॉल्यूम को सुव्यवस्थित शेड्यूल के साथ संभाल सकता है
|
लगातार बड़े वॉल्यूम को सावधानी से संभालने की आवश्यकता
|
|
जटिलता
|
डेटा की पूर्वानुमेयता के कारण कम जटिल और प्रबंधन में आसान
|
उच्च जटिलता, क्योंकि डेटा की वेलोसिटी, वॉल्यूम और वैरायटी अधिक होती है
|
|
उपयोग के मामले
|
ऐसा डेटा प्रोसेस करना जिसका विश्लेषण आवधिक रूप से होता है, जैसे मासिक रिपोर्ट या साप्ताहिक परफ़ॉर्मेंस मैट्रिक्स
|
धोखाधड़ी अलर्ट, लाइव स्ट्रीमिंग एनालिटिक्स, और IoT प्रोसेसिंग जैसी चीज़ों के लिए निरंतर विश्लेषण
|
|
इन्फ्रास्ट्रक्चर और लागत
|
कम जटिल इन्फ्रास्ट्रक्चर जो समानांतर प्रोसेस को सपोर्ट करने पर केंद्रित है, और कम लागत क्योंकि संसाधन आसानी से साझा किए जा सकते हैं
|
अत्यधिक जटिल इन्फ्रास्ट्रक्चर जिसे निरंतर ध्यान और लचीलापन चाहिए, और लगातार स्केलिंग की आवश्यकता के कारण महत्वपूर्ण लागत आती है
|
बैच बनाम स्ट्रीमिंग प्रोसेसिंग: अंतरों का सार
बैच प्रोसेसिंग के सामान्य उपयोग मामले
बैच प्रोसेसिंग के विविध अनुप्रयोग हैं जो विभिन्न व्यावसायिक आवश्यकताओं की पूर्ति करते हैं, विशेषकर बड़े डेटासेट या नियमित कार्यों से जुड़ी स्थितियों में। नीचे ऐसे कई उदाहरण दिए गए हैं जहाँ बैच प्रोसेसिंग एक व्यावहारिक समाधान सिद्ध होती है:
डेटा वेयरहाउसिंग और ETL
बैच प्रोसेसिंग का उपयोग अक्सर डेटा वेयरहाउसिंग वातावरण में ETL प्रक्रियाओं के लिए होता है। यह सुनिश्चित करती है कि डेटा वेयरहाउस लगातार अप-टू-डेट रहे, जबकि ऑपरेशनल सिस्टम पर प्रभाव न्यूनतम हो।
यह विभिन्न स्रोतों से डेटा एकत्रित करने, उसे उपयुक्त फ़ॉर्मेट में ट्रांसफ़ॉर्म करने, और निर्धारित अंतराल पर कुशलतापूर्वक केंद्रीकृत डेटा वेयरहाउस में लोड करने पर केंद्रित रहती है।
आवधिक रिपोर्टिंग
कई संगठन बैच प्रोसेसिंग का उपयोग आवधिक रिपोर्ट बनाने के लिए करते हैं, जैसे मासिक बिक्री सारांश या तिमाही प्रदर्शन समीक्षा।
नियमित अंतराल पर डेटा एकत्रित और प्रोसेस करके, व्यवसाय व्यापक रिपोर्ट कुशलतापूर्वक तैयार कर सकते हैं जो उनके संचालन पर मूल्यवान इनसाइट्स प्रदान करती हैं।
ऐतिहासिक डेटा विश्लेषण
बैच प्रोसेसिंग ऐतिहासिक डेटा का विश्लेषण करने के लिए उपयुक्त है, क्योंकि यह लम्बी अवधि में संचित बड़े डेटासेट्स को नियमित रूप से प्रोसेस और जांच सकती है।
व्यवसाय एक ही बैच जॉब में वर्षों के बिक्री डेटा, ग्राहक इंटरैक्शन, या ऑपरेशनल मीट्रिक्स का विश्लेषण कर सकते हैं। यह व्यापक विश्लेषण रुझानों और विसंगतियों की पहचान करने में मदद कर सकता है जो परिचालन अक्षमताओं या जोखिमों की ओर इशारा करते हैं।
बड़े पैमाने के डेटा माइग्रेशन
बैच प्रोसेसिंग एक सिस्टम से दूसरे सिस्टम तक बड़े वॉल्यूम के डेटा को कुशलतापूर्वक स्थानांतरित कर सकती है। माइग्रेशन को बैचों में प्रोसेस करके, संगठन डाउनटाइम को न्यूनतम कर सकते हैं और डेटा अखंडता बनाए रखते हुए अधिक सुगम संक्रमण सुनिश्चित कर सकते हैं।
स्ट्रीमिंग प्रोसेसिंग के सामान्य उपयोग मामले
स्ट्रीमिंग प्रोसेसिंग विशेष रूप से उन परिदृश्यों के लिए उपयुक्त है जहाँ समय पर इनसाइट्स और त्वरित प्रतिक्रियाएँ महत्वपूर्ण होती हैं। यहाँ कुछ विशिष्ट उदाहरण हैं जहाँ स्ट्रीमिंग प्रोसेसिंग उत्कृष्ट प्रदर्शन करती है।
रीयल-टाइम एनालिटिक्स और मॉनिटरिंग
स्ट्रीमिंग प्रोसेसिंग आने वाले डेटा का रीयल-टाइम विश्लेषण सक्षम करती है, जिससे रुझानों, ग्राहक व्यवहार, और संभावित समस्याओं पर तात्कालिक इनसाइट्स मिलती हैं।
उदाहरण के लिए, सोशल मीडिया पर अचानक नकारात्मक उल्लेखों में वृद्धि तुरंत पकड़ी जा सकती है, जिससे कंपनी शीघ्र प्रतिक्रिया दे सकती है।
फ्रॉड डिटेक्शन
रीयल-टाइम में ट्रांजैक्शन पैटर्न का विश्लेषण करके, सिस्टम असामान्य खर्च पैटर्न या अप्रत्याशित स्थानों से ट्रांजैक्शन जैसी विसंगतियों या संदिग्ध व्यवहार की पहचान कर सकता है—और धोखाधड़ी रोकने के लिए अलर्ट ट्रिगर कर सकता है या ट्रांजैक्शन ब्लॉक कर सकता है। इससे उपभोक्ता और व्यवसाय दोनों को गलत ट्रांजैक्शन के जोखिम से सुरक्षा मिलती है।
लाइव डेटा फीड और इवेंट प्रोसेसिंग
टेलीविजन नेटवर्क प्रसारण के दौरान लाइव अपडेट और जानकारी प्रदान करने के लिए स्ट्रीमिंग प्रोसेसिंग का उपयोग करते हैं।
एक अच्छा उदाहरण खेल आयोजन हैं। रीयल-टाइम डेटा स्ट्रीम्स (जैसे स्कोर, खिलाड़ी आँकड़े, और प्ले-बाय-प्ले क्रियाएँ) को प्रोसेस करके अद्यतन जानकारी दी जाती है और लाइव कमेंट्री व इंटरैक्टिव फीचर्स के साथ दर्शकों की भागीदारी बढ़ाई जाती है।
IoT डेटा प्रोसेसिंग
स्मार्ट शहरों में, स्ट्रीमिंग प्रोसेसिंग ट्रैफ़िक लाइट्स, पार्किंग मीटर, और पब्लिक ट्रांसपोर्ट सिस्टम में एंबेडेड सेंसरों से प्राप्त डेटा को मैनेज करती है। इस डेटा का रीयल-टाइम विश्लेषण ट्रैफ़िक प्रवाह को अनुकूलित करने, वायु गुणवत्ता की निगरानी करने, और सार्वजनिक परिवहन प्रणालियों को कुशलतापूर्वक प्रबंधित करने में मदद करता है।
यात्रा पैटर्न में उन विसंगतियों का पता लगाकर जो संभावित समस्याओं का संकेत दे सकती हैं, शहर अधिकारी सक्रिय समायोजन कर सकते हैं और ट्रैफ़िक कम कर सकते हैं।
सही तरीका चुनना: किन कारकों पर विचार करें
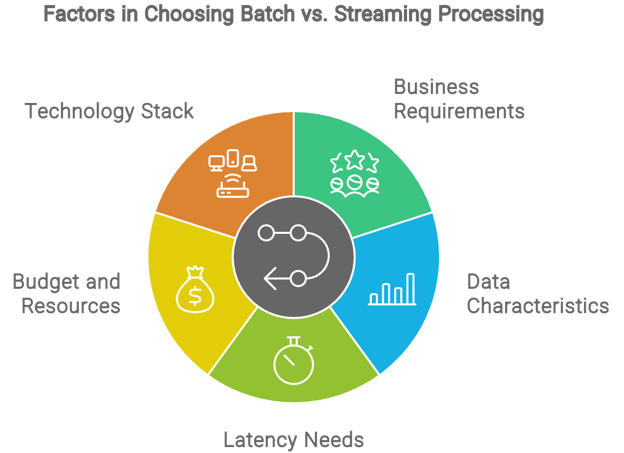
बैच और स्ट्रीमिंग प्रोसेसिंग के बीच निर्णय लेते समय व्यावसायिक आवश्यकताओं, डेटा की प्रकृति, लेटेंसी की ज़रूरत, बजट, संसाधन, और टेक्नोलॉजी स्टैक जैसे कई कारकों पर विचार करें। यही घटक आपके व्यवसाय और उसकी डेटा आवश्यकताओं के लिए आदर्श दृष्टिकोण निर्धारित करते हैं।
व्यावसायिक आवश्यकताएँ
हर व्यवसाय की ज़रूरतें अलग होती हैं, और डेटा वर्कफ़्लो का व्यावसायिक लक्ष्यों पर क्या प्रभाव पड़ता है, यह समझना उचित प्रोसेसिंग फ़्रेमवर्क लागू करने के लिए महत्वपूर्ण है।
- बैच प्रोसेसिंग: बैच चुनें यदि आपके व्यवसाय को आवधिक रिपोर्ट बनानी हैं, ऐतिहासिक डेटा का विश्लेषण करना है, या बड़े पैमाने के डेटा ट्रांसफ़ॉर्मेशन करने हैं जहाँ तुरंत प्रतिक्रिया आवश्यक नहीं है। यह मासिक वित्तीय रिपोर्टिंग या दिनांत डेटा एग्रीगेशन जैसे परिदृश्यों के लिए उपयुक्त है।
- स्ट्रीम प्रोसेसिंग: स्ट्रीमिंग तब चुनें जब आपके व्यवसाय को रीयल-टाइम इनसाइट्स और तुरंत कार्रवाई चाहिए। यह फ्रॉड डिटेक्शन, लाइव ट्रैफ़िक मैनेजमेंट, या रीयल-टाइम कस्टमर एंगेजमेंट जैसे अनुप्रयोगों के लिए आदर्श है, जहाँ समय पर विश्लेषण निर्णय लेने और संचालन दक्षता के लिए महत्वपूर्ण है।
डेटा की विशेषताएँ
जानें कि अलग-अलग प्रकार के डेटा के लिए कौन-सा तरीका बेहतर है। बैच प्रोसेसिंग पूर्वानुमेय डेटासेट के साथ सबसे अच्छा काम करती है, जबकि स्ट्रीम प्रोसेसिंग अधिक परिवर्तनीय डेटा संरचना को संभालने के लिए डिज़ाइन की गई है।
- बैच प्रोसेसिंग ऐसे बड़े वॉल्यूम के ऐतिहासिक या एग्रीगेटेड डेटा के लिए उपयुक्त है जिनका तुरंत विश्लेषण करना आवश्यक नहीं। यदि आपका डेटा थोक में एकत्रित होता है और आवधिक रूप से प्रोसेस होता है, तो बैच प्रोसेसिंग इसे कुशलतापूर्वक संभाल लेगी।
- स्ट्रीम प्रोसेसिंग सतत, उच्च-वेलोसिटी डेटा के लिए आदर्श है जिसे आते ही प्रोसेस और विश्लेषित करना होता है। यदि आपका डेटा लगातार प्रवाह में रहता है और रीयल-टाइम प्रोसेसिंग आवश्यक है—जैसे IoT सेंसर या लाइव सोशल मीडिया फीड—तो स्ट्रीमिंग इन आवश्यकताओं को पूरा करेगी।
लेटेंसी की ज़रूरत
व्यावसायिक ज़रूरतों को समझना महत्वपूर्ण है, लेकिन स्वीकार्य डेटा विलंब कितना है, यह समझना निर्णायक है। डेटा को रीयल-टाइम में चाहिए या उसे आवधिक रूप से संभाला जा सकता है—यही बैच बनाम स्ट्रीमिंग का मुख्य निर्धारक होगा।
- बैच प्रोसेसिंग: यदि आपका अनुप्रयोग कुछ विलंब सहन कर सकता है और तुरंत इनसाइट्स आवश्यक नहीं हैं, तो बैच प्रोसेसिंग उपयुक्त है। रिपोर्ट बनाने या रुझानों का विश्लेषण करने जैसे मामलों में, जहाँ रीयल-टाइम विश्लेषण जरूरी नहीं, बैच की अधिक लेटेंसी स्वीकार्य है।
- स्ट्रीम प्रोसेसिंग: यदि आपके अनुप्रयोग को कम लेटेंसी और रीयल-टाइम प्रतिक्रिया चाहिए, तो स्ट्रीमिंग चुनें। यह लाइव ट्रांजैक्शन मॉनिटरिंग या रीयल-टाइम विसंगति पहचान जैसे परिदृश्यों के लिए आवश्यक है।
बजट और संसाधन
बजट और संसाधनों की सीमाएँ आपके चुनाव को सीमित कर सकती हैं। आपका संगठन मौजूदा इन्फ्रास्ट्रक्चर का उपयोग प्राथमिकता दे सकता है, और आपको अपनी पाइपलाइनों को उसी में फिट करना पड़ सकता है।
- बैच प्रोसेसिंग: सामान्यतः कम जटिल और बड़े वॉल्यूम के डेटा को संभालने में अधिक किफायती होती है। इसमें आमतौर पर कम सतत मेंटेनेंस लगता है और कम विशेष इन्फ्रास्ट्रक्चर से लागू किया जा सकता है, जिससे बड़े पैमाने के डेटा ऑपरेशनों के लिए यह बजट-अनुकूल विकल्प बनता है।
- स्ट्रीम प्रोसेसिंग: स्ट्रीमिंग अधिक महंगी हो सकती है क्योंकि सतत डेटा फ्लो को संभालने के लिए विशेष इन्फ्रास्ट्रक्चर और तकनीक चाहिए। रीयल-टाइम प्रोसेसिंग इंजन और स्केलिंग संसाधनों पर अधिक लागत आ सकती है, इसलिए सुनिश्चित करें कि आपका बजट इन आवश्यकताओं को वहन कर सके।
टेक्नोलॉजी स्टैक
अलग-अलग टेक्नोलॉजी स्टैक की क्षमताएँ भिन्न होती हैं, और टूल्स का चुनाव इस पर महत्वपूर्ण प्रभाव डालता है कि बैच या स्ट्रीमिंग में से कौन-सा तरीका आपकी ज़रूरतों के लिए बेहतर है।
- बैच प्रोसेसिंग: यदि आपके मौजूदा स्टैक में Google BigQuery, Amazon Redshift, या Snowflake जैसे आधुनिक डेटा वेयरहाउसिंग समाधान शामिल हैं, तो आप बैच की ओर झुक सकते हैं। Apache Spark (बैच मोड) या Azure Data Factory जैसे टूल्स का उपयोग अक्सर बड़े पैमाने की बैच ऑपरेशनों को संभालने के लिए किया जाता है। ये प्लेटफ़ॉर्म निर्धारित अंतराल पर विशाल मात्रा में डेटा प्रोसेस करने देते हैं, जिससे वे ETL/ELT पाइपलाइनों, आवधिक रिपोर्टिंग, और डेटा एग्रीगेशन जैसे कार्यों के लिए उपयुक्त होते हैं।
- स्ट्रीम प्रोसेसिंग: यदि आपके स्टैक में Apache Kafka, Apache Flink, या Amazon Kinesis जैसे रीयल-टाइम प्रोसेसिंग टूल्स हैं और आपका इन्फ्रास्ट्रक्चर सतत डेटा फ्लो को संभालने के लिए डिज़ाइन किया गया है, तो स्ट्रीमिंग अधिक उपयुक्त हो सकती है। ये तकनीकें कम लेटेंसी, रीयल-टाइम एनालिटिक्स और निर्णय लेने को सपोर्ट करने के लिए बनी हैं। Google Cloud Dataflow और AWS Lambda जैसी क्लाउड-नेटिव सेवाएँ आधुनिक इन्फ्रास्ट्रक्चर में निर्बाध रीयल-टाइम प्रोसेसिंग को सुगम बनाती हैं।
निष्कर्ष
अपनी पसंद को व्यावसायिक आवश्यकताओं, डेटा की विशेषताओं, लेटेंसी की ज़रूरत, बजट, और मौजूदा टेक्नोलॉजी के साथ संरेखित करने से आप अपनी डेटा प्रोसेसिंग ज़रूरतों के लिए सबसे प्रभावी तरीका चुन सकेंगे।
यदि आपको आवधिक विश्लेषण के साथ बड़े वॉल्यूम के ऐतिहासिक डेटा को संभालना है और बजट सीमित है, तो बैच प्रोसेसिंग चुनें। यदि रीयल-टाइम विश्लेषण और तुरंत कार्रवाई महत्वपूर्ण हैं और आपके पास अधिक जटिल, उच्च-प्रदर्शन इन्फ्रास्ट्रक्चर के लिए आवश्यक बजट और संसाधन हैं, तो स्ट्रीमिंग चुनें।
मेरे अनुभव में, स्ट्रीमिंग की आवश्यकता बहुत कम परिदृश्यों में होती है। अधिकांश समय, आप बैच प्रोसेसिंग से काम चला सकते हैं।
यदि आप ETL/ELT, स्ट्रीम प्रोसेसिंग, बैच प्रोसेसिंग, और पाइपलाइन बनाने के बारे में और सीखना चाहते हैं, तो DataCamp के ये संसाधन देखें:


बैच और स्ट्रीम प्रोसेसिंग डेटा को संभालने और विश्लेषित करने के दो बुनियादी तरीके हैं। दोनों विधियों को समझना विभिन्न डेटा-आधारित परिस्थितियों—ऐतिहासिक विश्लेषण से लेकर रीयल-टाइम निर्णय लेने तक—में प्रत्येक तरीके की ताकतों का लाभ उठाने के लिए महत्वपूर्ण है।
किसी भी डेटा प्रोफेशनल को दोनों तरीकों की खूबियों और सीमाओं के साथ-साथ ETL और ELT प्रक्रियाओं के लिए प्रत्येक को कहाँ लागू करना उपयुक्त है, यह समझना चाहिए।
इस लेख में, हम बैच और स्ट्रीम प्रोसेसिंग की परिभाषा, उनके बीच के अंतर, और आपके विशेष उपयोग मामले के लिए सही तरीका कैसे चुनें, यह बतायेंगे।
बैच प्रोसेसिंग क्या है?
बैच प्रोसेसिंग वह तरीका है जिसमें एकत्रित बड़े पैमाने के डेटा को हिस्सों या बैचों में प्रोसेस किया जाता है।
यह तरीका विशेष रूप से संसाधन-गहन कार्यों, दोहराव वाले टास्क, और ऐसे बड़े डेटासेट के लिए प्रभावी है जहाँ रीयल-टाइम प्रोसेसिंग की आवश्यकता नहीं होती। यह डेटा वेयरहाउसिंग, ETL (Extract, Transform, Load), और बड़े पैमाने की रिपोर्टिंग जैसे अनुप्रयोगों के लिए आदर्श है।
विभिन्न व्यावसायिक आवश्यकताओं को पूरा करने में इसकी बहुमुखी प्रतिभा के कारण, बैच प्रोसेसिंग डेटा प्रोसेसिंग के लिए व्यापक रूप से अपनाई जाती है।
डेटा बैच प्रोसेसिंग मुख्य रूप से स्वचालित होती है, और एक बार सेटअप हो जाने के बाद न्यूनतम मानवीय हस्तक्षेप की आवश्यकता होती है। कार्य पूर्वनिर्धारित होते हैं, और सिस्टम उन्हें निर्धारित समयसारिणी के अनुसार निष्पादित करता है—आमतौर पर ऑफ-पीक घंटों में जब कंप्यूटिंग संसाधन आसानी से उपलब्ध होते हैं।
मानव सहभागिता आमतौर पर प्रारंभिक पैरामीटर कॉन्फ़िगर करने, त्रुटियाँ आने पर ट्रबलशूट करने, और आउटपुट की समीक्षा करने तक सीमित रहती है, जिससे बैच प्रोसेसिंग बड़े पैमाने के डेटा कार्यों के प्रबंधन का अत्यंत कुशल और हैंड्स-ऑफ तरीका बन जाता है।
बैच प्रोसेसिंग के लिए कई प्रकार के ETL टूल उपलब्ध हैं। एक आम टूल Apache Airflow है, जो उपयोगकर्ताओं को डेटा ऑर्केस्ट्रेशन पाइपलाइनों को शीघ्रता से बनाने देता है जो निर्धारित शेड्यूल पर चल सकती हैं और सरल मॉनिटरिंग देती हैं। अपनी व्यावसायिक ज़रूरतों के अनुसार सर्वश्रेष्ठ टूल चुनने के लिए विभिन्न टूल्स का अन्वेषण करें!
स्ट्रीम प्रोसेसिंग क्या है?
स्ट्रीम प्रोसेसिंग, जिसे कभी-कभी स्ट्रीमिंग प्रोसेसिंग या रीयल-टाइम डेटा प्रोसेसिंग भी कहा जाता है, एक ऐसा दृष्टिकोण है जो डेटा को सिस्टम में प्रवाहित होते ही रीयल-टाइम में संभालने और विश्लेषित करने के लिए बनाया गया है।
बैच प्रोसेसिंग के विपरीत, जिसमें डेटा को बड़े, अलग-अलग हिस्सों में तय अंतराल पर इकट्ठा कर प्रोसेस किया जाता है, स्ट्रीम प्रोसेसिंग डेटा को सतत और क्रमिक रूप से संभालती है।
डेटा विभिन्न स्रोतों जैसे सेंसर, लॉग, ट्रांजैक्शन, सोशल मीडिया फीड, या अन्य लाइव डेटा स्रोतों से एकत्रित किया जाता है।
इसके बाद प्राप्त होते ही डेटा स्ट्रीम्स को प्रोसेस किया जाता है, जिसमें फिल्टरिंग, ट्रांसफ़ॉर्मिंग, और एग्रीगेटिंग जैसी क्रियाएँ शामिल होती हैं। इससे लाइव एनालिटिक्स, अलर्ट ट्रिगर करना, रीयल-टाइम डैशबोर्ड, या आगे की कार्रवाई के लिए अन्य सिस्टम को डेटा भेजने जैसी रीयल-टाइम प्रक्रियाएँ संभव होती हैं। ये इनसाइट्स अक्सर त्वरित निर्णयों को प्रभावित करती हैं।
स्ट्रीमिंग प्रोसेसिंग के अनुप्रयोगों में वित्तीय बाज़ारों के रीयल-टाइम एनालिटिक्स, फ्रॉड डिटेक्शन, नेटवर्क ट्रैफ़िक मॉनिटरिंग, रिकमेंडेशन इंजन, इत्यादि शामिल हैं।
स्ट्रीमिंग सिस्टम अक्सर उच्च-वेलोसिटी डेटा को सपोर्ट करने के लिए डेटा फ्लो और प्रोसेसिंग पाइपलाइनों की लगातार मॉनिटरिंग और प्रबंधन की क्षमताएँ शामिल करते हैं। इसमें सिस्टम के प्रदर्शन, डेटा स्ट्रीम्स के स्वास्थ्य, और प्रोसेसिंग टास्क के परिणामों को ट्रैक करना शामिल है।
एक लोकप्रिय फ्रेमवर्क AWS Kinesis (Lambda के साथ) है। Amazon Kinesis एक क्लाउड-आधारित सेवा है जो आपको रीयल-टाइम स्ट्रीमिंग डेटा को एकत्रित, प्रोसेस और विश्लेषित करने देती है, जबकि Lambda जटिल फ़ंक्शंस और ऑटोमेशन को सपोर्ट करता है।
बैच प्रोसेसिंग और स्ट्रीमिंग प्रोसेसिंग के बीच अंतर
अब जब हमने बैच और स्ट्रीमिंग प्रक्रियाओं को परिभाषित कर लिया है, तो उनके कुछ अंतरों पर प्रकाश डालते हैं।
डेटा लेटेंसी
डेटा को कितनी तेजी से प्रोसेस और विश्लेषित किया जा सकता है, इस पर विचार करने पर बैच और स्ट्रीमिंग तरीकों में स्पष्ट अंतर है।
डेटा वॉल्यूम
किसी भी समय पर प्रत्येक तरीका जितना डेटा संभाल सकता है, उसमें भी काफी अंतर होता है।
जटिलता
इन तरीकों को सेटअप और मेंटेन करने में शामिल जटिलता भी एक महत्वपूर्ण अंतर है।
उपयोग के मामले
अलग-अलग प्रोसेसिंग तरीके अलग-अलग प्रकार के अनुप्रयोगों और उपयोग मामलों के लिए उपयुक्त होते हैं।
इन्फ्रास्ट्रक्चर और लागत
बैच और स्ट्रीमिंग प्रोसेसिंग में इन्फ्रास्ट्रक्चर आवश्यकताएँ और संबंधित लागतें भी भिन्न होती हैं।
बैच प्रोसेसिंग
स्ट्रीम प्रोसेसिंग
डेटा लेटेंसी
उच्च लेटेंसी, तय शेड्यूल पर प्रोसेसिंग
कम लेटेंसी, रीयल-टाइम में प्रोसेसिंग
डेटा वॉल्यूम
एक साथ बड़े हिस्से, और बड़े वॉल्यूम को सुव्यवस्थित शेड्यूल के साथ संभाल सकता है
लगातार बड़े वॉल्यूम को सावधानी से संभालने की आवश्यकता
जटिलता
डेटा की पूर्वानुमेयता के कारण कम जटिल और प्रबंधन में आसान
उच्च जटिलता, क्योंकि डेटा की वेलोसिटी, वॉल्यूम और वैरायटी अधिक होती है
उपयोग के मामले
ऐसा डेटा प्रोसेस करना जिसका विश्लेषण आवधिक रूप से होता है, जैसे मासिक रिपोर्ट या साप्ताहिक परफ़ॉर्मेंस मैट्रिक्स
धोखाधड़ी अलर्ट, लाइव स्ट्रीमिंग एनालिटिक्स, और IoT प्रोसेसिंग जैसी चीज़ों के लिए निरंतर विश्लेषण
इन्फ्रास्ट्रक्चर और लागत
कम जटिल इन्फ्रास्ट्रक्चर जो समानांतर प्रोसेस को सपोर्ट करने पर केंद्रित है, और कम लागत क्योंकि संसाधन आसानी से साझा किए जा सकते हैं
अत्यधिक जटिल इन्फ्रास्ट्रक्चर जिसे निरंतर ध्यान और लचीलापन चाहिए, और लगातार स्केलिंग की आवश्यकता के कारण महत्वपूर्ण लागत आती है
बैच बनाम स्ट्रीमिंग प्रोसेसिंग: अंतरों का सार
बैच प्रोसेसिंग के सामान्य उपयोग मामले
बैच प्रोसेसिंग के विविध अनुप्रयोग हैं जो विभिन्न व्यावसायिक आवश्यकताओं की पूर्ति करते हैं, विशेषकर बड़े डेटासेट या नियमित कार्यों से जुड़ी स्थितियों में। नीचे ऐसे कई उदाहरण दिए गए हैं जहाँ बैच प्रोसेसिंग एक व्यावहारिक समाधान सिद्ध होती है:
डेटा वेयरहाउसिंग और ETL
बैच प्रोसेसिंग का उपयोग अक्सर डेटा वेयरहाउसिंग वातावरण में ETL प्रक्रियाओं के लिए होता है। यह सुनिश्चित करती है कि डेटा वेयरहाउस लगातार अप-टू-डेट रहे, जबकि ऑपरेशनल सिस्टम पर प्रभाव न्यूनतम हो।
यह विभिन्न स्रोतों से डेटा एकत्रित करने, उसे उपयुक्त फ़ॉर्मेट में ट्रांसफ़ॉर्म करने, और निर्धारित अंतराल पर कुशलतापूर्वक केंद्रीकृत डेटा वेयरहाउस में लोड करने पर केंद्रित रहती है।
आवधिक रिपोर्टिंग
कई संगठन बैच प्रोसेसिंग का उपयोग आवधिक रिपोर्ट बनाने के लिए करते हैं, जैसे मासिक बिक्री सारांश या तिमाही प्रदर्शन समीक्षा।
नियमित अंतराल पर डेटा एकत्रित और प्रोसेस करके, व्यवसाय व्यापक रिपोर्ट कुशलतापूर्वक तैयार कर सकते हैं जो उनके संचालन पर मूल्यवान इनसाइट्स प्रदान करती हैं।
ऐतिहासिक डेटा विश्लेषण
बैच प्रोसेसिंग ऐतिहासिक डेटा का विश्लेषण करने के लिए उपयुक्त है, क्योंकि यह लम्बी अवधि में संचित बड़े डेटासेट्स को नियमित रूप से प्रोसेस और जांच सकती है।
व्यवसाय एक ही बैच जॉब में वर्षों के बिक्री डेटा, ग्राहक इंटरैक्शन, या ऑपरेशनल मीट्रिक्स का विश्लेषण कर सकते हैं। यह व्यापक विश्लेषण रुझानों और विसंगतियों की पहचान करने में मदद कर सकता है जो परिचालन अक्षमताओं या जोखिमों की ओर इशारा करते हैं।
बड़े पैमाने के डेटा माइग्रेशन
बैच प्रोसेसिंग एक सिस्टम से दूसरे सिस्टम तक बड़े वॉल्यूम के डेटा को कुशलतापूर्वक स्थानांतरित कर सकती है। माइग्रेशन को बैचों में प्रोसेस करके, संगठन डाउनटाइम को न्यूनतम कर सकते हैं और डेटा अखंडता बनाए रखते हुए अधिक सुगम संक्रमण सुनिश्चित कर सकते हैं।
स्ट्रीमिंग प्रोसेसिंग के सामान्य उपयोग मामले
स्ट्रीमिंग प्रोसेसिंग विशेष रूप से उन परिदृश्यों के लिए उपयुक्त है जहाँ समय पर इनसाइट्स और त्वरित प्रतिक्रियाएँ महत्वपूर्ण होती हैं। यहाँ कुछ विशिष्ट उदाहरण हैं जहाँ स्ट्रीमिंग प्रोसेसिंग उत्कृष्ट प्रदर्शन करती है।
रीयल-टाइम एनालिटिक्स और मॉनिटरिंग
स्ट्रीमिंग प्रोसेसिंग आने वाले डेटा का रीयल-टाइम विश्लेषण सक्षम करती है, जिससे रुझानों, ग्राहक व्यवहार, और संभावित समस्याओं पर तात्कालिक इनसाइट्स मिलती हैं।
उदाहरण के लिए, सोशल मीडिया पर अचानक नकारात्मक उल्लेखों में वृद्धि तुरंत पकड़ी जा सकती है, जिससे कंपनी शीघ्र प्रतिक्रिया दे सकती है।
फ्रॉड डिटेक्शन
रीयल-टाइम में ट्रांजैक्शन पैटर्न का विश्लेषण करके, सिस्टम असामान्य खर्च पैटर्न या अप्रत्याशित स्थानों से ट्रांजैक्शन जैसी विसंगतियों या संदिग्ध व्यवहार की पहचान कर सकता है—और धोखाधड़ी रोकने के लिए अलर्ट ट्रिगर कर सकता है या ट्रांजैक्शन ब्लॉक कर सकता है। इससे उपभोक्ता और व्यवसाय दोनों को गलत ट्रांजैक्शन के जोखिम से सुरक्षा मिलती है।
लाइव डेटा फीड और इवेंट प्रोसेसिंग
टेलीविजन नेटवर्क प्रसारण के दौरान लाइव अपडेट और जानकारी प्रदान करने के लिए स्ट्रीमिंग प्रोसेसिंग का उपयोग करते हैं।
एक अच्छा उदाहरण खेल आयोजन हैं। रीयल-टाइम डेटा स्ट्रीम्स (जैसे स्कोर, खिलाड़ी आँकड़े, और प्ले-बाय-प्ले क्रियाएँ) को प्रोसेस करके अद्यतन जानकारी दी जाती है और लाइव कमेंट्री व इंटरैक्टिव फीचर्स के साथ दर्शकों की भागीदारी बढ़ाई जाती है।
IoT डेटा प्रोसेसिंग
स्मार्ट शहरों में, स्ट्रीमिंग प्रोसेसिंग ट्रैफ़िक लाइट्स, पार्किंग मीटर, और पब्लिक ट्रांसपोर्ट सिस्टम में एंबेडेड सेंसरों से प्राप्त डेटा को मैनेज करती है। इस डेटा का रीयल-टाइम विश्लेषण ट्रैफ़िक प्रवाह को अनुकूलित करने, वायु गुणवत्ता की निगरानी करने, और सार्वजनिक परिवहन प्रणालियों को कुशलतापूर्वक प्रबंधित करने में मदद करता है।
यात्रा पैटर्न में उन विसंगतियों का पता लगाकर जो संभावित समस्याओं का संकेत दे सकती हैं, शहर अधिकारी सक्रिय समायोजन कर सकते हैं और ट्रैफ़िक कम कर सकते हैं।
सही तरीका चुनना: किन कारकों पर विचार करें
बैच और स्ट्रीमिंग प्रोसेसिंग के बीच निर्णय लेते समय व्यावसायिक आवश्यकताओं, डेटा की प्रकृति, लेटेंसी की ज़रूरत, बजट, संसाधन, और टेक्नोलॉजी स्टैक जैसे कई कारकों पर विचार करें। यही घटक आपके व्यवसाय और उसकी डेटा आवश्यकताओं के लिए आदर्श दृष्टिकोण निर्धारित करते हैं।
व्यावसायिक आवश्यकताएँ
हर व्यवसाय की ज़रूरतें अलग होती हैं, और डेटा वर्कफ़्लो का व्यावसायिक लक्ष्यों पर क्या प्रभाव पड़ता है, यह समझना उचित प्रोसेसिंग फ़्रेमवर्क लागू करने के लिए महत्वपूर्ण है।
डेटा की विशेषताएँ
जानें कि अलग-अलग प्रकार के डेटा के लिए कौन-सा तरीका बेहतर है। बैच प्रोसेसिंग पूर्वानुमेय डेटासेट के साथ सबसे अच्छा काम करती है, जबकि स्ट्रीम प्रोसेसिंग अधिक परिवर्तनीय डेटा संरचना को संभालने के लिए डिज़ाइन की गई है।
लेटेंसी की ज़रूरत
व्यावसायिक ज़रूरतों को समझना महत्वपूर्ण है, लेकिन स्वीकार्य डेटा विलंब कितना है, यह समझना निर्णायक है। डेटा को रीयल-टाइम में चाहिए या उसे आवधिक रूप से संभाला जा सकता है—यही बैच बनाम स्ट्रीमिंग का मुख्य निर्धारक होगा।
बजट और संसाधन
बजट और संसाधनों की सीमाएँ आपके चुनाव को सीमित कर सकती हैं। आपका संगठन मौजूदा इन्फ्रास्ट्रक्चर का उपयोग प्राथमिकता दे सकता है, और आपको अपनी पाइपलाइनों को उसी में फिट करना पड़ सकता है।
टेक्नोलॉजी स्टैक
अलग-अलग टेक्नोलॉजी स्टैक की क्षमताएँ भिन्न होती हैं, और टूल्स का चुनाव इस पर महत्वपूर्ण प्रभाव डालता है कि बैच या स्ट्रीमिंग में से कौन-सा तरीका आपकी ज़रूरतों के लिए बेहतर है।
निष्कर्ष
अपनी पसंद को व्यावसायिक आवश्यकताओं, डेटा की विशेषताओं, लेटेंसी की ज़रूरत, बजट, और मौजूदा टेक्नोलॉजी के साथ संरेखित करने से आप अपनी डेटा प्रोसेसिंग ज़रूरतों के लिए सबसे प्रभावी तरीका चुन सकेंगे।
यदि आपको आवधिक विश्लेषण के साथ बड़े वॉल्यूम के ऐतिहासिक डेटा को संभालना है और बजट सीमित है, तो बैच प्रोसेसिंग चुनें। यदि रीयल-टाइम विश्लेषण और तुरंत कार्रवाई महत्वपूर्ण हैं और आपके पास अधिक जटिल, उच्च-प्रदर्शन इन्फ्रास्ट्रक्चर के लिए आवश्यक बजट और संसाधन हैं, तो स्ट्रीमिंग चुनें।
मेरे अनुभव में, स्ट्रीमिंग की आवश्यकता बहुत कम परिदृश्यों में होती है। अधिकांश समय, आप बैच प्रोसेसिंग से काम चला सकते हैं।
यदि आप ETL/ELT, स्ट्रीम प्रोसेसिंग, बैच प्रोसेसिंग, और पाइपलाइन बनाने के बारे में और सीखना चाहते हैं, तो DataCamp के ये संसाधन देखें: