
Last chance! 50% off DataCamp Premium
Sale ends in
在谷歌发布令人印象深刻的 Gemini 3 之后不久,Anthropic 宣布推出 Claude Opus 4.5,并称其为“全球在编程、智能体与电脑操作方面最强的模型”。
尽管 Gemini 3 的基准成绩非常亮眼,但在测试软件工程技能的 SWE 基准上,它仍落后于 Claude Sonnet 4.5。随着 Claude Opus 4.5 的发布,Anthropic 在 SWE 基准和其他测试上又一次刷新了自家成绩。
Claude Opus 4.5 是 Anthropic 在短短两个月内第三次重大发布,继 Sonnet 4.5 和 Haiku 4.5 之后推出。如今 Anthropic 的估值已超过 3500 亿美元,可见其有足够的资源保持这一发布节奏。
本文将全面解析 Claude Opus 4.5 的新变化,涵盖基准测试、新功能,并通过上手测试其能力。
Claude Opus 4.5 是 Anthropic 最新的大语言模型。延续自 Opus 4,它是 Anthropic 最先进的模型,重点面向编程、推理与长时任务。该模型在 SWE-bench 上得分 80.9%,在 Terminal-bench 上得分 59.3%。
Claude Opus 4.5 现已在 Anthropic 的应用、API 与主要云平台上提供。
从官宣中,我注意到以下亮点:
与模型发布同时,Anthropic 还宣布了多项产品更新,下面我将详细介绍。包括 Claude for Chrome 浏览器扩展,可让 Claude 跨标签页执行操作,以及 Claude for Excel。
如果不把新模型拉出来小试几道题,测评就不算完整。让我们看看这些改进在一系列任务上的表现:
首先,我想看看 Opus 4.5 如何处理一个经典的经济学最优化问题。我设想的是一个对数线性需求模型,用价格预测销量。这是计量经济学课程里常见的内容,同时也非常实用。如果您知道自己的 需求曲线和成本,就可以求出使收入最大化的价格。
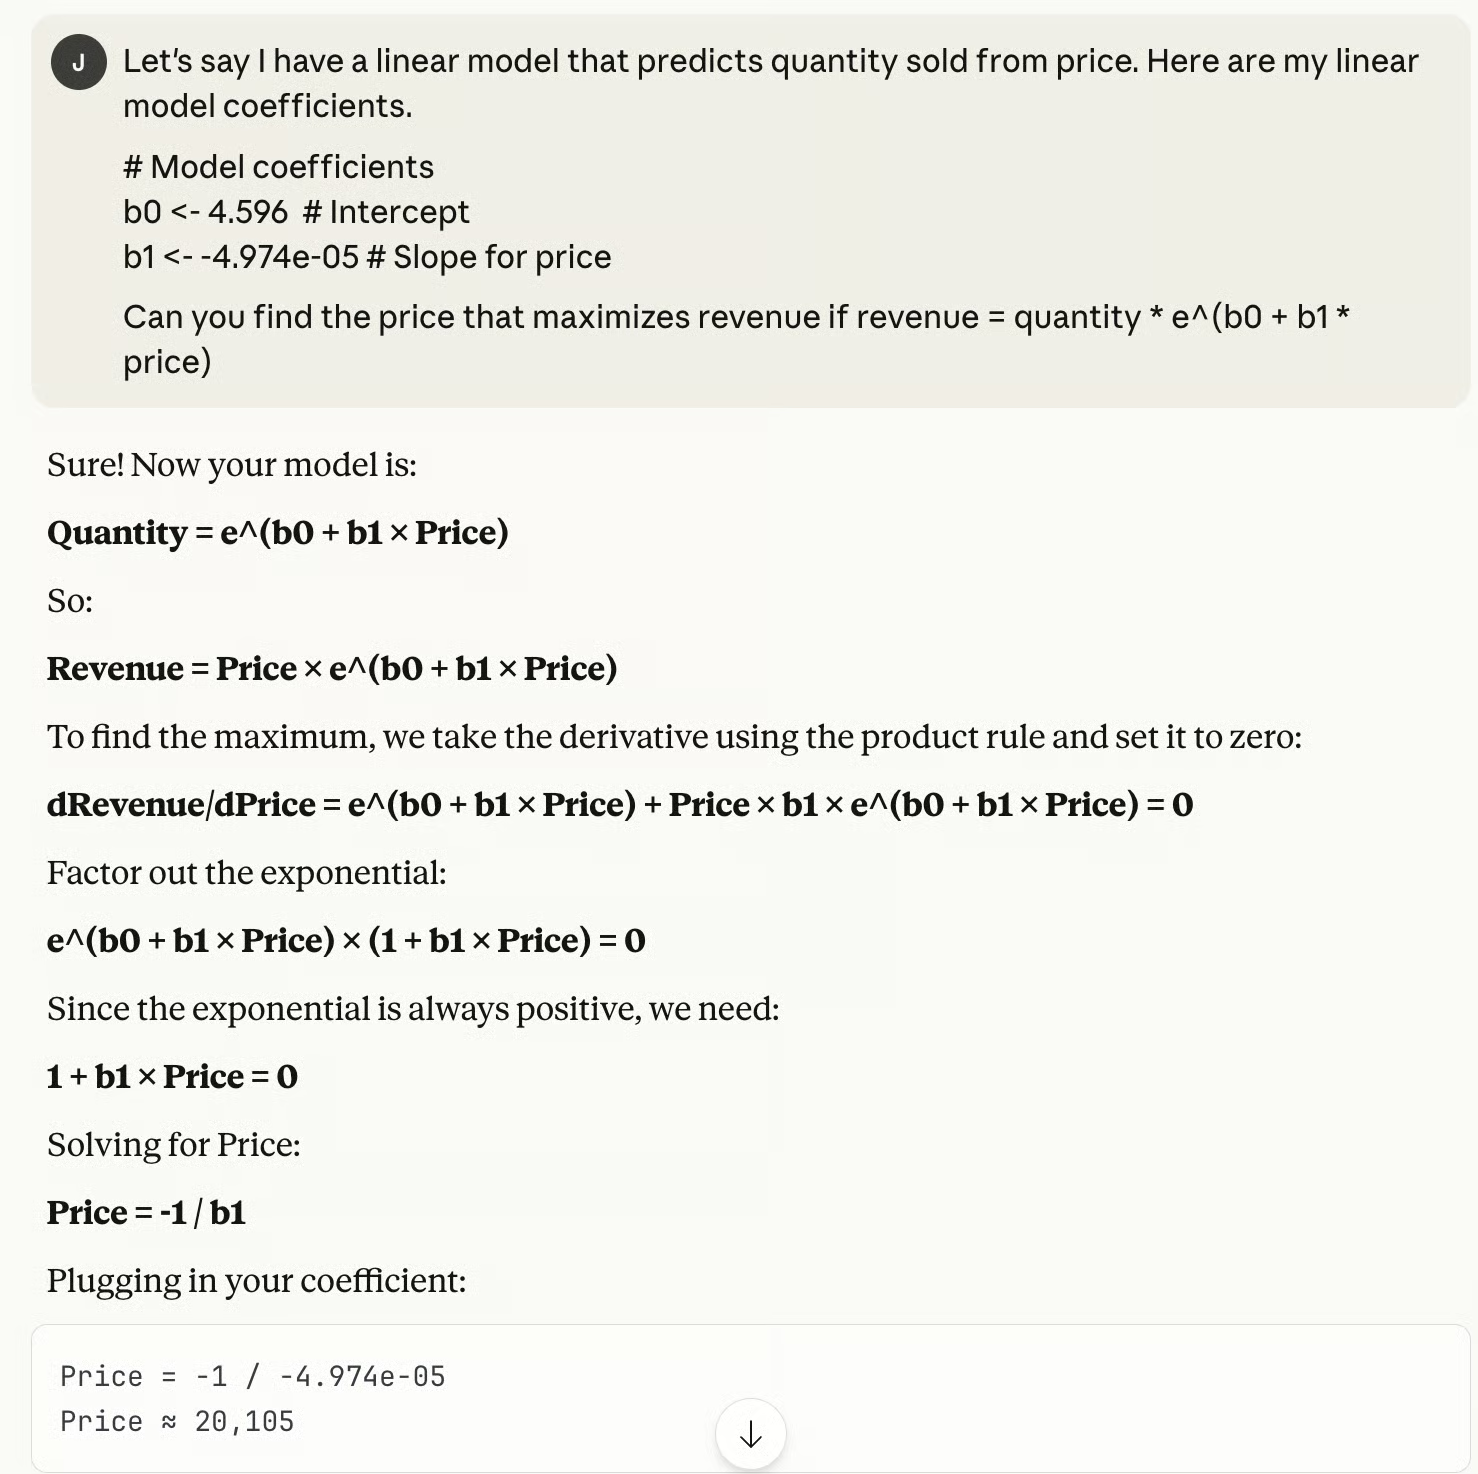
Opus 4.5 很快就给出了正确答案,一次性完成,没有拖泥带水。
这一点让我印象深刻,因为几乎所有卖产品的公司都会对销量和价格有一定把握,但未必都有资源去推导这些基础的最优化问题答案。
不过,只要提示设计得当,您就能轻松得到答案。当然,分析师仍需判断约束条件是否被充分、恰当地建模。
我还喜欢的是:Opus 4.5 会“展示解题过程”。它不只是给出一个数字,而是走了一遍求导、因式分解和代数步骤。如果它出错,我也能看出错在何处。
接着,我想用统计问题测试 Opus 4.5。我创建了一个数据集,其中 yield 是 temperature 的函数,并加入了噪声。
library(tidyverse)

set.seed(1024)

# Generate data
n <- 100
df <- data.frame(
  temperature = seq(0, 100, length.out = n)
) %>%
  mutate(yield = 0.5 * temperature + 10 + rnorm(n, 0, 5))
随后我向 Claude 提交了如下提示。
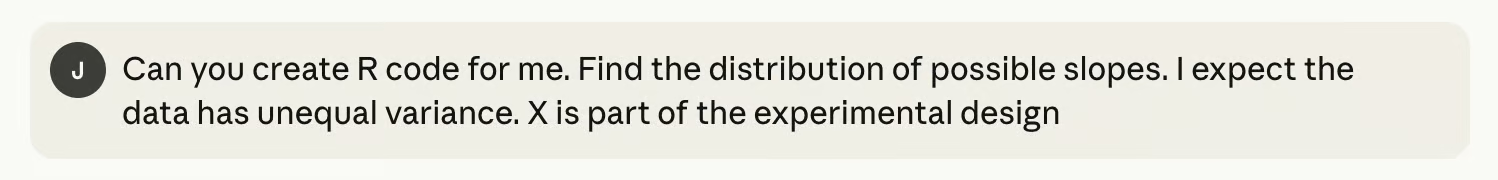
Claude 返回了如下内容,我据此绘制了下方的直方图。
# Fit model
fit <- lm(yield ~ temperature, data = df)
fitted_vals <- fitted(fit)
resids <- residuals(fit)
original_slope <- coef(fit)[2]

# Residual bootstrap
set.seed(123)
n_boot <- 1000
boot_slopes <- numeric(n_boot)

for (i in 1:n_boot) {
  new_y <- fitted_vals + sample(resids, replace = TRUE)
  boot_fit <- lm(new_y ~ df$temperature)
  boot_slopes[i] <- coef(boot_fit)[2]
}

# Confidence intervals
ci_lower <- quantile(boot_slopes, 0.025)
ci_upper <- quantile(boot_slopes, 0.975)

# Plot
ggplot(data.frame(slope = boot_slopes), aes(x = slope)) +
  geom_histogram(bins = 40, fill = "gray70", color = "white") +
  geom_vline(xintercept = original_slope, color = "red", linewidth = 1) +
  geom_vline(xintercept = ci_lower, color = "steelblue", linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = ci_upper, color = "steelblue", linetype = "dashed", linewidth = 1) +
  labs(
    title = "Bootstrap Estimate: Effect of Temperature on Yield",
    subtitle = paste0("Estimate: ", round(original_slope, 3),
                      " | 95% CI: [", round(ci_lower, 3), ", ", round(ci_upper, 3), "]"),
    x = "Slope (yield per °C)",
    y = "Count"
  ) +
  theme_minimal()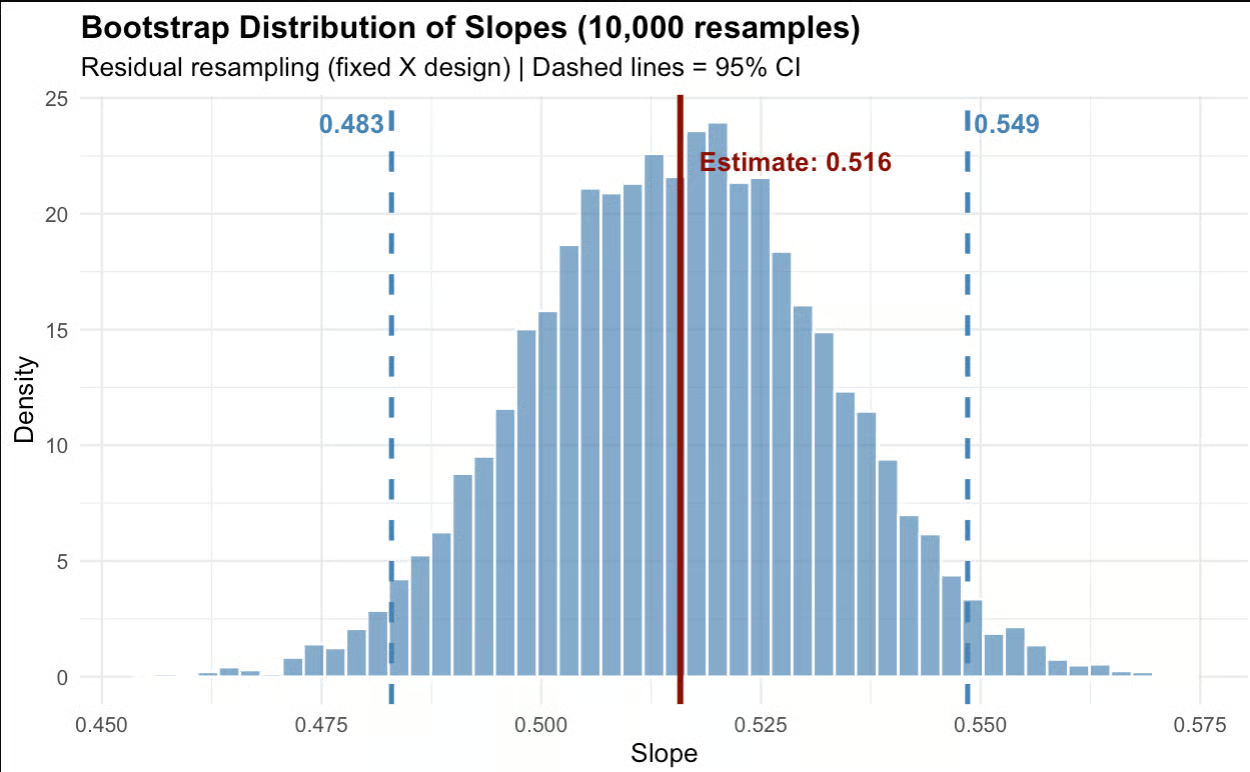
我对这个结果很满意。Opus 4.5 求出了斜率的置信区间,这正是我真正想要的。
它采用了 自助法(bootstrap),这是一种在存在 异方差 时求置信区间的好方法。它更具体地使用了“残差自助法”,而不是对 (X,Y) 对进行重抽样的另一种自助法,后者会假设 X 项存在误差。
对于从事这类工作的读者来说,这是一个细微但重要的点:当 X 由实验设计固定(正如我在提示中说明的),并且您希望基于这些确切的 X 值进行条件推断(如科学研究中常见),残差自助法更合适。总之,Opus 4.5 听懂了提示中的细节。
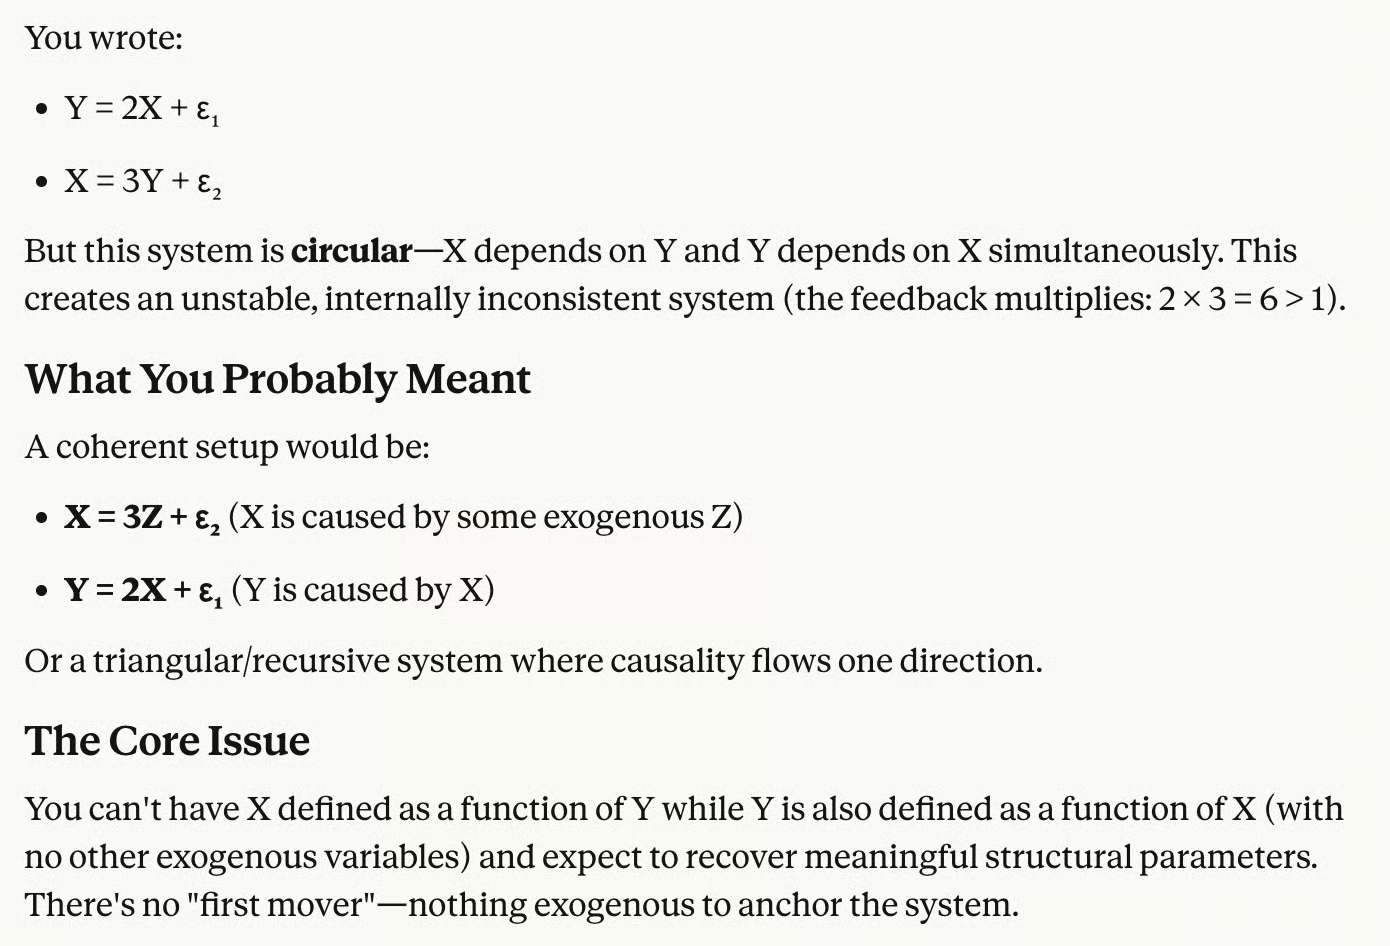
接着,我想看看能否在某种程度上难倒 Opus 4.5。
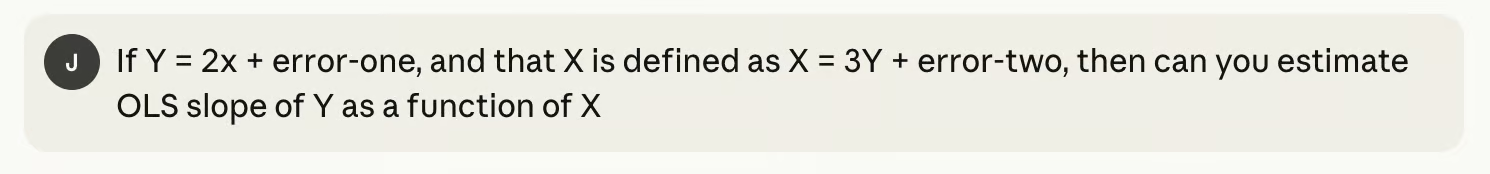
在这个案例中,模型比我领先一步。Opus 4.5 识别到我的问题是循环定义——我用 Y 定义 X,又用 X 定义 Y,因此在给定条件下无法对回归线的斜率给出有意义的估计。
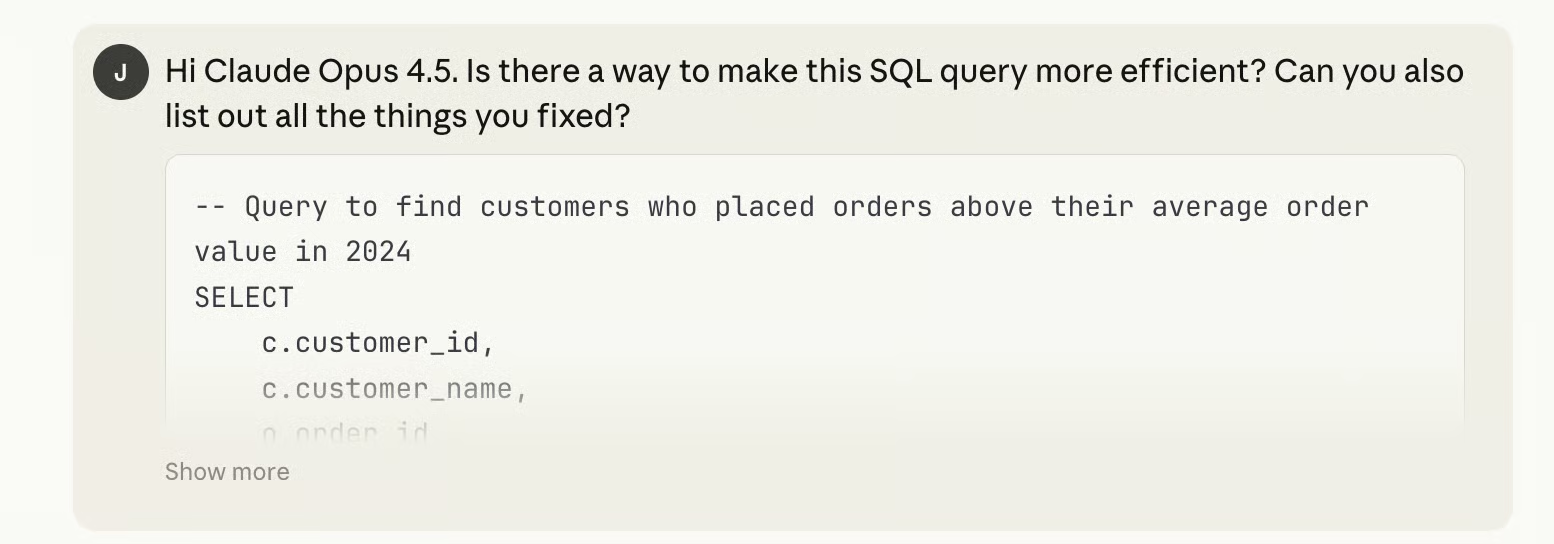
最后,我觉得用一道 SQL 题来测试 Opus 4.5 也会很有趣。我给它发去了一条可用但极不高效的 SQL 查询。
-- Find customers who placed orders above their average order value in 2024
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > (
        SELECT AVG(o2.order_total)
        FROM orders o2
        WHERE o2.customer_id = c.customer_id
    )
    AND c.customer_id IN (
        SELECT DISTINCT o3.customer_id
        FROM orders o3
        WHERE o3.order_date >= '2024-01-01'
    )
    AND EXISTS (
        SELECT 1
        FROM customer_preferences cp
        WHERE cp.customer_id = c.customer_id
            AND cp.email_opt_in = 1
    )
ORDER BY (
    SELECT COUNT(*)
    FROM orders o4
    WHERE o4.customer_id = c.customer_id
) DESC;
我让 Opus 4.5 优化这条查询。它大约一秒就给出了答案。
-- Find customers who placed orders above their average order value in 2024
WITH customer_avg AS (
    SELECT
        customer_id,
        AVG(order_total) AS avg_order_total,
        COUNT(*) AS order_count
    FROM orders
    GROUP BY customer_id
)
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
JOIN customer_avg ca ON c.customer_id = ca.customer_id
JOIN customer_preferences cp ON c.customer_id = cp.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > ca.avg_order_total
    AND cp.email_opt_in = 1
ORDER BY ca.order_count DESC;
除其他之外,Opus 4.5 用 CTE 替换了用于 AVG 的相关子查询。(原查询会在评估的每一行上重复计算 AVG(order_total),而 CTE 现在会为每位客户预先计算一次平均值。)Opus 4.5 还移除了多余的 IN (SELECT DISTINCT ...) 子句,它只是在做无用功。同时它把 EXISTS 子查询改成了 JOIN,这样更好。
这次发布还有其他亮点。我们详细看看:
Anthropic 为开发者新增了多种构建模块。其中最引人注目的是 effort 参数,它可控制模型在回复前投入多少“思考”。轻量任务设低值;需要模型深入推理时设高值。
据 Anthropic 称,在中等 effort 下,Opus 4.5 以 76% 更少的输出 token 达到 Sonnet 4.5 在 SWE-bench 上的最佳成绩;在高 effort 下,它领先 Sonnet 超过 4%,同时输出 token 仍接近减半。
还有改进的上下文管理与记忆能力。对于长时运行的智能体,Claude 现在可以自动总结较早的上下文,避免在任务中途“撞墙”。这与上下文压缩配套使用,使智能体在更少干预下运行更久。
最后,Opus 4.5 在多智能体编排方面表现也相当不错,意味着它可以管理一个子智能体团队。
在一项深度研究评测中,Opus 4.5 的表现据称提升了约 15%。
我也对其深度研究能力做了自测。我让它撰写一份关于仍流传至今但不常用的古英语词汇,以及此类词语随时间如何变化的报告。报告在七分钟内完成:
老实说,我对这份报告的质量相当满意:内容有趣、文字流畅、结构清晰、研究扎实。
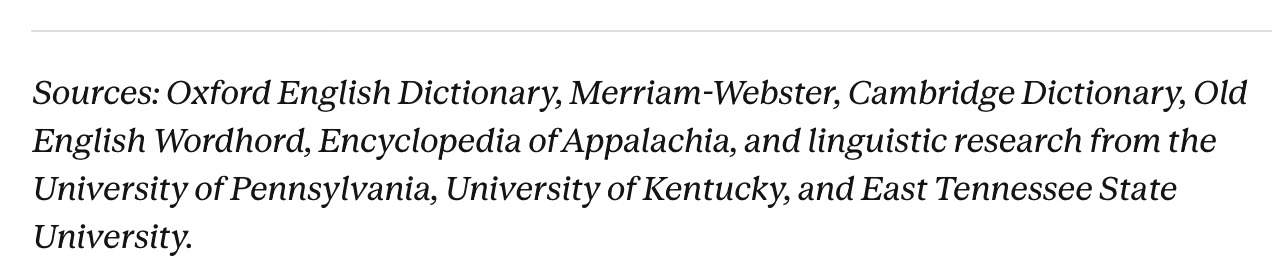
它并非枯燥乏味、充斥古词僻字的文档。固然,有些段落的区分度还可以更好,报告中段略显平淡。但——这才是关键——其研究非常扎实。看看这些引文就知道了:
此外,我还学到了一个很美的词:apricity,意为冬日阳光的温暖。
Anthropic 对 Claude Code 推送了两个升级。
所谓“计划模式”(Plan Mode)现在会在执行前构建更精确的计划。实际体验中,这意味着 Claude 会先提出澄清性问题,然后生成一个可编辑的 plan.md 文件,您可以在它开始工作前审阅并调整。其思路是避免“错误起步”。
另一项重要升级是桌面应用集成。Claude Code 现已在桌面应用中可用,这意味着您可以并行运行多个本地与远程会话。以 Anthropic 自己的示例来说:一个智能体修复漏洞,另一个检索 GitHub 问题,第三个更新文档。
Claude 消费者应用中也上线了一些智能体功能:
Claude for Chrome 让 Claude 能够跨浏览器标签执行任务。现已向所有 Max 用户开放。可将其视为一个浏览智能体,能够在多个网站间导航、点击、填写表单并抓取信息。
Claude for Excel 将电子表格自动化带到 Claude。这一功能先前已宣布,如今 Anthropic 将测试版访问扩展至所有 Max、Team 与 Enterprise 用户,离全面可用更近一步。
长对话处理解决了一个令人烦恼的限制。此前,长对话会触发上下文上限而被迫中断,您不得不重新开一个会话。现在 Claude 会在后台自动总结对话的早期部分,为后续交流腾出空间,避免“撞墙”。
与此前的 Claude 模型一样,Opus 4.5 在智能体式编程、工具使用、电脑操作与问题求解等通用基准上进行了测试。以下是 Opus 4.5 的主要结果。
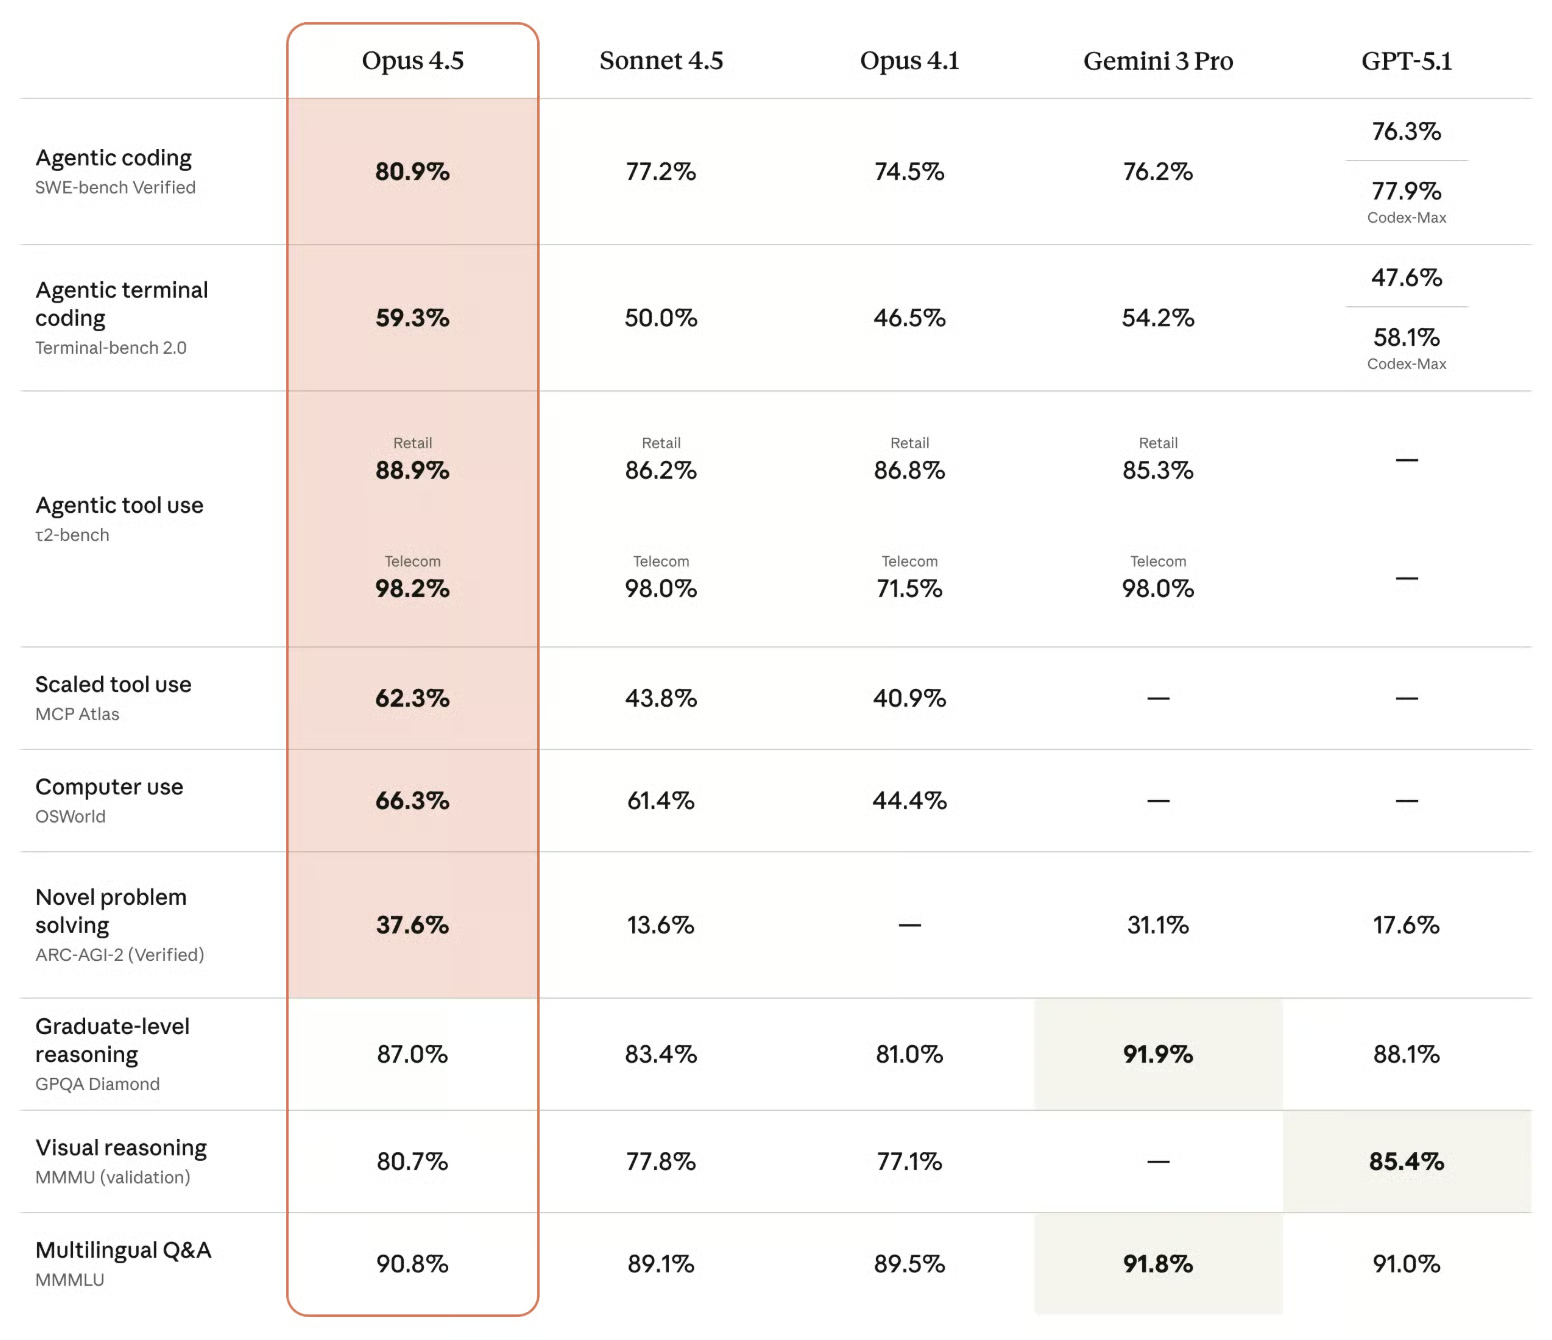
Opus 4.5 在许多关键测试中名列前茅。凡是涉及“动手做事”的项目,例如编写能通过测试的代码(SWE-bench)、在多步工作流中使用工具(τ2-bench、MCP Atlas),以及操作电脑(OSWorld),Opus 4.5 都遥遥领先,且往往优势明显。
在规模化工具使用上的差距尤其巨大:62.3% 对 43.8%(后者也是 Claude 的模型)。这显示了 Anthropic 在提升智能体任务表现方面投入之大。尽管他们的旧模型在某些类别上目前仍领先,但他们并未放慢前进步伐。
看起来,Gemini 3 Pro 在一些知识密集型基准上占优,例如研究生水平推理(GPQA Diamond)与多语种问答(MMMLU)。这些测试可能更看重训练数据的广度与对非记忆性事实的严谨推理,而谷歌在这方面当然拥有雄厚资源。
Anthropic 的改进不仅体现在编程、研究与电脑操作方面,也非常强调安全性,并称这是他们迄今“最安全、对齐度最高”的模型。
这一说法得到所谓“令人担忧行为分数”下降的支持,该分数低于其他 4.5 系列模型,以及 GPT-5.1 与 Gemini 3 Pro。Anthropic 还让 Opus 4.5 对提示注入攻击更加稳健,而提示注入可能诱使模型产生有害行为。
Claude Opus 4.5 现已在 Anthropic 的完整产品阵列中提供,包括 Claude 应用、API 以及三大云平台。开发者可通过模型 ID claude-opus-4-5-20251101 直接访问。
价格也有明显下调。以 每百万输入 token 5 美元、每百万输出 token 25 美元 计价,Opus 4.5 让 Anthropic 的顶级能力更易获得。
对于企业用户而言,这一价格变化尤为重要。成本下降、API 访问扩大以及在各大云厂商上的更广泛可用,使 Opus 4.5 成为更具竞争力的选择。
Claude Opus 4.5 充分表明了 Anthropic 在 AI 竞赛中的自我定位。谷歌着力于多模态理解与端侧模型,Anthropic 则重注于“行动”:智能体式编程、工具使用与电脑交互。
基准结果已经说明了一切:Opus 4.5 在软件工程基准上取得了有史以来最高分,且无需太多引导就能处理多系统调试。
我的测试也印证了这些结论:Opus 4.5 非常擅长多步任务。不论是运行自助法模拟,还是跨论文整合研究成果,该模型都像“思考者”一样处理问题:自适应,且推理清晰。如果您希望增强工作流程,这才是关键。
如果您想进一步了解 Claude 模型,建议看看这门课程:Introduction to Claude Models。
与 DataCamp 一起学习
课程
课程
课程

