
Last chance! 50% off DataCamp Premium
Sale ends in
Sull’onda del notevole rilascio di Gemini 3 di Google, Anthropic ha annunciato Claude Opus 4.5, definendolo il “miglior modello al mondo per coding, agent e uso del computer”.
Nonostante i benchmark estremamente impressionanti di Gemini 3, è comunque arrivato dietro a Claude Sonnet 4.5 sulla SWE-bench, un test sulle competenze di ingegneria del software. Con Claude Opus 4.5, Anthropic supera il proprio punteggio sulla SWE-bench e in altri test.
Claude Opus 4.5 rappresenta il terzo grande lancio di un modello da parte di Anthropic in appena due mesi, dopo Sonnet 4.5 e Haiku 4.5. E ora che Anthropic ha una valutazione superiore a 350 miliardi di dollari, sappiamo che ha le risorse per mantenere questo ritmo.
In questo articolo esplorerò tutte le novità di Claude Opus 4.5, esaminando benchmark, nuove funzionalità e mettendo le mani in pasta per testarne le capacità.
Claude Opus 4.5 è l’ultimo large language model di Anthropic. Seguendo Opus 4, è il modello più avanzato di Anthropic, con un focus su coding, ragionamento e task di lunga durata. Il modello ottiene l’80,9% su SWE-bench e il 59,3% su Terminal-bench.
Claude Opus 4.5 è ora disponibile sulle app di Anthropic, sull’API e sulle principali piattaforme cloud.
Dall’annuncio, queste cose mi hanno colpito:
Insieme al lancio del modello, Anthropic ha annunciato diversi aggiornamenti di prodotto, di cui parlerò più in dettaglio sotto. Tra questi Claude per Chrome, l’estensione del browser che consente a Claude di agire tra le schede, e Claude per Excel.
Un articolo non sarebbe completo senza mettere alla prova il nuovo modello con uno o due test. Vediamo come le nuove migliorie gestiscono una serie di task:
Per prima cosa, volevo vedere come Opus 4.5 affrontasse un classico problema di ottimizzazione economica. Sto immaginando un modello di domanda log-lineare che predice la quantità venduta a partire dal prezzo. È il tipo di cosa che si vede in un corso di econometria, ma è anche davvero utile. Se conosci la tua curva di domanda e i tuoi costi, puoi risolvere per il prezzo che massimizza i ricavi.
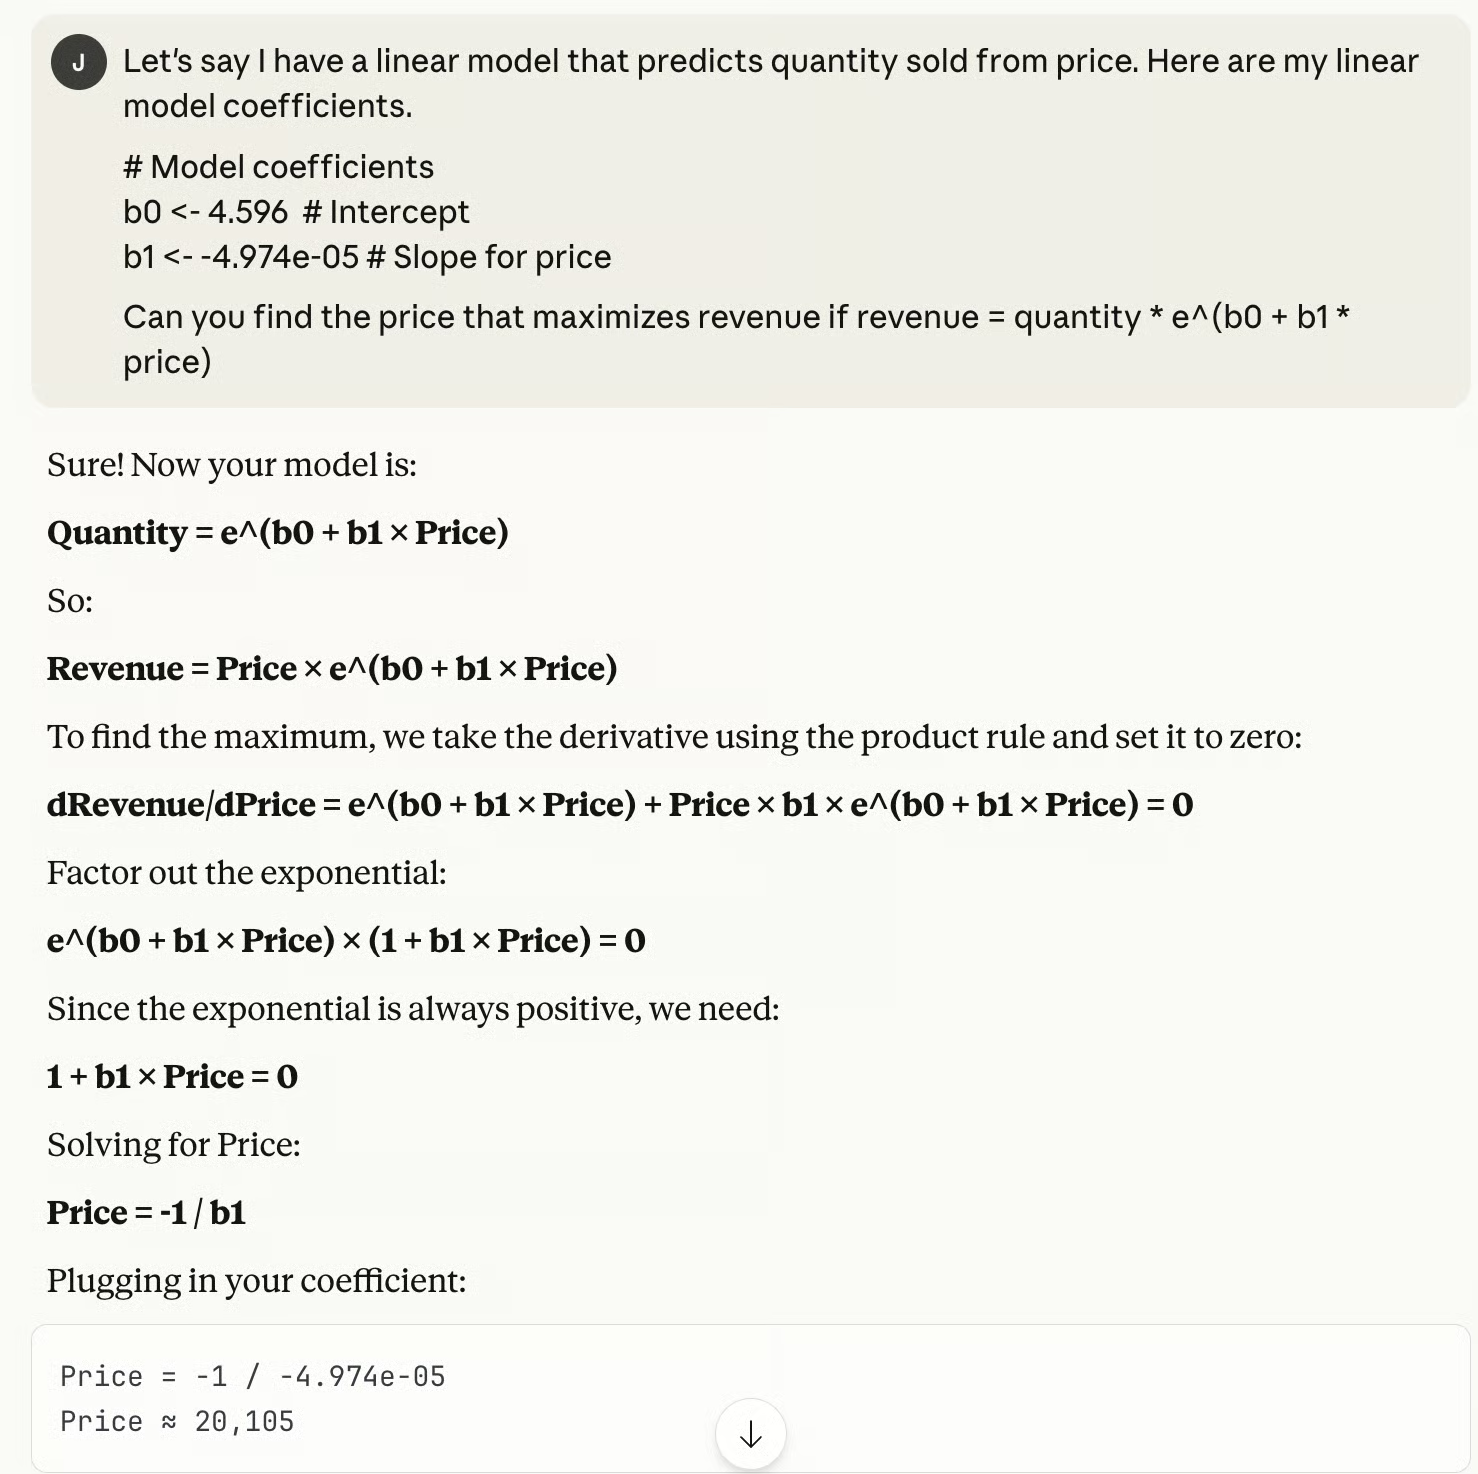
Opus 4.5 mi ha dato la risposta giusta, senza pensarci troppo, e tutto in un’unica volta.
Questo mi ha colpito perché praticamente qualsiasi azienda che vende qualcosa avrà un’idea della quantità venduta e del prezzo, ma non tutte avranno le risorse per abbozzare risposte a problemi di ottimizzazione di base.
Qui, però, con un prompt ben progettato, puoi trovare facilmente la risposta. Ovviamente spetterebbe comunque all’analista decidere se abbastanza vincoli siano stati davvero modellati correttamente.
Un’altra cosa che ho apprezzato: Opus 4.5 ha mostrato il procedimento. Non mi ha dato solo un numero. Ha illustrato derivata, fattorizzazione e passaggi algebrici. Se avesse commesso un errore, avrei potuto individuare dove.
Poi ho voluto testare Opus 4.5 con una domanda di statistica. Ho creato un dataset in cui yield era funzione di temperature con rumore aggiunto.
library(tidyverse)

set.seed(1024)

# Generate data
n <- 100
df <- data.frame(
  temperature = seq(0, 100, length.out = n)
) %>%
  mutate(yield = 0.5 * temperature + 10 + rnorm(n, 0, 5))
Poi ho passato a Claude questo prompt.
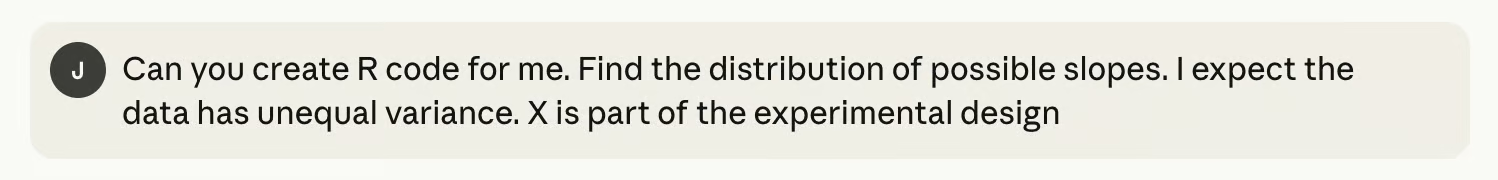
Claude mi ha restituito quanto segue, che ho usato per creare un istogramma, qui sotto.
# Fit model
fit <- lm(yield ~ temperature, data = df)
fitted_vals <- fitted(fit)
resids <- residuals(fit)
original_slope <- coef(fit)[2]

# Residual bootstrap
set.seed(123)
n_boot <- 1000
boot_slopes <- numeric(n_boot)

for (i in 1:n_boot) {
  new_y <- fitted_vals + sample(resids, replace = TRUE)
  boot_fit <- lm(new_y ~ df$temperature)
  boot_slopes[i] <- coef(boot_fit)[2]
}

# Confidence intervals
ci_lower <- quantile(boot_slopes, 0.025)
ci_upper <- quantile(boot_slopes, 0.975)

# Plot
ggplot(data.frame(slope = boot_slopes), aes(x = slope)) +
  geom_histogram(bins = 40, fill = "gray70", color = "white") +
  geom_vline(xintercept = original_slope, color = "red", linewidth = 1) +
  geom_vline(xintercept = ci_lower, color = "steelblue", linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = ci_upper, color = "steelblue", linetype = "dashed", linewidth = 1) +
  labs(
    title = "Bootstrap Estimate: Effect of Temperature on Yield",
    subtitle = paste0("Estimate: ", round(original_slope, 3),
                      " | 95% CI: [", round(ci_lower, 3), ", ", round(ci_upper, 3), "]"),
    x = "Slope (yield per °C)",
    y = "Count"
  ) +
  theme_minimal()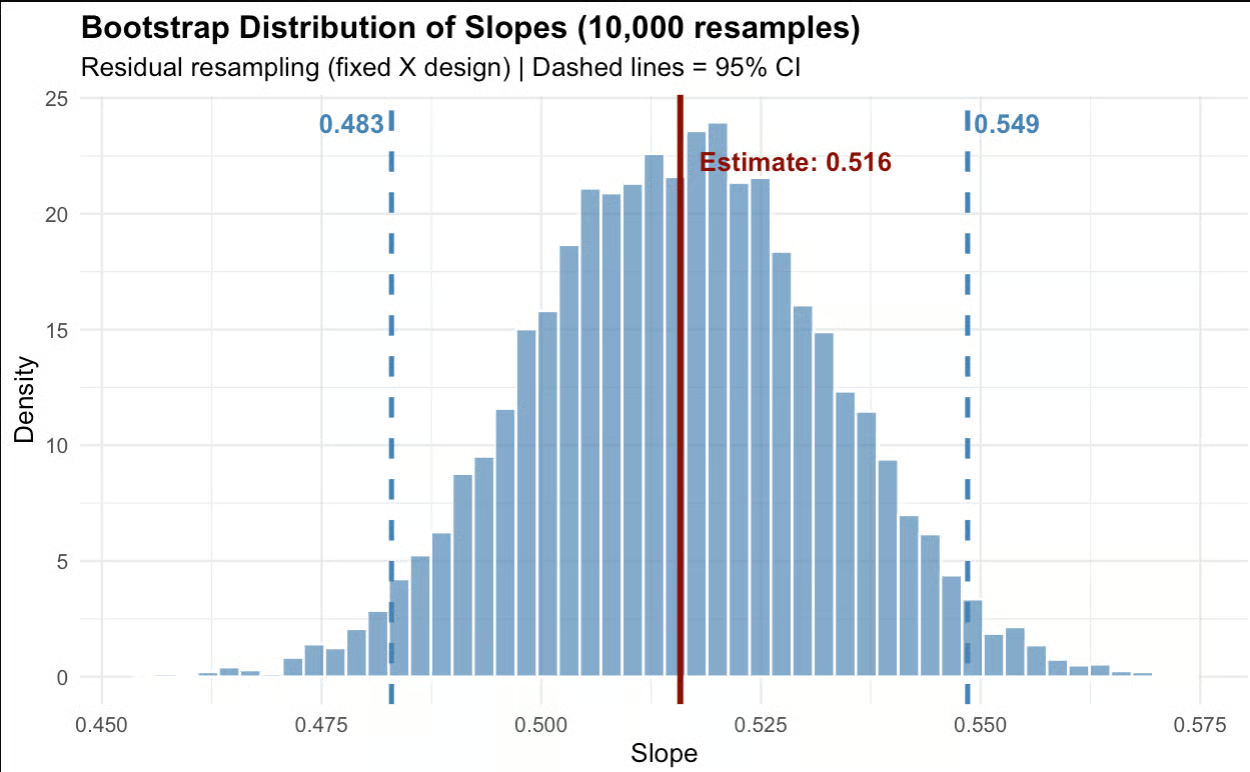
Devo dire che mi piace questo risultato. Opus 4.5 ha trovato un intervallo di confidenza per la pendenza, che era ciò che chiedevo davvero.
Ha usato un metodo bootstrap, che è una buona tecnica per trovare intervalli di confidenza quando è presente eteroschedasticità. Più nello specifico, ha usato un bootstrap sui residui, invece di un altro metodo che ricampiona le coppie (X,Y), il quale avrebbe presupposto errore nel termine X.
Tutto questo è un punto sottile ma probabilmente importante per chi fa questo tipo di lavoro: un bootstrap sui residui è preferibile quando X è fissata per disegno, come ho specificato nel mio prompt, e quando quindi vuoi un’inferenza condizionata su quei valori esatti di X, come in uno studio scientifico. Quello che voglio dire è che Opus 4.5 ha colto le sfumature del prompt.
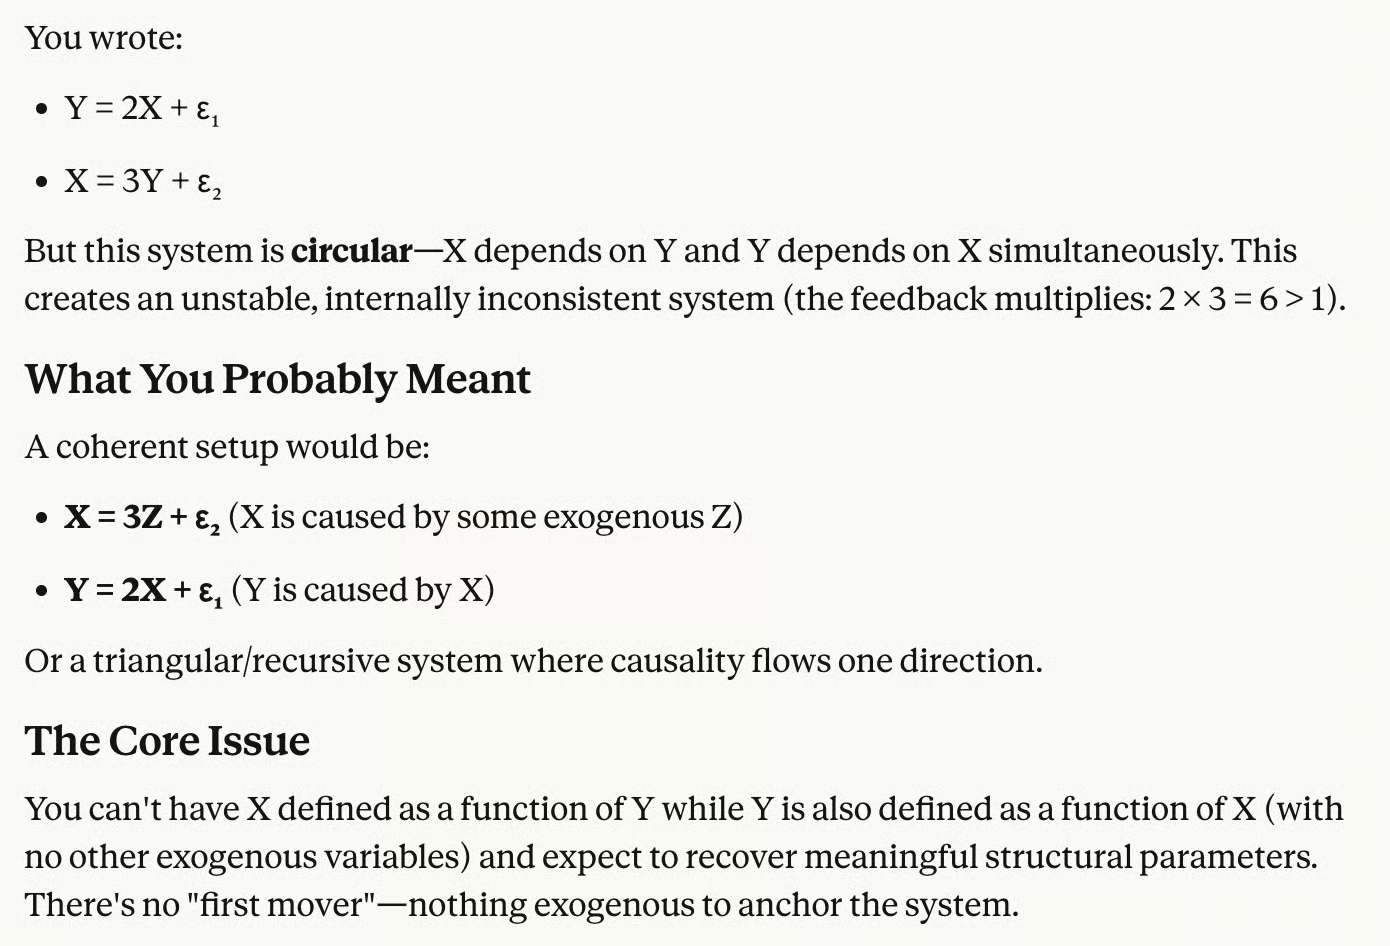
Successivamente, volevo vedere se riuscivo in qualche modo a mettere in difficoltà Opus 4.5.
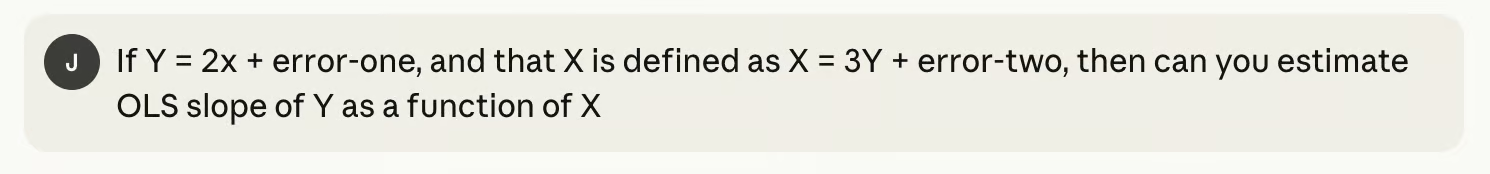
In questo caso, il modello era molto avanti a me. Opus 4.5 ha capito che la mia domanda era circolare: stavo definendo X tramite Y e viceversa, quindi non potevamo ricavare una stima significativa per la pendenza di una retta di regressione, dati gli elementi a disposizione.
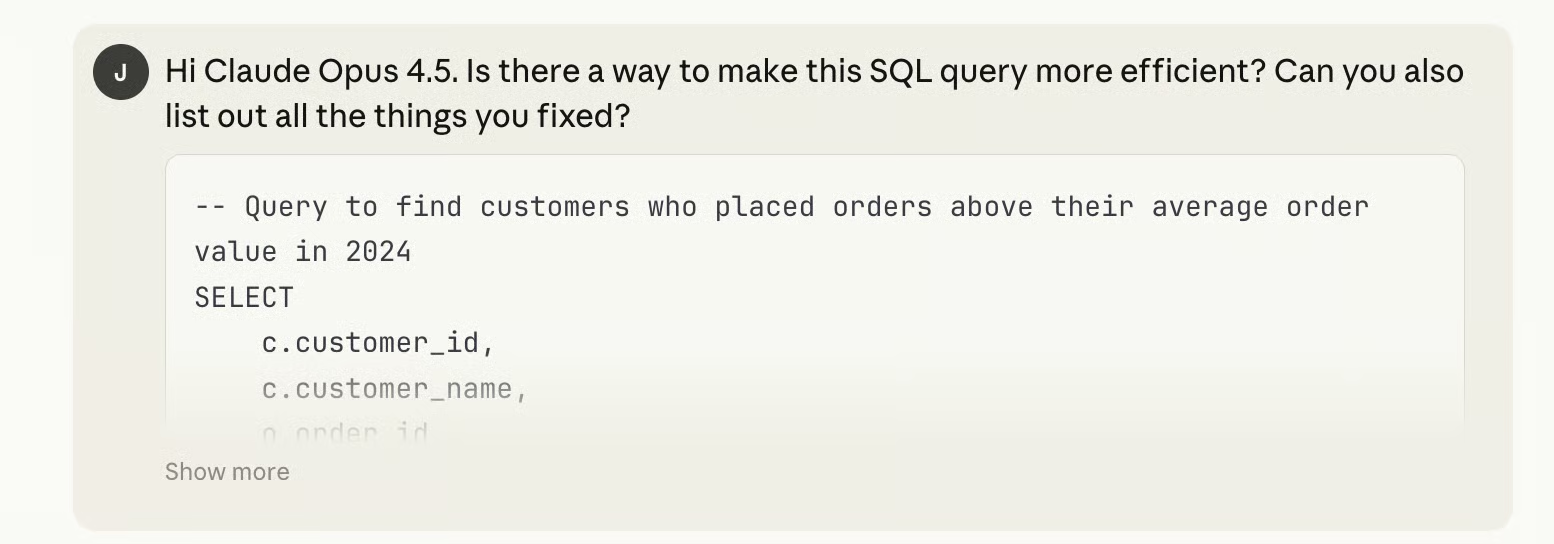
Infine, ho pensato fosse divertente testare Opus 4.5 con una domanda SQL. Gli ho inviato una query SQL funzionante ma molto inefficiente.
-- Find customers who placed orders above their average order value in 2024
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > (
        SELECT AVG(o2.order_total)
        FROM orders o2
        WHERE o2.customer_id = c.customer_id
    )
    AND c.customer_id IN (
        SELECT DISTINCT o3.customer_id
        FROM orders o3
        WHERE o3.order_date >= '2024-01-01'
    )
    AND EXISTS (
        SELECT 1
        FROM customer_preferences cp
        WHERE cp.customer_id = c.customer_id
            AND cp.email_opt_in = 1
    )
ORDER BY (
    SELECT COUNT(*)
    FROM orders o4
    WHERE o4.customer_id = c.customer_id
) DESC;
Ho chiesto a Opus 4.5 di migliorare la query. Mi ha dato una risposta in circa un secondo.
-- Find customers who placed orders above their average order value in 2024
WITH customer_avg AS (
    SELECT
        customer_id,
        AVG(order_total) AS avg_order_total,
        COUNT(*) AS order_count
    FROM orders
    GROUP BY customer_id
)
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
JOIN customer_avg ca ON c.customer_id = ca.customer_id
JOIN customer_preferences cp ON c.customer_id = cp.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > ca.avg_order_total
    AND cp.email_opt_in = 1
ORDER BY ca.order_count DESC;
Tra le altre cose, Opus 4.5 ha sostituito la sottoquery correlata per AVG con una CTE. (La query originale ricalcolava AVG(order_total) per ogni singola riga valutata, mentre ora la CTE calcola la media di ciascun cliente una sola volta all’inizio.) Opus 4.5 ha anche rimosso la clausola ridondante IN (SELECT DISTINCT ...), che faceva lavoro extra per nulla. E ha convertito la sottoquery EXISTS in un JOIN, che è meglio.
Ci sono stati altri punti salienti in questo ultimo rilascio di Anthropic. Diamo uno sguardo più da vicino:
Anthropic ha aggiunto diversi nuovi mattoni per gli sviluppatori. Il più notevole è il parametro effort, che ti consente di controllare quanto “pensiero” il modello fa prima di rispondere. Impostalo basso per task rapidi e leggeri; più alto quando vuoi che il modello mastichi un problema.
Secondo Anthropic, con effort medio, Opus 4.5 eguaglia il miglior punteggio SWE-bench di Sonnet 4.5 usando il 76% di token di output in meno. Con effort alto, supera Sonnet di oltre il 4% — usando comunque quasi la metà dei token.
C’è anche una gestione del contesto e una memoria migliorate. Per agent di lunga durata, Claude può ora riassumere automaticamente il contesto precedente così da non bloccarsi a metà del task. Questo si abbina alla compattazione del contesto, che mantiene gli agent operativi più a lungo con meno interventi.
Infine, a quanto pare Opus 4.5 è piuttosto bravo nell’orchestrazione multi-agent, il che significa che potrebbe gestire un team di sotto-agent.
A quanto pare, le prestazioni di Opus 4.5 in una valutazione di deep research sono aumentate di circa il 15%.
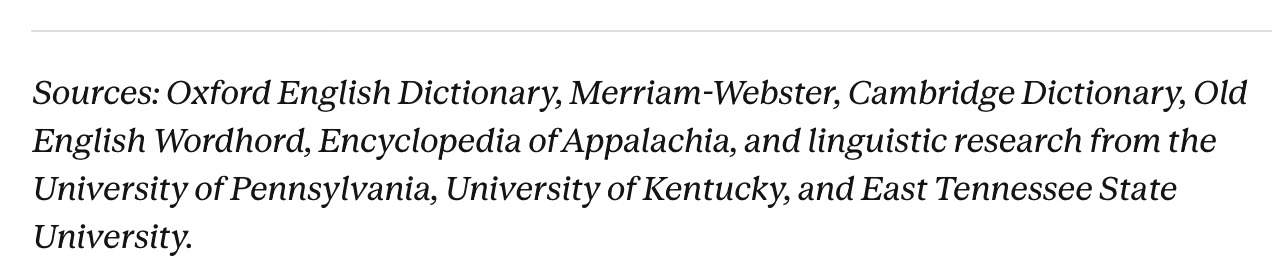
Ho messo alla prova la capacità di deep research. Gli ho chiesto di prepararmi un report sulle parole dell’inglese antico sopravvissute oggi ma non comunemente usate, e su come questo tipo di parole sia cambiato nel tempo. Il report era pronto in sette minuti:
Sono rimasto piuttosto colpito dalla qualità del report in termini di interesse, qualità della scrittura, organizzazione e profondità della ricerca.
Non era un documento totalmente asciutto, eccessivamente denso di parole arcaiche o obsolete. Ammetto che alcune sezioni potevano essere differenziate meglio. La parte centrale del report era un po’ più noiosa del resto. Ma — ed è questo il punto — era estremamente ben documentato. Basta guardare queste citazioni:
In più, ho imparato una parola molto bella: apricity, che significa il calore del sole in inverno.
Anthropic ha rilasciato due aggiornamenti per Claude Code.
Quello che ora si chiama Plan Mode costruisce piani più precisi prima di eseguire. In pratica, significa che Claude fa domande di chiarimento all’inizio, poi genera un file modificabile plan.md che puoi rivedere e ritoccare prima che inizi a lavorare. L’idea è evitarti una falsa partenza.
L’integrazione con l’app desktop è l’altra grande novità. Claude Code è ora disponibile nell’app desktop, il che significa che puoi eseguire più sessioni locali e remote in parallelo. Per usare l’esempio di Anthropic: un agent corregge bug, un altro ricerca issue su GitHub e un terzo aggiorna la documentazione.
Alcune funzionalità agentiche sono arrivate nelle app consumer di Claude:
Claude per Chrome consente a Claude di gestire task tra le schede del browser. È ora disponibile per tutti gli utenti Max. Pensalo come un agent di navigazione che può muoversi, cliccare, compilare moduli e raccogliere informazioni su più siti.
Claude per Excel porta l’automazione dei fogli di calcolo in Claude. Questo era stato annunciato in precedenza, ma Anthropic ha ora esteso l’accesso beta a tutti gli utenti Max, Team ed Enterprise, quindi sta diventando più concreto.
La gestione delle conversazioni lunghe risolve quella che era una limitazione fastidiosa. In passato, le chat lunghe raggiungevano un limite di contesto e si interrompevano, costringendoti ad avviare una nuova conversazione. Ora Claude riassume automaticamente in background le parti precedenti della conversazione, liberando spazio così da non incorrere nel blocco.
Opus 4.5, come i precedenti modelli Claude, è stato testato su benchmark comuni per agentic coding, uso di strumenti, uso del computer e problem solving. Ecco i risultati principali per Opus 4.5.
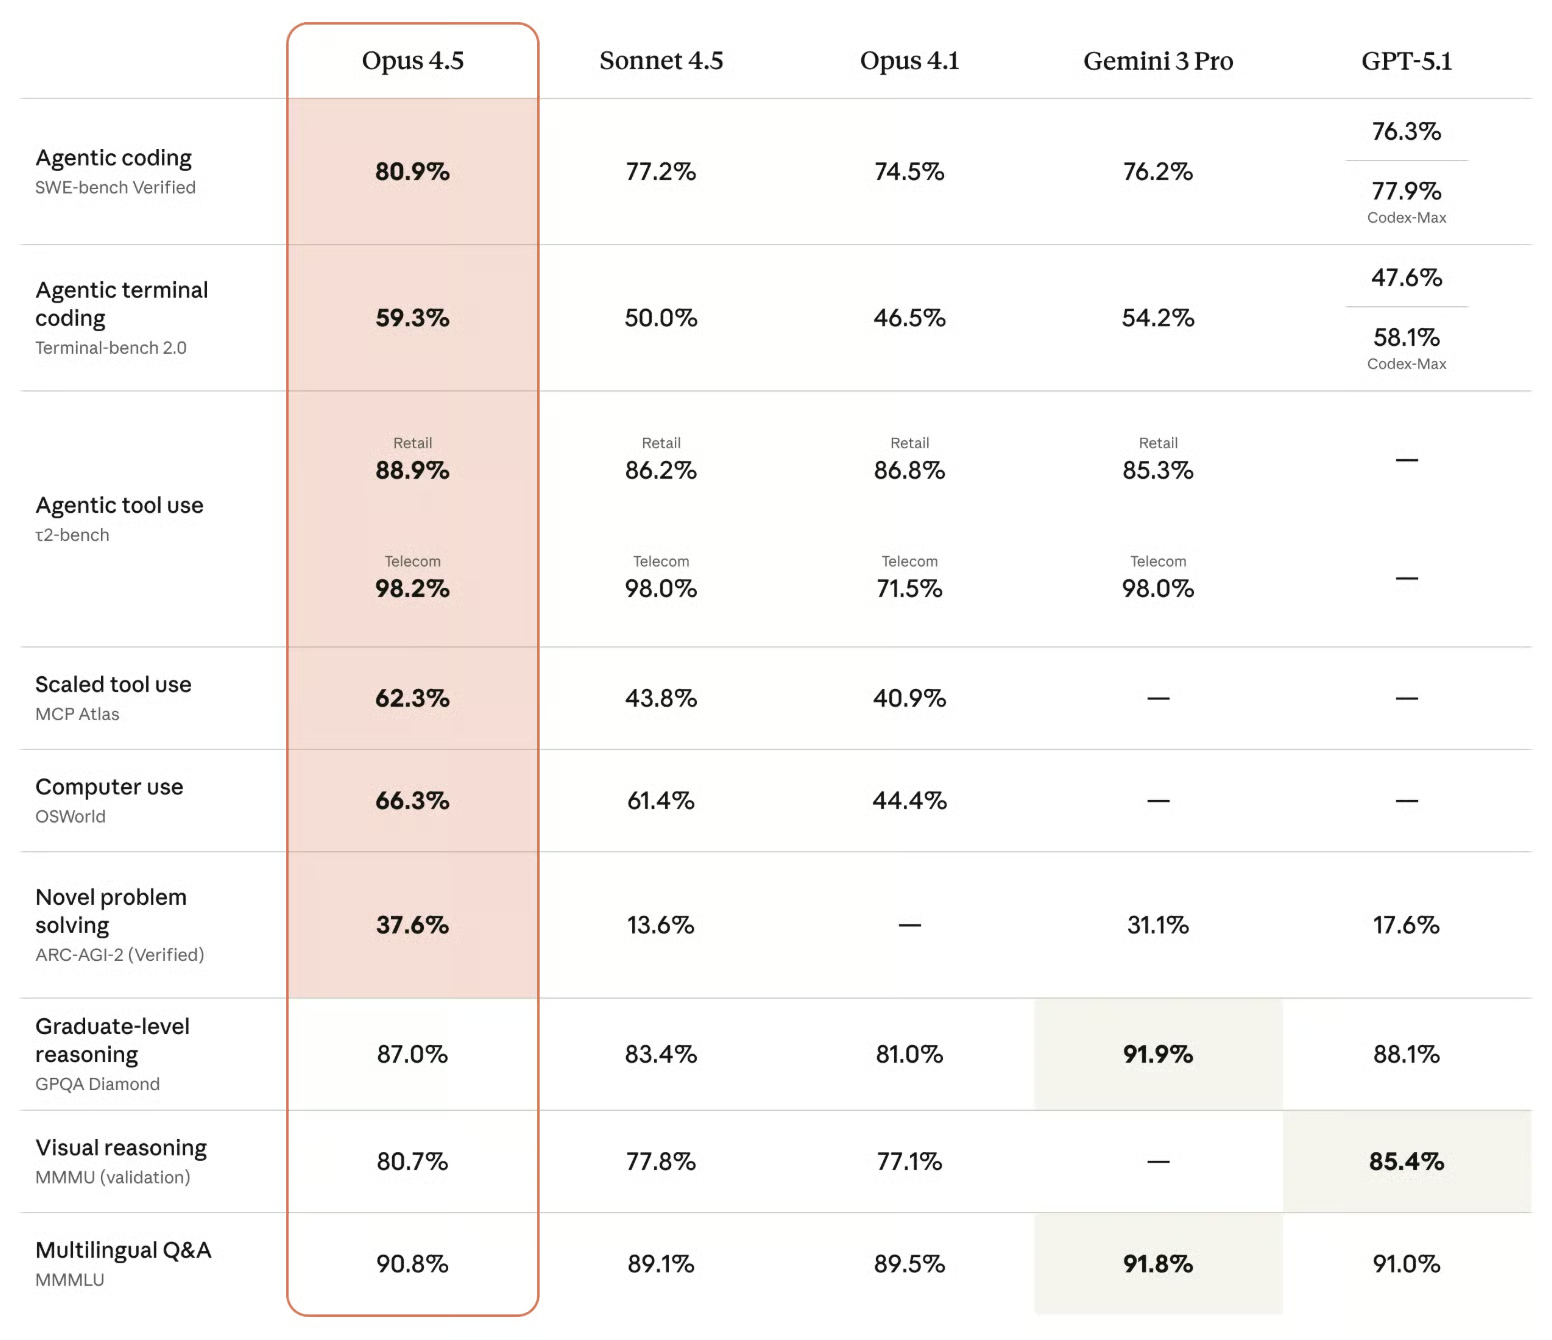
Opus 4.5 ottiene il primo posto in molti dei test più importanti. Tutto ciò che implica fare davvero le cose, come scrivere codice che supera i test (SWE-bench), usare strumenti in workflow multi-step (τ2-bench, MCP Atlas) e operare un computer (OSWorld). Opus 4.5 è in testa, spesso di molto.
Il divario nello scaled tool use è davvero ampio: 62,3% contro il 43,8% del secondo migliore, che è comunque Claude! Tuttavia, questo dimostra quanto Anthropic stia investendo per migliorare le prestazioni, in particolare nei task agentici. Anche se il loro modello più vecchio potrebbe attualmente guidare in alcune categorie, non rallentano i progressi.
Sembra che Gemini 3 Pro abbia il vantaggio su alcuni benchmark ad alta intensità di conoscenza, come il ragionamento a livello graduate (GPQA Diamond) e il Q&A multilingue (MMMLU). Questi benchmark probabilmente premiano l’ampiezza dei dati di training e un ragionamento accurato rispetto ai fatti memorizzati e Google, ovviamente, ha molte risorse.
I miglioramenti di Anthropic non riguardano solo coding, ricerca e uso del computer. C’è una forte enfasi sulla sicurezza, sostenendo che questo modello sia il loro più sicuro e “più robustamente allineato” rilasciato finora.
Questa affermazione è supportata da una riduzione di ciò che chiamano “concerning behavior score”, inferiore rispetto agli altri modelli 4.5, così come a GPT-5.1 e Gemini 3 Pro. Anthropic ha anche reso Opus 4.5 più robusto contro attacchi di prompt injection, che possono indurre il modello a comportamenti dannosi.
Claude Opus 4.5 è disponibile oggi in tutta la gamma di prodotti Anthropic, inclusi l’app Claude, l’API e tutte e tre le principali piattaforme cloud. Gli sviluppatori possono accedervi direttamente tramite l’ID modello claude-opus-4-5-20251101.
Anche i prezzi hanno fatto un passo significativo verso il basso. A 5 $ per milione di token in input e 25 $ per milione di token in output, Opus 4.5 rende le capacità di fascia alta di Anthropic molto più accessibili.
Per gli utenti enterprise, il cambiamento di prezzo potrebbe essere particolarmente significativo. La combinazione di costi ridotti, maggiore accesso all’API e più ampia disponibilità tra i provider cloud posiziona Opus 4.5 come un’opzione competitiva.
Claude Opus 4.5 è l’affermazione più chiara di Anthropic su come si vede nella corsa all’IA. Mentre Google punta sulla comprensione multimodale e sui modelli on-device, Anthropic scommette molto sulle azioni: agentic coding, uso di strumenti e interazione con il computer.
I risultati dei benchmark raccontano davvero la storia: Opus 4.5 ottiene i punteggi più alti mai registrati sui benchmark di ingegneria del software e gestisce il debugging multi-sistema senza molte indicazioni.
I miei test confermano ciò che suggeriscono i benchmark: Opus 4.5 è molto capace nel lavoro multi-step. Che si trattasse di eseguire simulazioni bootstrap o di sintetizzare ricerche tra articoli, il modello ha affrontato i problemi come farebbe un pensatore: in modo adattivo e con un ragionamento chiaro. Se vuoi potenziare i tuoi workflow, penso che sia questo ciò che conta.
Se ti interessa approfondire i modelli Claude, ti consiglio il corso Introduction to Claude Models.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min





