

{count, plural, one {Khóa học} other {Khóa học}}
Hiểu về Trí tuệ Nhân tạo
{hours} giờ
428.4K
Ngay sau bản phát hành đáng chú ý của Gemini 3 từ Google, Anthropic đã công bố Claude Opus 4.5, gọi đây là “mẫu tốt nhất thế giới cho lập trình, tác nhân, và sử dụng máy tính.”
Mặc dù Gemini 3 đạt điểm chuẩn rất ấn tượng, nó vẫn xếp sau Claude Sonnet 4.5 trên SWE-bench, bài kiểm tra kỹ năng kỹ thuật phần mềm. Với Claude Opus 4.5, Anthropic vượt qua chính điểm số của mình trên SWE-bench và các bài kiểm tra khác.
Claude Opus 4.5 đánh dấu lần ra mắt mẫu quan trọng thứ ba của Anthropic chỉ trong hai tháng, sau Sonnet 4.5 và Haiku 4.5. Và với việc Anthropic hiện được định giá hơn 350 tỷ đô la, chúng ta biết họ có nguồn lực để duy trì tốc độ này.
Trong bài viết này, tôi sẽ khám phá mọi điều mới ở Claude Opus 4.5, xem xét các điểm chuẩn, tính năng mới và trực tiếp thử nghiệm khả năng của nó.
Claude Opus 4.5 là mẫu ngôn ngữ lớn mới nhất từ Anthropic. Kế thừa Opus 4, đây là mẫu tiên tiến nhất của Anthropic, tập trung vào lập trình, suy luận và các tác vụ kéo dài. Mẫu đạt 80,9% trên SWE-bench và 59,3% trên Terminal-bench.
Claude Opus 4.5 hiện có trên các ứng dụng của Anthropic, API và các nền tảng đám mây lớn.
Từ thông báo, những điểm sau nổi bật với tôi:
Cùng với việc ra mắt mẫu, Anthropic công bố một số cập nhật sản phẩm, tôi sẽ bàn kỹ hơn bên dưới. Bao gồm Claude for Chrome, tiện ích mở rộng trình duyệt cho phép Claude hành động trên nhiều thẻ, và Claude for Excel.
Một bài viết sẽ không trọn vẹn nếu không đưa mẫu mới vào vài bài kiểm tra. Hãy xem các cải tiến mới xử lý dải tác vụ như thế nào:
Đầu tiên, tôi muốn xem Opus 4.5 xử lý một bài toán tối ưu hóa kinh tế học kinh điển ra sao. Tôi hình dung một mô hình cầu log-linear dự đoán lượng bán theo giá. Đây là dạng bài bạn sẽ gặp trong một khóa kinh tế lượng, nhưng cũng rất hữu ích. Nếu bạn biết đường cầu và chi phí, bạn có thể giải ra mức giá tối đa hóa doanh thu.
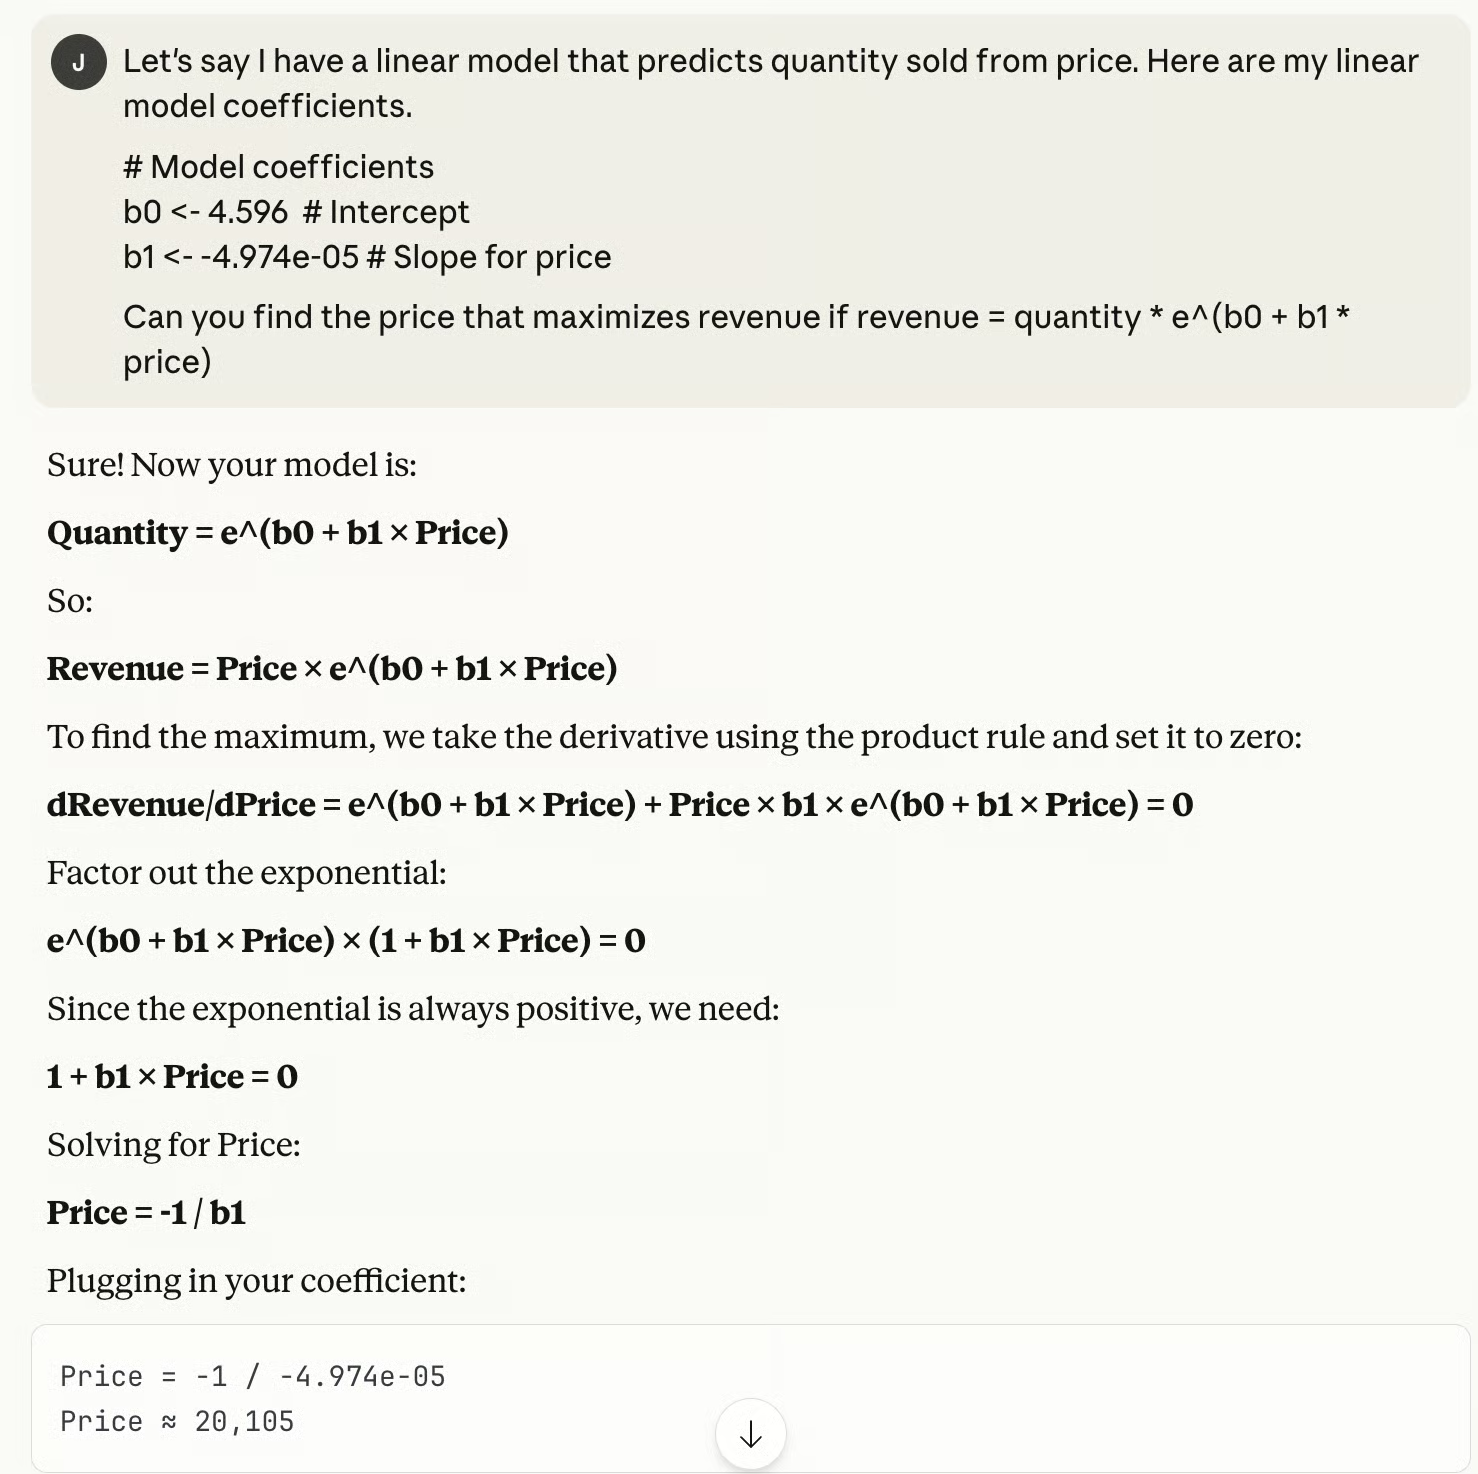
Opus 4.5 đưa ra câu trả lời đúng, không cần suy nghĩ lâu, và thực hiện liền mạch trong một lần.
Điều này khiến tôi ấn tượng vì hầu như bất kỳ công ty nào bán hàng cũng sẽ có một số hiểu biết về lượng bán và giá, nhưng không phải công ty nào cũng có nguồn lực để phác thảo lời giải cho các bài toán tối ưu hóa sơ cấp.
Nhưng ở đây, với một lời nhắc được thiết kế tốt, bạn có thể dễ dàng tìm ra đáp án. Dĩ nhiên, vẫn tùy nhà phân tích quyết định liệu các ràng buộc đã được mô hình hóa đầy đủ hay chưa.
Điểm tôi cũng thích: Opus 4.5 “trình bày bài làm”. Nó không chỉ đưa ra một con số. Nó đi qua đạo hàm, phân tích thừa số và đại số. Nếu có lỗi, tôi có thể phát hiện chỗ sai.
Tiếp theo, tôi muốn kiểm tra Opus 4.5 với một câu hỏi thống kê. Tôi tạo một bộ dữ liệu trong đó yield là hàm của temperature với nhiễu được thêm vào.
library(tidyverse)

set.seed(1024)

# Generate data
n <- 100
df <- data.frame(
  temperature = seq(0, 100, length.out = n)
) %>%
  mutate(yield = 0.5 * temperature + 10 + rnorm(n, 0, 5))
Sau đó tôi đưa cho Claude lời nhắc này.
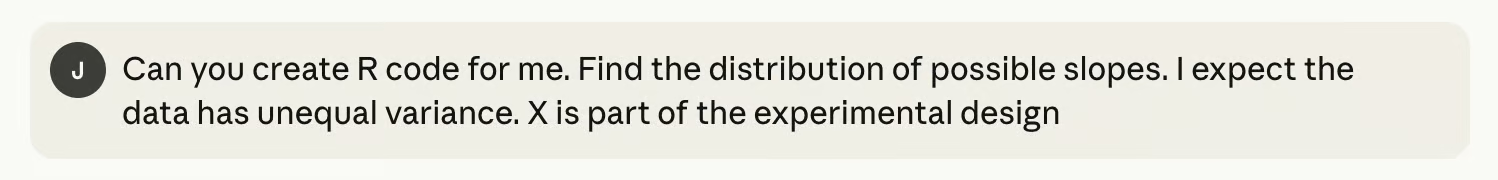
Claude trả về cho tôi đoạn sau, tôi dùng để tạo biểu đồ histogram bên dưới.
# Fit model
fit <- lm(yield ~ temperature, data = df)
fitted_vals <- fitted(fit)
resids <- residuals(fit)
original_slope <- coef(fit)[2]

# Residual bootstrap
set.seed(123)
n_boot <- 1000
boot_slopes <- numeric(n_boot)

for (i in 1:n_boot) {
  new_y <- fitted_vals + sample(resids, replace = TRUE)
  boot_fit <- lm(new_y ~ df$temperature)
  boot_slopes[i] <- coef(boot_fit)[2]
}

# Confidence intervals
ci_lower <- quantile(boot_slopes, 0.025)
ci_upper <- quantile(boot_slopes, 0.975)

# Plot
ggplot(data.frame(slope = boot_slopes), aes(x = slope)) +
  geom_histogram(bins = 40, fill = "gray70", color = "white") +
  geom_vline(xintercept = original_slope, color = "red", linewidth = 1) +
  geom_vline(xintercept = ci_lower, color = "steelblue", linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = ci_upper, color = "steelblue", linetype = "dashed", linewidth = 1) +
  labs(
    title = "Bootstrap Estimate: Effect of Temperature on Yield",
    subtitle = paste0("Estimate: ", round(original_slope, 3),
                      " | 95% CI: [", round(ci_lower, 3), ", ", round(ci_upper, 3), "]"),
    x = "Slope (yield per °C)",
    y = "Count"
  ) +
  theme_minimal()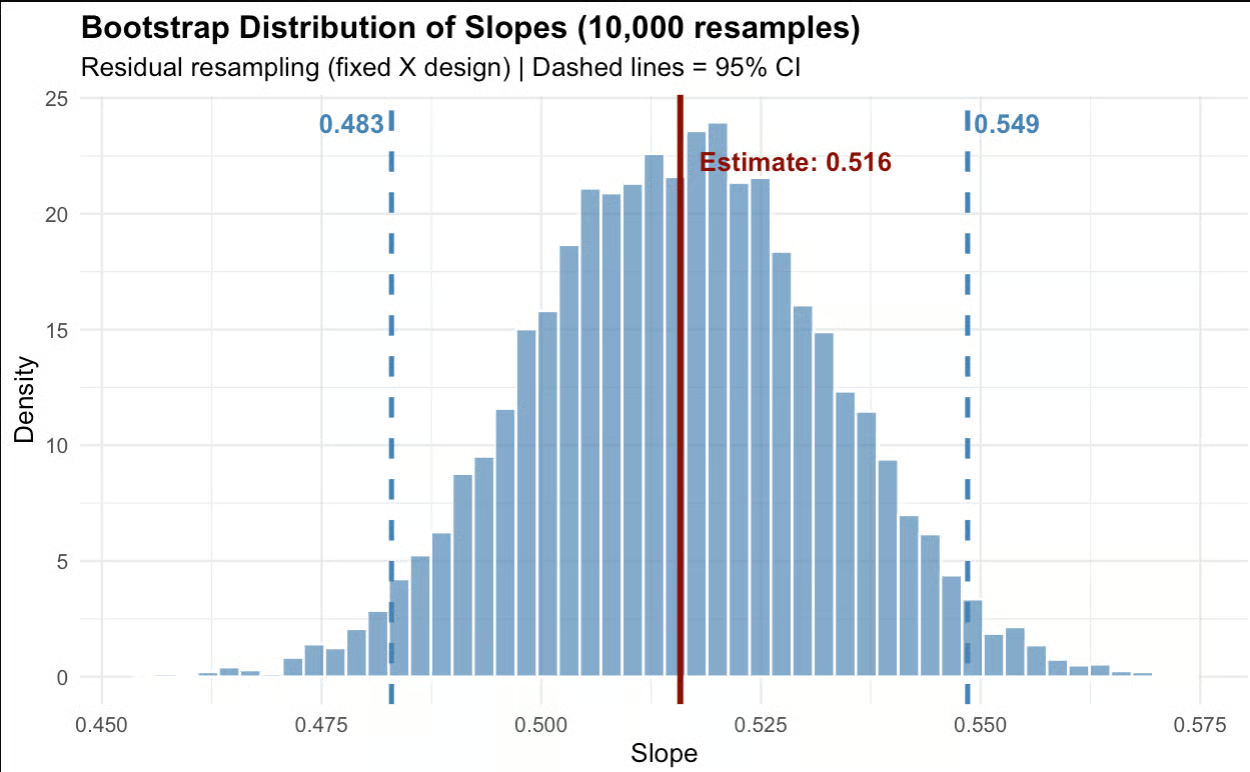
Tôi phải nói là tôi thích kết quả này. Opus 4.5 tìm được khoảng tin cậy cho hệ số dốc, đúng với điều tôi thực sự yêu cầu.
Nó dùng phương pháp bootstrap, một kỹ thuật tốt để tìm khoảng tin cậy khi có phương sai sai số thay đổi. Cụ thể hơn, nó bootstrap trên phần dư, thay vì phương pháp bootstrap khác tái lấy mẫu cặp (X,Y), vốn sẽ giả định có sai số ở biến X.
Tất cả điều này là một điểm tinh tế nhưng quan trọng với những người làm công việc kiểu này: Bootstrap phần dư sẽ tốt hơn khi X được cố định theo thiết kế, như tôi nêu trong lời nhắc, và khi bạn muốn suy luận có điều kiện trên đúng các giá trị X đó, như trong một nghiên cứu khoa học. Ý tôi là Opus 4.5 đã “lắng nghe” những điểm tinh tế trong lời nhắc.
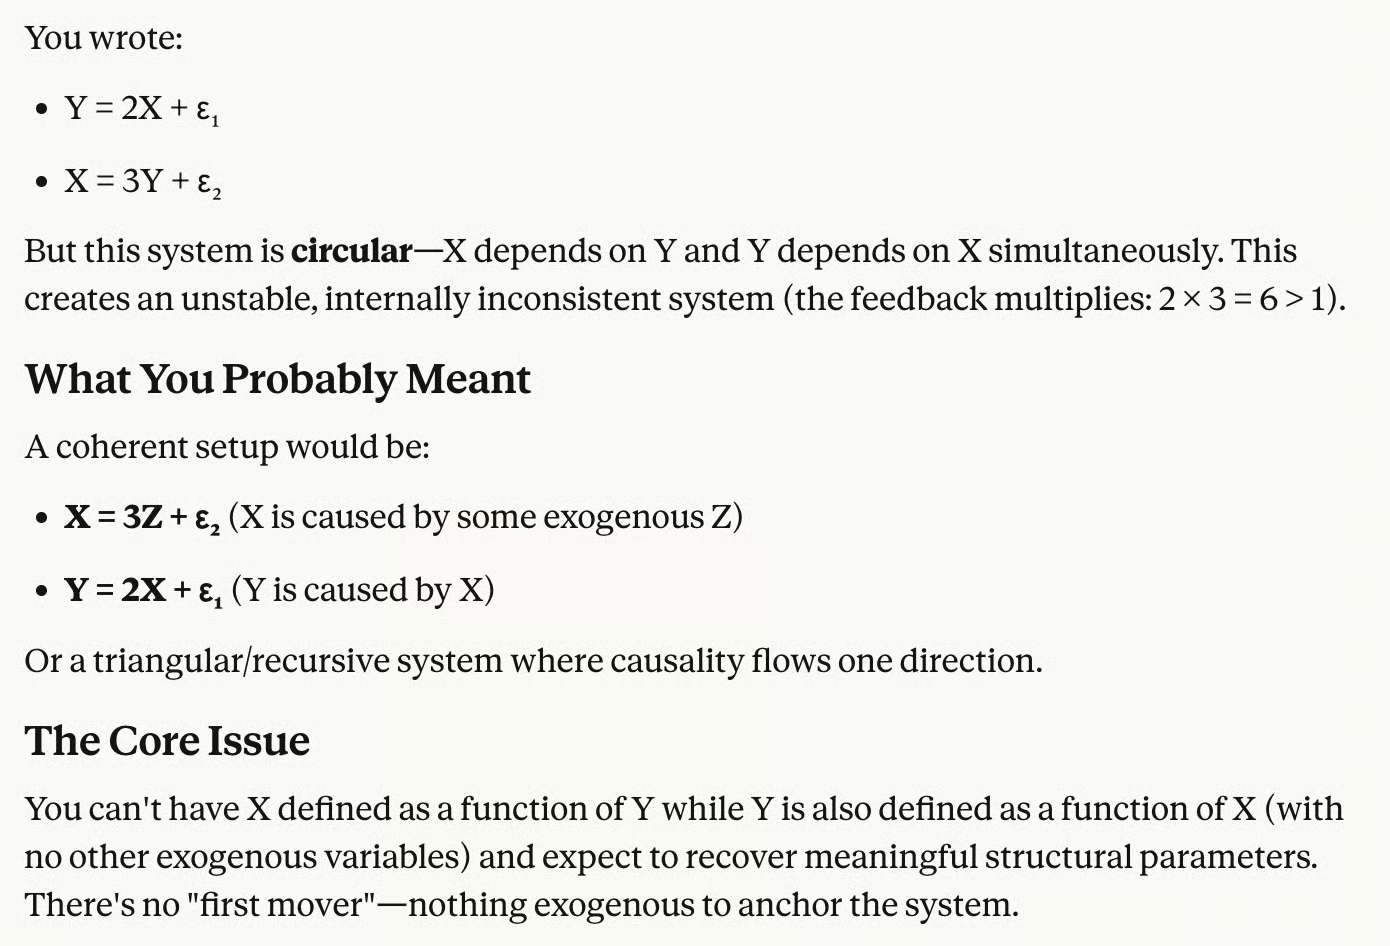
Tiếp theo, tôi muốn xem liệu mình có thể “gài” Opus 4.5 theo cách nào đó không.
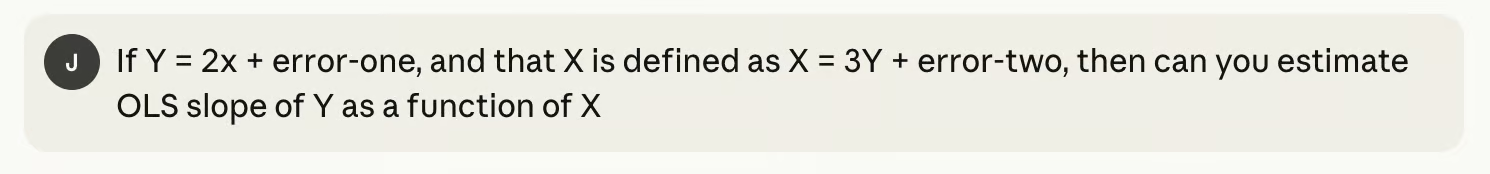
Trong trường hợp này, mẫu đã đi trước tôi một bước. Opus 4.5 hiểu rằng câu hỏi của tôi mang tính vòng tròn — tôi định nghĩa X theo Y và ngược lại, nên chúng ta không thể rút ra ước lượng ý nghĩa cho hệ số dốc của đường hồi quy với dữ liệu có sẵn.
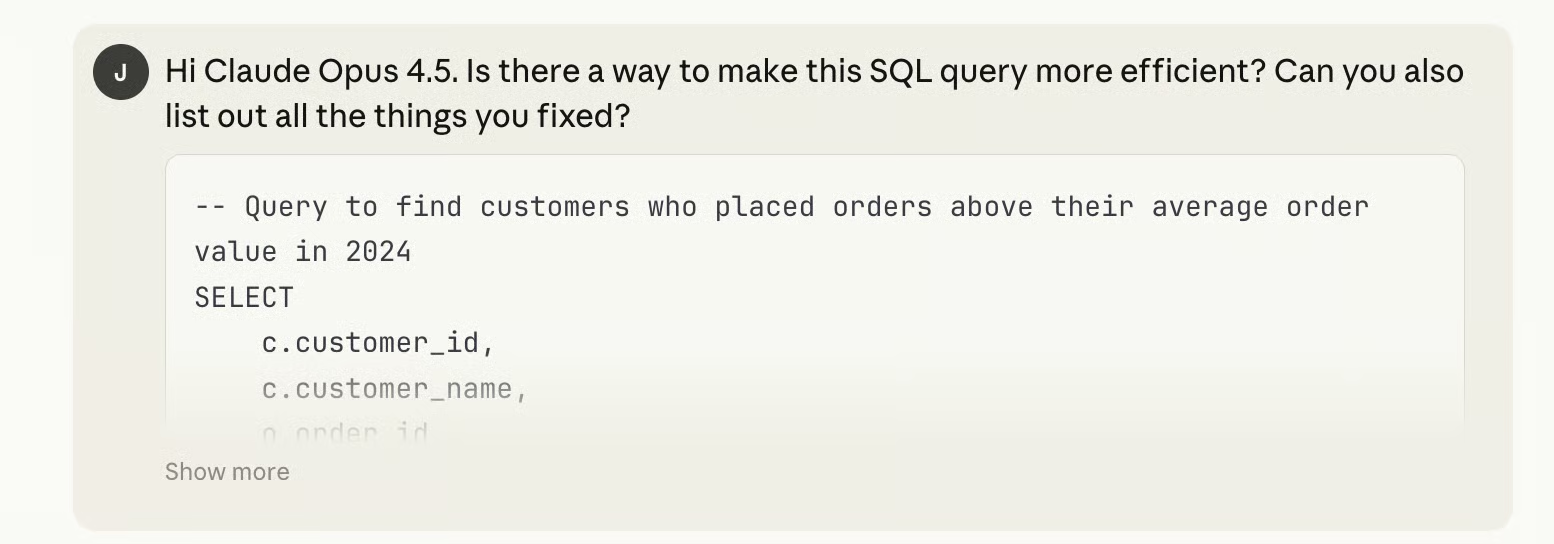
Cuối cùng, tôi nghĩ sẽ thú vị nếu kiểm tra Opus 4.5 với một câu hỏi SQL. Tôi gửi một truy vấn SQL chạy được nhưng rất kém hiệu quả.
-- Find customers who placed orders above their average order value in 2024
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > (
        SELECT AVG(o2.order_total)
        FROM orders o2
        WHERE o2.customer_id = c.customer_id
    )
    AND c.customer_id IN (
        SELECT DISTINCT o3.customer_id
        FROM orders o3
        WHERE o3.order_date >= '2024-01-01'
    )
    AND EXISTS (
        SELECT 1
        FROM customer_preferences cp
        WHERE cp.customer_id = c.customer_id
            AND cp.email_opt_in = 1
    )
ORDER BY (
    SELECT COUNT(*)
    FROM orders o4
    WHERE o4.customer_id = c.customer_id
) DESC;
Tôi yêu cầu Opus 4.5 cải thiện truy vấn. Nó đưa ra câu trả lời trong khoảng một giây.
-- Find customers who placed orders above their average order value in 2024
WITH customer_avg AS (
    SELECT
        customer_id,
        AVG(order_total) AS avg_order_total,
        COUNT(*) AS order_count
    FROM orders
    GROUP BY customer_id
)
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
JOIN customer_avg ca ON c.customer_id = ca.customer_id
JOIN customer_preferences cp ON c.customer_id = cp.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > ca.avg_order_total
    AND cp.email_opt_in = 1
ORDER BY ca.order_count DESC;
Trong số các cải tiến, Opus 4.5 thay thế truy vấn con tương quan cho AVG bằng một CTE. (Truy vấn gốc tính lại AVG(order_total) cho từng hàng được đánh giá, còn CTE giờ tính trung bình của mỗi khách hàng một lần từ đầu.) Opus 4.5 cũng loại bỏ mệnh đề IN (SELECT DISTINCT ...) dư thừa, vốn làm việc thừa. Và nó chuyển truy vấn con EXISTS thành JOIN, hợp lý hơn.
Có những điểm nổi bật khác trong bản phát hành mới nhất của Anthropic. Hãy xem chi tiết hơn:
Anthropic đã bổ sung một số khối xây dựng mới cho nhà phát triển. Đáng chú ý nhất là tham số effort, cho phép bạn kiểm soát mức độ “suy nghĩ” của mẫu trước khi phản hồi. Đặt thấp cho tác vụ nhanh, nhẹ; đặt cao hơn khi bạn cần mẫu “nhai kỹ” vấn đề.
Theo Anthropic, ở mức effort trung bình, Opus 4.5 đạt điểm SWE-bench tốt nhất của Sonnet 4.5 trong khi dùng ít hơn 76% token đầu ra. Ở mức effort cao, nó vượt Sonnet hơn 4% — vẫn dùng gần bằng một nửa số token.
Cũng có quản lý ngữ cảnh và bộ nhớ được cải thiện. Với các tác nhân chạy dài, Claude giờ có thể tự động tóm tắt ngữ cảnh trước đó để không “đụng trần” giữa chừng. Điều này kết hợp với nén ngữ cảnh, giúp tác nhân chạy lâu hơn với ít can thiệp.
Cuối cùng, Opus 4.5 tỏ ra khá giỏi trong điều phối đa tác nhân, tức có thể quản lý một nhóm tác nhân con.
Có vẻ như hiệu suất của Opus 4.5 trên một đánh giá nghiên cứu chuyên sâu đã tăng khoảng 15%.
Tôi đã tự kiểm tra khả năng nghiên cứu chuyên sâu. Tôi yêu cầu nó viết một báo cáo về các từ tiếng Anh cổ còn tồn tại đến ngày nay nhưng không phổ biến, và cách những từ loại này thay đổi theo thời gian. Báo cáo sẵn sàng sau bảy phút:
Tôi khá ấn tượng với chất lượng báo cáo xét về mức độ thú vị, chất lượng viết, tổ chức nội dung và chiều sâu nghiên cứu.
Đây không phải một tài liệu khô khan dày đặc các từ cổ hay lỗi thời. Tôi thừa nhận một số phần có thể được phân tách rõ hơn. Phần giữa báo cáo hơi nhàm hơn các phần khác. Nhưng — và đây là điểm mấu chốt — nó được nghiên cứu cực kỳ kỹ lưỡng. Hãy nhìn vào các trích dẫn này:
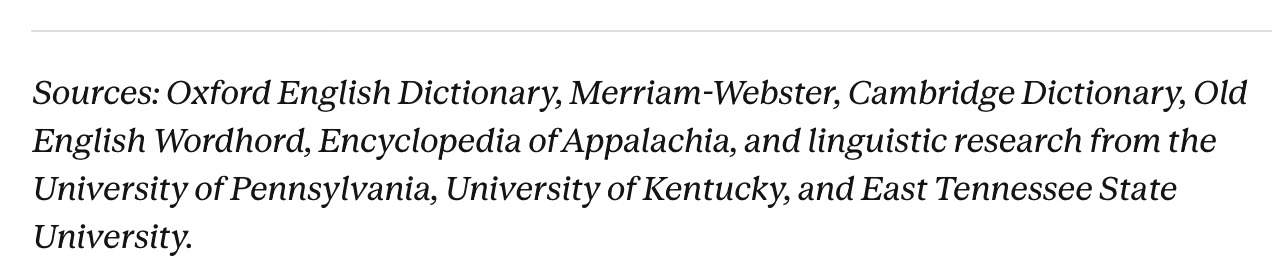
Thêm nữa, tôi học được một từ rất hay: apricity, nghĩa là hơi ấm của mặt trời vào mùa đông.
Anthropic đã phát hành hai nâng cấp cho Claude Code.
Chế độ Plan hiện xây dựng kế hoạch chính xác hơn trước khi thực thi. Trên thực tế, điều này nghĩa là Claude sẽ hỏi các câu làm rõ ngay từ đầu, rồi tạo tệp plan.md có thể chỉnh sửa để bạn xem và tinh chỉnh trước khi nó bắt đầu làm việc. Mục tiêu là tránh những khởi đầu sai hướng.
Tích hợp ứng dụng desktop là điểm lớn còn lại. Claude Code hiện có trong ứng dụng desktop, nghĩa là bạn có thể chạy song song nhiều phiên cục bộ và từ xa. Theo ví dụ của chính Anthropic: một tác nhân sửa lỗi, tác nhân khác nghiên cứu issue trên GitHub, và tác nhân thứ ba cập nhật tài liệu.
Một vài tính năng mang tính tác nhân đã xuất hiện trong các ứng dụng Claude cho người dùng:
Claude for Chrome cho phép Claude xử lý tác vụ trên các thẻ trình duyệt của bạn. Hiện khả dụng cho tất cả người dùng Max. Hãy coi đây là một tác nhân duyệt web có thể điều hướng, nhấp, điền biểu mẫu và thu thập thông tin trên nhiều trang.
Claude for Excel mang tự động hóa bảng tính đến với Claude. Tính năng này đã được công bố trước đó, nhưng Anthropic nay đã mở rộng truy cập beta cho tất cả người dùng Max, Team và Enterprise, nên tính khả dụng đã thực tế hơn.
Xử lý hội thoại dài khắc phục một hạn chế khó chịu. Trước đây, các cuộc trò chuyện dài sẽ chạm giới hạn ngữ cảnh và dừng lại, buộc bạn phải bắt đầu cuộc trò chuyện mới. Giờ đây, Claude tự động tóm tắt các phần trước của cuộc trò chuyện ở hậu trường, giải phóng không gian để bạn không bị “đụng tường”.
Giống các mẫu Claude trước, Opus 4.5 được kiểm tra trên các điểm chuẩn phổ biến về lập trình mang tính tác nhân, sử dụng công cụ, sử dụng máy tính và giải quyết vấn đề. Dưới đây là các kết quả lớn của Opus 4.5.
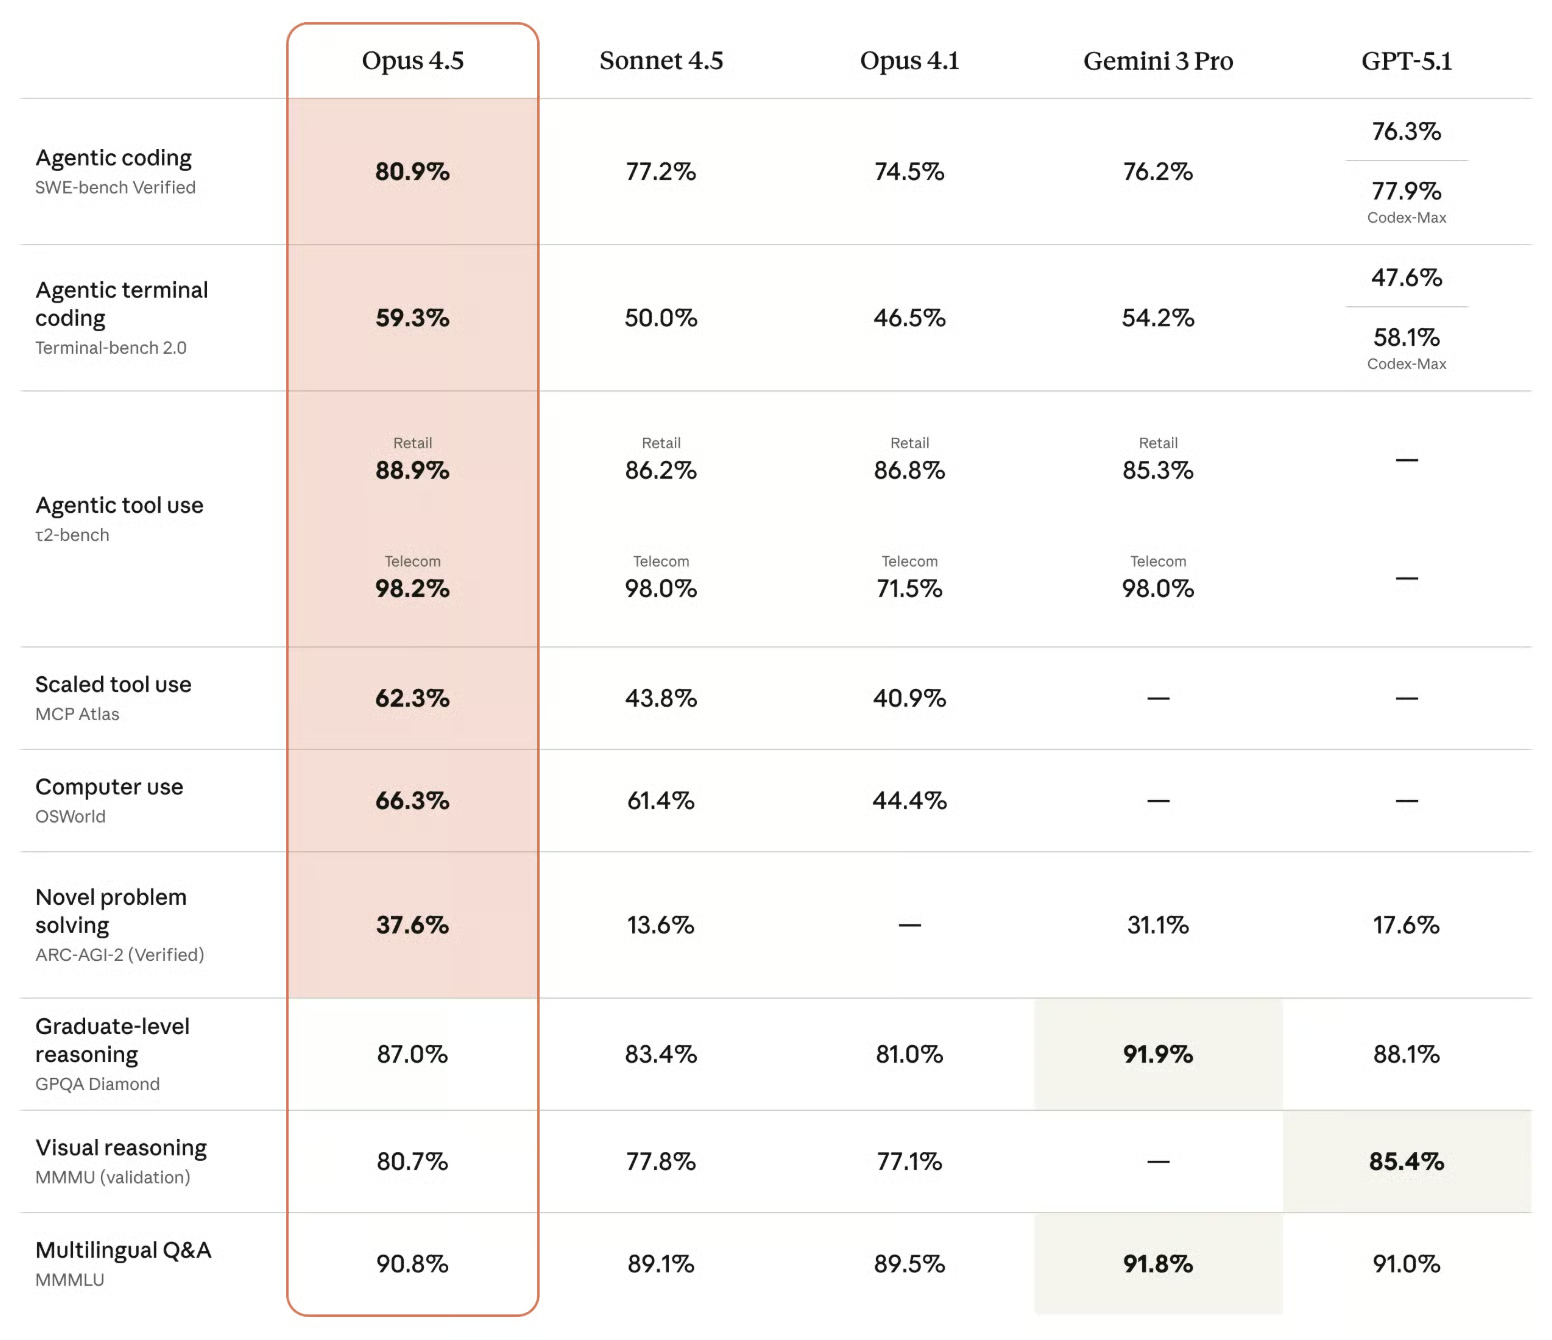
Opus 4.5 đứng đầu ở nhiều bài kiểm tra quan trọng nhất. Bất cứ thứ gì liên quan đến việc “thực sự làm”, như viết mã vượt qua bài kiểm tra (SWE-bench), dùng công cụ trong quy trình nhiều bước (τ2-bench, MCP Atlas), và vận hành máy tính (OSWorld). Opus 4.5 dẫn đầu, thường là bỏ xa.
Khoảng cách ở hạng mục sử dụng công cụ quy mô lớn thực sự rất lớn: 62,3% so với 43,8% cho vị trí thứ hai, cũng là Claude! Tuy nhiên, điều này cho thấy Anthropic đầu tư rất nhiều để cải thiện hiệu suất, đặc biệt ở các tác vụ mang tính tác nhân. Dù mẫu cũ hơn của họ có thể đang dẫn đầu ở một số hạng mục, họ vẫn không hạ tốc độ tiến bộ.
Có vẻ Gemini 3 Pro chiếm ưu thế ở một số điểm chuẩn đòi hỏi kiến thức, như suy luận trình độ sau đại học (GPQA Diamond) và Hỏi đáp đa ngôn ngữ (MMMLU). Những điểm chuẩn này có lẽ thưởng cho bề rộng dữ liệu huấn luyện và suy luận cẩn trọng hơn là ghi nhớ sự kiện, và dĩ nhiên Google có rất nhiều nguồn lực.
Những cải tiến từ Anthropic không chỉ xoay quanh lập trình, nghiên cứu và sử dụng máy tính. Họ nhấn mạnh mạnh mẽ vào an toàn, khẳng định đây là mẫu an toàn nhất và “được căn chỉnh vững vàng nhất” mà họ từng phát hành.
Tuyên bố này được hậu thuẫn bởi việc giảm cái gọi là “điểm hành vi đáng lo ngại”, thấp hơn các mẫu dòng 4.5 khác, cũng như GPT-5.1 và Gemini 3 Pro. Anthropic cũng làm cho Opus 4.5 vững vàng hơn trước các cuộc tấn công prompt injection, vốn có thể đánh lừa mẫu thực hiện hành vi gây hại.
Claude Opus 4.5 hiện khả dụng trên toàn bộ danh mục sản phẩm của Anthropic, bao gồm ứng dụng Claude, API và cả ba nền tảng đám mây lớn. Nhà phát triển có thể truy cập trực tiếp qua ID mẫu claude-opus-4-5-20251101.
Giá cũng giảm đáng kể. Ở mức 5 đô la cho mỗi triệu token đầu vào và 25 đô la cho mỗi triệu token đầu ra, Opus 4.5 giúp năng lực hàng đầu của Anthropic dễ tiếp cận hơn nhiều.
Với người dùng doanh nghiệp, thay đổi về giá có thể đặc biệt ý nghĩa. Sự kết hợp giữa chi phí giảm, mở rộng truy cập API và khả dụng rộng hơn trên các nhà cung cấp đám mây khiến Opus 4.5 trở thành lựa chọn cạnh tranh.
Claude Opus 4.5 là tuyên bố rõ ràng nhất của Anthropic về vị thế của họ trong cuộc đua AI. Trong khi Google thúc đẩy hiểu đa phương thức và mẫu chạy trên thiết bị, Anthropic đặt cược mạnh vào hành động: lập trình mang tính tác nhân, sử dụng công cụ và tương tác máy tính.
Các kết quả điểm chuẩn nói lên tất cả: Opus 4.5 đạt điểm cao nhất từng ghi nhận trên các điểm chuẩn kỹ thuật phần mềm và xử lý gỡ lỗi đa hệ thống mà không cần nhiều hướng dẫn.
Các thử nghiệm của tôi xác nhận điều các điểm chuẩn gợi ý: Opus 4.5 rất giỏi ở công việc nhiều bước. Dù là chạy mô phỏng bootstrap hay tổng hợp nghiên cứu từ nhiều bài báo, mẫu tiếp cận vấn đề như một người suy nghĩ: thích ứng và lý giải rõ ràng. Nếu bạn muốn tăng cường quy trình làm việc, đây mới là điều quan trọng.
Nếu bạn muốn tìm hiểu thêm về các mẫu Claude, tôi khuyến nghị xem khóa học Introduction to Claude Models.
Học với DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
