

为回归进行自助法置信区间估计
线性回归是统计建模的基石,用于揭示一个或多个自变量与因变量之间的关系。在处理回归模型时,常常需要评估估计的不确定性。一种方法是计算线性回归置信区间,它提供了一个范围,其中很可能包含真实参数(如均值)。这里,我们将用自助法创建置信区间,同时也使用正态近似方法(又称 Wald 置信区间)进行对比。
在线性回归的语境下,自助重抽样是指从数据集中随机抽样生成多个自助样本,然后对每个样本拟合回归模型,最后利用各样本得到的模型系数分布来估计置信区间。在下面的代码中,我们使用tidymodels包中的bootstraps()函数对数据集进行自助重抽样,并绘制截距与权重系数在自助样本中的取值范围直方图。
boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)ggplot(boot_coefs, aes(estimate)) + geom_histogram(bins = 30) + facet_wrap( ~ term, scales = "free") + labs(title="fish", subtitle = "Height ~ Square Root of Weight") + labs(caption = "95% confidence interval parameter estimates, intercept + estimate") + geom_vline(aes(xintercept = .lower), data = percentile_intervals, col = '#528fad') + geom_vline(aes(xintercept = .upper), data = percentile_intervals, col = '#528fad')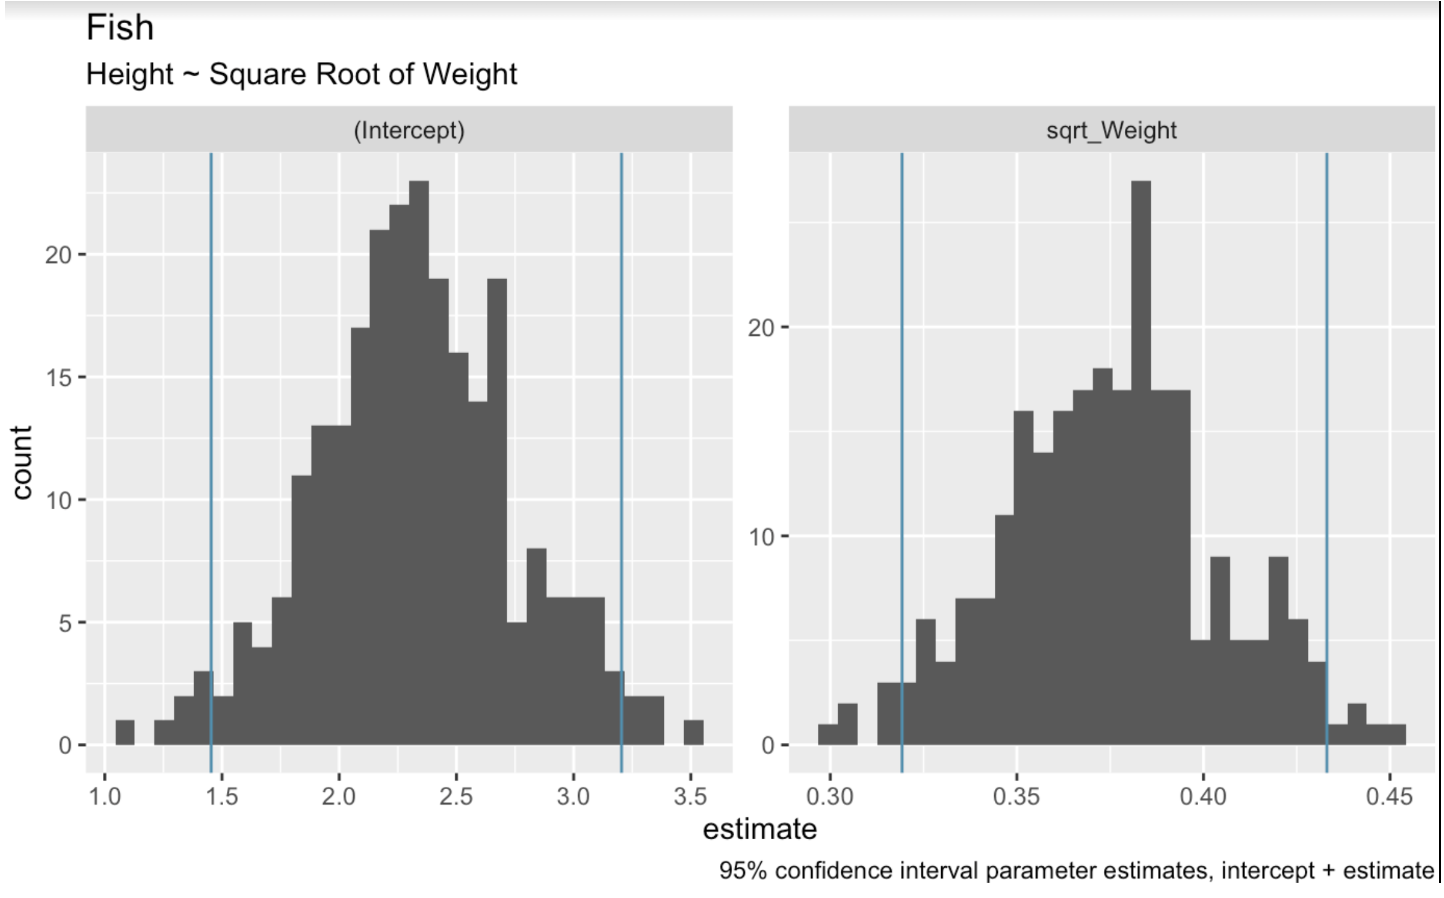
线性模型的自助法系数。图片由作者提供。
当我们绘制可能的回归线时,会在两端裁剪掉最极端的曲线,以得到 95% 区间。int_pctl()函数可以轻松实现这一点。
boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)最后一步,我们用更具理论性的闭式公式来生成置信区间。可通过对线性模型对象调用summary()来获取参数。
linear_model <- lm(Height ~ sqrt(Weight), fish_df)summary(linear_model)Call:lm(formula = Height ~ sqrt(Weight), data = fish_df)Residuals: Min 1Q Median 3Q Max-7.7425 -1.3611 -0.5628 2.2606 5.0131Coefficients: Estimate Std. Error t value Pr(>|t|)(Intercept) 2.31506 0.43636 5.305 3.77e-07 ***sqrt(Weight) 0.37569 0.02186 17.183 < 2e-16 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 2.533 on 157 degrees of freedomMultiple R-squared: 0.6529, Adjusted R-squared: 0.6506F-statistic: 295.3 on 1 and 157 DF, p-value: < 2.2e-16这里,sqrt_Weight变量的估计系数为 0.37569。sqrt_Weight的标准误为 0.02186。自由度为 157(即 159 个观测减去两个估计参数)。95% 双侧置信区间的 t 值为 1.975189。我们通过qt()函数得到这一数值:qt(0.975, 157)。在下图中,蓝色线为自助法得到的线性回归线,红色虚线为常见解析公式生成的置信区间。
# Wald confidence interval(CI_upper <- 0.37569 + 1.975 * 0.02186)(CI_lower <- 0.37569 - 1.975 * 0.02186)(CI_intercept_upper <- 2.31506 + 1.975 * 0.43636)(CI_intercept_lower <- 2.31506 - 1.975 * 0.43636)ggplot(boot_aug, aes(sqrt_Weight, Height)) + geom_line(aes(y = .fitted, group = id), alpha = .3, col = '#528fad') + geom_point(alpha = 0.005) + labs(title="fish", subtitle = "Height ~ Weight") + labs(caption = "linear regression bootstrap resampling") + geom_abline(intercept = 1.453249, slope = 0.4188635, linetype = "dashed", color = "#e76254") + geom_abline(intercept = 3.176871, slope = 0.3325165, linetype = "dashed", color = "#e76254")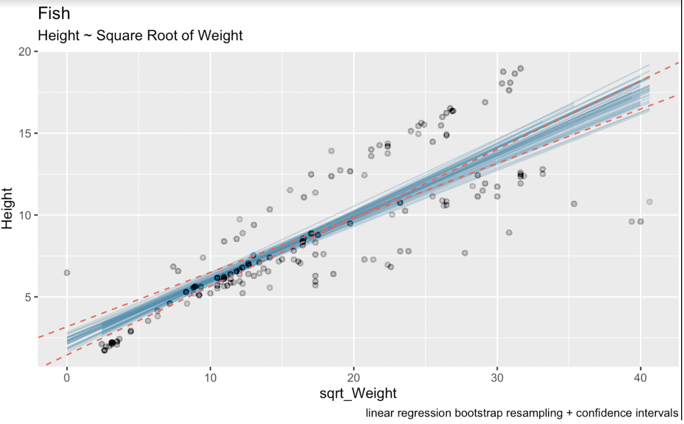
带置信区间的自助法线性回归。图片由作者提供。
可以清楚看到,自助重抽样过程为我们的估计引入了更多不确定性。这是因为线性回归系数的区间在解析方法中通常基于关于误差分布与估计量性质的假设而推导,这些公式依赖于误差正态性和方差齐性等假设。
而自助重抽样则是分布无关(distribution-free)的,几乎不对底层数据分布作假设。它直接通过对观测数据进行重抽样来估计感兴趣统计量的抽样分布。因此,当传统方法的假设遭到破坏,或在样本量较小(如我们的 Fish Market 数据集仅有 159 个观测)的情形下,自助法得到的置信区间往往更稳健、更可靠。
参数化 vs. 非参数化自助法
在参数化自助法中,我们会对数据的底层分布作出假设,并基于这些假设生成重抽样。当您对数据分布有先验认知或强假设时,这种方法很有用。设想某个抽样数据集本身可能并非正态分布,但其背后的机制较为清楚,因此可以使用总体参数来构造分布。
非参数化自助法则不对数据分布作任何假设。它直接对观测数据进行有放回重抽样,因此当真实分布未知或难以刻画时尤其有价值。在上面的示例中,我们使用的就是非参数化自助法。两种方法都可以用来估计标准误和置信区间等统计量。但在处理现实世界的数据集(尤其是小样本或复杂样本)时,非参数化自助法更灵活,也更常见。
自助法在预测中的应用
在时间序列预测中,自助法可用于对历史数据进行重抽样并生成未来预测,给出一组可能结果的分布,而非单一的点估计。这有助于刻画潜在未来情景的范围,并为预测构建置信区间。自助法还支撑了时间序列模型中的装袋等集成方法,通过组合多个模型来降低过拟合、提升整体预测精度。我们的R 语言预测课程将教您如何在时间序列预测中进行重抽样,无论您采用ARIMA 预测还是其他方法。
结语
希望本文能让您更加认可自助法的价值。正如我们所见,自助法是统计学与机器学习中的强大工具,它提供了一种无需对底层数据作出强假设、却能评估统计量变异性与置信度的有趣途径。
不妨开始我们的Python 机器学习科学家职业路径,精通各类分布与复杂数据集的处理。我们的R 语言统计推断技能路径同样是绝佳选择,侧重假设检验、随机化与不确定性度量。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
在本文中,我们将探讨统计学和机器学习中的一项重要技术——自助法(bootstrapping)。自助法的名字来源于短语“pulling yourself up by your bootstraps”(自力更生),因为这种统计技术让您用很少的资源做到很多事。通过自助法,您可以从任意形状或大小的分布中生成一个由重抽样构成的新分布,并利用该新分布去近似真实的概率分布。因此,自助法对样本估计赋予准确度度量(如偏差、方差、置信区间和预测误差)尤其有效。
在开始之前,如果您对数据科学感兴趣,建议学习 DataCamp 上关于数据科学与统计学的课程,例如我们的R 语言统计推断技能路径以及Python 推断基础课程。
自助法与其他重抽样方法
首先,让我们明确自助法在重抽样方法中的位置。尽管重抽样方法有不同类型,但它们有一个共同点:模拟抽样过程。我们之所以使用重抽样方法,是因为在关注的人群中不断抽取新样本并不现实,而重抽样则是一种捷径。
例如,当我们想了解目标总体的某些特征时,可能会考虑发放一份问卷,并期望获得一千份回复。然而,没有人会对同一目标人群将同一问卷实施一千次。正因这种现实限制,我们会使用重抽样方法来生成关于样本的统计量,如标准误。
重抽样方法的类型
重抽样方法主要有四类。之所以提及其他方法,是因为它们共享一段统计创新与改进的历史。尤其是,自助法是在刀切法(jackknife)的基础上进行了扩展、修改或改进而发展起来的。
刀切法 vs. 自助法
尤其值得讨论一下刀切法,因为它是自助法的前身,而自助法正是作为对刀切法的扩展与改进被提出的。刀切法诞生于上世纪 50 年代,那时计算机的内存只有大约 1KB。
刀切法是一种留一法重抽样方法,针对感兴趣的统计量进行计算;它会按顺序或迭代地进行,直到每个观测值都被剔除一次。使用刀切法,重抽样次数受限于观测数,因此在小样本下表现往往较差。刀切法在可用数据类型方面也稍显受限。另一方面,与自助法不同,刀切法每次都具有可重复性。
自助法的应用
自助法在统计学和机器学习中应用广泛。最常见的用途之一是在未知底层分布或样本量较小时估计置信区间。这使得当传统参数方法可能不适用时,自助法尤为有价值。
此外,自助法常用于假设检验和模型验证,帮助评估模型预测的稳健性。在机器学习中,自助法支撑了流行的集成方法装袋(bagging),该方法被用于随机森林等模型中,通过降低方差来提升准确率。
如何进行自助重抽样
为了演示自助法,我们需要使用 R 这样的编程语言,因为它可以生成多个重抽样数据集;没有编程环境,手动实施这个过程会过于耗时且复杂。本文将使用 Kaggle 上的Fish Market数据集,分别对一个分布和一个线性回归的置信区间进行自助法估计。
有放回与无放回抽样
在正式介绍自助法之前,先熟悉一下有放回抽样的概念。在这里,R 语言的基础函数
sample()至少需要在函数调用中显式指定两个参数:x和size。x用来确定我们抽样所依据的值列表或范围,size决定样本大小。还有一个常常会显式指定的参数是replace。除非另行设置,默认是replace = FALSE。自助法是有放回抽样。有放回抽样意味着每次抽取后都会将该值放回。因此,每次抽样彼此独立;而无放回抽样则不放回,一旦某个值被选中便无法再次被选中,于是两次样本取值并不独立,某次抽样的结果会影响下一次抽样的可能性。其结果之一是,如果不指定
replace = TRUE,我们无法选择大于输入向量长度的样本大小。自助法不存在这个问题,我们可以生成一个远大于原始数据集的自助重抽样数据集。为一个分布进行自助法置信区间估计
现在下载数据集,并使用
read.csv()函数从下载文件夹读取到 RStudio。首先,让我们绘制鱼重量平方根的直方图,以查看其分布。由图可见,该分布与正态或高斯分布相去甚远,甚至有些双峰特征。
鱼重量直方图。图片由作者提供。
我们可以通过
tidymodels库中的infer包在 R 中进行自助法重抽样。将该表打印到控制台会得到每次重复对应的目标统计量数据框。当我们用这些重复值构建一个新的分布时,该分布将近似正态分布,我们可以据此生成置信区间。