
Last chance! 50% off DataCamp Premium
Sale ends in
Kort na de indrukwekkende release van Gemini 3 van Google kondigde Anthropic onlangs Claude Opus 4.5 aan, dat het omschrijft als het ‘beste model ter wereld voor coderen, agents en computergebruik’.
Ondanks de zeer indrukwekkende benchmarks van Gemini 3 kwam het nog steeds achter Claude Sonnet 4.5 op de SWE-bench, een test van software-engineeringsvaardigheden. Met Claude Opus 4.5 verbetert Anthropic zijn eigen score op de SWE-bench en andere tests.
Claude Opus 4.5 is Anthropics derde grote modellancering in slechts twee maanden, na Sonnet 4.5 en Haiku 4.5. En nu Anthropic een waardering heeft van meer dan $350 miljard, weten we dat ze de middelen hebben om dit tempo vol te houden.
In dit artikel bekijk ik alles wat nieuw is aan Claude Opus 4.5: de benchmarks, de nieuwe functies, en ik ga hands-on om zijn capaciteiten te testen.
Claude Opus 4.5 is het nieuwste large language model van Anthropic. Het volgt Opus 4 op en is Anthropics meest geavanceerde model, met een focus op coderen, redeneren en taken die lang draaien. Het model scoort 80,9% op de SWE-bench en 59,3% op de Terminal-bench.
Claude Opus 4.5 is nu beschikbaar in Anthropics apps, de API en op grote cloudplatformen.
Uit de aankondiging viel mij het volgende op:
Naast de modellancering kondigde Anthropic verschillende productupdates aan, waar ik hieronder dieper op inga. Ze omvatten Claude voor Chrome, de browserextensie waarmee Claude acties kan uitvoeren over tabbladen heen, en Claude voor Excel.
Een verslag is niet compleet zonder het nieuwe model aan een of twee tests te onderwerpen. Laten we kijken hoe de nieuwe verbeteringen omgaan met verschillende taken:
Eerst wilde ik zien hoe Opus 4.5 een klassieke optimalisatievraag uit de economie aanpakt. Ik dacht aan een log-lineair vraagmodel dat de verkochte hoeveelheid voorspelt op basis van prijs. Het is iets wat je in een econometriecollege ziet, maar ook echt nuttig is. Als je je vraagcurve en je kosten kent, kun je de prijs oplossen die de omzet maximaliseert.
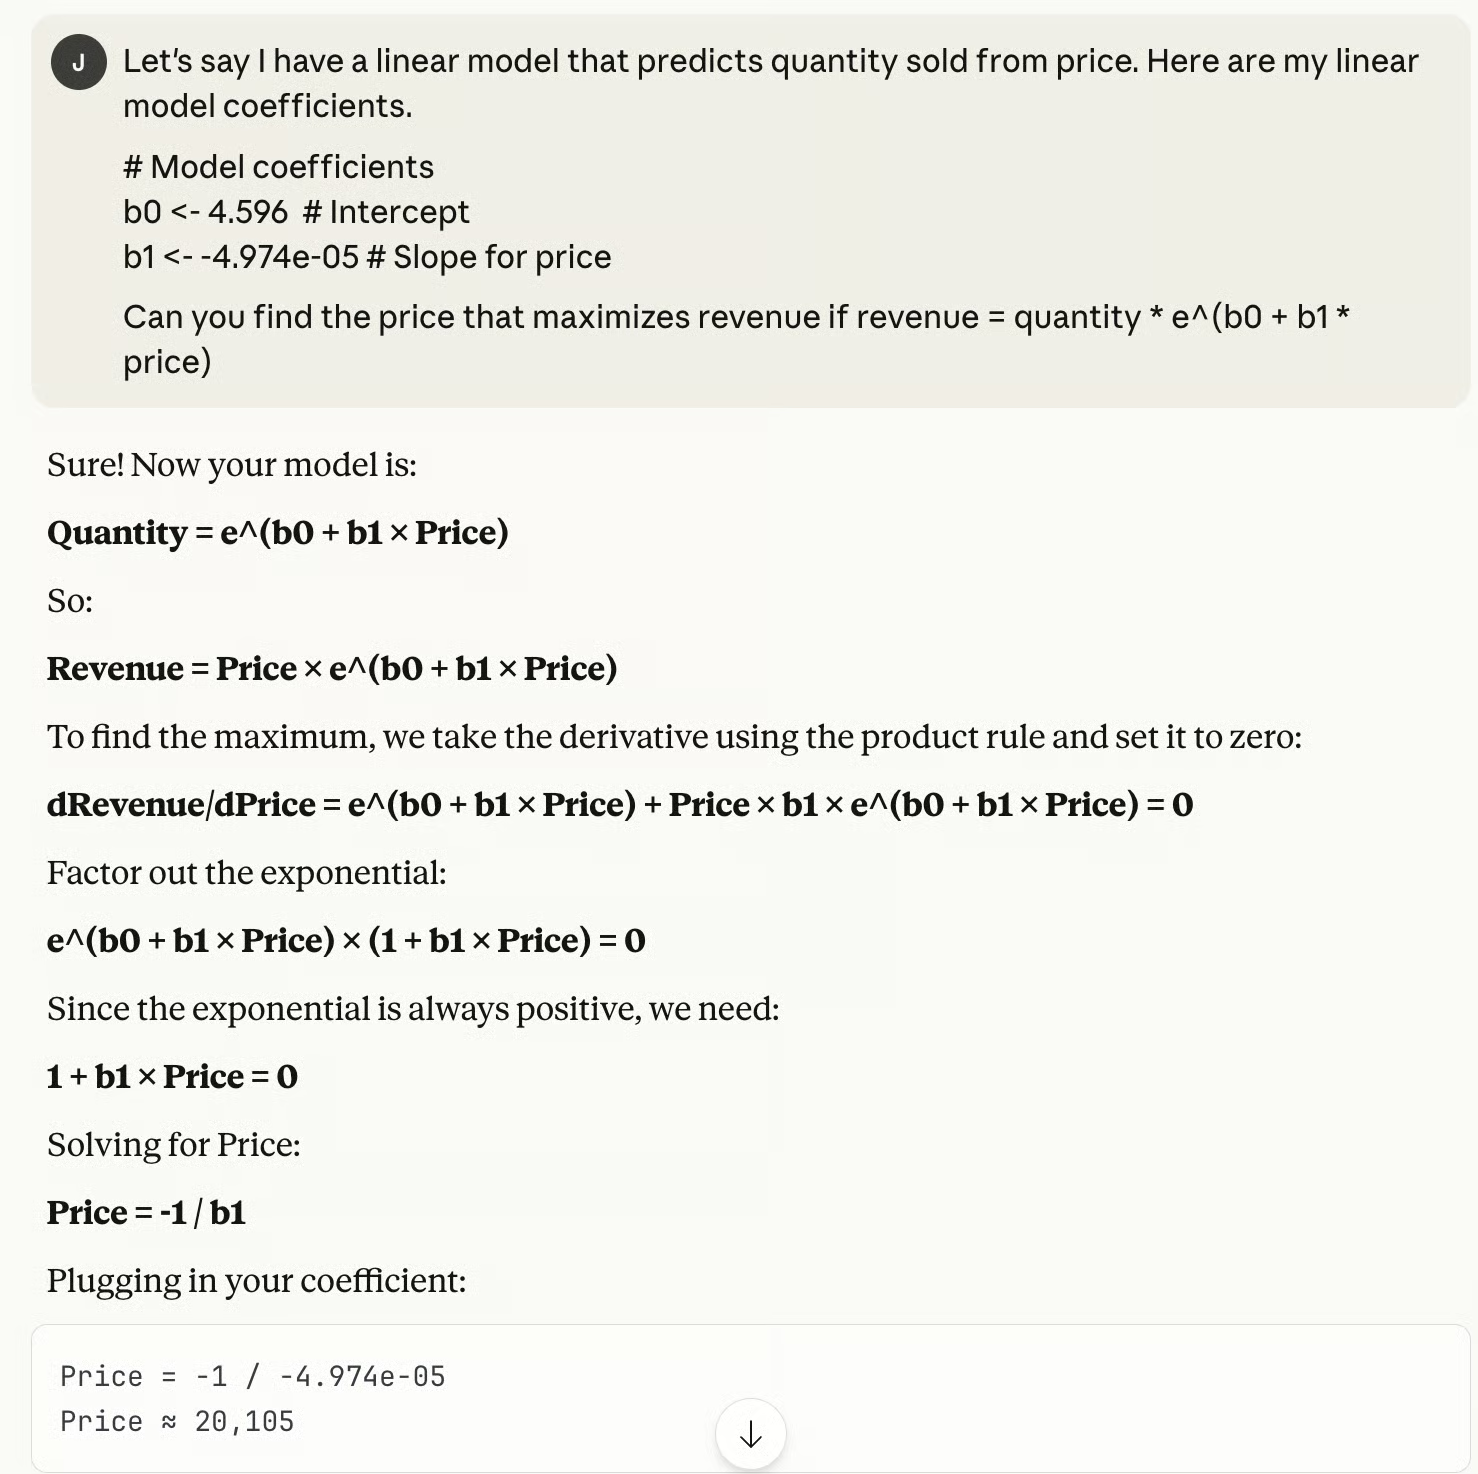
Opus 4.5 gaf me het juiste antwoord, zonder er lang over na te denken, en het gebeurde in één keer.
Dit maakte indruk, omdat zowat elk bedrijf dat iets verkoopt wel een idee heeft van hoeveelheid en prijs, maar niet elk bedrijf de middelen heeft om basisoptimalisatieproblemen uit te tekenen.
Maar hier kun je, met een goed ontworpen prompt, je antwoord eenvoudig vinden. Natuurlijk is het nog steeds aan de analist om te bepalen of genoeg van de randvoorwaarden echt goed zijn gemodelleerd.
Dit vond ik ook fijn: Opus 4.5 liet zien hoe het te werk ging. Het gaf me niet alleen een getal. Het liep de afgeleide, het ontbinden en de algebra door. Als het een fout had gemaakt, had ik kunnen zien waar.
Vervolgens wilde ik Opus 4.5 testen op een statistiekvraag. Ik maakte een dataset waarin yield een functie was van temperature met toegevoegde ruis.
library(tidyverse)

set.seed(1024)

# Generate data
n <- 100
df <- data.frame(
  temperature = seq(0, 100, length.out = n)
) %>%
  mutate(yield = 0.5 * temperature + 10 + rnorm(n, 0, 5))
Daarna gaf ik Claude deze prompt.
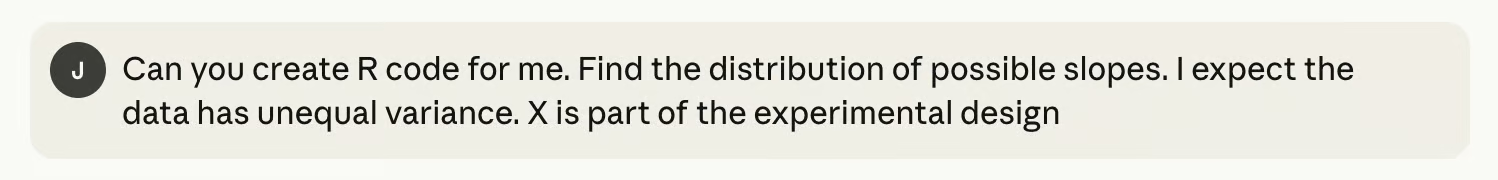
Claude gaf me het volgende terug, wat ik gebruikte om hieronder een histogram te maken.
# Fit model
fit <- lm(yield ~ temperature, data = df)
fitted_vals <- fitted(fit)
resids <- residuals(fit)
original_slope <- coef(fit)[2]

# Residual bootstrap
set.seed(123)
n_boot <- 1000
boot_slopes <- numeric(n_boot)

for (i in 1:n_boot) {
  new_y <- fitted_vals + sample(resids, replace = TRUE)
  boot_fit <- lm(new_y ~ df$temperature)
  boot_slopes[i] <- coef(boot_fit)[2]
}

# Confidence intervals
ci_lower <- quantile(boot_slopes, 0.025)
ci_upper <- quantile(boot_slopes, 0.975)

# Plot
ggplot(data.frame(slope = boot_slopes), aes(x = slope)) +
  geom_histogram(bins = 40, fill = "gray70", color = "white") +
  geom_vline(xintercept = original_slope, color = "red", linewidth = 1) +
  geom_vline(xintercept = ci_lower, color = "steelblue", linetype = "dashed", linewidth = 1) +
  geom_vline(xintercept = ci_upper, color = "steelblue", linetype = "dashed", linewidth = 1) +
  labs(
    title = "Bootstrap Estimate: Effect of Temperature on Yield",
    subtitle = paste0("Estimate: ", round(original_slope, 3),
                      " | 95% CI: [", round(ci_lower, 3), ", ", round(ci_upper, 3), "]"),
    x = "Slope (yield per °C)",
    y = "Count"
  ) +
  theme_minimal()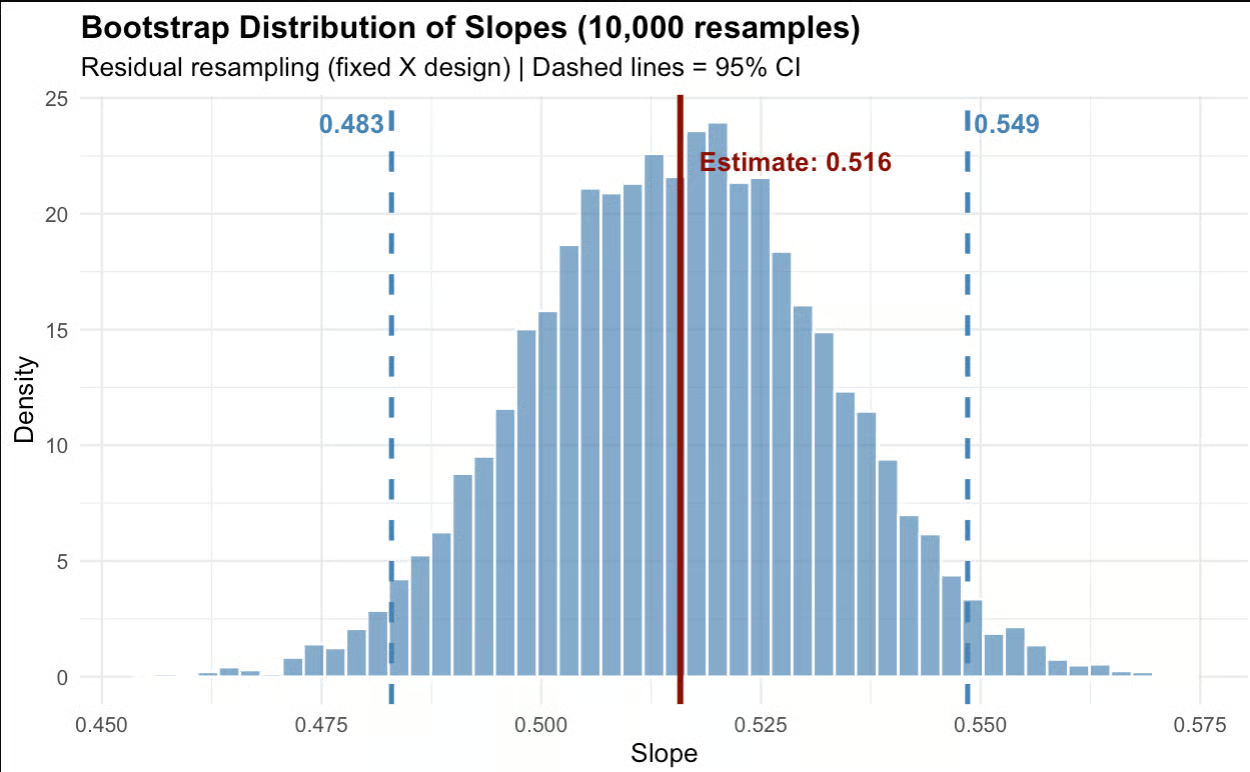
Ik moet zeggen dat ik dit resultaat goed vind. Opus 4.5 vond een betrouwbaarheidsinterval voor de helling, en dat was precies waar ik om vroeg.
Het gebruikte een bootstrapmethode, wat een goede techniek is om betrouwbaarheidsintervallen te vinden wanneer heteroscedasticiteit aanwezig is. Het gebruikte bovendien specifiek een bootstrap op de residuen, in plaats van een andere bootstrapmethode die (X,Y)-paren hersampelt, wat zou impliceren dat er fout in de X-term zit.
Dit is een subtiel maar waarschijnlijk belangrijk punt voor mensen die dit soort werk doen: een residu-bootstrap is beter wanneer X door ontwerp vastligt, zoals ik in mijn prompt aangaf, en wanneer je dus inferentie wilt conditioneel op die exacte X-waarden, zoals bij een wetenschappelijke studie. Wat ik wil zeggen is dat Opus 4.5 luisterde naar de subtiliteiten in de prompt.
Daarna wilde ik zien of ik Opus 4.5 op de een of andere manier op het verkeerde been kon zetten.
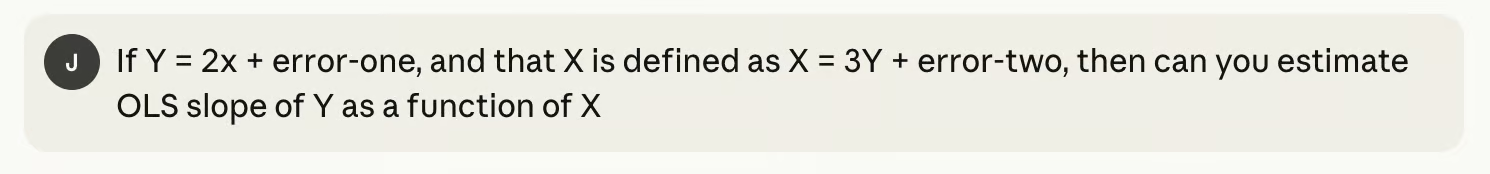
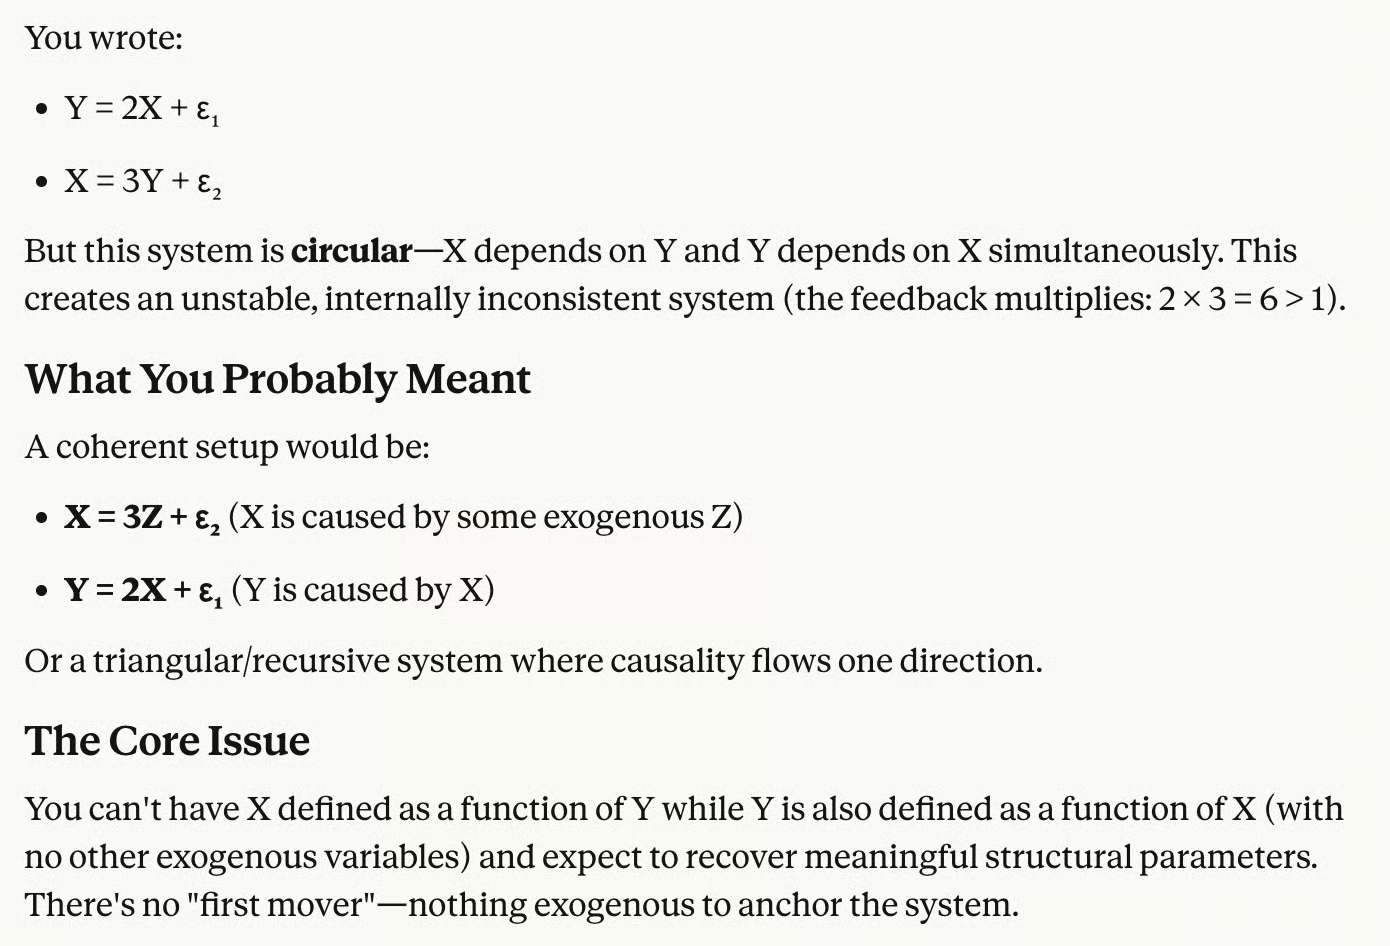
In dit geval was het model me ver vooruit. Opus 4.5 begreep dat mijn vraag circulair was - ik definieerde X via Y en omgekeerd, dus we konden geen zinvolle schatting voor de helling van een regressielijn halen uit wat we hadden.
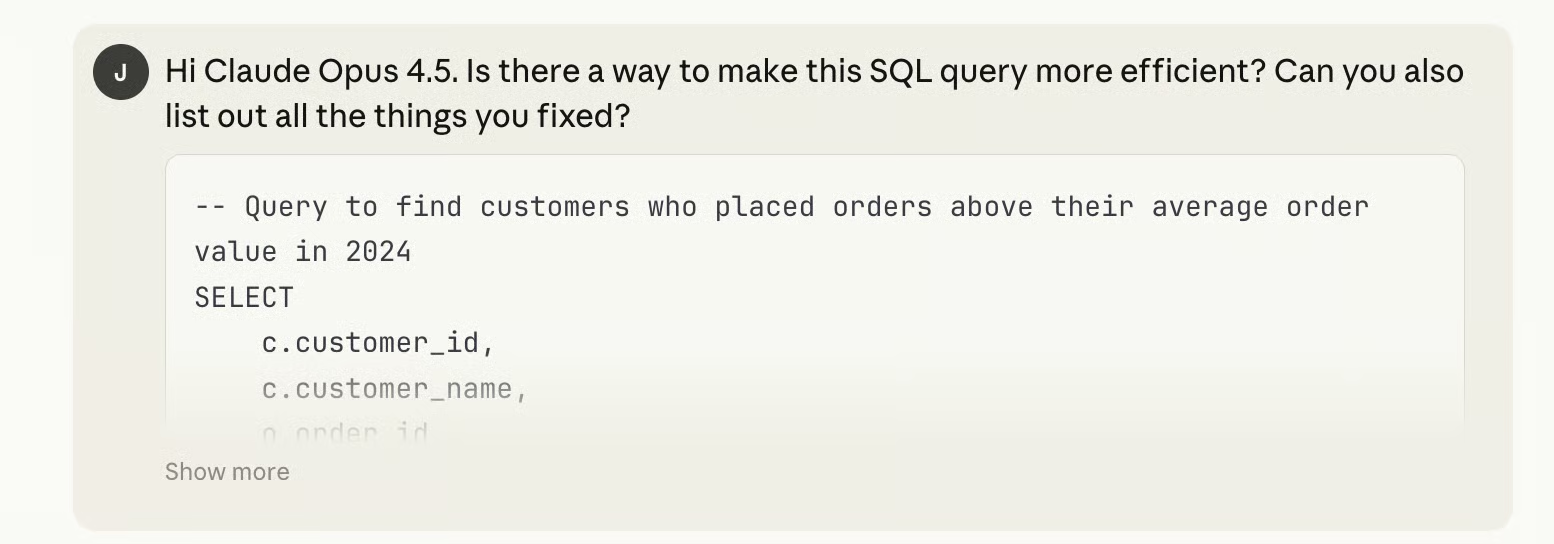
Tot slot leek het me leuk om Opus 4.5 te testen met een SQL-vraag. Ik stuurde een werkbare maar erg inefficiënte SQL-query.
-- Find customers who placed orders above their average order value in 2024
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > (
        SELECT AVG(o2.order_total)
        FROM orders o2
        WHERE o2.customer_id = c.customer_id
    )
    AND c.customer_id IN (
        SELECT DISTINCT o3.customer_id
        FROM orders o3
        WHERE o3.order_date >= '2024-01-01'
    )
    AND EXISTS (
        SELECT 1
        FROM customer_preferences cp
        WHERE cp.customer_id = c.customer_id
            AND cp.email_opt_in = 1
    )
ORDER BY (
    SELECT COUNT(*)
    FROM orders o4
    WHERE o4.customer_id = c.customer_id
) DESC;
Ik vroeg Opus 4.5 de query te verbeteren. Binnen ongeveer een seconde kreeg ik antwoord.
-- Find customers who placed orders above their average order value in 2024
WITH customer_avg AS (
    SELECT
        customer_id,
        AVG(order_total) AS avg_order_total,
        COUNT(*) AS order_count
    FROM orders
    GROUP BY customer_id
)
SELECT
    c.customer_id,
    c.customer_name,
    o.order_id,
    o.order_date,
    o.order_total
FROM customers c
JOIN orders o ON c.customer_id = o.customer_id
JOIN customer_avg ca ON c.customer_id = ca.customer_id
JOIN customer_preferences cp ON c.customer_id = cp.customer_id
WHERE o.order_date >= '2024-01-01'
    AND o.order_date < '2025-01-01'
    AND o.order_total > ca.avg_order_total
    AND cp.email_opt_in = 1
ORDER BY ca.order_count DESC;
Onder meer verving Opus 4.5 de gecorreleerde subquery voor AVG door een CTE. (De oorspronkelijke query herberekende AVG(order_total) voor elke rij die werd geëvalueerd, maar de CTE berekent nu voor elke klant één keer vooraf het gemiddelde.) Opus 4.5 verwijderde ook de overbodige IN (SELECT DISTINCT ...)-clausule, die onnodig extra werk deed. En het zette de EXISTS-subquery om naar een JOIN, wat beter is.
Er waren meer highlights in deze nieuwste release van Anthropic. Laten we ze in meer detail bekijken:
Anthropic heeft verschillende nieuwe bouwstenen voor ontwikkelaars toegevoegd. De meest opvallende is de effort-parameter, waarmee je kunt bepalen hoeveel denkwerk het model doet voordat het reageert. Zet ‘m laag voor snelle, lichte taken; zet ‘m hoger als je wilt dat het model ergens goed op kauwt.
Volgens Anthropic evenaart Opus 4.5 bij medium effort Sonnet 4.5’s beste SWE-benchscore met 76% minder outputtokens. Bij high effort verslaat het Sonnet met meer dan 4% — nog steeds met bijna de helft van het aantal tokens.
Er is ook verbeterd contextbeheer en geheugen. Voor agents die lang draaien kan Claude nu automatisch eerdere context samenvatten, zodat het niet halverwege een taak vastloopt. Dit gaat samen met contextcompactie, waardoor agents langer blijven draaien met minder ingrijpen.
Tot slot schijnt Opus 4.5 behoorlijk goed te zijn in multi-agent-orkestratie, wat betekent dat het een team van subagents kan aansturen.
Blijkbaar is Opus 4.5’s prestatie op een deep research-evaluatie met ongeveer 15% gestegen.
Ik heb de deep research-capaciteit zelf getest. Ik vroeg om een rapport over Oud-Engelse woorden die vandaag de dag nog bestaan maar niet veel worden gebruikt, en hoe dit soort woorden in de loop van de tijd is veranderd. Het rapport was in zeven minuten klaar:
Ik was eigenlijk behoorlijk onder de indruk van de kwaliteit van het rapport qua interessantheid, schrijfstijl, structuur en diepgang van het onderzoek.
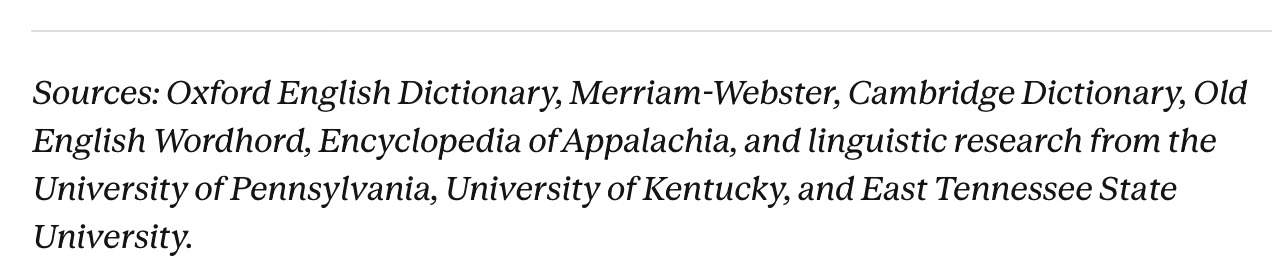
Het was geen volledig droog document dat te vol stond met archaïsche of verouderde woorden. Ik geef toe dat sommige secties beter hadden kunnen worden gedifferentieerd. Het midden van het rapport was wat saaier dan de rest. Maar — en hier gaat het om — het was extreem goed onderbouwd. Kijk maar naar deze verwijzingen:
Daarnaast leerde ik een erg mooi nieuw woord: apricity, wat de warmte van de winterzon betekent.
Anthropic heeft twee upgrades uitgebracht voor Claude Code.
Wat Plan Mode heet, bouwt nu nauwkeurigere plannen voordat het uitvoert. In de praktijk betekent dit dat Claude vooraf verduidelijkende vragen stelt en daarna een bewerkbaar plan.md-bestand genereert dat je kunt beoordelen en bijstellen voordat het begint. Het idee is om je te behoeden voor een valse start.
Desktopapp-integratie is de andere grote. Claude Code is nu beschikbaar in de desktopapp, wat betekent dat je meerdere lokale en externe sessies parallel kunt draaien. Om het voorbeeld van Anthropic zelf te gebruiken: één agent fixt bugs, een andere onderzoekt GitHub-issues en een derde werkt de documentatie bij.
Een paar agentische functies zijn geland in de consumentenapps van Claude:
Claude voor Chrome laat Claude taken afhandelen over je browsertabbladen heen. Het is nu beschikbaar voor alle Max-gebruikers. Zie het als een browse-agent die kan navigeren, klikken, formulieren invullen en informatie ophalen over meerdere sites.
Claude voor Excel brengt spreadsheetautomatisering naar Claude. Dit was eerder al aangekondigd, maar Anthropic heeft de beta-toegang nu uitgebreid naar alle Max-, Team- en Enterprise-gebruikers, dus het wordt steeds concreter.
Het afhandelen van lange gesprekken verhelpt wat een irritante beperking was. Voorheen liepen lange chats tegen een contextlimiet aan en stopten ze gewoon, waarna je een nieuw gesprek moest starten. Nu vat Claude eerdere delen van het gesprek automatisch op de achtergrond samen, waardoor er ruimte vrijkomt en je niet vastloopt.
Opus 4.5, net als de eerdere Claude-modellen, is getest op de gangbare benchmarks voor agentisch coderen, toolgebruik, computergebruik en probleemoplossing. Dit zijn de belangrijkste resultaten voor Opus 4.5.
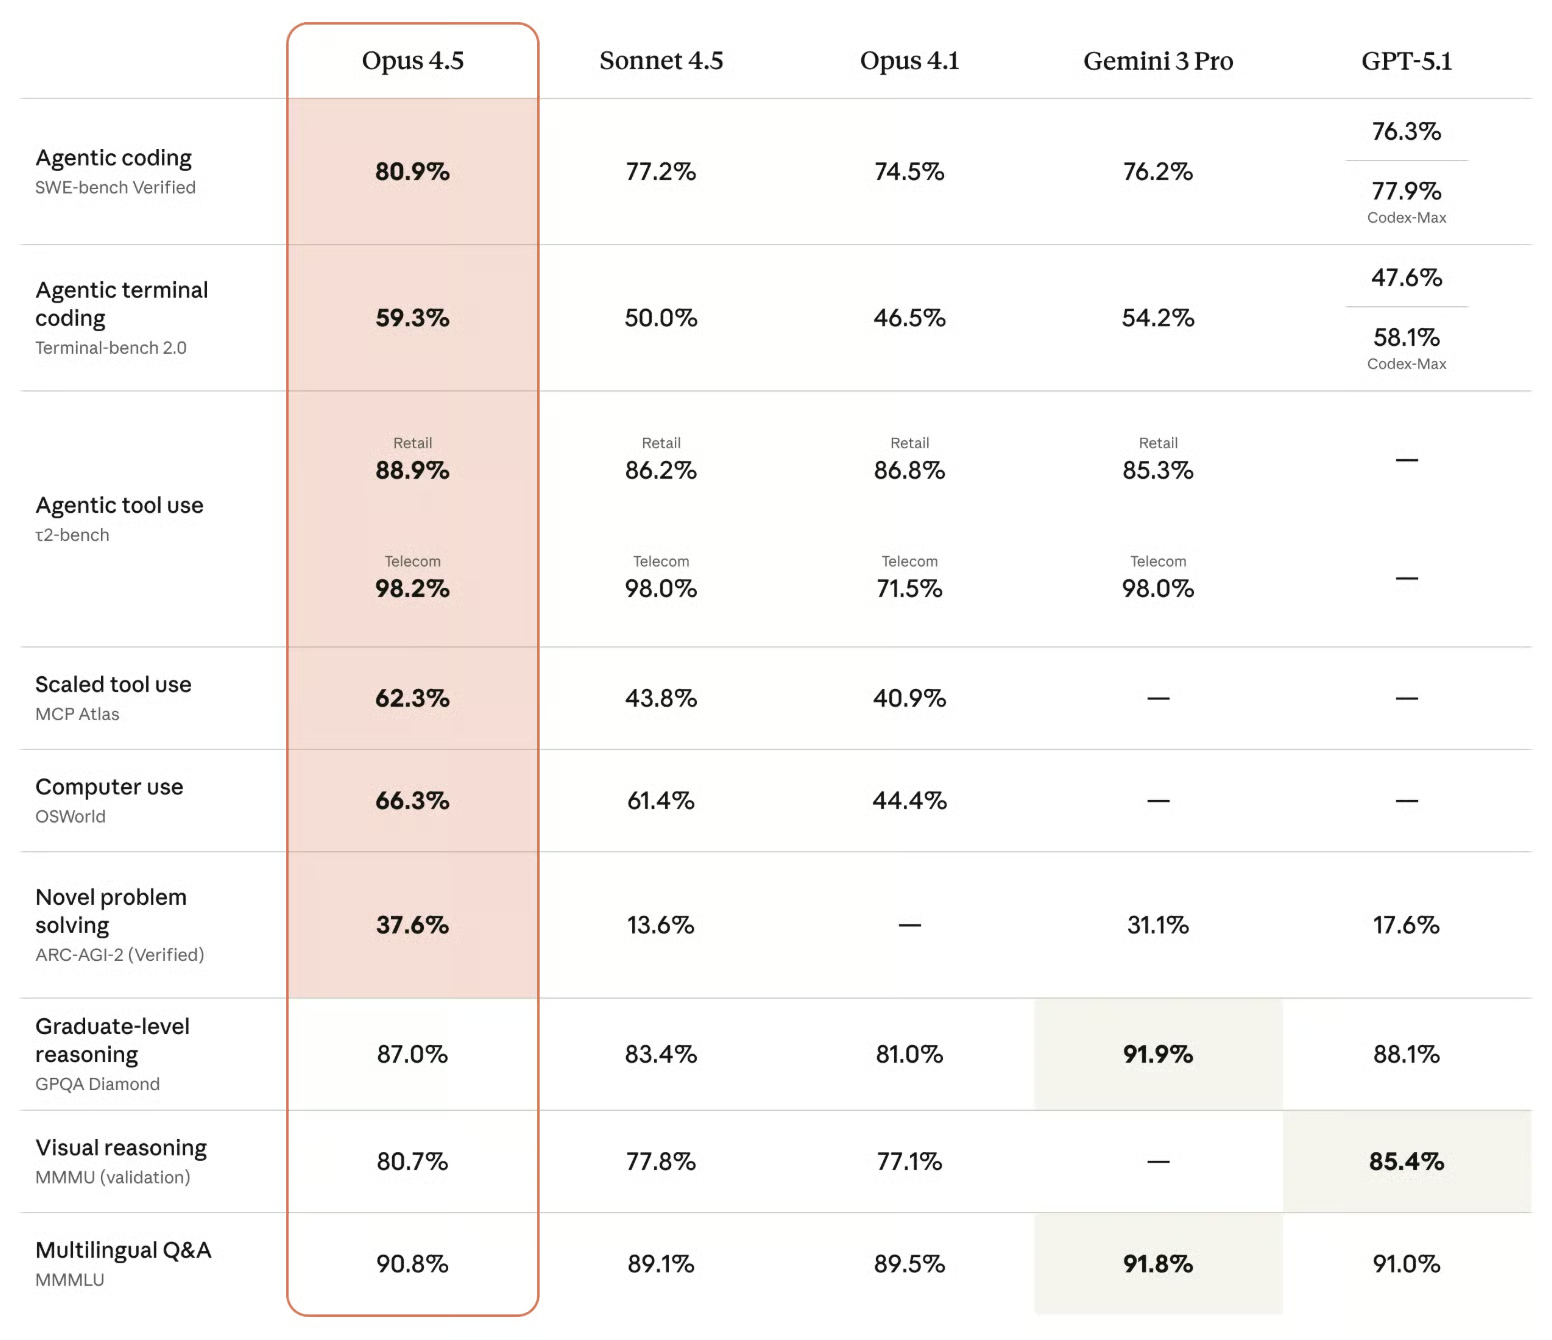
Opus 4.5 behaalt de toppositie in veel van de belangrijkste tests. Bij alles waarbij daadwerkelijk dingen gedaan moeten worden — zoals code schrijven die tests doorstaat (SWE-bench), tools gebruiken in meerstapsworkflows (τ2-bench, MCP Atlas) en een computer bedienen (OSWorld) — leidt Opus 4.5, vaak met ruime voorsprong.
Het verschil bij opgeschaald toolgebruik is zelfs erg groot: 62,3% vs. 43,8% voor de nummer twee, ook al is dat óók Claude! Dit laat echter zien hoeveel Anthropic investeert in het verbeteren van de prestaties, vooral bij agentische taken. Hoewel hun oudere model momenteel in sommige categorieën aan kop kan gaan, remt dat hun vooruitgang niet af.
Het lijkt erop dat Gemini 3 Pro de overhand heeft op sommige kennisintensieve benchmarks, zoals redeneren op graduate-niveau (GPQA Diamond) en meertalige Q&A (MMMLU). Deze benchmarks belonen waarschijnlijk de breedte van trainingsdata en zorgvuldig redeneren boven gememoriseerde feiten, en Google heeft natuurlijk veel middelen.
De verbeteringen van Anthropic gaan niet alleen over coderen, onderzoek en computergebruik. Er ligt ook sterk de nadruk op veiligheid: dit zou hun veiligste en ‘meest robuust uitgelijnde model’ tot nu toe zijn.
Die claim wordt onderbouwd door een verlaging van wat zij de ‘concerning behavior score’ noemen, die lager is dan bij de andere 4.5-modellen, evenals GPT-5.1 en Gemini 3 Pro. Anthropic heeft Opus 4.5 ook beter bestand gemaakt tegen promptinjection-aanvallen, die het model kunnen misleiden tot schadelijk gedrag.
Claude Opus 4.5 is per vandaag beschikbaar in het volledige productaanbod van Anthropic, waaronder de Claude-app, API en alle drie de grote cloudplatformen. Ontwikkelaars kunnen er direct bij via het model-ID claude-opus-4-5-20251101.
De prijs is ook merkbaar gedaald. Met $5 per miljoen inputtokens en $25 per miljoen outputtokens maakt Opus 4.5 Anthropics topcapaciteiten veel toegankelijker.
Voor enterprise-gebruikers kan deze prijswijziging extra betekenisvol zijn. De combinatie van lagere kosten, uitgebreidere API-toegang en bredere beschikbaarheid bij cloudproviders maakt Opus 4.5 tot een competitieve optie.
Claude Opus 4.5 is Anthropics duidelijkste statement tot nu toe over waar het zichzelf ziet in de AI-race. Terwijl Google inzet op multimodale begrip en on-device modellen, gokt Anthropic sterk op acties: agentisch coderen, toolgebruik en computergestuurde interactie.
De benchmarkresultaten vertellen eigenlijk het verhaal: Opus 4.5 behaalt de hoogste scores ooit op software-engineeringbenchmarks en handelt debugging over meerdere systemen af met weinig sturing.
Mijn testen bevestigen wat de benchmarks suggereren: Opus 4.5 is zeer capabel in meerstapswerk. Of het nu ging om het draaien van bootstrapsimulaties of het synthetiseren van onderzoek over papers heen, het model pakte problemen aan zoals een denker dat zou doen: adaptief en met helder redeneren. Als je je workflows wilt versterken, is dit wat telt.
Als je meer wilt leren over Claude-modellen, raad ik de cursus Introduction to Claude Models aan.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min



