

सामग्री की रोचकता, लेखन गुणवत्ता, संगठन, और शोध की गहराई के लिहाज़ से मैं रिपोर्ट की गुणवत्ता से काफ़ी प्रभावित हुआ।
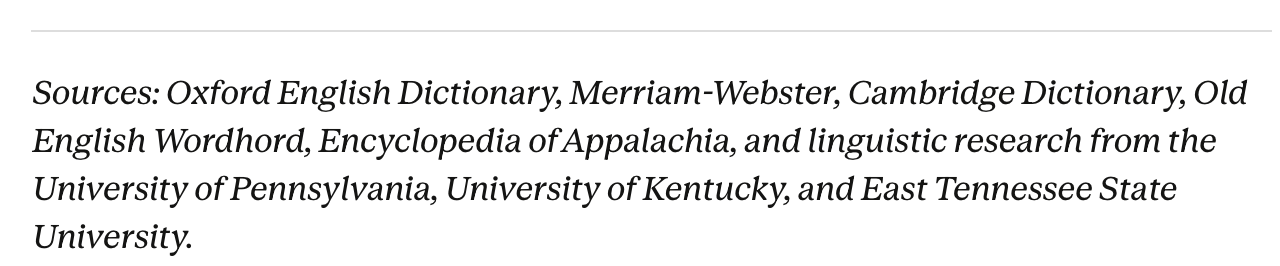
यह पूरी तरह सूखी, अत्यधिक पुरातन या अप्रचलित शब्दों से भरी डॉक्युमेंट नहीं थी। मानता हूँ कुछ हिस्से और बेहतर तरीके से अलगाए जा सकते थे। रिपोर्ट का मध्य भाग बाकी की तुलना में थोड़ा उबाऊ था। पर—और असली बात यही है—यह बेहद अच्छे से शोधित थी। इन संदर्भों पर नज़र डालिए:
साथ ही, मुझे एक बहुत अच्छा नया शब्द मिला: apricity, जिसका अर्थ है सर्दियों में सूरज की गर्माहट।
Claude Code
Anthropic ने Claude Code में दो अपग्रेड जारी किए हैं।
जिसे Plan Mode कहा जाता है, अब कार्यान्वयन से पहले और सटीक योजनाएँ बनाता है। व्यावहारिक रूप से, इसका मतलब है कि Claude शुरुआत में स्पष्टता वाले प्रश्न पूछता है, फिर एक संपादनयोग्य plan.md फ़ाइल जनरेट करता है जिसे आप इसके काम शुरू करने से पहले समीक्षा और संशोधित कर सकते हैं। विचार यह है कि आपको गलत शुरुआत से बचाया जाए।
डेस्कटॉप ऐप इंटीग्रेशन दूसरा बड़ा अपडेट है। Claude Code अब डेस्कटॉप ऐप में उपलब्ध है, यानी आप एक साथ कई लोकल और रिमोट सेशन्स चला सकते हैं। Anthropic के अपने उदाहरण से कहें तो: एक एजेंट बग्स ठीक करता है, दूसरा GitHub इश्यूज़ पर शोध करता है, और तीसरा डॉक्युमेंटेशन अपडेट करता है।
कंज़्यूमर ऐप एजेंट्स
Claude उपभोक्ता ऐप्स में कुछ एजेंटिक फीचर्स आए हैं:
Chrome के लिए Claude, आपके ब्राउज़र टैब्स के पार कार्यों को संभालने देता है। यह अब सभी Max उपयोगकर्ताओं के लिए उपलब्ध है। इसे एक ब्राउज़िंग एजेंट की तरह समझिए जो कई साइट्स पर नेविगेट कर सकता है, क्लिक कर सकता है, फॉर्म भर सकता है, और जानकारी एकत्र कर सकता है।
Excel के लिए Claude, स्प्रेडशीट ऑटोमेशन लाता है। इसकी घोषणा पहले हुई थी, पर अब Anthropic ने बीटा एक्सेस को सभी Max, Team, और Enterprise उपयोगकर्ताओं तक बढ़ा दिया है, इसलिए यह और वास्तविक हो रहा है।
लंबी बातचीत हैंडलिंग अब एक परेशान करने वाली सीमा को दुरुस्त करती है। पहले, लंबी चैट्स कॉन्टेक्स्ट सीमा पर आकर रुक जाती थीं और आपको नई बातचीत शुरू करनी पड़ती थी। अब Claude पृष्ठभूमि में बातचीत के पहले के हिस्सों का स्वतः सार बनाता है, जिससे जगह खाली होती है और आप दीवार से नहीं टकराते।
Claude Opus 4.5 बेंचमार्क परिणाम
Opus 4.5 को, पिछले Claude मॉडलों की तरह, एजेंटिक कोडिंग, टूल उपयोग, कंप्यूटर उपयोग, और समस्या-समाधान के सामान्य बेंचमार्क पर परखा गया। Opus 4.5 के बड़े परिणाम ये हैं।
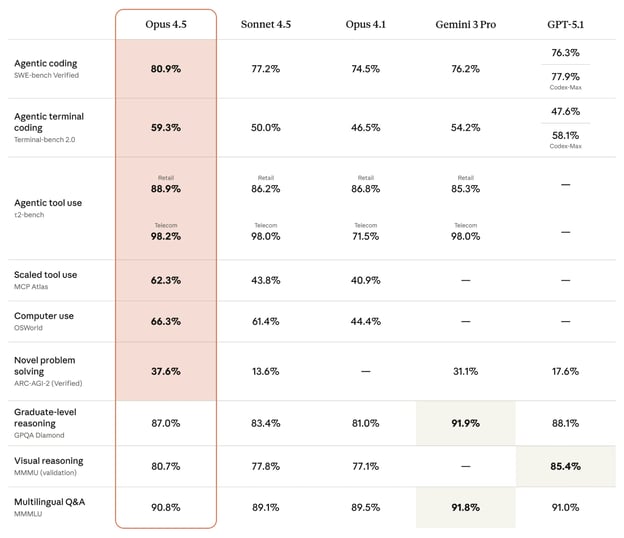
Opus 4.5 कई सबसे महत्वपूर्ण परीक्षणों में शीर्ष स्थान पाता है। वे सभी चीज़ें जिनमें वास्तव में काम करना शामिल है—जैसे ऐसा कोड लिखना जो टेस्ट पास करे (SWE-bench), बहु-चरणीय वर्कफ़्लोज़ में टूल्स का उपयोग (τ2-bench, MCP Atlas), और कंप्यूटर चलाना (OSWorld)—Opus 4.5 आगे है, अक्सर काफी अंतर से।
स्केल्ड टूल उपयोग का अंतर वाकई बड़ा है: 62.3% बनाम अगले सर्वश्रेष्ठ—जो कि Claude ही है—के 43.8%। हालांकि, यह दिखाता है कि Anthropic एजेंटिक कार्यों पर प्रदर्शन सुधारने में कितना निवेश कर रहा है। जबकि उनका पुराना मॉडल कुछ श्रेणियों में अब भी आगे हो सकता है, वे अपनी प्रगति धीमी नहीं करते।
ऐसा लगता है कि Gemini 3 Pro कुछ ज्ञान-गहन बेंचमार्क—जैसे स्नातकोत्तर-स्तरीय तर्क (GPQA Diamond) और बहुभाषी Q&A (MMMLU)—में बढ़त रखता है। ये बेंचमार्क शायद व्यापक प्रशिक्षण डेटा और रटे हुए तथ्यों से इतर सावधानीपूर्वक तर्क-वितर्क को पुरस्कृत करते हैं, और Google के पास, स्वाभाविक रूप से, बहुत संसाधन हैं।
सुरक्षा और एलाइन्मेंट में प्रगति
Anthropic के सुधार सिर्फ कोडिंग, शोध, और कंप्यूटर उपयोग तक सीमित नहीं हैं। सुरक्षा पर भी खास जोर है—दावा है कि यह अब तक जारी किया गया उनका सबसे सुरक्षित और ‘सबसे मज़बूती से एलाइन्ड मॉडल’ है।
यह दावा उनके तथाकथित ‘चिंताजनक व्यवहार स्कोर’ में कमी से समर्थित है, जो अन्य 4.5 मॉडलों, साथ ही GPT-5.1 और Gemini 3 Pro से कम है। Anthropic ने Opus 4.5 को prompt injection हमलों के विरुद्ध भी अधिक मज़बूत बनाया है, जो मॉडल को हानिकारक व्यवहार में फँसा सकते हैं।
Claude 4.5 Opus की कीमत और उपलब्धता
Claude Opus 4.5 आज Anthropic के पूरे उत्पाद लाइनअप—Claude ऐप, API, और तीनों प्रमुख क्लाउड प्लेटफॉर्म्स—में उपलब्ध है। डेवलपर्स इसे सीधे मॉडल ID claude-opus-4-5-20251101 के माध्यम से एक्सेस कर सकते हैं।
कीमत में भी उल्लेखनीय कमी आई है। प्रति मिलियन इनपुट टोकन $5 और प्रति मिलियन आउटपुट टोकन $25 पर, Opus 4.5, Anthropic की शीर्ष-स्तरीय क्षमताओं को कहीं अधिक सुलभ बनाता है।
एंटरप्राइज़ उपयोगकर्ताओं के लिए यह मूल्य परिवर्तन विशेष रूप से अहम हो सकता है। घटती लागत, विस्तारित API एक्सेस, और क्लाउड प्रदाताओं में व्यापक उपलब्धता का संयोजन Opus 4.5 को एक प्रतिस्पर्धी विकल्प बनाता है।
निष्कर्ष
Claude Opus 4.5, AI दौड़ में अपनी स्थिति को लेकर Anthropic का अब तक का सबसे स्पष्ट बयान है। जहाँ Google मल्टीमॉडल समझ और ऑन-डिवाइस मॉडलों पर जोर देता है, वहीं Anthropic ने एक्शन्स—एजेंटिक कोडिंग, टूल उपयोग, और कंप्यूटर इंटरेक्शन—पर बड़ा दांव लगाया है।
बेंचमार्क परिणाम पूरी कहानी कहते हैं: Opus 4.5 सॉफ्टवेयर इंजीनियरिंग बेंचमार्क्स पर अब तक के सर्वोच्च स्कोर पाता है और बहुत कम मार्गदर्शन में बहु-प्रणाली डिबगिंग संभालता है।
मेरे परीक्षण बेंचमार्क्स के संकेतों की पुष्टि करते हैं: Opus 4.5 बहु-चरणीय कार्यों में बेहद सक्षम है। चाहे बूटस्ट्रैप सिमुलेशन चलाना हो या कई शोधपत्रों के पार शोध का संश्लेषण करना—मॉडल ने समस्याओं को एक विचारक की तरह निपटाया: अनुकूल होकर और स्पष्ट तर्क के साथ। यदि आप अपने वर्कफ़्लोज़ को सशक्त बनाना चाहते हैं, तो अहम बात यही है।
यदि आप Claude मॉडलों के बारे में और जानना चाहते हैं, तो मैं कोर्स Introduction to Claude Models देखने की सलाह देता हूँ।
Claude Opus 4.5 FAQs
Claude Opus 4.5, Sonnet 4.5 और Haiku 4.5 से कैसे अलग है?
Opus 4.5 सबसे शक्तिशाली 모델 है, जो जटिल तर्क-वितर्क, कोडिंग, और लंबी अवधि के कार्यों के लिए बनाया गया है। Sonnet 4.5 प्रदर्शन और लागत का संतुलन रखता है, जबकि Haiku 4.5 गति और दक्षता के लिए अनुकूलित है।
मैं Claude Opus 4.5 कहाँ एक्सेस कर सकता/सकती हूँ?
यह Claude के वेब और मोबाइल ऐप्स, Claude API, और सभी प्रमुख क्लाउड प्लेटफॉर्म्स के माध्यम से उपलब्ध है, जिससे इसे विभिन्न वर्कफ़्लोज़ में एकीकृत करना आसान हो जाता है।
क्या Anthropic ने Claude की संदर्भ या मेमोरी क्षमताएँ बढ़ाई हैं?
हाँ। Opus 4.5 विस्तारित तर्क-वितर्क और बहु-चरणीय कार्यों के समर्थन के लिए मजबूत संदर्भ प्रबंधन, लंबी बातचीत हैंडलिंग, और बेहतर सार-संक्षेप पेश करता है।
Opus 4.5 किन सुरक्षा मानकों का पालन करता है?
यह Anthropic के सर्वोच्च सुरक्षा स्तर को पूरा करता है—एलाइन्मेंट में बड़े उन्नयन, कम “चिंताजनक व्यवहार” स्कोर, और prompt injection हमलों के प्रति अधिक प्रतिरोध के साथ।
Opus 4.5 किन उपयोग मामलों के लिए सबसे अधिक फायदेमंद है?
Opus 4.5 जटिल, बहु-चरणीय तर्क-वितर्क—जैसे डिबगिंग, शोध, और बहु-एजेंट orchestration—के लिए आदर्श है। सरल या तेज़ कार्यों के लिए, Sonnet या Haiku अधिक किफायती हो सकते हैं।

लेखक
Josef Waples
मैं एक डेटा साइंस संपादक हूँ और वैज्ञानिक पत्रिकाओं में प्रकाशित शोध लेखों में योगदान दे चुका/चुकी हूँ। मुझे विशेष रूप से रैखिक बीजगणित, सांख्यिकी, R, और इसी तरह के विषयों में रुचि है।

एआई और एडटेक क्षेत्र में सीनियर संपादक। डेटा और एआई रुझानों की पड़ताल के लिए प्रतिबद्ध।
Google के प्रभावशाली Gemini 3 रिलीज़ के तुरंत बाद, Anthropic ने हाल ही में Claude Opus 4.5 की घोषणा की, जिसे उन्होंने कोडिंग, एजेंट्स, और कंप्यूटर उपयोग के लिए ‘दुनिया का सबसे अच्छा मॉडल’ बताया है।
Gemini 3 के बेहद प्रभावशाली बेंचमार्क के बावजूद, यह SWE bench—जो सॉफ्टवेयर इंजीनियरिंग कौशल का परीक्षण है—पर फिर भी Claude Sonnet 4.5 से पीछे रहा। Claude Opus 4.5 के साथ, Anthropic ने SWE bench और अन्य परीक्षणों पर अपना ही स्कोर पीछे छोड़ दिया है।
Claude Opus 4.5, Anthropic का पिछले दो महीनों में तीसरा बड़ा मॉडल लॉन्च है, Sonnet 4.5 और Haiku 4.5 के बाद। और अब जब Anthropic का मूल्यांकन $350 बिलियन से ऊपर है, तो स्पष्ट है कि उनके पास इस गति से आगे बढ़ने के लिए संसाधन हैं।
इस लेख में, मैं Claude Opus 4.5 में नया क्या है, इस पर नज़र डालूंगा—बेंचमार्क, नए फीचर्स, और इसकी क्षमताओं का हाथों-हाथ परीक्षण।
Claude Opus 4.5 क्या है?
Claude Opus 4.5, Anthropic का नवीनतम बड़ा भाषा मॉडल है। Opus 4 के बाद आया यह Anthropic का सबसे उन्नत मॉडल है, जिसका फोकस कोडिंग, तर्क-वितर्क, और लंबी अवधि के कार्यों पर है। मॉडल SWE-bench पर 80.9% और Terminal-bench पर 59.3% स्कोर करता है।
Claude Opus 4.5 अब Anthropic के ऐप्स, API, और प्रमुख क्लाउड प्लेटफॉर्म्स पर उपलब्ध है।
Claude Opus 4.5 में नया क्या है?
घोषणा में, ये बातें सबसे ज्यादा ध्यान खींचती हैं:
मॉडल लॉन्च के साथ, Anthropic ने कई उत्पाद अपडेट भी घोषित किए हैं, जिन पर मैं नीचे विस्तार से चर्चा करूंगा। इनमें Chrome के लिए Claude—वह ब्राउज़र एक्सटेंशन जो Claude को टैब्स के पार एक्शन लेने देता है—और Claude for Excel शामिल हैं।
Claude Opus 4.5 का परीक्षण
बिना एक-दो परीक्षणों के कोई समीक्षा पूरी नहीं होती। देखते हैं कि नए सुधार विविध कार्यों को कैसे संभालते हैं:
अर्थशास्त्र के प्रश्न से Opus 4.5 का परीक्षण
सबसे पहले, मैंने देखना चाहा कि Opus 4.5 एक क्लासिक अर्थशास्त्र अनुकूलन समस्या को कैसे संभालता है। मैं एक लॉग-लिनियर मांग मॉडल की कल्पना कर रहा हूँ जो कीमत से बिकने वाली मात्रा का अनुमान लगाता है। यह वो चीज़ है जो आप अर्थमिति के कोर्स में देखते हैं, और यह वास्तव में उपयोगी भी है। यदि आपको अपनी डिमांड कर्व और अपनी लागतें पता हैं, तो आप वह कीमत निकाल सकते हैं जो राजस्व अधिकतम करती है।
Opus 4.5 ने मुझे सही उत्तर दिया, वह भी बिना ज्यादा सोचे-विचारे और एक ही बार में।
यह मुझे इसलिए प्रभावशाली लगा क्योंकि लगभग हर कंपनी जो कुछ भी बेचती है, उसके पास बिकने वाली मात्रा और कीमत का कुछ अंदाज़ा तो होता है, पर हर कंपनी के पास बुनियादी अनुकूलन समस्याओं के उत्तर निकालने के लिए संसाधन नहीं होते।
लेकिन यहाँ, एक अच्छे से रचे गए प्रॉम्प्ट के साथ, आप आसानी से अपना उत्तर पा सकते हैं। बेशक, यह अब भी विश्लेषक पर निर्भर करेगा कि क्या पर्याप्त बाधाएँ सही ढंग से मॉडल की गई हैं।
मुझे यह भी अच्छा लगा: Opus 4.5 ने अपना काम दिखाया। उसने सिर्फ एक संख्या नहीं दी, बल्कि व्युत्पन्न, फैक्टरिंग, और बीजगणित से गुजरा। यदि उससे गलती होती, तो मैं देख सकता था कि कहाँ हुई।
स्टैटिस्टिक्स प्रश्न से Opus 4.5 का परीक्षण
अगला, मैं Opus 4.5 को एक सांख्यिकी प्रश्न पर परखना चाहता था। मैंने एक डेटा सेट बनाया जहाँ
yieldशोर जोड़े जाने के साथtemperatureका एक फलन था।फिर मैंने Claude को यह प्रॉम्प्ट दिया।
Claude ने मुझे नीचे दिया गया उत्तर लौटाया, जिसका उपयोग मैंने नीचे दिखाए गए हिस्टोग्राम को बनाने में किया।
मुझे कहना होगा कि यह परिणाम मुझे पसंद आया। Opus 4.5 ने ढलान के लिए एक confidence interval निकाला, जो मैं दरअसल पूछ ही रहा था।
इसने बूटस्ट्रैप विधि का उपयोग किया, जो हेटेरोस्केडैस्टिसिटी मौजूद होने पर confidence interval निकालने की एक अच्छी तकनीक है। इसने विशेष रूप से residuals पर बूटस्ट्रैप का इस्तेमाल किया, न कि (X,Y) युग्मों को रिसैंपल करने वाली दूसरी बूटस्ट्रैप विधि का, जो X पद में त्रुटि मान लेती।
यह सब इस तरह के काम करने वालों के लिए एक सूक्ष्म परंतु महत्वपूर्ण बात है: जब X डिजाइन द्वारा नियत हो—जैसा कि मैंने अपने प्रॉम्प्ट में निर्दिष्ट किया—और जब आप ठीक उन्हीं X मानों पर सशर्त अनुमान लगाना चाहें, जैसे किसी वैज्ञानिक अध्ययन में, तब residual बूटस्ट्रैप बेहतर रहेगा। मेरा कहना यह है कि Opus 4.5 ने प्रॉम्प्ट की बारीकियों को समझा।
गणित के प्रश्न से Opus 4.5 का परीक्षण
अगला, मैं देखना चाहता था कि क्या मैं किसी तरह Opus 4.5 को उलझा सकता हूँ।
इस मामले में, मॉडल मुझसे बहुत आगे था। Opus 4.5 ने समझ लिया कि मेरा प्रश्न चक्रीय है—मैं X को Y से और Y को X से परिभाषित कर रहा था—इसलिए उपलब्ध जानकारी के साथ प्रतिगमन रेखा की ढलान का कोई सार्थक अनुमान निकालना संभव नहीं था।
SQL अनुकूलन के लिए Opus 4.5 का परीक्षण
अंत में, मैंने सोचा कि Opus 4.5 को एक SQL प्रश्न पर परखना मज़ेदार होगा। मैंने उसे एक कामचलाऊ मगर बेहद अक्षम SQL क्वेरी भेजी।
मैंने Opus 4.5 से क्वेरी बेहतर बनाने को कहा। उसने लगभग एक सेकंड में उत्तर दे दिया।
अन्य बातों के अलावा, Opus 4.5 ने
AVGके लिए संबद्ध सबक्वेरी को CTE से बदल दिया। (मूल क्वेरी में हर पंक्ति के लिएAVG(order_total)दोबारा-गिना जा रहा था, जबकि CTE अब हर ग्राहक का औसत एक बार पहले ही निकाल देता है।) Opus 4.5 ने अनावश्यकIN (SELECT DISTINCT ...)क्लॉज़ भी हटा दी, जो बिना वजह अतिरिक्त काम कर रही थी। और इसनेEXISTSसबक्वेरी कोJOINमें बदला, जो बेहतर है।Claude Opus 4.5 एजेंट्स और एजेंटिक क्षमताएँ
Anthropic के इस नवीनतम रिलीज़ में अन्य भी कई मुख्य आकर्षण हैं। विस्तार से देखते हैं:
डेवलपर प्लेटफ़ॉर्म फीचर्स
Anthropic ने डेवलपर्स के लिए कई नए बिल्डिंग ब्लॉक्स जोड़े हैं। सबसे उल्लेखनीय है effort पैरामीटर, जो आपको नियंत्रित करने देता है कि उत्तर देने से पहले मॉडल कितना सोचे। त्वरित, हल्के कार्यों के लिए इसे कम रखें; और जब मॉडल को किसी चीज़ पर अच्छी तरह विचार करना हो, तो इसे अधिक करें।
Anthropic के अनुसार, मध्यम effort पर, Opus 4.5 Sonnet 4.5 के सर्वश्रेष्ठ SWE-bench स्कोर के बराबर है, जबकि 76% कम आउटपुट टोकन उपयोग करता है। उच्च effort पर, यह Sonnet से 4% से अधिक बेहतर है—फिर भी लगभग आधे टोकन का उपयोग करते हुए।
संदर्भ प्रबंधन और मेमोरी में भी सुधार है। लंबे समय तक चलने वाले एजेंट्स के लिए, Claude अब स्वतः पहले के संदर्भ का सारांश बना सकता है ताकि कार्य के बीच में बाधा न आए। यह context compaction के साथ काम करता है, जो एजेंट्स को कम हस्तक्षेप के साथ अधिक समय तक चलाता है।
अंत में, Opus 4.5 बहु-एजेंट orchestration में काफी अच्छा माना जा रहा है—यानि यह उप-एजेंट्स की एक टीम का प्रबंधन कर सकता है।
Claude Opus 4.5 डीप रिसर्च
बताया गया है कि डीप रिसर्च मूल्यांकन पर Opus 4.5 का प्रदर्शन लगभग 15% बढ़ा है।
मैंने डीप रिसर्च क्षमता को अपने परीक्षण से परखा। मैंने इसे उन पुरानी अंग्रेज़ी शब्दों पर एक रिपोर्ट देने को कहा जो आज भी मौजूद हैं पर आमतौर पर इस्तेमाल नहीं होते, और समय के साथ ऐसे शब्द कैसे बदले हैं। रिपोर्ट सात मिनट में तैयार थी: