2026 年的大多数 AI 发布都在聊天与推理上卷向天花板,如 OpenAI 的 GPT-6 Astra、Anthropic 的 Fable 5.1。
TypeSafe 选择了另一条路。2026 年 9 月 15 日,这家公司发布了一款完全不生成文本的模型。
这款模型名为 Jev,归属于 TypeSafe 称之为System One 模型的全新 AI 模型类别。
Jev 不再逐 token 产出字符串,而是接收非结构化的程序状态作为输入,在一次并行计算中返回具备类型、带概率的决策。
TypeSafe 的核心宣称包括:在可比任务上,Jev 运行速度比前沿 LLM 快 40x-200x,输入百万 token 成本为 $0.042,输出免费,且在数学上不可能产生幻觉或类型错误。
本文将解释什么是 System One 模型、Jev 与标准 LLM 的差异、与其他模型的工作流基准对比结果,以及它在真实技术栈中的定位。
想深入了解与 Jev 对比的模型,请参阅我们的《Jev vs GPT-6 Astra》、《GPT-5.6 Terra vs Claude Sonnet 5》以及《Claude Opus 5 vs GPT-5.6 Sol》对比文章。也推荐查看我们的Jev 替代方案指南和Jev API 教程。
要点速览
- Jev 是 TypeSafe 的首个System One 模型:它返回带有校准概率的具类型决策,而非文本。
- 它不会产生幻觉或类型错误,因为有效输出在调用前由模式(schema)预先定义。
- 在 TypeSafe 的 4 个工作流基准上,准确率约 68%,接近 GPT-5.6 Terra 等中端 LLM,但成本低 40-400 倍、速度快 20-200 倍。
- 不适用于聊天、代码生成或任何需要书面解释的任务。
- Jev 适用于在共享状态上进行高频、重复、且答案空间可预先确定的决策。
什么是 System One 模型?
System One 模型是一类前沿 AI 模型,返回具类型的概率化决策,而非文本。
您提供一段状态与一组具类型的问题;它会并行评估这些问题,并返回带校准置信度的结构化答案,无需字符串生成,也无需解析。TypeSafe 在 2026 年 9 月首次公开发布 Jev 的同时提出了这一类别名称。
什么是 Jev?
Jev 是一款前沿模型,旨在做出可被软件直接消费的快速、结构化决策,无需额外的解析或校验步骤。
这是 TypeSafe System One 系列的首个公开版本,于 2026 年 9 月早期开放并行通道发布,名称来源于经济学家 William Stanley Jevons。
“System One/Two”的说法源自 Daniel Kahneman 的《思考,快与慢》。
Kahneman 的系统 1 快速直觉;系统 2 缓慢审慎。
现有 LLM 依赖思维链和数秒级的推理轨迹,更偏向系统 2。
TypeSafe 创始人 Diogo Almeida(曾在 OpenAI 共同发明 ChatGPT)认为,自动化之所以受限,是因为大家都在做系统 2 模型,而大多数软件决策其实需要系统 1 式的快速回答。
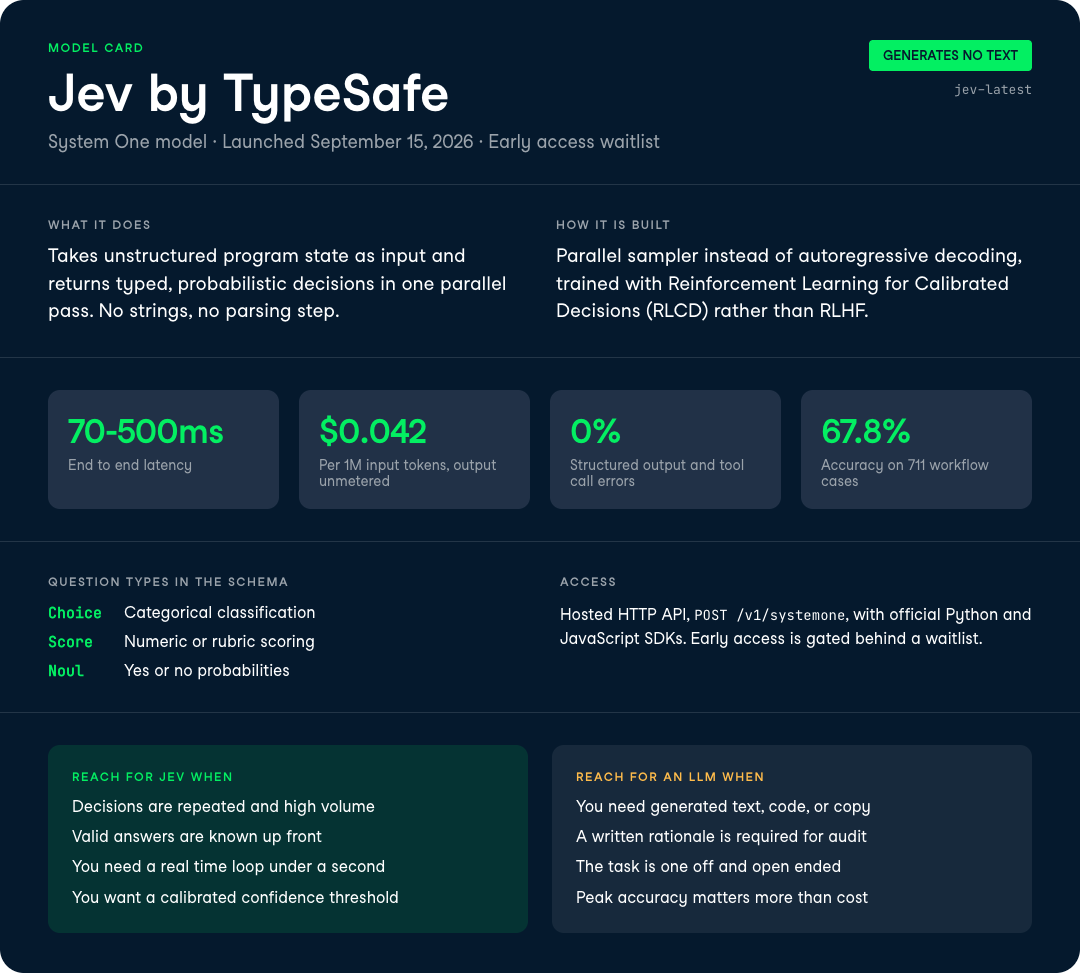
在架构上,Jev 与Transformer 类的 LLM 大相径庭。
它采用全新的模型架构,通过并行采样在一次查询中生成全部输出,而非自回归地逐 token 输出;训练方法为 TypeSafe 称作用于校准决策的强化学习(RLCD)。
当 GPT-5.6 与 Opus 5 通过RLHF 和可验证奖励来生成更受人类偏好的文本时,RLCD 则针对结构化决策的概率校准进行优化。
按 TypeSafe 的数据,结果是结构化输出错误率 0%,端到端时延 70-500ms。
关于 RLCD 的一点补充:TypeSafe 将其与 RLHF、RLVR 直接对位。RLHF 优化人类评审更偏好的聊天回复,RLVR 优化可由程序验证的输出,RLCD 则优化决策任务中具认识论诚实性的概率。这就是为什么校准是 Jev 的一等公民属性,而不是通过提示词“外接”的功能。
Jev 与标准 LLM 一览对比
用一张表概括核心的架构差异,避免在文字中被淹没。
| 属性 | 前沿 LLM(GPT-5.6、Opus 5) | Jev(System One 模型) |
|---|
| 输出 | 生成字符串,需解析 | 具类型的值,由模式保证 |
| 采样 | 顺序,逐 token | 并行,单次查询 |
| 输入价格 / 百万 token | $0.20-$10 | $0.042 |
| 输出价格 | 约为输入的 5 倍 | 免费 |
| 时延 | 3-329s | 70-500ms |
| 幻觉 / 类型错误 | 可能发生 | 在设计上不可能 |
| 置信度 | 过度自信且不一致 | 按输出逐项校准 |
Jev 关键特性
这些特性均源于一个设计取舍:Jev 完全放弃了字符串生成。
正是这项“减法”,带来了速度、价格与类型保障。
以具类型决策替代文本
Jev 返回类型安全的结构化值,所有可能输出都在调用前由您的模式定义。
API 暴露了一小组问题类型:
- Choice:用于类别分类
- Score:用于数值或量表评分
- Noul:用于是/否概率
可将其理解为前沿智能的函数调用:非结构化状态入,具类型的概率化决策出。
例如对工单进行路由,您可定义一个 Choice({billing, technical, sales, spam})和一个 0-100 的紧急程度 Score,Jev 在一次通过中同时给出两项结果。无需解析 JSON,也无需担心模型“跑题”写一大段话。
显而易见的前提是:只有在有效答案空间事先有界且已知时才适用。Jev 不适合开放式生成,也不会替您编写模式。
每个输出都具备校准置信度
每个 Jev 输出都会附带一个校准概率,意味着更高置信度真实对应更高准确率。
这可能是实践中最有用的特性。
标准 LLM 即便显式要求给出概率,也常常过度自信。
如果一个模型平均能以 95% 的准确率完成分类,却无法指出余下 5% 哪些它不确定,您就无法安全地围绕它做自动化。
Jev 的校准允许您设定置信度阈值,仅对高于阈值的结果自动执行,将不确定案例路由给人工或更慢的 LLM。
需要注意的限制是:Jev 只给您一个数字,而非理由。
它不会用自然语言解释为何给出该评分,这在调试或受监管领域的审计中尤为重要。
无幻觉、无类型错误
由于 Jev 的输出受模式约束,它在数学上不可能产生无效值或类型错误。
TypeSafe 报告结构化输出错误率 0%、工具调用错误率 0%。
对比来看,在 TypeSafe 的结构化输出测试中,OpenAI 的 luna 与 terra 为 0.58%,Anthropic 的 Opus 5 为 5.73%,Claude Haiku 4.5 达到 45.5%。
在工具调用上,GPT-5.6 Sol 最差,为 17.0%。
互动式代理中的幻觉式工具调用也许只是烦人,但在多层依赖链且有时延保障的场景中则是实打实的问题。
并行采样实现实时速度
Jev 在一次并行查询中生成全部输出,而不是逐 token 发出。
这带来了 70-500ms 的时延。
这种速度拓展了逐 token LLM 无法覆盖的用例。
TypeSafe 的演示让 Jev 通过结构化的游戏状态(以文本提供)来玩 Doom,每秒反应约 10 次,推理成本约 $7/小时。
重点不在于 Jev 玩得有多好(脚本化机器人会更强),而在于它能在实时循环里做出反应式决策,而 3-30 秒的 LLM 调用在此类场景下根本行不通。
在大数据上做映射
Jev 单案例约 $0.0004 的成本,使得对大型数据集的每一行运行一次决策成为可能——这对前沿 LLM 来说成本高得难以承受。
TypeSafe 将此定位为通过 map-reduce 式的决策,把 PB 级原始数据转化为特征与洞见。
一个具体示例是:为一张 5,000 万行的商品评价表逐条打分(情感与政策违规)。按报告费率,使用 Jev 的决策调用成本约为 $20,而按 token 计费的 LLM 则要数千美元。
Jev 的基准表现如何?
简而言之,Jev 的准确率大致落在中端前沿 LLM 的区间,同时在成本与时延上以一到两个数量级领先。
以下数据均来自 TypeSafe 自身的评测表,目前尚无大规模独立复现,需视为厂商披露。
生产工作流上的决策准确率
TypeSafe 构建了覆盖 4 个工作流的定制评测(安全事件响应、代理追踪可观测性、发票处理、客户服务),以 GPT-6 Astra 与 Anthropic Fable 的平均预测为参照来对各模型评分。
Jev 的平均一致率为 67.8%。
与相同工作流上的前沿 LLM 对比如下:
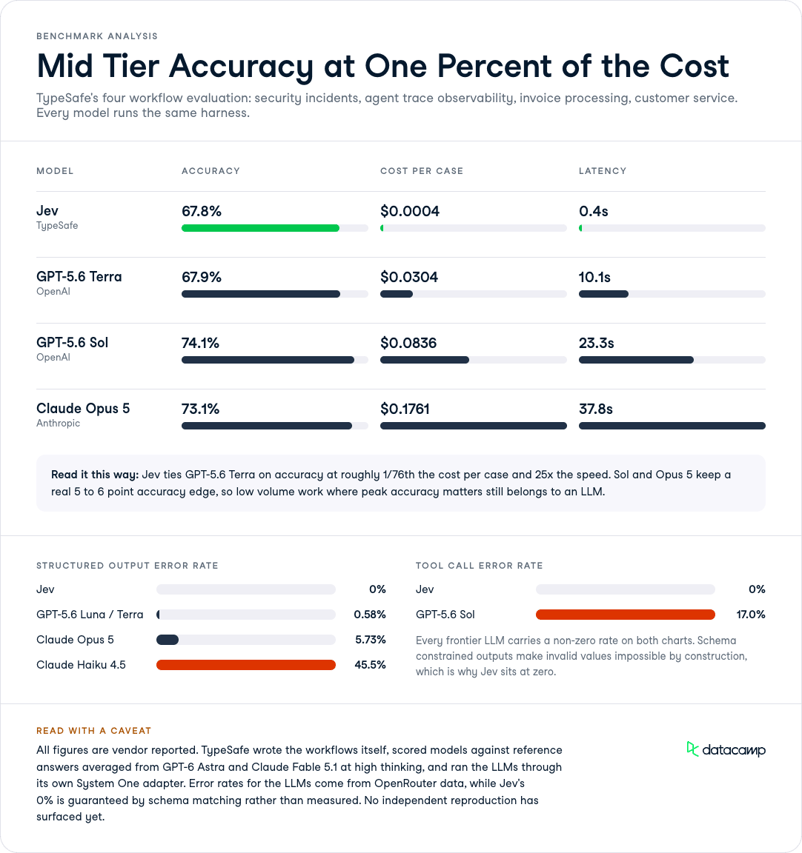
整体模式一致:Jev 以略低于最强模型的准确率,换取巨大成本与时延优势。
| 模型 | 准确率 | 单案例成本 | 时延 |
|---|
| Jev(TypeSafe) | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3s |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8s |
Jev 与 Terra 在准确率上基本持平,但单案例成本约为其 1/76,速度快 25 倍。
顶级准确率的 Sol(74.1%)与 Opus 5(73.1%)仍有 5-6 个百分点优势,因此若低量任务需要极致准确率,LLM 仍占优。
结构化输出与工具调用的可靠性
在可靠性图表中,Jev 的结构化输出与工具调用错误率均为 0%,这正是模式约束设计的意义所在。
各前沿 LLM 在此维度都存在非零故障率。
两个数字尤为显眼:Claude Haiku 4.5 的结构化输出错误率为 45.5%,GPT-5.6 Sol 的工具调用错误率为 17.0%。
这些并非冷门边缘案例,而是会在无人值守的流水线上,一旦规模化即刻“爆雷”的问题。
可解释性与审计的限制
Jev 返回的是概率,而非自然语言理由。评审者普遍指出这在调试与受监管领域的审计中是个现实约束。
如果合规团队需要知道贷款申请为何得到该评分,仅有一个置信度数字并不能满足要求。
务实做法是把 Jev 用作高吞吐的路由层,把被标记或低置信度的案例升级给能产出书面解释的模型。
这样既保留吞吐优势,也在法律要求的地方保留了可审计轨迹。
哪些数字需要保留态度
TypeSafe 对其自家评测的偏差来源给出了相对坦诚的说明。
工作流由其模型能力团队编写,可能存在偏差;而参照答案来自 OpenAI 与 Anthropic 的模型,可能低估了 Jev 以及 DeepSeek 模型的相对表现。
这些测试中的 LLM 通过 TypeSafe 的开源 System One 适配器运行,被迫输出与 API 兼容的结构化决策。
TypeSafe 表示,这是从 LLM 获取决策的最准确方式,但比不带概率的自由回答更慢也更贵。
在有中立测评基准复现之前,我会将当前的“准确率大致持平”视为积极信号,但尚未尘埃落定。
Jev vs 前沿 LLM:各自的用武之地
Jev 并非与 GPT-5.6 或 Opus 5 争抢同一类工作;更有用的问题是:何时该选哪一类模型。
分野在于任务需要的是有界决策,还是开放式回答。
- 当决策重复、高频,且可能答案在事先可知的范围内,请选用 Jev 等 System One 模型。
- 当您需要生成文本、代码、书面理由,或一次性的复杂推理,请选用前沿 LLM。
| 用例 | 应选 | 原因 |
|---|
| 对数百万工单进行分类或路由 | Jev | 输出有界,成本与吞吐占优 |
| 大规模对 LLM 输出打分或加护栏 | Jev | 快速的是/否概率,无幻觉风险 |
| 应用循环内的实时决策 | Jev | 70-500ms 时延 vs LLM 的 3-30s |
| 撰写代码、邮件或摘要 | 前沿 LLM | Jev 完全不生成文本 |
| 一次性多步推理并需解释 | 前沿 LLM | 需要理由与开放式输出 |
在实践中,两者相辅相成:用 Jev 作为快速决策层进行分类、评分与路由,再把那小部分困难或开放式案例交给 Terra 或 Opus 5 等模型。Jev 的校准能力让这一交接更干净,因为您可以按置信度阈值路由。
Jev 的定价与可用性
Jev 在定价上相当激进。
输入 token 每百万 $0.042(每十亿 $42),输出 token 不计量、免费;TypeSafe 的说法是,由于模型返回的是结构化决策而非长文本,输出“低到无需计量”。
参照来看,该输入费率约为 GPT-5.6 Terra 的 $2.00/百万 的 1/48,且 Terra 还需额外支付 $12.00/百万 的输出费用。
在工作流层面,TypeSafe 的内部评测给出 Jev 单案例约 $0.0004,而 Terra 为 $0.0304、Sol 为 $0.0836。
TypeSafe 直言无法证明该定价未被补贴,并表示可持续性有待长期检验,但预期价格将下行而非上行。
截至 2026 年 9 月 15 日,Jev 处于早期访问阶段,通过候补名单逐步放量。我未在发布材料中看到明确的免费额度或试用计划。
如何获取 Jev 的访问权限?
Jev 是一款专有、托管的模型,通过 TypeSafe 的 HTTP API 访问。不过,要获取访问权限,您需要加入候补名单,并在 TypeSafe AI 博客关注社区动态。
接口为 POST https://api.typesafe.ai/v1/systemone,早期访问的模型路由为 jev-latest。
TypeSafe 提供 Python 与 JavaScript 官方 SDK 以及原生 HTTP API。
您在模式中定义问题类型(Choice、Score、Noul),将程序状态作为输入传入;响应会以具类型的值与校准概率返回。
以下为无服务器路由的最小请求结构:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())技术支持
完整的模式参考与 SDK 设置,请以 TypeSafe 的官方文档为准。
结语
TypeSafe 正在押注一个判断:许多当下交给 LLM 的任务,本质上是被“聊天”外衣包裹的结构化决策。
若此判断成立,Jev 在成本上 40-400 倍的优势与 0% 类型错误保障,将以 GPT-5.6、Opus 5 难以在价格上匹敌的方式,重塑高频自动化的经济性。
我的直观结论是:Jev 作为快速决策与护栏层确有实用价值,而“校准”是我会围绕其构建系统的核心。
悬而未决的问题是:是否有独立基准能确认其准确率对标,以及价格在补贴退出后能否维持。
若您想理解 Jev 所面向的决策问题,我们的AI Fundamentals 技能路径涵盖其背后的分类与校准概念。


2026 年的大多数 AI 发布都在聊天与推理上卷向天花板,如 OpenAI 的 GPT-6 Astra、Anthropic 的 Fable 5.1。
TypeSafe 选择了另一条路。2026 年 9 月 15 日,这家公司发布了一款完全不生成文本的模型。
这款模型名为 Jev,归属于 TypeSafe 称之为System One 模型的全新 AI 模型类别。
Jev 不再逐 token 产出字符串,而是接收非结构化的程序状态作为输入,在一次并行计算中返回具备类型、带概率的决策。
TypeSafe 的核心宣称包括:在可比任务上,Jev 运行速度比前沿 LLM 快 40x-200x,输入百万 token 成本为 $0.042,输出免费,且在数学上不可能产生幻觉或类型错误。
本文将解释什么是 System One 模型、Jev 与标准 LLM 的差异、与其他模型的工作流基准对比结果,以及它在真实技术栈中的定位。
想深入了解与 Jev 对比的模型,请参阅我们的《Jev vs GPT-6 Astra》、《GPT-5.6 Terra vs Claude Sonnet 5》以及《Claude Opus 5 vs GPT-5.6 Sol》对比文章。也推荐查看我们的Jev 替代方案指南和Jev API 教程。
要点速览
什么是 System One 模型?
System One 模型是一类前沿 AI 模型,返回具类型的概率化决策,而非文本。
您提供一段状态与一组具类型的问题;它会并行评估这些问题,并返回带校准置信度的结构化答案,无需字符串生成,也无需解析。TypeSafe 在 2026 年 9 月首次公开发布 Jev 的同时提出了这一类别名称。
什么是 Jev?
Jev 是一款前沿模型,旨在做出可被软件直接消费的快速、结构化决策,无需额外的解析或校验步骤。
这是 TypeSafe System One 系列的首个公开版本,于 2026 年 9 月早期开放并行通道发布,名称来源于经济学家 William Stanley Jevons。
“System One/Two”的说法源自 Daniel Kahneman 的《思考,快与慢》。
Kahneman 的系统 1 快速直觉;系统 2 缓慢审慎。
现有 LLM 依赖思维链和数秒级的推理轨迹,更偏向系统 2。
TypeSafe 创始人 Diogo Almeida(曾在 OpenAI 共同发明 ChatGPT)认为,自动化之所以受限,是因为大家都在做系统 2 模型,而大多数软件决策其实需要系统 1 式的快速回答。
在架构上,Jev 与Transformer 类的 LLM 大相径庭。
它采用全新的模型架构,通过并行采样在一次查询中生成全部输出,而非自回归地逐 token 输出;训练方法为 TypeSafe 称作用于校准决策的强化学习(RLCD)。
当 GPT-5.6 与 Opus 5 通过RLHF 和可验证奖励来生成更受人类偏好的文本时,RLCD 则针对结构化决策的概率校准进行优化。
按 TypeSafe 的数据,结果是结构化输出错误率 0%,端到端时延 70-500ms。
关于 RLCD 的一点补充:TypeSafe 将其与 RLHF、RLVR 直接对位。RLHF 优化人类评审更偏好的聊天回复,RLVR 优化可由程序验证的输出,RLCD 则优化决策任务中具认识论诚实性的概率。这就是为什么校准是 Jev 的一等公民属性,而不是通过提示词“外接”的功能。
Jev 与标准 LLM 一览对比
用一张表概括核心的架构差异,避免在文字中被淹没。
Jev 关键特性
这些特性均源于一个设计取舍:Jev 完全放弃了字符串生成。
正是这项“减法”,带来了速度、价格与类型保障。
以具类型决策替代文本
Jev 返回类型安全的结构化值,所有可能输出都在调用前由您的模式定义。
API 暴露了一小组问题类型:
可将其理解为前沿智能的函数调用:非结构化状态入,具类型的概率化决策出。
例如对工单进行路由,您可定义一个 Choice({billing, technical, sales, spam})和一个 0-100 的紧急程度 Score,Jev 在一次通过中同时给出两项结果。无需解析 JSON,也无需担心模型“跑题”写一大段话。
显而易见的前提是:只有在有效答案空间事先有界且已知时才适用。Jev 不适合开放式生成,也不会替您编写模式。
每个输出都具备校准置信度
每个 Jev 输出都会附带一个校准概率,意味着更高置信度真实对应更高准确率。
这可能是实践中最有用的特性。
标准 LLM 即便显式要求给出概率,也常常过度自信。
如果一个模型平均能以 95% 的准确率完成分类,却无法指出余下 5% 哪些它不确定,您就无法安全地围绕它做自动化。
Jev 的校准允许您设定置信度阈值,仅对高于阈值的结果自动执行,将不确定案例路由给人工或更慢的 LLM。
需要注意的限制是:Jev 只给您一个数字,而非理由。
它不会用自然语言解释为何给出该评分,这在调试或受监管领域的审计中尤为重要。
无幻觉、无类型错误
由于 Jev 的输出受模式约束,它在数学上不可能产生无效值或类型错误。
TypeSafe 报告结构化输出错误率 0%、工具调用错误率 0%。
对比来看,在 TypeSafe 的结构化输出测试中,OpenAI 的 luna 与 terra 为 0.58%,Anthropic 的 Opus 5 为 5.73%,Claude Haiku 4.5 达到 45.5%。
在工具调用上,GPT-5.6 Sol 最差,为 17.0%。
互动式代理中的幻觉式工具调用也许只是烦人,但在多层依赖链且有时延保障的场景中则是实打实的问题。
并行采样实现实时速度
Jev 在一次并行查询中生成全部输出,而不是逐 token 发出。
这带来了 70-500ms 的时延。
这种速度拓展了逐 token LLM 无法覆盖的用例。
TypeSafe 的演示让 Jev 通过结构化的游戏状态(以文本提供)来玩 Doom,每秒反应约 10 次,推理成本约 $7/小时。
重点不在于 Jev 玩得有多好(脚本化机器人会更强),而在于它能在实时循环里做出反应式决策,而 3-30 秒的 LLM 调用在此类场景下根本行不通。
在大数据上做映射
Jev 单案例约 $0.0004 的成本,使得对大型数据集的每一行运行一次决策成为可能——这对前沿 LLM 来说成本高得难以承受。
TypeSafe 将此定位为通过 map-reduce 式的决策,把 PB 级原始数据转化为特征与洞见。
一个具体示例是:为一张 5,000 万行的商品评价表逐条打分(情感与政策违规)。按报告费率,使用 Jev 的决策调用成本约为 $20,而按 token 计费的 LLM 则要数千美元。
Jev 的基准表现如何?
简而言之,Jev 的准确率大致落在中端前沿 LLM 的区间,同时在成本与时延上以一到两个数量级领先。
以下数据均来自 TypeSafe 自身的评测表,目前尚无大规模独立复现,需视为厂商披露。
生产工作流上的决策准确率
TypeSafe 构建了覆盖 4 个工作流的定制评测(安全事件响应、代理追踪可观测性、发票处理、客户服务),以 GPT-6 Astra 与 Anthropic Fable 的平均预测为参照来对各模型评分。
Jev 的平均一致率为 67.8%。
与相同工作流上的前沿 LLM 对比如下:
整体模式一致:Jev 以略低于最强模型的准确率,换取巨大成本与时延优势。
Jev 与 Terra 在准确率上基本持平,但单案例成本约为其 1/76,速度快 25 倍。
顶级准确率的 Sol(74.1%)与 Opus 5(73.1%)仍有 5-6 个百分点优势,因此若低量任务需要极致准确率,LLM 仍占优。
结构化输出与工具调用的可靠性
在可靠性图表中,Jev 的结构化输出与工具调用错误率均为 0%,这正是模式约束设计的意义所在。
各前沿 LLM 在此维度都存在非零故障率。
两个数字尤为显眼:Claude Haiku 4.5 的结构化输出错误率为 45.5%,GPT-5.6 Sol 的工具调用错误率为 17.0%。
这些并非冷门边缘案例,而是会在无人值守的流水线上,一旦规模化即刻“爆雷”的问题。
可解释性与审计的限制
Jev 返回的是概率,而非自然语言理由。评审者普遍指出这在调试与受监管领域的审计中是个现实约束。
如果合规团队需要知道贷款申请为何得到该评分,仅有一个置信度数字并不能满足要求。
务实做法是把 Jev 用作高吞吐的路由层,把被标记或低置信度的案例升级给能产出书面解释的模型。
这样既保留吞吐优势,也在法律要求的地方保留了可审计轨迹。
哪些数字需要保留态度
TypeSafe 对其自家评测的偏差来源给出了相对坦诚的说明。
工作流由其模型能力团队编写,可能存在偏差;而参照答案来自 OpenAI 与 Anthropic 的模型,可能低估了 Jev 以及 DeepSeek 模型的相对表现。
这些测试中的 LLM 通过 TypeSafe 的开源 System One 适配器运行,被迫输出与 API 兼容的结构化决策。
TypeSafe 表示,这是从 LLM 获取决策的最准确方式,但比不带概率的自由回答更慢也更贵。
在有中立测评基准复现之前,我会将当前的“准确率大致持平”视为积极信号,但尚未尘埃落定。
Jev vs 前沿 LLM:各自的用武之地
Jev 并非与 GPT-5.6 或 Opus 5 争抢同一类工作;更有用的问题是:何时该选哪一类模型。
分野在于任务需要的是有界决策,还是开放式回答。
在实践中,两者相辅相成:用 Jev 作为快速决策层进行分类、评分与路由,再把那小部分困难或开放式案例交给 Terra 或 Opus 5 等模型。Jev 的校准能力让这一交接更干净,因为您可以按置信度阈值路由。
Jev 的定价与可用性
Jev 在定价上相当激进。
输入 token 每百万 $0.042(每十亿 $42),输出 token 不计量、免费;TypeSafe 的说法是,由于模型返回的是结构化决策而非长文本,输出“低到无需计量”。
参照来看,该输入费率约为 GPT-5.6 Terra 的 $2.00/百万 的 1/48,且 Terra 还需额外支付 $12.00/百万 的输出费用。
在工作流层面,TypeSafe 的内部评测给出 Jev 单案例约 $0.0004,而 Terra 为 $0.0304、Sol 为 $0.0836。
TypeSafe 直言无法证明该定价未被补贴,并表示可持续性有待长期检验,但预期价格将下行而非上行。
截至 2026 年 9 月 15 日,Jev 处于早期访问阶段,通过候补名单逐步放量。我未在发布材料中看到明确的免费额度或试用计划。
如何获取 Jev 的访问权限?
Jev 是一款专有、托管的模型,通过 TypeSafe 的 HTTP API 访问。不过,要获取访问权限,您需要加入候补名单,并在 TypeSafe AI 博客关注社区动态。
接口为
POST https://api.typesafe.ai/v1/systemone,早期访问的模型路由为jev-latest。TypeSafe 提供 Python 与 JavaScript 官方 SDK 以及原生 HTTP API。
您在模式中定义问题类型(Choice、Score、Noul),将程序状态作为输入传入;响应会以具类型的值与校准概率返回。
以下为无服务器路由的最小请求结构:
完整的模式参考与 SDK 设置,请以 TypeSafe 的官方文档为准。
结语
TypeSafe 正在押注一个判断:许多当下交给 LLM 的任务,本质上是被“聊天”外衣包裹的结构化决策。
若此判断成立,Jev 在成本上 40-400 倍的优势与 0% 类型错误保障,将以 GPT-5.6、Opus 5 难以在价格上匹敌的方式,重塑高频自动化的经济性。
我的直观结论是:Jev 作为快速决策与护栏层确有实用价值,而“校准”是我会围绕其构建系统的核心。
悬而未决的问题是:是否有独立基准能确认其准确率对标,以及价格在补贴退出后能否维持。
若您想理解 Jev 所面向的决策问题,我们的AI Fundamentals 技能路径涵盖其背后的分类与校准概念。