
Last chance! 50% off DataCamp Premium
Sale ends in

scale() 对数据进行规范化,以确保各变量贡献相同princomp() 或 prcomp(),并结合 FactoMineR 和 factoextra 包进行分析与可视化要跟随本教程,您需要:
corrr、ggcorrplot、FactoMineR、factoextra(安装步骤在教程中讲解)尽管我们的重点是 PCA,但请牢记以下五种旨在总结与可视化多变量数据的主成分方法。与其他方法不同,PCA 仅适用于定量变量。

主成分方法
我们不深入讲解数学原理,因为它可能较为复杂。然而,理解以下五个步骤有助于更好地把握如何计算 PCA。

计算主成分的五个主要步骤
回到引言中的例子,设想某位客户具有如下信息。
这些信息的量纲不同,直接用此数据进行 PCA 会产生偏差。这时需要进行数据规范化。它确保每个属性具有相同的贡献度,避免某个变量支配其他变量。对每个变量,规范化通过减去其均值并除以其标准差来完成。
顾名思义,此步骤基于规范化后的数据计算协方差矩阵。这是一个对称矩阵,其中每个元素 (i, j) 对应变量 i 与 j 之间的协方差。
从几何角度看,特征向量表示一个方向,比如“竖直”或“90 度”。而特征值是一个数,表示数据在该方向上的方差大小。每个特征向量都有其对应的特征值。
特征向量与特征值的配对数量等于数据中的变量数。在只包含月度花费、年龄和评分的数据中,将会有三对。并非所有配对都重要。因此,具有最大特征值的特征向量对应第一主成分。第二主成分则对应于具有第二大特征值的特征向量,依此类推。
此步骤将原始数据重新投影到由主成分定义的新子空间中。该重投影通过将原始数据与此前计算的特征向量相乘来完成。
需要牢记的是,此变换并未修改原始数据本身,而是提供了一个新的视角,以更好地表征数据。
主成分分析在我们的日常生活中有广泛应用,包括但不限于金融、图像处理、医疗与安防等领域。
利用历史价格预测股票价格的思想在研究中已沿用多年。PCA 可用于降维与数据分析,帮助专家找到解释数据大部分变异性的相关成分。您可以在我们的专门课程中进一步学习R 中的降维。
一张图像由多个特征构成。PCA 主要用于图像压缩,在降低维度的同时保留图像的关键信息。此外,PCA 还可用于更复杂的任务,例如图像识别。
与图像压缩的逻辑相同,PCA 被用于核磁共振成像(MRI)中,以降低图像的维度,从而获得更好的可视化与医学分析。它也可集成到医学技术中,例如基于影像识别特定疾病。
用于指纹识别的生物识别系统可以集成基于主成分分析的技术,以提取最相关的特征,如指纹纹理及其他信息。
现在您已经理解了 PCA 的基本原理,终于可以看看它的实际应用。
本节涵盖从安装相关软件包、加载并准备数据、在 R 中应用主成分分析,到解读结果的全部步骤。
源代码可在 DataLab 获取。
要顺利完成本教程,您需要以下库;每个库要高效使用通常需两步:
这是一个用于相关性分析的 R 包,主要专注于创建与处理 R 数据框。以下为安装与加载步骤。
install.packages("corrr")
library('corrr')ggcorrplot 包提供多种函数,其中包括与 ggplot2 搭配的函数,便于可视化相关矩阵。与上述步骤类似,安装十分直接。
install.packages("ggcorrplot")
library(ggcorrplot)主要用于多变量探索性数据分析;factoMineR 包提供 PCA 模块以执行主成分分析。
install.packages("FactoMineR")
library("FactoMineR")最后这个包提供了可视化主成分分析结果的相关函数。包括但不限于碎石图、双标图——本文稍后将介绍这两种可视化技术。
install.packages("factoextra")
library(factoextra)在加载数据并进行进一步探索之前,先了解您将要处理的数据及其基本信息是很有必要的。
该蛋白质数据集为实值多变量数据,描述了 25 个欧洲国家居民的平均蛋白质摄入量。
每个国家有十列。前八列对应不同类型的蛋白质。最后一列对应各蛋白质平均值的总和。
我们先快速浏览一下数据。
首先,使用 read.csv() 函数加载数据,然后用 str(),如下图所示。
protein_data <- read.csv("protein.csv")
str(protein_data)
可以看到数据集有 25 条观测与 11 列。除 Country 列为字符型外,其余各变量均为数值型。

蛋白质数据描述
缺失值的存在会使 PCA 结果产生偏差。因此,强烈建议采用合适的方法处理这些值。我们的数据科学家应掌握的缺失值处理技巧教程可帮助您做出正确选择。
colSums(is.na(protein_data))colSums() 与 is.na() 结合可返回每列中的缺失值数量。如下所示,没有列存在缺失值。

各列缺失值数量
如本文前面所述,PCA 只适用于数值型变量。因此我们需要去除 Country 列。此外,Total 列为剩余数值变量的线性组合,对分析并无帮助。
下面的代码创建仅包含数值列的新数据。
numerical_data <- protein_data[,2:10]

head(numerical_data)
数据规范化前(仅展示前五列)
现在,可使用 scale() 函数进行规范化。
data_normalized <- scale(numerical_data)
head(data_normalized)
规范化后的数据(仅展示前五列)
在运行 PCA 之前,通过可视化变量间的相关性可以验证 PCA 是否会有效。高相关性表明存在冗余,PCA 可以对其进行压缩。我将使用前面安装的 corrr 与 ggcorrplot 包。
corr_matrix <- cor(data_normalized)
ggcorrplot(corr_matrix,
           hc.order = TRUE,
           type = "lower",
           lab = TRUE)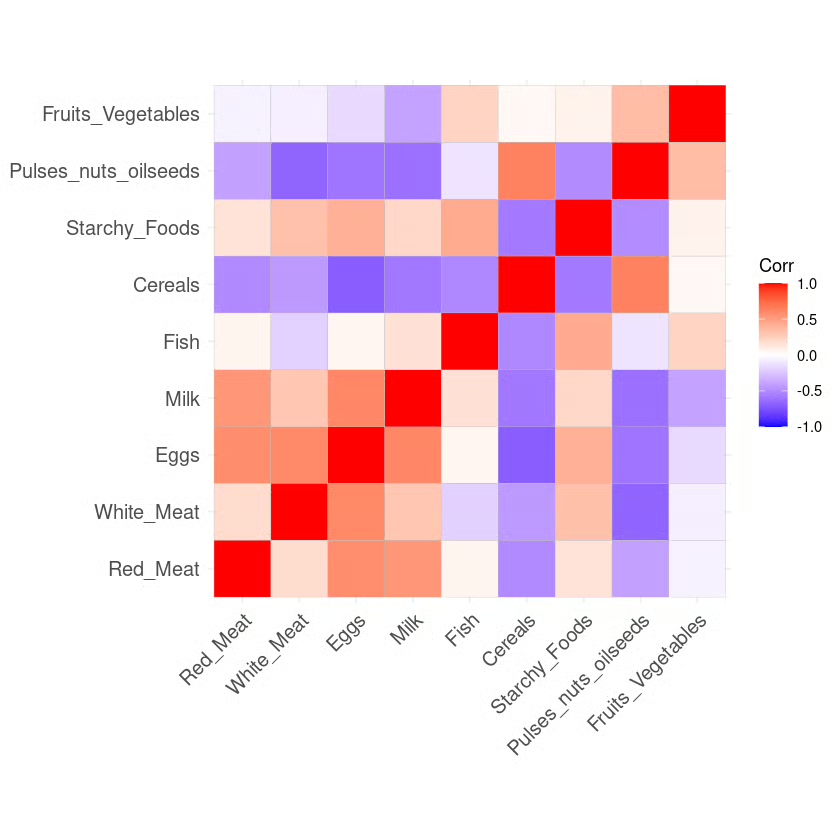
热图显示动物蛋白来源(红肉、白肉、鸡蛋和牛奶)之间存在强正相关,这也解释了第一个主成分几乎捕获了 77% 的总方差。这种相关结构正是 PCA 旨在利用的。
关于 R 中 PCA 函数的说明:本教程使用 princomp(),它对协方差矩阵进行谱分解。对于大多数实际场景,prcomp() 更为常用——它使用奇异值分解(SVD),在变量较多的数据集上数值稳定性更好。两者输出的一个关键差异:princomp() 将载荷存放在 $loadings,而 prcomp() 使用 $rotation。对于像本文所用蛋白质数据这类条件良好的数据,它们得到的结果等价。
现在执行 PCA 所需的一切资源都已就绪。首先用 princomp() 计算 PCA,再用 summary() 查看结果。
data.pca <- princomp(data_normalized)
summary(data.pca)
R PCA 摘要
从上图可以看到,生成了 9 个主成分(Comp.1 至 Comp.9),这也对应于数据中的变量数量。
每个成分解释了数据集中总方差的一定比例。在累计占比一栏,第一主成分解释了将近 77% 的总方差。这意味着在 9 个变量构成的数据中,近三分之二的信息可以仅由第一主成分表示。第二主成分解释了 12.08% 的总方差。
Comp.1 与 Comp.2 的累计占比接近 89% 的总方差。这表示前两个主成分已足以较好地表示数据。
有了前两个主成分固然很好,但它们究竟意味着什么?
可以通过查看各主成分的载荷与每一列的关系来回答这个问题。
data.pca$loadings[, 1:2]
前两个主成分的载荷矩阵
载荷矩阵显示,第一主成分在红肉、白肉、鸡蛋与牛奶上具有较高的正值。然而,在谷物、豆类、坚果与油籽以及果蔬上的数值相对为负。这表明动物蛋白摄入更高的国家处于“过量”,而摄入较低的国家则处于“不足”。
至于第二主成分,其在鱼类、淀粉类食物以及果蔬上的取值为较高的负值。 这意味着各国的饮食在很大程度上受到地理位置的影响,例如沿海地区偏好鱼类,而内陆地区的饮食更富含蔬菜与土豆。
前面对载荷矩阵的分析帮助我们理解了前两个主成分与数据属性之间的关系,但其可视化表现可能并不直观。
有几种常见的可视化策略可以帮助用户从数据中获取洞见,本节将介绍其中一部分方法,先从碎石图开始。
首个方法是碎石图。它用于可视化各主成分的重要性,并可辅助确定保留的主成分个数。可通过 fviz_eig() 函数生成碎石图。
fviz_eig(data.pca, addlabels = TRUE)
主成分的碎石图
该图展示了特征值从高到低的下降曲线。前两个成分可视为最重要,因为它们几乎包含了数据总信息的 89%。
通过双标图,可以同时可视化样本之间的相似与差异,并进一步展示各属性对各主成分的影响。
# 变量图
fviz_pca_var(data.pca, col.var = "black")
相对于主成分的变量双标图
从上图可以观察到三点主要信息。
第三种可视化的目标是确定某个成分对每个变量的表示程度。这种表示质量称为 Cos2(平方余弦),可使用 fviz_cos2() 函数计算。
fviz_cos2(data.pca, choice = "var", axes = 1:2)上述代码计算了相对于前两个主成分的每个变量的平方余弦值。
从下图可见,谷物、豆类坚果油籽、鸡蛋与牛奶是 cos2 最高的前四个变量,因此对 PC1 与 PC2 贡献最大。

变量对主成分的贡献
最后两种可视化——双标图与属性重要性——可以结合起来,生成单个双标图:cos2 得分相近的属性将呈现相近的颜色。这可以通过如下方式微调 fviz_pca_var 函数来实现:
fviz_pca_var(data.pca, col.var = "cos2",
            gradient.cols = c("black", "orange", "green"),
            repel = TRUE)
从下方双标图可见:

双标图与 cos2 得分的结合
两个实用准则可帮助决定保留多少个主成分:
本教程介绍了什么是主成分分析以及它在数据分析中的重要性。从数学基础到 R 代码实操,我们在蛋白质数据集上完整走了一遍 PCA 工作流——从规范化、应用 princomp(),到解读碎石图、双标图与 cos2 可视化,以理解主成分与原始变量之间的关系。
将这些技术应用到您自己的数据集,以实现降维、挖掘潜在结构,并构建更精炼的机器学习流水线。
想要进一步学习,请探索以下相关资源: