
什么是 NLU?
自然语言理解(NLU)是自然语言处理(NLP)的一个分支,专注于让机器理解和解释人类语言。
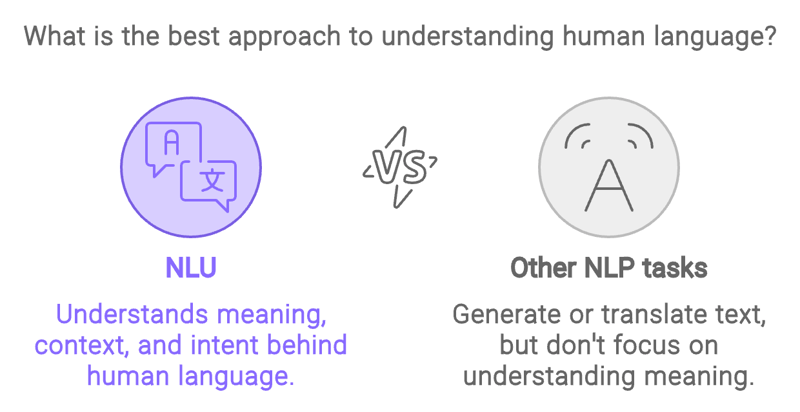
不同于其他可能涉及生成或翻译文本的 NLP 任务,NLU 专注于理解人们使用的词句背后的含义、语境和意图。
由 Napkin.ai 创建
从本质上讲,NLU 是将非结构化语言数据转化为机器可处理的结构化信息。这包括识别句子中的实体、判断陈述的情感,或对用户查询背后的意图进行分类等任务。
例如,当有人说:“Book a flight to New York.”,NLU 系统必须识别“book”是一个动作,“flight”是宾语,“New York”是目的地。
NLU 的工作原理
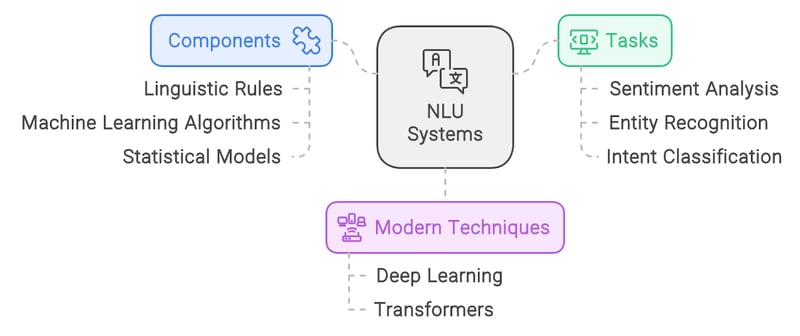
自然语言理解(NLU)依赖语言学规则、机器学习算法以及统计模型的组合来准确解读人类语言。
NLU 系统会将非结构化语言数据转化为结构化信息,使机器能够执行情感分析、实体识别和意图分类等任务。
现代 NLU 主要依赖深度学习,尤其是Transformer等模型。例如,即便是通用模型ChatGPT也能够解析任意英文句子以提取其含义。
由 Napkin.ai 创建
NLU 与 NLP
需要明确的是,自然语言理解(NLU)并不独立于自然语言处理(NLP),而是其中至关重要的组成部分。人们常说“NLU vs. NLP”,这种表述会造成误导,因为 NLU 是 NLP 的子集。
两者唯一有意义的比较应当是讨论不属于 NLU 的 NLP 任务。但那会偏离 NLU 的主题,因此我们不沿此思路展开。
NLP 涵盖与文本处理和分析相关的广泛任务,而 NLU 专注于理解。例如,NLP 可能涉及语音识别或文本生成,而 NLU 关注的是理解输入文本的含义——用户想表达什么以及为什么。
下表突出展示了二者的一些关键差异:
|
方面 |
NLP |
NLU |
|
范围 |
广(涵盖处理和生成自然语言的各个方面) |
窄(专注于理解含义、意图与语境) |
|
示例任务 |
语音识别、文本生成、机器翻译 |
实体识别、意图分类、情感分析 |
|
侧重 |
语言的理解与生成 |
对语言含义和意图的理解 |
该表说明,NLP 覆盖与人类语言理解与生成相关的广泛任务,而 NLU 则专注于理解本身。
NLU 的应用
自然语言理解(NLU)是众多 AI 驱动应用的核心。它使机器(例如聊天机器人)能够以直观、自然的方式与人类互动。以下列出 NLU 产生显著影响的一些关键领域,并附以各自的现代工具示例。
聊天机器人
NLU 的主要应用之一是聊天机器人和虚拟助手。这些系统依赖 NLU 来准确解读并响应用户请求。
例如,当用户询问:“Can you find me a nearby coffee shop?” 时,NLU 组件会帮助系统理解用户在寻找距离其当前位置较近的咖啡店,从而让聊天机器人或助手提供相关回应。
NLU 不仅能理解单个查询,还对维系对话流至关重要。它使聊天机器人与虚拟助手能够跟踪上下文,从而实现更自然、连贯的往返交流。例如,如果用户对聊天机器人发怒,它能够理解这种情绪并作出相应回应。
一个用于构建具备高级 NLU 能力聊天机器人的流行工具是Rasa 框架。它是一个开源库,用于构建具备高级 NLU 能力的聊天机器人。
情感分析
情感分析是 NLU 的另一项关键应用,广泛用于评估公众意见和客户反馈。
企业利用 NLU 来分析客户评论、社交媒体帖子及其他反馈形式中表达的情感,以判断总体情绪是积极还是消极。
我想提到的一款常用的情感分析工具是VADER(Valence Aware Dictionary and sEntiment Reasoner)。它是一款开源的基于规则的工具,专为理解社交媒体中的情感而设计。
文本分类
NLU 在文本分类任务(如垃圾邮件过滤)中发挥着关键作用。通过分析邮件或消息的内容与意图,NLU 系统可以有效区分正常邮件与垃圾邮件。
两款常用的文本分类工具是SpaCy和NLTK(自然语言工具包)。
SpaCy 是一个开源库,旨在为 Python 提供高效快速的 NLP,提供可微调的预训练模型,适用于多种文本分类任务。
NLTK 是另一款功能强大的 Python 库,提供易用的分词、词性标注和文本分类等工具。两者均可用于构建文本分类流程。
NLU 的挑战
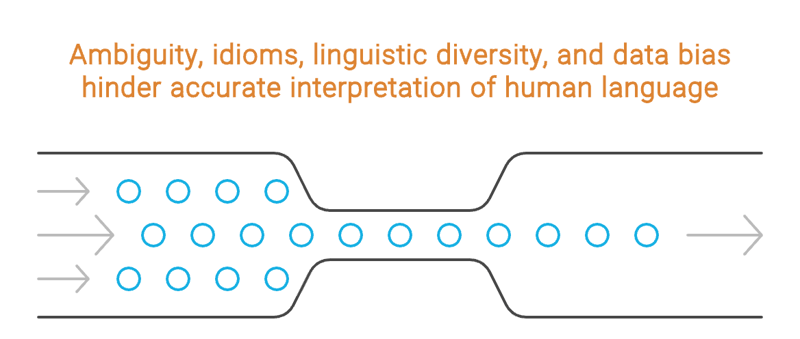
NLU 常被称为“AI-hard”问题,意味着它是 AI 领域最复杂、最具挑战性的方向之一。困难在于人类语言的微妙之处——歧义、习语、语境和文化差异都加剧了其复杂性。
由 Napkin.ai 创建
歧义性
NLU 的一大难点是处理人类语言中固有的歧义性。
一句话往往可以有多种解读。例如,考虑这句话:“I saw a man with binoculars.” 这可能表示我们用望远镜看见了那名男子,也可能表示我们看见的那名男子带着望远镜。
要消解此类歧义,需要理解上下文——这对人类来说相对容易,但对机器仍是相当大的挑战。
习语与比喻性语言
习语和比喻性语言为 NLU 增添了新的复杂层面。诸如“kick the bucket”或“spill the beans”之类的短语,其含义与字面解释并无直接关联。
要准确解读这类表达,NLU 系统必须在包含这些文化与语言细微差别的大量数据上进行训练,而这些差别在不同语言与地区之间可能差异很大。
文化与语言多样性
语言并不统一。不同文化、地区,甚至不同社群之间,语言差异显著。一个在某种语言或文化语境下表现良好的 NLU 系统,可能在另一种语境中失效。
例如,俚语、方言和地域表达对 NLU 系统而言都可能难以准确解读。要构建能够处理这种多样性的系统,需要大量且多元的训练数据,而这往往难以获得。
数据偏见
偏见在训练数据中的存在,是 NLU 系统面临的另一大挑战。如果用于训练 NLU 模型的数据存在偏见,模型的预测与解读也会反映这种偏见。
例如,如果模型在来自特定人群的文本上训练,它在解读其他人群的语言时可能表现不佳。
结语
自然语言理解(NLU)是 AI 和 NLP 的重要分支,专注于让机器准确理解与解释人类语言。
通过理解 NLU 的原理与挑战,以及其在更广泛 NLP 语境中的角色,您将更能体会自然语言理解的复杂性与重要性。

企业和个人每天都会生成海量文本数据。然而,从这些非结构化信息中提取洞见,对传统数据处理方法而言是一项挑战。
自然语言处理(NLP)涵盖分析与理解文本的一系列技术,而其中的一个特定子领域——自然语言理解(NLU)——则聚焦于让机器理解人类语言背后的含义、语境和意图。
NLU 能将原始文本转化为可付诸行动的洞见,为智能聊天机器人和情感分析等应用铺平道路。
尽管已有显著进展,NLU 依然是人工智能中最具挑战且尚未完全解决的问题之一,其复杂性根植于自然语言的细微差别与歧义。本文将为您打下扎实的 NLU 基础。