
कोर्स
Python में NLP के लिए Feature Engineering
4 घंटा
29.7K
प्राकृतिक भाषा समझ (NLU) प्राकृतिक भाषा प्रसंस्करण (NLP) का एक उपक्षेत्र है, जो मशीनों को मानव भाषा को समझने और उसकी व्याख्या करने में सक्षम बनाने पर केंद्रित है।
अन्य NLP कार्यों के विपरीत जिनमें पाठ उत्पन्न करना या अनुवाद करना शामिल हो सकता है, NLU विशेष रूप से उन शब्दों और वाक्यांशों के पीछे के अर्थ, संदर्भ और आशय को समझने से संबंधित है जिनका लोग उपयोग करते हैं।
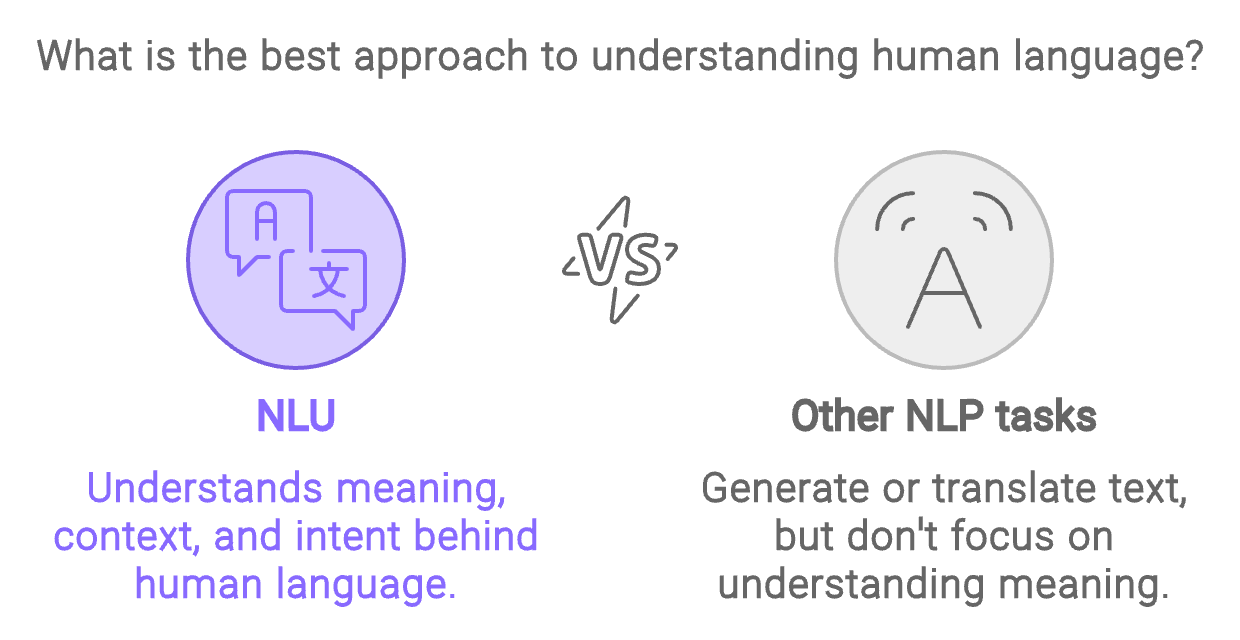
Napkin.ai के साथ बनाया गया
अपने मूल में, NLU असंरचित भाषा डेटा को संरचित जानकारी में बदलने के बारे में है, जिसके साथ मशीनें काम कर सकें। इसमें वाक्य में संस्थाओं की पहचान करना, किसी कथन की भावना निर्धारित करना, या उपयोगकर्ता की क्वेरी के पीछे के आशय को वर्गीकृत करना जैसे कार्य शामिल होते हैं।
उदाहरण के लिए, जब कोई कहता है, "न्यूयॉर्क के लिए एक फ्लाइट बुक करें," तो एक NLU सिस्टम को "बुक" को एक क्रिया, "फ्लाइट" को वस्तु, और "न्यूयॉर्क" को गंतव्य के रूप में पहचानना चाहिए।
प्राकृतिक भाषा समझ (NLU) मानव भाषा की सटीक व्याख्या करने के लिए भाषिक नियमों, मशीन लर्निंग एल्गोरिदम और सांख्यिकीय मॉडलों के संयोजन पर निर्भर करता है।
NLU सिस्टम असंरचित भाषा डेटा को संरचित जानकारी में परिवर्तित करते हैं, जिसे मशीनें भाव विश्लेषण, इकाई पहचान, और आशय वर्गीकरण जैसे कार्यों के लिए उपयोग कर सकती हैं।
आधुनिक NLU मुख्य रूप से डीप लर्निंग पर निर्भर करता है, विशेषकर ट्रांसफॉर्मर जैसे मॉडलों पर। उदाहरण के लिए, ChatGPT जैसे बहुउद्देशीय मॉडल भी किसी भी अंग्रेज़ी वाक्य का पार्स करके उसका अर्थ निकालने में सक्षम हैं।
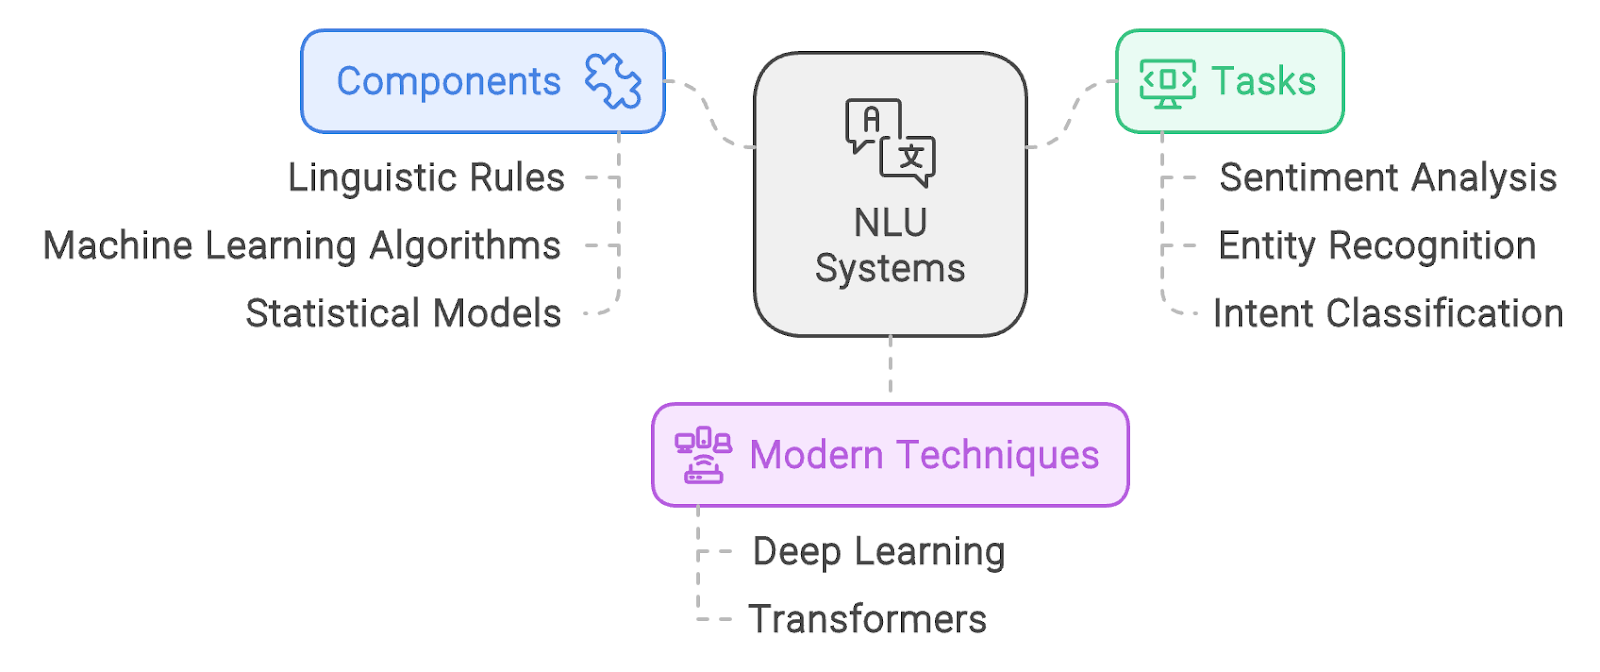
Napkin.ai के साथ बनाया गया
यह स्पष्ट करना महत्वपूर्ण है कि प्राकृतिक भाषा समझ (NLU) प्राकृतिक भाषा प्रसंस्करण (NLP) से अलग नहीं है, बल्कि उसका एक महत्वपूर्ण घटक है। लोग अक्सर "NLU बनाम NLP" कहते हैं, लेकिन यह ढांचा भ्रामक है क्योंकि NLU, NLP का उपसमुच्चय है।
इन दोनों के बीच एकमात्र सार्थक तुलना में उन NLP कार्यों पर चर्चा शामिल होगी जो NLU के अंतर्गत नहीं आते। हालांकि, इससे ध्यान NLU से हट जाएगा, इसलिए हम इस तरह की तुलना नहीं करेंगे।
NLP पाठ के प्रसंस्करण और विश्लेषण से जुड़े व्यापक कार्यों को समेटता है, जबकि NLU विशेष रूप से समझ पर केंद्रित है। उदाहरण के लिए, जहां NLP में वाक् पहचान या पाठ निर्माण जैसे कार्य शामिल हो सकते हैं, वहीं NLU इनपुट पाठ के अर्थ को समझने के बारे में है—उपयोगकर्ता क्या कहना चाह रहा है और क्यों।
नीचे दी गई तालिका दोनों के बीच कुछ प्रमुख अंतर दर्शाती है:
|
पहलू |
NLP |
NLU |
|
परिसीमा |
विस्तृत (मानव भाषा के प्रसंस्करण और उत्पादन के सभी पहलुओं को शामिल करता है) |
संकीर्ण (विशेष रूप से अर्थ, आशय और संदर्भ को समझने पर केंद्रित) |
|
उदाहरण कार्य |
वाक् पहचान, पाठ निर्माण, मशीन अनुवाद |
इकाई पहचान, आशय वर्गीकरण, भाव विश्लेषण |
|
केन्द्रबिंदु |
भाषा की समझ और निर्माण दोनों |
भाषा के अर्थ और आशय की समझ |
यह तालिका दर्शाती है कि जहां NLP मानव भाषा की समझ और निर्माण दोनों से जुड़े व्यापक कार्यों को कवर करता है, वहीं NLU विशेष रूप से समझ पर केंद्रित है।
प्राकृतिक भाषा समझ (NLU) कई AI-संचालित अनुप्रयोगों के केंद्र में है। यह मशीनों (उदाहरण के लिए, चैटबॉट) को मानवों के साथ ऐसे तरीकों से बातचीत करने में सक्षम बनाता है जो सहज और स्वाभाविक महसूस होते हैं। नीचे कुछ प्रमुख क्षेत्र दिए गए हैं जहां NLU महत्वपूर्ण प्रभाव डाल रहा है, साथ ही प्रत्येक के लिए आधुनिक टूलिंग के कुछ उदाहरण।
NLU का एक प्रमुख अनुप्रयोग चैटबॉट और वर्चुअल असिस्टेंट में है। ये सिस्टम उपयोगकर्ता के अनुरोधों की सटीक व्याख्या और उत्तर देने के लिए NLU पर निर्भर करते हैं।
उदाहरण के लिए, जब कोई उपयोगकर्ता पूछता है, "क्या आप मेरे लिए पास का कोई कॉफी शॉप ढूंढ सकते हैं?" तो NLU घटक सिस्टम को समझने में मदद करता है कि उपयोगकर्ता अपनी मौजूदा लोकेशन के पास कॉफी शॉप ढूंढ रहा है, जिससे चैटबॉट या असिस्टेंट प्रासंगिक उत्तर दे सके।
केवल अलग-अलग प्रश्नों को समझने से आगे बढ़कर, बातचीत के प्रवाह को बनाए रखने के लिए NLU आवश्यक है। यह चैटबॉट और वर्चुअल असिस्टेंट को संदर्भ का ट्रैक रखने में सक्षम बनाता है, जिससे अधिक स्वाभाविक और सुसंगत बातचीत संभव होती है। उदाहरण के लिए, यदि कोई उपयोगकर्ता चैटबॉट से नाराज़ हो जाता है, तो वह इसे समझकर उसी अनुरूप प्रतिक्रिया देगा।
उन्नत NLU क्षमताओं वाले चैटबॉट बनाने के लिए एक लोकप्रिय टूल Rasa फ्रेमवर्क है। यह एक ओपन-सोर्स लाइब्रेरी है जिसका उपयोग उन्नत NLU क्षमताओं वाले चैटबॉट बनाने के लिए किया जाता है।
भाव विश्लेषण NLU का एक और महत्वपूर्ण अनुप्रयोग है और इसे जनमत और ग्राहक फीडबैक का आकलन करने के लिए व्यापक रूप से उपयोग किया जाता है।
व्यवसाय NLU का उपयोग ग्राहक समीक्षाओं, सोशल मीडिया पोस्ट और अन्य फीडबैक में व्यक्त भावना का विश्लेषण करने के लिए करते हैं, ताकि यह निर्धारित किया जा सके कि समग्र भावना सकारात्मक है या नकारात्मक।
एक आमतौर पर प्रयुक्त भाव विश्लेषण टूल जिसका मैं उल्लेख करना चाहूंगा, वह है VADER (Valence Aware Dictionary and sEntiment Reasoner)। यह एक ओपन-सोर्स नियम-आधारित टूल है जिसे विशेष रूप से सोशल मीडिया में भाव को समझने के लिए डिज़ाइन किया गया है।
स्पैम फिल्टरिंग जैसे पाठ वर्गीकरण कार्यों में NLU महत्वपूर्ण भूमिका निभाता है। ईमेल या संदेशों की सामग्री और आशय का विश्लेषण करके, NLU सिस्टम प्रभावी रूप से हैम और स्पैम के बीच अंतर कर सकते हैं।
पाठ वर्गीकरण के दो लोकप्रिय टूल SpaCy और NLTK (Natural Language Toolkit) हैं।
SpaCy Python में कुशल और तेज़ NLP के लिए बनाई गई एक ओपन-सोर्स लाइब्रेरी है, जो प्री-ट्रेंड मॉडल प्रदान करती है जिन्हें विभिन्न पाठ वर्गीकरण कार्यों के लिए फाइन-ट्यून किया जा सकता है।
NLTK एक और शक्तिशाली Python लाइब्रेरी है जो टोकनाइज़ेशन, पार्ट-ऑफ़-स्पीच टैगिंग और पाठ वर्गीकरण जैसे कार्यों के लिए उपयोग में आसान टूल प्रदान करती है। दोनों लाइब्रेरी का उपयोग पाठ वर्गीकरण पाइपलाइन बनाने के लिए किया जा सकता है।
NLU को अक्सर AI-कठिन समस्या कहा जाता है, अर्थात यह AI के सबसे जटिल और चुनौतीपूर्ण क्षेत्रों में से एक है। कठिनाई मानव भाषा की बारीकियों में निहित है—अस्पष्टताएँ, मुहावरे, संदर्भ, और सांस्कृतिक भिन्नताएँ—all जटिलता में योगदान देते हैं।
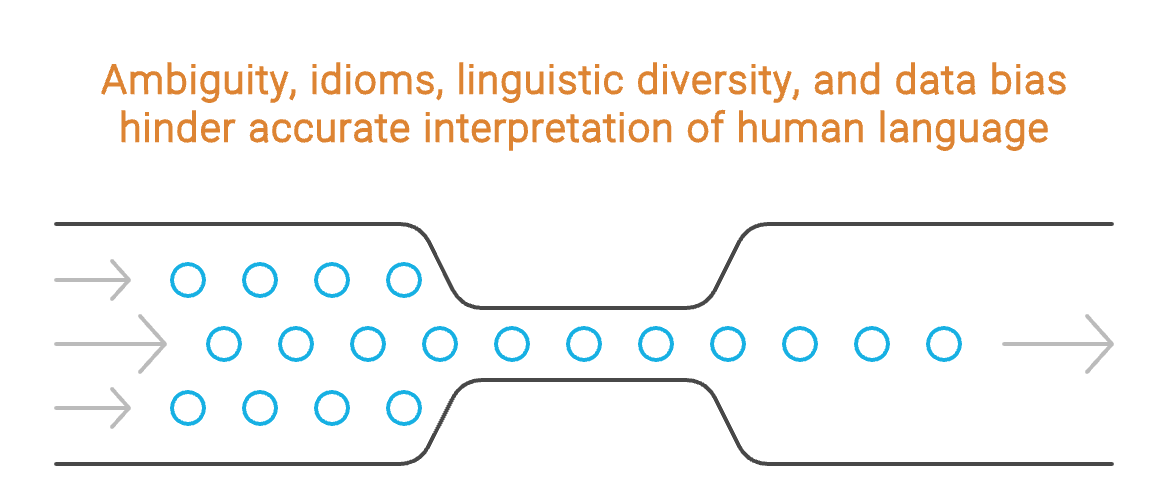
Napkin.ai के साथ बनाया गया
NLU में सबसे बड़ी चुनौतियों में से एक मानव भाषाओं में अंतर्निहित अस्पष्टता को संभालना है।
एक ही वाक्य के कई अर्थ हो सकते हैं। उदाहरण के लिए, यह वाक्य देखें: “I saw a man with binoculars.” यह वाक्य या तो यह मतलब दे सकता है कि हमने दूरबीन का उपयोग करके उस आदमी को देखा, या वह आदमी जिसे हमने देखा उसके पास दूरबीन थी।
ऐसे वाक्यों का अस्पष्टता-निवारण संदर्भ की समझ की मांग करता है—जो मानवों के लिए अपेक्षाकृत सहज है, लेकिन मशीनों के लिए अब भी एक बड़ी चुनौती है।
मुहावरेदार अभिव्यक्तियाँ और अलंकारिक भाषा NLU में एक और परत की जटिलता जोड़ती हैं। "kick the bucket" या "spill the beans" जैसे वाक्यांशों के अर्थ शब्दों की शाब्दिक व्याख्या से सीधे संबद्ध नहीं होते।
ऐसी अभिव्यक्तियों की सटीक व्याख्या करने के लिए NLU सिस्टम को बड़े पैमाने पर ऐसे डेटा पर प्रशिक्षित करना पड़ता है जिनमें ये सांस्कृतिक और भाषाई बारीकियाँ शामिल हों, जो विभिन्न भाषाओं और क्षेत्रों में व्यापक रूप से भिन्न हो सकती हैं।
भाषा एकरूप नहीं होती। यह विभिन्न संस्कृतियों, क्षेत्रों और यहां तक कि सामाजिक समूहों में भी काफी भिन्न होती है। एक NLU सिस्टम जो एक भाषा या सांस्कृतिक संदर्भ में अच्छा काम करता है, दूसरे में विफल हो सकता है।
उदाहरण के लिए, स्लैंग, बोलियाँ और क्षेत्रीय अभिव्यक्तियाँ NLU सिस्टम के लिए सही ढंग से व्याख्यायित करना चुनौतीपूर्ण हो सकती हैं। इस विविधता को संभालने वाले सिस्टम बनाने के लिए व्यापक और विविध प्रशिक्षण डेटा की आवश्यकता होती है, जिसे प्राप्त करना अक्सर कठिन होता है।
पूर्वाग्रह प्रशिक्षण डेटा में NLU सिस्टम के लिए एक और महत्वपूर्ण चुनौती प्रस्तुत करता है। यदि NLU मॉडल को प्रशिक्षित करने के लिए प्रयुक्त डेटा पूर्वाग्रहपूर्ण है, तो मॉडल की भविष्यवाणियाँ और व्याख्याएँ भी उसी पूर्वाग्रह को परिलक्षित करेंगी।
उदाहरण के लिए, यदि किसी मॉडल को किसी विशेष जनसांख्यिकीय से प्राप्त पाठ पर प्रशिक्षित किया गया है, तो वह अन्य जनसांख्यिकी की भाषा की व्याख्या करते समय अच्छा प्रदर्शन नहीं कर सकता।
प्राकृतिक भाषा समझ (NLU) AI और NLP का एक महत्वपूर्ण उपक्षेत्र है, जो मशीनों को मानव भाषा को सटीक रूप से समझने और उसकी व्याख्या करने में सक्षम बनाने पर केंद्रित है।
NLU के सिद्धांतों और चुनौतियों—सहित NLP के व्यापक संदर्भ में इसकी भूमिका—को समझकर, आप प्राकृतिक भाषा समझ की जटिलता और महत्ता की सराहना कर सकते हैं।
इन पाठ्यक्रमों के साथ NLP सीखें!
कोर्स