
Cursus
Feature Engineering voor NLP in Python
4 uur
29.7K
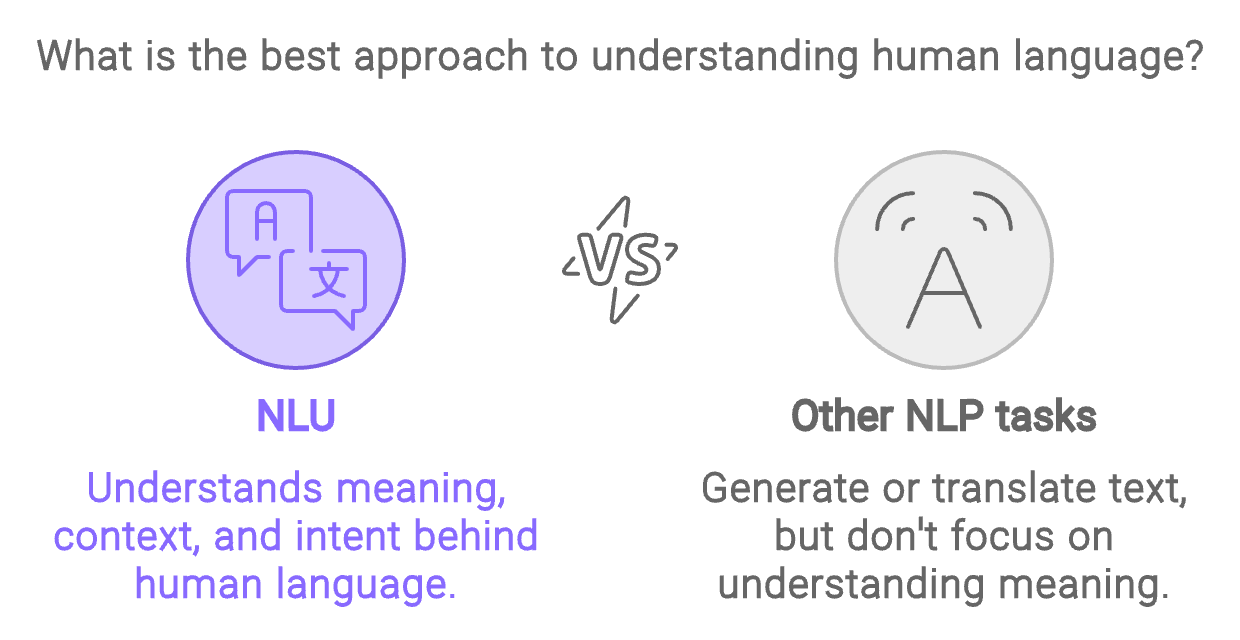
Natural language understanding (NLU) is een deelgebied van natural language processing (NLP) dat zich richt op het in staat stellen van machines om menselijke taal te begrijpen en te interpreteren.
In tegenstelling tot andere NLP-taken die kunnen gaan over het genereren of vertalen van tekst, draait NLU specifiek om het begrijpen van de betekenis, context en intentie achter de woorden en zinnen die mensen gebruiken.
Gemaakt met Napkin.ai
In de kern gaat NLU over het omzetten van ongestructureerde taaldata naar gestructureerde informatie waar machines mee kunnen werken. Dit omvat taken zoals het identificeren van entiteiten in een zin, het bepalen van het sentiment van een uitspraak of het classificeren van de intentie achter de vraag van een gebruiker.
Als iemand bijvoorbeeld zegt: "Boek een vlucht naar New York", dan moet een NLU-systeem "boek" als actie herkennen, "vlucht" als object en "New York" als bestemming.
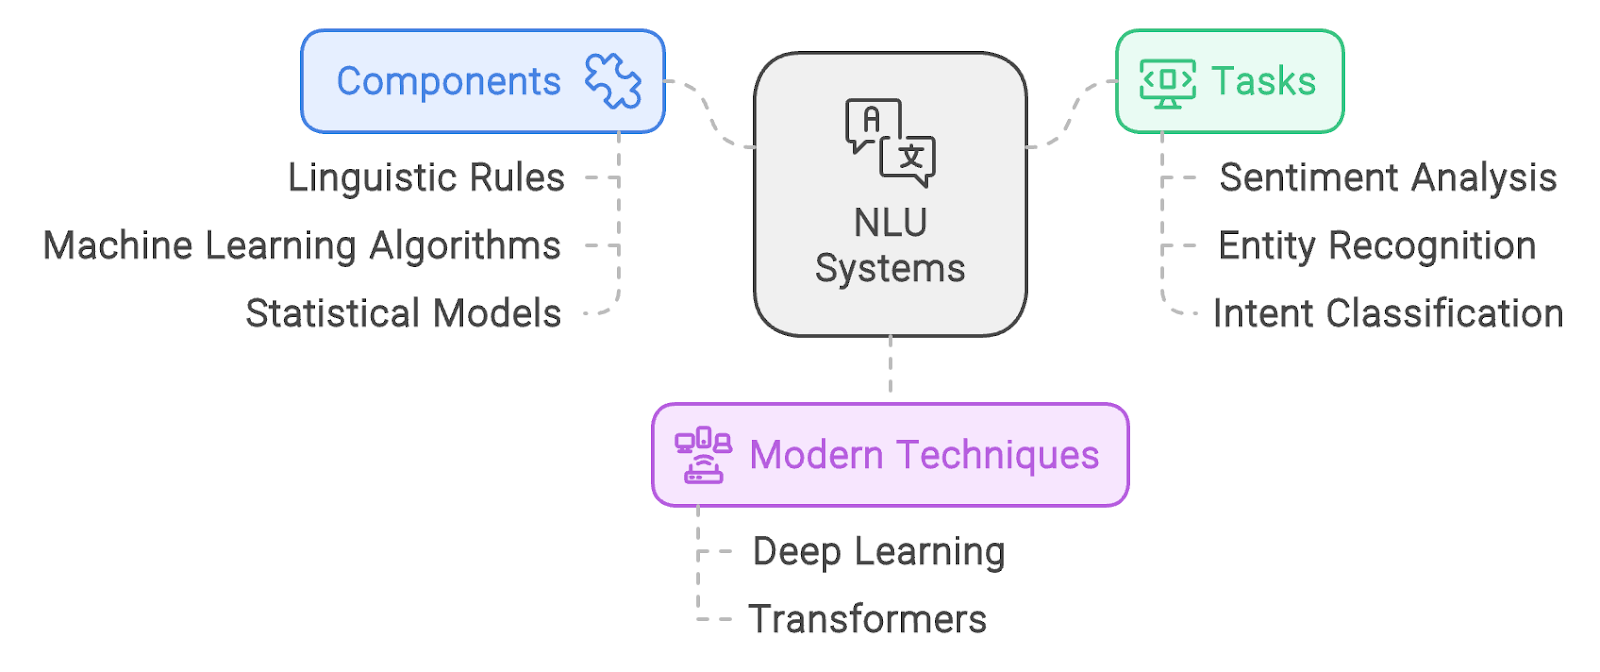
Natural language understanding (NLU) steunt op een combinatie van linguïstische regels, machine learning-algoritmen en statistische modellen om menselijke taal nauwkeurig te interpreteren.
NLU-systemen zetten ongestructureerde taaldata om in gestructureerde informatie die machines kunnen gebruiken om taken uit te voeren zoals sentimentanalyse, entiteitsherkenning en intentieclassificatie.
Moderne NLU steunt vooral op deep learning, met name modellen zoals transformers. Zo kunnen zelfs veelzijdige modellen zoals ChatGPT elke Engelse zin ontleden om de betekenis te extraheren.
Gemaakt met Napkin.ai
Het is belangrijk om te verduidelijken dat natural language understanding (NLU) niet losstaat van natural language processing (NLP), maar juist een cruciaal onderdeel ervan is. Hoewel mensen vaak de term "NLU vs. NLP" gebruiken, is dit een misleidende framing omdat NLU een subset van NLP is.
De enige zinvolle vergelijking tussen deze twee zou gaan over NLP-taken die niet onder NLU vallen. Dat zou de aandacht echter weghalen van NLU, dus die vergelijking volgen we hier niet.
NLP omvat een breed scala aan taken rondom het verwerken en analyseren van tekst, terwijl NLU zich specifiek richt op begrip. Zo kan NLP bijvoorbeeld taken omvatten als spraakherkenning of tekstgeneratie, terwijl NLU draait om het begrijpen van de betekenis van de invoertekst—wat de gebruiker probeert te zeggen en waarom.
De onderstaande tabel belicht enkele van de belangrijkste verschillen tussen de twee:
|
Aspect |
NLP |
NLU |
|
Reikwijdte |
Breed (omvat alle aspecten van het verwerken en genereren van menselijke taal) |
Smal (specifiek gericht op het begrijpen van betekenis, intentie en context) |
|
Voorbeeldtaken |
Spraakherkenning, tekstgeneratie, machinale vertaling |
Entiteitsherkenning, intentieclassificatie, sentimentanalyse |
|
Focus |
Zowel begrip als generatie van taal |
Begrip van taalbetekenis en intentie |
Deze tabel laat zien dat NLP een breed scala aan taken bestrijkt die zowel begrip als generatie van menselijke taal omvatten, terwijl NLU zich specifiek richt op begrip.
Natural language understanding (NLU) vormt de kern van veel AI-gedreven toepassingen. Het stelt machines (bijvoorbeeld chatbots) in staat om op een intuïtieve en natuurlijke manier met mensen te communiceren. Hieronder vind je enkele belangrijke domeinen waar NLU een grote impact heeft, met voorbeelden van moderne tooling per onderdeel.
Een van de belangrijkste toepassingen van NLU is in chatbots en virtuele assistenten. Deze systemen vertrouwen op NLU om gebruikersverzoeken nauwkeurig te interpreteren en te beantwoorden.
Wanneer een gebruiker bijvoorbeeld vraagt: "Kun je een nabijgelegen koffietentje voor me vinden?" helpt de NLU-component het systeem te begrijpen dat de gebruiker een koffiebar dicht bij zijn of haar huidige locatie zoekt, zodat de chatbot of assistent een relevant antwoord kan geven.
Verder is NLU essentieel om de conversatiestroom te bewaren. Het stelt chatbots en virtuele assistenten in staat om de context bij te houden, wat zorgt voor natuurlijkere en samenhangende interacties. Als een gebruiker bijvoorbeeld boos wordt op de chatbot, zal deze dat begrijpen en passend reageren.
Een populair hulpmiddel voor het bouwen van chatbots met geavanceerde NLU-mogelijkheden is het Rasa-framework. Het is een open-sourcelibrary voor het bouwen van chatbots met geavanceerde NLU-capaciteiten.
Sentimentanalyse is een andere cruciale toepassing van NLU en wordt veel gebruikt om de publieke opinie en klantfeedback te peilen.
Bedrijven gebruiken NLU om het sentiment in klantrecensies, socialemediaberichten en andere vormen van feedback te analyseren om te bepalen of het algemene sentiment positief of negatief is.
Een veelgebruikt sentimentanalyse-instrument dat ik wil noemen is VADER (Valence Aware Dictionary and sEntiment Reasoner). Het is een open-source, regelgebaseerd hulpmiddel dat specifiek is ontworpen om sentiment op sociale media te begrijpen.
NLU speelt een belangrijke rol bij tekstclassificatietaken, zoals spamfiltering. Door de inhoud en intentie achter e-mails of berichten te analyseren, kunnen NLU-systemen effectief onderscheid maken tussen ham en spam.
Twee populaire tools voor tekstclassificatie zijn spaCy en NLTK (Natural Language Toolkit).
spaCy is een open-sourcelibrary voor efficiënte en snelle NLP in Python, met pretrained modellen die je kunt fine-tunen voor verschillende tekstclassificatietaken.
NLTK is een andere krachtige Python-bibliotheek met eenvoudig te gebruiken tools voor taken zoals tokenization, part-of-speech-tagging en tekstclassificatie. Beide libraries kun je gebruiken om tekstclassificatiepipelines te bouwen.
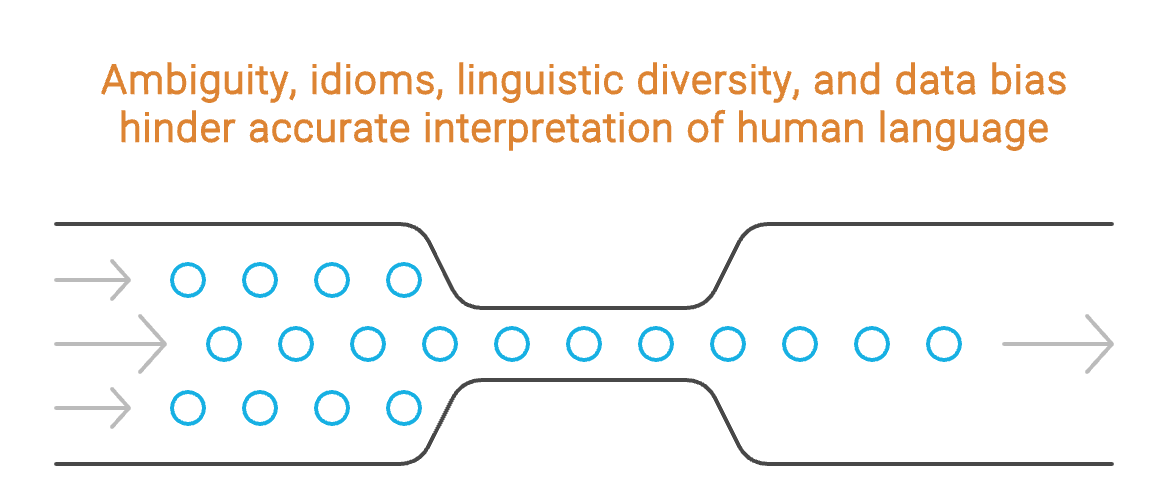
NLU wordt vaak een AI-hard probleem genoemd, wat betekent dat het een van de meest complexe en uitdagende gebieden binnen AI is. De moeilijkheid zit in de nuances van menselijke taal—ambiguïteit, idiomen, context en culturele verschillen dragen allemaal bij aan de complexiteit.
Gemaakt met Napkin.ai
Een van de grootste uitdagingen in NLU is het omgaan met de inherente ambiguïteit in menselijke talen.
Eén enkele zin kan vaak op meerdere manieren worden geïnterpreteerd. Neem bijvoorbeeld de zin: “Ik zag een man met een verrekijker.” Dit kan betekenen dat wij de man zagen met behulp van een verrekijker, of dat de man die we zagen een verrekijker bij zich had.
Het wegnemen van ambiguïteit in zulke zinnen vereist begrip van de context, iets wat voor mensen relatief eenvoudig is maar voor machines een flinke uitdaging blijft.
Idiomsche uitdrukkingen en figuurlijke taal voegen nog een laag complexiteit toe aan NLU. Uitdrukkingen als "het loodje leggen" of "de beans spillen" hebben betekenissen die niet direct gerelateerd zijn aan de letterlijke interpretatie van de woorden.
Om zulke uitdrukkingen correct te interpreteren, moeten NLU-systemen getraind zijn op veel data die deze culturele en linguïstische nuances bevat, wat sterk kan variëren tussen talen en regio's.
Taal is niet uniform. Ze verschilt sterk tussen culturen, regio's en zelfs sociale groepen. Een NLU-systeem dat goed werkt in de ene taal of culturele context kan falen in een andere.
Straattaal, dialecten en regionale uitdrukkingen zijn bijvoorbeeld lastig voor NLU-systemen om correct te interpreteren. Systemen bouwen die met deze diversiteit kunnen omgaan vereist uitgebreide en diverse trainingsdata, die vaak moeilijk te verkrijgen zijn.
Vooringenomenheid in trainingsdata is een andere grote uitdaging voor NLU-systemen. Als de data waarmee een NLU-model wordt getraind bevooroordeeld is, zullen de voorspellingen en interpretaties van het model die vooringenomenheid weerspiegelen.
Als een model bijvoorbeeld is getraind op teksten van een specifieke demografische groep, kan het slechter presteren bij het interpreteren van taal van andere demografieën.
Natural language understanding (NLU) is een belangrijk deelgebied van AI en NLP dat zich richt op het in staat stellen van machines om menselijke taal nauwkeurig te begrijpen en te interpreteren.
Door de principes en uitdagingen van NLU te begrijpen, inclusief de rol binnen de bredere context van NLP, kun je de complexiteit en het belang van natural language understanding waarderen.
Leer NLP met deze cursussen!
Cursus
blog
Adel Nehme
15 min

