
Last chance! 50% off DataCamp Premium
Sale ends in
La natural language understanding (NLU) è un sottoinsieme del natural language processing (NLP) che si concentra nel permettere alle macchine di comprendere e interpretare il linguaggio umano.
A differenza di altri compiti NLP che possono riguardare la generazione o la traduzione di testo, la NLU si occupa specificamente di comprendere il significato, il contesto e l’intento dietro le parole e le frasi utilizzate dalle persone.
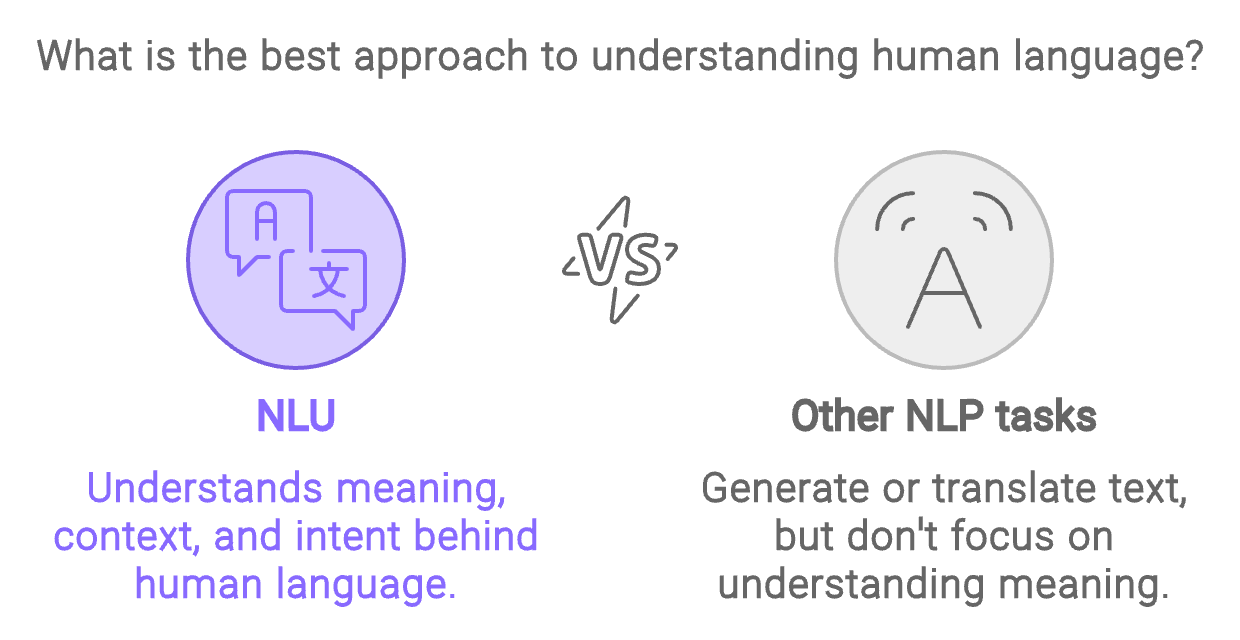
Creato con Napkin.ai
Alla base, la NLU consiste nel trasformare dati linguistici non strutturati in informazioni strutturate con cui le macchine possano lavorare. Ciò implica compiti come identificare le entità in una frase, determinare il sentiment di un’affermazione o classificare l’intento alla base della richiesta di un utente.
Ad esempio, quando qualcuno dice: "Prenota un volo per New York", un sistema NLU deve riconoscere "prenota" come azione, "volo" come oggetto e "New York" come destinazione.
La natural language understanding (NLU) si basa su una combinazione di regole linguistico-grammaticali, algoritmi di machine learning e modelli statistici per interpretare con precisione il linguaggio umano.
I sistemi NLU trasformano dati linguistici non strutturati in informazioni strutturate che le macchine possono utilizzare per svolgere compiti come analisi del sentiment, riconoscimento di entità e classificazione dell’intento.
La NLU moderna si basa soprattutto sul deep learning, in particolare su modelli come i transformer. Ad esempio, anche modelli multiuso come ChatGPT sono in grado di analizzare qualsiasi frase in inglese per estrarne il significato.
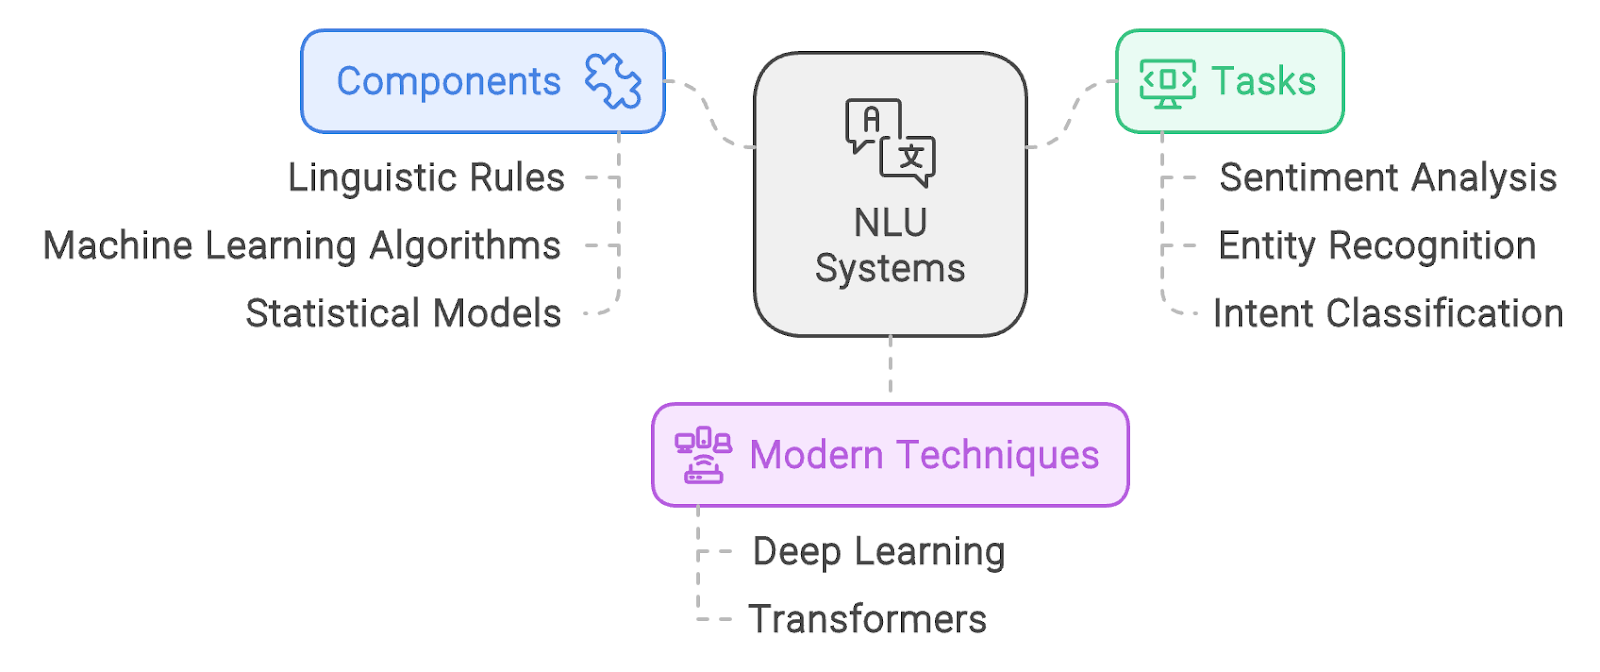
Creato con Napkin.ai
È importante chiarire che la natural language understanding (NLU) non è separata dal natural language processing (NLP), ma ne è piuttosto una componente fondamentale. Sebbene spesso si usi il termine "NLU vs. NLP", questa impostazione è fuorviante perché la NLU è un sottoinsieme dell’NLP.
L’unico confronto significativo tra i due riguarderebbe i compiti NLP che non rientrano nella NLU. Tuttavia, ciò sposterebbe l’attenzione dalla NLU, quindi non approfondiremo questa linea di confronto.
L’NLP comprende un’ampia gamma di attività legate all’elaborazione e all’analisi del testo, mentre la NLU si concentra specificamente sulla comprensione. Per esempio, mentre l’NLP può includere attività come il riconoscimento vocale o la generazione di testo, la NLU riguarda la comprensione del significato del testo in input—cosa l’utente sta cercando di dire e perché.
La tabella seguente evidenzia alcune delle principali differenze tra i due:
|
Aspetto |
NLP |
NLU |
|
Ambito |
Ampio (include tutti gli aspetti dell’elaborazione e della generazione del linguaggio umano) |
Ristretto (focalizzato specificamente sulla comprensione di significato, intento e contesto) |
|
Esempi di compiti |
Riconoscimento vocale, generazione di testo, traduzione automatica |
Riconoscimento di entità, classificazione dell’intento, analisi del sentiment |
|
Focus |
Sia comprensione sia generazione del linguaggio |
Comprensione del significato e dell’intento del linguaggio |
Questa tabella dimostra che, mentre l’NLP copre una vasta gamma di attività che coinvolgono sia la comprensione sia la generazione del linguaggio umano, la NLU è focalizzata specificamente sulla comprensione.
La natural language understanding (NLU) è al centro di molte applicazioni guidate dall’IA. Consente alle macchine (per esempio, i chatbot) di interagire con gli esseri umani in modi che risultano intuitivi e naturali. Di seguito alcune aree chiave in cui la NLU sta avendo un impatto significativo, insieme ad esempi di strumenti moderni per ciascuna.
Una delle principali applicazioni della NLU è nei chatbot e negli assistenti virtuali. Questi sistemi si basano sulla NLU per interpretare e rispondere con precisione alle richieste degli utenti.
Per esempio, quando un utente chiede: "Puoi trovarmi un bar vicino?" la componente NLU aiuta il sistema a capire che l’utente sta cercando un bar vicino alla sua posizione attuale, permettendo al chatbot o all’assistente di fornire una risposta pertinente.
Oltre alla comprensione delle singole richieste, la NLU è essenziale per mantenere il flusso della conversazione. Consente a chatbot e assistenti virtuali di tenere traccia del contesto, permettendo interazioni più naturali e coerenti. Ad esempio, se un utente si arrabbia con il chatbot, questo lo capirà e risponderà di conseguenza.
Uno strumento popolare per creare chatbot con funzionalità NLU avanzate è il framework Rasa. Si tratta di una libreria open source usata per creare chatbot con funzionalità NLU avanzate.
L’analisi del sentiment è un’altra applicazione fondamentale della NLU, ed è ampiamente utilizzata per misurare l’opinione pubblica e il feedback dei clienti.
Le aziende usano la NLU per analizzare il sentiment espresso nelle recensioni dei clienti, nei post sui social media e in altre forme di feedback, per determinare se il sentiment generale è positivo o negativo.
Uno strumento comunemente usato per l’analisi del sentiment che vale la pena citare è VADER (Valence Aware Dictionary and sEntiment Reasoner). È uno strumento open source basato su regole, progettato specificamente per comprendere il sentiment nei social media.
La NLU svolge un ruolo fondamentale nei compiti di classificazione del testo, come il filtraggio dello spam. Analizzando il contenuto e l’intento dietro email o messaggi, i sistemi NLU possono distinguere in modo efficace tra ham e spam.
Due strumenti popolari per la classificazione del testo sono SpaCy e NLTK (Natural Language Toolkit).
SpaCy è una libreria open source progettata per un NLP efficiente e veloce in Python, che offre modelli pre-addestrati da perfezionare per vari compiti di classificazione del testo.
NLTK è un’altra potente libreria Python che fornisce strumenti semplici da usare per attività come tokenizzazione, part-of-speech tagging e classificazione del testo. Entrambe le librerie possono essere utilizzate per costruire pipeline di classificazione del testo.
La NLU è spesso definita un problema AI-hard, ossia uno dei campi più complessi e impegnativi dell’IA. La difficoltà risiede nelle sfumature del linguaggio umano—ambiguità, modi di dire, contesto e differenze culturali contribuiscono tutti alla complessità.
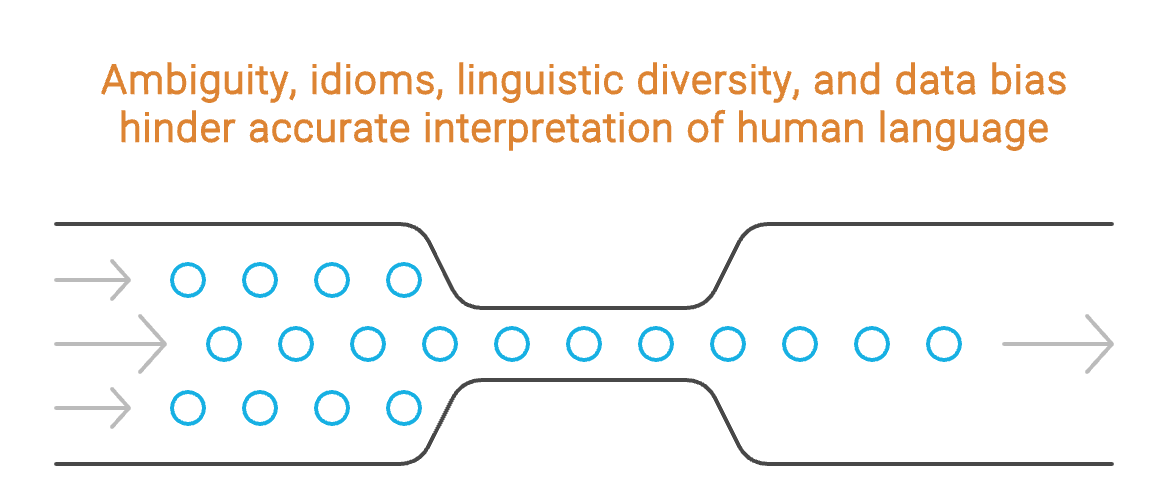
Creato con Napkin.ai
Una delle sfide più significative nella NLU è gestire l’intrinseca ambiguità delle lingue umane.
Una singola frase può spesso essere interpretata in più modi. Considera, ad esempio, la frase: “Ho visto un uomo con il binocolo.” Questa frase può significare che abbiamo visto l’uomo usando il binocolo oppure che l’uomo che abbiamo visto aveva un binocolo.
Disambiguare frasi di questo tipo richiede la comprensione del contesto, qualcosa di relativamente semplice per gli umani ma che rimane una notevole sfida per le macchine.
Le espressioni idiomatiche e il linguaggio figurato aggiungono un ulteriore livello di complessità alla NLU. Frasi come "tirare le cuoia" o "vuotare il sacco" hanno significati che non sono direttamente collegati all’interpretazione letterale delle parole.
Per interpretare correttamente tali espressioni, i sistemi NLU devono essere addestrati su grandi quantità di dati che includano queste sfumature culturali e linguistiche, le quali possono variare ampiamente tra lingue e regioni diverse.
La lingua non è uniforme. Varia in modo significativo tra culture, regioni e persino gruppi sociali. Un sistema NLU che funziona bene in una lingua o in un contesto culturale può fallire in un altro.
Ad esempio, gerghi, dialetti ed espressioni regionali possono essere difficili da interpretare correttamente per i sistemi NLU. Costruire sistemi in grado di gestire questa diversità richiede dati di addestramento estesi e diversificati, spesso difficili da reperire.
Il bias nei dati di addestramento rappresenta un’altra grande sfida per i sistemi NLU. Se i dati utilizzati per addestrare un modello NLU sono distorti, le previsioni e le interpretazioni del modello rifletteranno tale distorsione.
Ad esempio, se un modello è addestrato su testi provenienti da una particolare demografia, potrebbe non funzionare bene nell’interpretare il linguaggio di demografie diverse.
La natural language understanding (NLU) è un importante sottoinsieme dell’IA e dell’NLP che si concentra nel permettere alle macchine di comprendere e interpretare con precisione il linguaggio umano.
Comprendendo i principi e le sfide della NLU, incluso il suo ruolo nel più ampio contesto dell’NLP, puoi apprezzare la complessità e l’importanza della comprensione del linguaggio naturale.
Impara l’NLP con questi corsi!
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




