Kurs
Feature Engineering für NLP in Python
4 Std.
29.6K
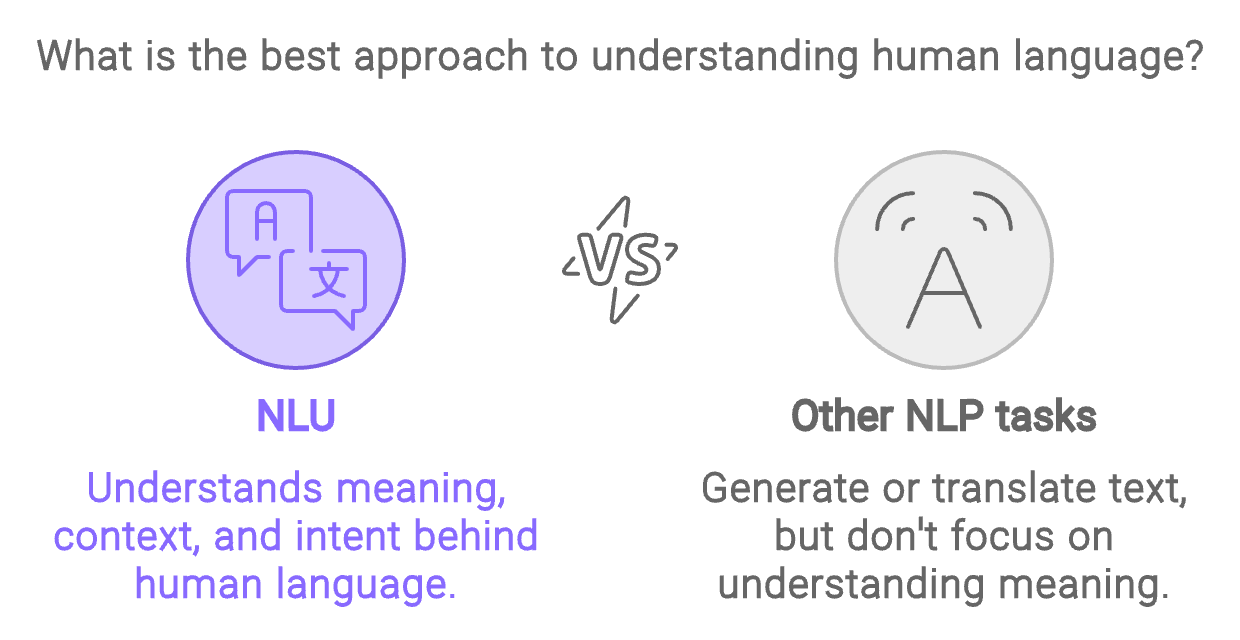
Natural Language Understanding (NLU) ist ein Teilgebiet der Natural Language Processing (NLP) und hat zum Ziel, Maschinen das Verstehen und Interpretieren menschlicher Sprache zu ermöglichen.
Anders als andere NLP-Aufgaben, die etwa Texterzeugung oder Übersetzung umfassen, konzentriert sich NLU gezielt auf das Verstehen von Bedeutung, Kontext und Absicht hinter den Wörtern und Formulierungen, die Menschen verwenden.
Erstellt mit Napkin.ai
Im Kern geht es bei NLU darum, unstrukturierte Sprachdaten in strukturierte Informationen zu überführen, mit denen Maschinen arbeiten können. Dazu gehören Aufgaben wie das Erkennen von Entitäten in einem Satz, die Bestimmung der Stimmung einer Aussage oder die Klassifizierung der Absicht hinter einer Nutzeranfrage.
Sagt jemand zum Beispiel: "Buche einen Flug nach New York", muss ein NLU-System "buche" als Aktion, "Flug" als Objekt und "New York" als Reiseziel erkennen.
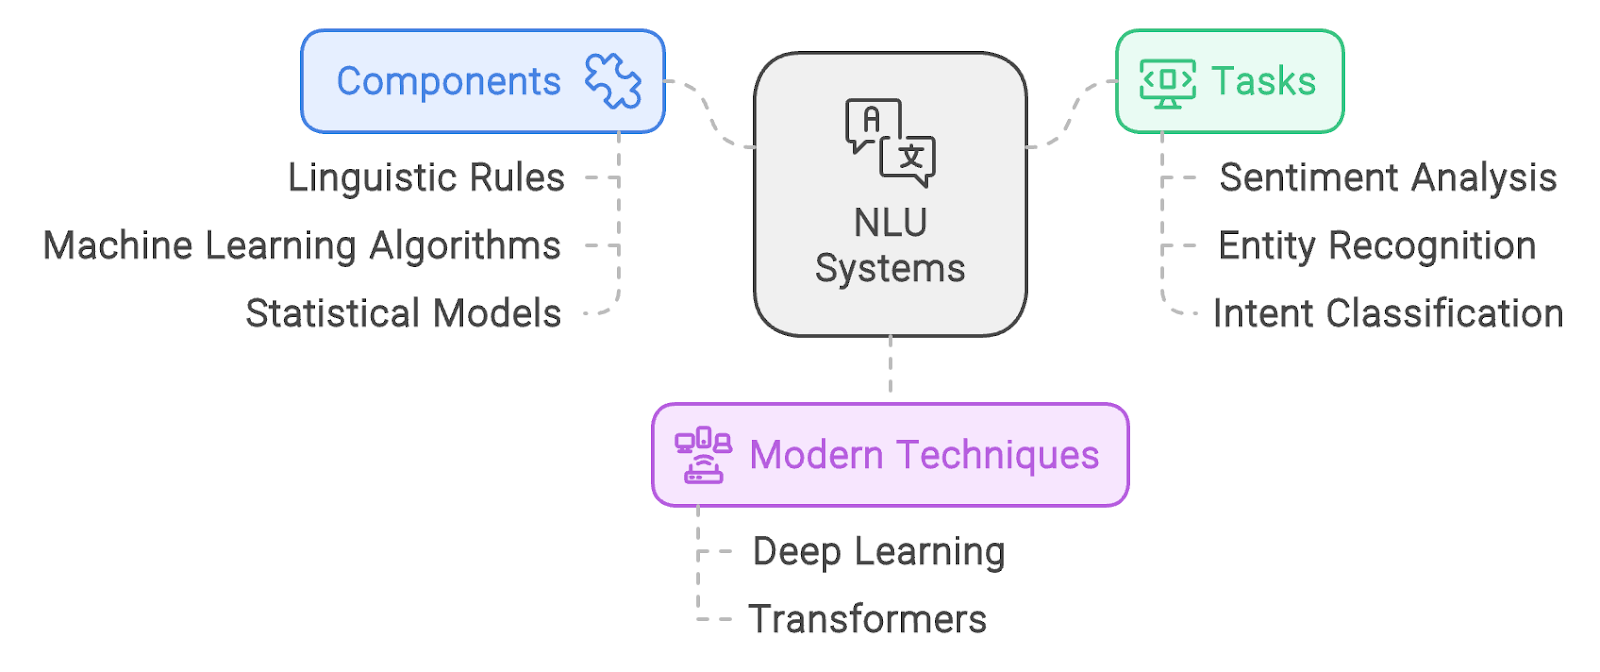
Natural Language Understanding (NLU) stützt sich auf eine Kombination aus linguistischen Regeln, maschinellen Lernalgorithmen und statistischen Modellen, um menschliche Sprache präzise zu interpretieren.
NLU-Systeme verwandeln unstrukturierte Sprachdaten in strukturierte Informationen, die Maschinen für Aufgaben wie Sentiment-Analyse, Entitätserkennung und Intent-Klassifikation nutzen können.
Moderne NLU basiert überwiegend auf Deep Learning, insbesondere auf Modellen wie Transformern. Selbst vielseitige Modelle wie ChatGPT können beispielsweise beliebige englische Sätze parsen und deren Bedeutung extrahieren.
Erstellt mit Napkin.ai
Wichtig ist: Natural Language Understanding (NLU) ist kein Gegenentwurf zu Natural Language Processing (NLP), sondern ein zentraler Bestandteil davon. Der geläufige Ausdruck "NLU vs. NLP" ist irreführend, denn NLU ist eine Teilmenge von NLP.
Sinnvoll vergleichen ließen sich lediglich NLP-Aufgaben, die nicht unter NLU fallen. Das würde den Fokus jedoch von NLU weglenken, daher verfolgen wir diesen Vergleich hier nicht weiter.
NLP umfasst ein breites Spektrum an Aufgaben zur Verarbeitung und Analyse von Text, während NLU speziell auf das Verstehen abzielt. Während NLP zum Beispiel Spracherkennung oder Texterzeugung beinhaltet, geht es bei NLU darum, die Bedeutung des Eingabetextes zu erfassen — was die Nutzerin oder der Nutzer sagen will und warum.
Die folgende Tabelle zeigt zentrale Unterschiede der beiden Bereiche:
|
Aspekt |
NLP |
NLU |
|
Umfang |
Breit (umfasst alle Aspekte der Verarbeitung und Erzeugung menschlicher Sprache) |
Eng (fokussiert auf das Verstehen von Bedeutung, Absicht und Kontext) |
|
Beispielaufgaben |
Spracherkennung, Texterzeugung, maschinelle Übersetzung |
Entitätserkennung, Intent-Klassifikation, Sentiment-Analyse |
|
Fokus |
Verstehen und Erzeugen von Sprache |
Verstehen von Bedeutung und Absicht |
Damit wird deutlich: NLP deckt ein breites Aufgabenspektrum rund um das Verstehen und Erzeugen menschlicher Sprache ab, während NLU gezielt auf das Verstehen ausgerichtet ist.
Natural Language Understanding (NLU) ist das Herzstück vieler KI-getriebener Anwendungen. Es ermöglicht Maschinen (zum Beispiel Chatbots), mit Menschen natürlich und intuitiv zu interagieren. Im Folgenden findest du zentrale Einsatzbereiche von NLU sowie Beispiele für moderne Tools.
Ein Hauptanwendungsfall von NLU sind Chatbots und virtuelle Assistenten. Diese Systeme sind auf NLU angewiesen, um Nutzeranfragen korrekt zu interpretieren und zu beantworten.
Fragt eine Person etwa: "Kannst du mir ein Café in der Nähe finden?", hilft die NLU-Komponente dem System zu verstehen, dass ein Café in der aktuellen Umgebung gesucht wird — und liefert eine passende Antwort.
Über das Verstehen einzelner Fragen hinaus ist NLU essenziell für einen natürlichen Gesprächsfluss. Chatbots und Assistenten können so den Kontext mitführen und schlüssig reagieren. Wird der oder die Nutzende beispielsweise wütend, erkennt das der Bot und reagiert entsprechend.
Ein beliebtes Tool zum Aufbau von Chatbots mit fortgeschrittenen NLU-Funktionen ist das Rasa-Framework. Es ist eine Open-Source-Bibliothek zum Erstellen von Chatbots mit erweiterten NLU-Fähigkeiten.
Die Sentiment-Analyse ist ein weiterer zentraler NLU-Anwendungsfall und wird breit genutzt, um öffentliche Meinung und Kundenfeedback einzuordnen.
Unternehmen analysieren mit NLU die Stimmung in Bewertungen, Social-Media-Posts und anderem Feedback, um zu bestimmen, ob die Tendenz positiv oder negativ ist.
Ein häufig genutztes Tool für Sentiment-Analysen ist VADER (Valence Aware Dictionary and sEntiment Reasoner). Es ist ein regelbasiertes Open-Source-Tool, das speziell für die Stimmungsanalyse in sozialen Medien entwickelt wurde.
NLU spielt eine zentrale Rolle bei Textklassifikationsaufgaben wie Spamfiltering. Durch Analyse von Inhalt und Absicht in E-Mails oder Nachrichten können NLU-Systeme zuverlässig zwischen Ham und Spam unterscheiden.
Zwei beliebte Tools für die Textklassifikation sind SpaCy und NLTK (Natural Language Toolkit).
SpaCy ist eine Open-Source-Bibliothek für effizientes und schnelles NLP in Python und bietet vortrainierte Modelle, die sich für verschiedene Textklassifikationsaufgaben feinabstimmen lassen.
NLTK ist eine weitere leistungsfähige Python-Bibliothek mit leicht nutzbaren Tools für Tokenisierung, Part-of-Speech-Tagging und Textklassifikation. Mit beiden Bibliotheken lassen sich Textklassifikations-Pipelines aufbauen.
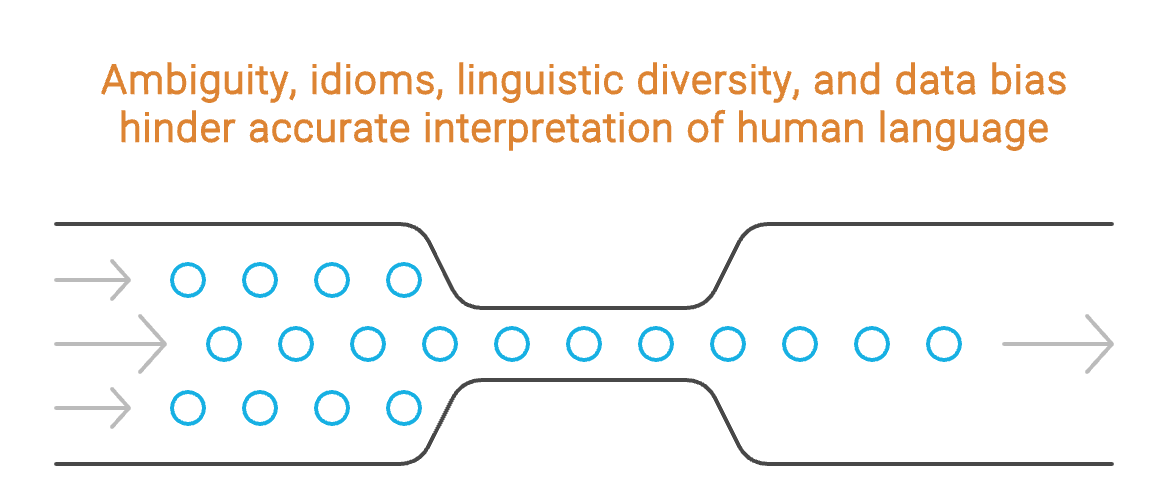
NLU gilt oft als "AI-hard" — eines der komplexesten und schwierigsten Felder der KI. Die Schwierigkeit liegt in den Feinheiten menschlicher Sprache: Mehrdeutigkeiten, Redewendungen, Kontext und kulturelle Unterschiede erhöhen die Komplexität erheblich.
Erstellt mit Napkin.ai
Eine der größten Herausforderungen in NLU ist der Umgang mit der inhärenten Mehrdeutigkeit menschlicher Sprachen.
Ein einzelner Satz lässt sich oft auf mehrere Arten interpretieren. Betrachte zum Beispiel: „Ich sah einen Mann mit einem Fernglas.“ Das kann bedeuten, dass wir das Fernglas benutzten, um den Mann zu sehen, oder dass der Mann, den wir sahen, ein Fernglas hatte.
Solche Sätze zu entwirren, erfordert Kontext — für Menschen meist intuitiv, für Maschinen jedoch weiterhin anspruchsvoll.
Idiomatische Ausdrücke und bildhafte Sprache erhöhen die Komplexität zusätzlich. Wendungen wie "kick the bucket" oder "spill the beans" haben Bedeutungen, die sich nicht aus der wörtlichen Übersetzung ergeben.
Damit NLU-Systeme solche Ausdrücke korrekt deuten, müssen sie mit umfangreichen Daten trainiert werden, die diese kulturellen und sprachlichen Nuancen abbilden — und die variieren je nach Sprache und Region stark.
Sprache ist nicht einheitlich. Sie unterscheidet sich stark zwischen Kulturen, Regionen und sozialen Gruppen. Ein NLU-System, das in einem Kontext gut funktioniert, kann in einem anderen scheitern.
Umgangssprachliche Ausdrücke, Dialekte und regionale Redewendungen sind für NLU-Systeme besonders herausfordernd. Solche Systeme zu bauen, verlangt umfangreiche und vielfältige Trainingsdaten, die oft schwer zu beschaffen sind.
Bias in Trainingsdaten ist eine weitere große Herausforderung. Sind die Daten verzerrt, spiegelt das Modell diese Verzerrungen in seinen Vorhersagen und Interpretationen wider.
Wird ein Modell zum Beispiel vorwiegend mit Texten einer bestimmten Bevölkerungsgruppe trainiert, kann es Sprache anderer Gruppen schlechter verstehen.
Natural Language Understanding (NLU) ist ein wichtiges Teilgebiet von KI und NLP, das Maschinen befähigt, menschliche Sprache präzise zu verstehen und zu interpretieren.
Wenn du die Grundlagen und Herausforderungen von NLU und seine Rolle im größeren Kontext von NLP kennst, erkennst du die Komplexität und Relevanz dieses Feldes.
Lerne NLP mit diesen Kursen!
Kurs