如果您一直关注科技领域,应该已经听过“大语言模型(LLMs)”这一术语。LLM 目前是最热门的技术词汇之一,其在人工智能(AI)世界中的重要性与日俱增。随着这些模型学习处理人类语言,如 ChatGPT 和 Bard,LLM 持续推动着生成式 AI 的革命。
凭借深度自然语言处理(NLP)系统模拟人类对话的能力,LLM 已在当今不断演进的市场中占据一席之地。自然,万物皆有局限,AI 助手也面临其独特挑战。
其中一个独特挑战就是潜在的 LLM 偏见,而这种偏见深植于用于训练模型的数据之中。
了解 LLM
让我们回到起点。什么是 LLM?
LLM 是如 ChatGPT 之类用于建模和处理人类语言的 AI 系统。这是一类利用深度学习技术来总结、生成和预测新内容的 AI 算法。之所以称为“大型”,是因为该模型需要以数百万甚至数十亿参数进行训练,并以“大”规模的文本语料作为训练数据。
LLM 与 NLP 相辅相成,它们旨在高度理解人类语言及其模式,并通过大型数据集习得知识。
如果您刚接触 LLM 领域,建议先阅读以下文章以快速入门:
什么是 LLM?大语言模型及其工作原理指南。或者参加我们的 大语言模型(LLM)概念课程,同样非常适合学习 LLM。
LLM 的使用场景
LLM 已在不同类型的 AI 应用中得到广泛使用。其受欢迎程度与日俱增,企业也在探索如何将其集成到现有系统和工具中,以提升工作流效率。
LLM 可用于以下场景:
- 内容创作
- 情感分析
- 客户服务
- 语言翻译
- 聊天机器人
- 个性化营销
- 数据分析
- 等等。
LLM 背后的机制
LLM 的预测与语言生成过程
LLM 使用 Transformer 模型,这是一种通过序列数据分析来学习上下文与理解的深度学习架构。
分词是指将输入文本拆分为称为 token 的更小单元,供模型通过数学运算进行处理与分析,以发现不同 token 之间的关系。该数学过程采用概率方法,在模型训练阶段预测下一段词序列。
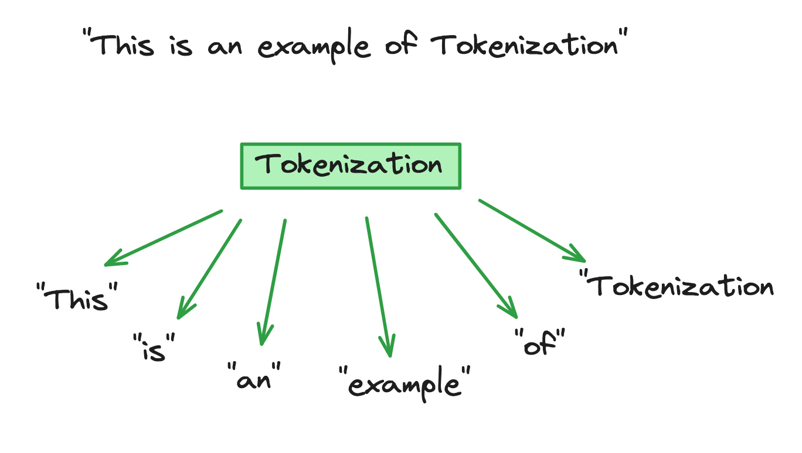
分词示例
训练阶段向模型输入海量文本数据,帮助模型理解多种语言环境、细微差别与风格。LLM 会构建一个知识库,从而能够有效地模拟人类语言。
语言理解与任务处理的多样性
LLM 所具备的多样性与语言理解能力,充分体现了其先进的 AI 实力。它们在来自不同体裁与风格(如法律文档和虚构叙事)的海量数据集上训练,使之能够适应不同情境与语境。
然而,LLM 的多样性不仅限于文本预测。能够处理不同语言、不同语境与不同输出形式的任务,这种多样性也体现在诸如客户服务等多种适配性应用中。这得益于在大型特定数据集上的广泛训练以及微调过程,从而提升了其在各领域的有效性。
不过,我们必须记住 LLM 的独特挑战:偏见。
LLM 中的偏见问题
众所周知,LLM 是在来自多种来源的多样化文本数据上训练而成。当数据被输入模型后,它会将这些数据作为唯一的知识库,并将其视为事实。然而,数据中可能夹杂偏见及错误信息,进而导致 LLM 的输出反映出偏见。
这类旨在提升生产力、协助日常任务的工具,也暴露出伦理方面的担忧。您可以在我们的课程中进一步了解 AI 伦理。
识别偏见
数据越多越好。但如果用于 LLM 训练的数据包含不具代表性的样本或偏见,模型自然会继承并学习这些偏见。LLM 偏见的例子包括性别偏见、种族偏见和文化偏见。
例如,如果大部分数据呈现“女性多为清洁工或护士,男性多为工程师或 CEO”,那么 LLM 就可能对性别存在偏见。由于训练数据的输入,LLM 继承了社会刻板印象。另一个例子是种族偏见,LLM 可能以刻板印象来反映某些族裔群体;还有文化偏见,通过过度呈现来迎合刻板印象。
LLM 偏见的两大来源是:
- 数据来源
- 人工评估
尽管 LLM 十分多才多艺,但这一挑战表明它在处理多元文化内容时效果较差。围绕 LLM 与偏见的担忧,归根结底在于其被用于决策过程,这自然引发伦理问题。
LLM 偏见的影响
LLM 中的偏见会同时影响模型用户与更广泛的社会。
-
强化刻板印象
如上所述,刻板印象类型多样,如文化和性别。LLM 训练数据中的偏见会持续强化这些有害的刻板印象,使社会困于偏见循环,有效阻碍社会进步。
如果 LLM 持续摄入带偏见的数据,它们就会不断加剧文化分裂与性别不平等。
-
歧视
歧视是基于性别、种族、年龄或残障等对不同人群的不公正对待。训练数据可能存在严重代表性不足的问题,无法真实呈现不同群体。
LLM 产生的偏见性输出若持续维系种族、性别和年龄歧视,会对边缘化群体的日常生活带来负面影响,例如招聘录用流程或受教育机会。这会导致 LLM 输出缺乏多样性与包容性,并引发伦理担忧,因为这些输出可能进一步被用于决策过程。
-
错误信息与虚假信息
如果用于 LLM 训练的数据存在样本不具代表性或偏见,也会引发数据是否准确的问题。通过 LLM 传播错误信息或虚假信息会带来严重后果。
例如,在医疗领域,使用含有偏见信息的 LLM 可能导致危险的健康决策。再如,LLM 若包含政治偏见数据并推动相关叙事,可能导致政治虚假信息的传播。
-
信任
围绕 LLM 的伦理担忧并非社会上有人不愿意在日常生活中引入 AI 系统的唯一原因。部分人对 AI 系统的使用及其对社会的影响存在顾虑,例如失业与经济不稳定。
社会对 AI 系统本就存在信任缺口。因此,LLM 产生的偏见可能彻底削弱社会对整体 AI 系统的信任与信心。要让社会自信地接纳 LLM 技术,首先需要建立信任。
缓解 LLM 偏见的策略
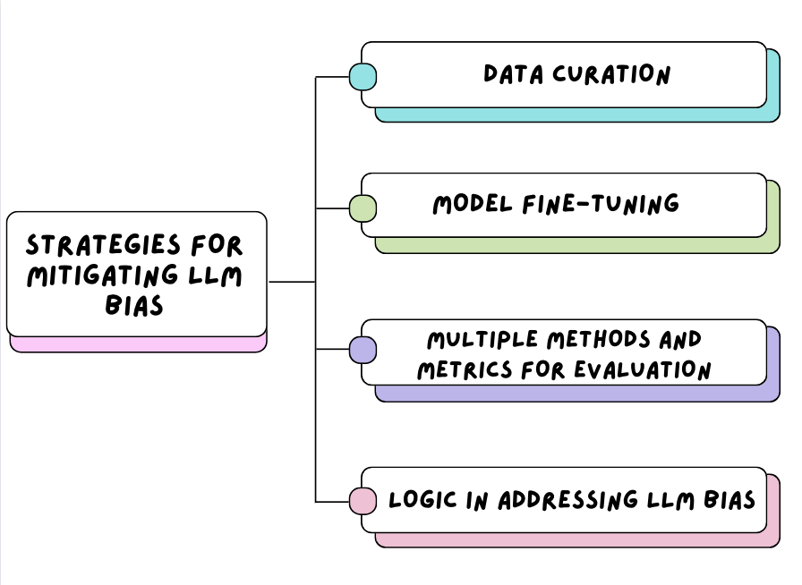
缓解 LLM 偏见的策略
数据策划
先从源头——数据——入手。企业必须对输入模型的数据类型负起高度责任。
确保用于 LLM 的训练数据来自多元的数据来源。来自不同人口统计、语言与文化的文本数据集将平衡对人类语言的呈现。这可确保训练数据不含不具代表性的样本,并为有针对性的模型微调提供指引,从而在更广泛的使用场景中降低偏见的影响。
模型微调
当收集并输入多样化的数据来源后,组织可以通过模型微调持续提升准确性并降低偏见。常见的微调方法包括:
- 迁移学习:使用预训练模型并基于更小且更特定的数据集进行进一步训练,以微调模型输出。例如,用一般文本数据预训练模型,再以法律文档进行微调。
- 偏见消减技术:组织也应更进一步,在流程中引入偏见检测工具,以发现并缓解训练数据中的偏见。比如,反事实数据增强方法通过修改训练数据来打破刻板数据,从而减少模型中的性别、种族或文化偏见。
您可以通过我们的 LLaMA 2 微调教程进一步了解微调过程,其中提供了调整预训练模型的分步指南。
多种评估方法与指标
为持续发展能够安全融入当今社会的 AI 系统,组织需要在评估过程中采用多种方法与指标。在 LLM 等 AI 系统向更广泛社区开放之前,必须实施正确的方法与指标,以确保捕捉到 LLM 输出中不同维度的偏见。
方法示例包括人工评估、自动化评估或混合评估。这些方法用于检测、估计或过滤 LLM 的偏见。指标示例包括准确率、情感、公平性等。这些指标可以为 LLM 输出中的偏见提供反馈,并帮助持续改进对偏见的检测与缓解。
若您想进一步了解用于提升 LLM 质量的不同评估方式,请观看我们的代码演练:评估 LLM 响应。
以逻辑应对 LLM 偏见
麻省理工学院计算机科学与人工智能实验室(CSAIL)的一项研究通过融入逻辑推理,在 LLM 方面取得重要进展:大型语言模型存在偏见。逻辑能否帮助挽救它们?
在 LLM 中引入逻辑与结构化思维,使模型能够在生成输出时应用逻辑推理与批判性思维,从而基于推理过程提供更为准确的回答。
这一过程包括构建一个中性语言模型,其中 token 之间的关系被视为“中性”,因为没有逻辑表明二者存在关系。CSAIL 将该方法用于训练语言模型,结果发现新训练的模型在无需更多数据与额外算法训练的情况下,表现出更低的偏见。
具备逻辑感知的语言模型将能够避免产生有害的刻板印象。
案例研究与真实应用
Google BERT 模型的多样化训练数据
Google Research 持续改进其 LLM BERT,通过扩展训练数据来确保更具包容性与多样性。在预训练阶段使用包含未标注文本的大型数据集,使模型后续能够微调以适配特定任务。目标是打造偏见更小、输出更健壮的 LLM。Google Research 指出,该方法已显示出模型生成刻板印象输出的减少,并持续提升其对不同方言与文化语境的理解表现。
公平性指标
Google Research 团队构建了多种名为“Fairness Indicators”的工具,旨在检测机器学习模型中的偏见并进行缓解。这些指标使用诸如假阳性和假阴性等度量来评估性能,并识别可能被总体指标掩盖的差距。
OpenAI 的预训练缓解措施
OpenAI 向更广泛的社区保证,安全、隐私与伦理问题是其目标的重中之重。他们针对 DALL-E 2 的预训练缓解措施包括从训练数据集中过滤暴力与色情图像、移除彼此在视觉上相似的图像,并训练模型以缓解数据集过滤带来的影响。
在降低偏见的同时保持性能
想要兼顾二者有时并不容易。这同样适用于在降低 LLM 偏见与维持甚至提升模型性能之间寻求平衡。对模型去偏以实现公平至关重要,但不应以牺牲模型性能与准确性为代价。
需要实施审慎的策略,以确保用于降低偏见的缓解方法(如数据策划、模型微调与多方法评估)不影响模型对语言的理解与生成能力。改进固然重要,但不应以性能为交换。
这是一场不断试错、监测与调优、去偏与改进的过程。
结论
本文我们讨论了:
- LLM 是什么及其背后的机制
- LLM 偏见问题及其影响
- 如何缓解 LLM 偏见
- 以及真实世界的案例。
LLM 偏见是一个复杂且多维的挑战,必须被优先解决,才能让社会对其更为信任,并自由地将其融入日常任务。组织需要理解刻板印象对个人与社会的长期负面影响,并以此为鉴,通过数据策划、模型微调与逻辑建模来确立缓解 LLM 偏见的路径。
想进一步了解 LLM,请查看我们的 大语言模型概念课程,了解这些强大工具如何重塑 AI 版图。


如果您一直关注科技领域,应该已经听过“大语言模型(LLMs)”这一术语。LLM 目前是最热门的技术词汇之一,其在人工智能(AI)世界中的重要性与日俱增。随着这些模型学习处理人类语言,如 ChatGPT 和 Bard,LLM 持续推动着生成式 AI 的革命。
凭借深度自然语言处理(NLP)系统模拟人类对话的能力,LLM 已在当今不断演进的市场中占据一席之地。自然,万物皆有局限,AI 助手也面临其独特挑战。
其中一个独特挑战就是潜在的 LLM 偏见,而这种偏见深植于用于训练模型的数据之中。
了解 LLM
让我们回到起点。什么是 LLM?
LLM 是如 ChatGPT 之类用于建模和处理人类语言的 AI 系统。这是一类利用深度学习技术来总结、生成和预测新内容的 AI 算法。之所以称为“大型”,是因为该模型需要以数百万甚至数十亿参数进行训练,并以“大”规模的文本语料作为训练数据。
LLM 与 NLP 相辅相成,它们旨在高度理解人类语言及其模式,并通过大型数据集习得知识。
如果您刚接触 LLM 领域,建议先阅读以下文章以快速入门:
什么是 LLM?大语言模型及其工作原理指南。或者参加我们的 大语言模型(LLM)概念课程,同样非常适合学习 LLM。
LLM 的使用场景
LLM 已在不同类型的 AI 应用中得到广泛使用。其受欢迎程度与日俱增,企业也在探索如何将其集成到现有系统和工具中,以提升工作流效率。
LLM 可用于以下场景:
LLM 背后的机制
LLM 的预测与语言生成过程
LLM 使用 Transformer 模型,这是一种通过序列数据分析来学习上下文与理解的深度学习架构。
分词是指将输入文本拆分为称为 token 的更小单元,供模型通过数学运算进行处理与分析,以发现不同 token 之间的关系。该数学过程采用概率方法,在模型训练阶段预测下一段词序列。
分词示例
训练阶段向模型输入海量文本数据,帮助模型理解多种语言环境、细微差别与风格。LLM 会构建一个知识库,从而能够有效地模拟人类语言。
语言理解与任务处理的多样性
LLM 所具备的多样性与语言理解能力,充分体现了其先进的 AI 实力。它们在来自不同体裁与风格(如法律文档和虚构叙事)的海量数据集上训练,使之能够适应不同情境与语境。
然而,LLM 的多样性不仅限于文本预测。能够处理不同语言、不同语境与不同输出形式的任务,这种多样性也体现在诸如客户服务等多种适配性应用中。这得益于在大型特定数据集上的广泛训练以及微调过程,从而提升了其在各领域的有效性。
不过,我们必须记住 LLM 的独特挑战:偏见。
LLM 中的偏见问题
众所周知,LLM 是在来自多种来源的多样化文本数据上训练而成。当数据被输入模型后,它会将这些数据作为唯一的知识库,并将其视为事实。然而,数据中可能夹杂偏见及错误信息,进而导致 LLM 的输出反映出偏见。
这类旨在提升生产力、协助日常任务的工具,也暴露出伦理方面的担忧。您可以在我们的课程中进一步了解 AI 伦理。
识别偏见
数据越多越好。但如果用于 LLM 训练的数据包含不具代表性的样本或偏见,模型自然会继承并学习这些偏见。LLM 偏见的例子包括性别偏见、种族偏见和文化偏见。
例如,如果大部分数据呈现“女性多为清洁工或护士,男性多为工程师或 CEO”,那么 LLM 就可能对性别存在偏见。由于训练数据的输入,LLM 继承了社会刻板印象。另一个例子是种族偏见,LLM 可能以刻板印象来反映某些族裔群体;还有文化偏见,通过过度呈现来迎合刻板印象。
LLM 偏见的两大来源是:
尽管 LLM 十分多才多艺,但这一挑战表明它在处理多元文化内容时效果较差。围绕 LLM 与偏见的担忧,归根结底在于其被用于决策过程,这自然引发伦理问题。
LLM 偏见的影响
LLM 中的偏见会同时影响模型用户与更广泛的社会。
强化刻板印象
如上所述,刻板印象类型多样,如文化和性别。LLM 训练数据中的偏见会持续强化这些有害的刻板印象,使社会困于偏见循环,有效阻碍社会进步。
如果 LLM 持续摄入带偏见的数据,它们就会不断加剧文化分裂与性别不平等。
歧视
歧视是基于性别、种族、年龄或残障等对不同人群的不公正对待。训练数据可能存在严重代表性不足的问题,无法真实呈现不同群体。
LLM 产生的偏见性输出若持续维系种族、性别和年龄歧视,会对边缘化群体的日常生活带来负面影响,例如招聘录用流程或受教育机会。这会导致 LLM 输出缺乏多样性与包容性,并引发伦理担忧,因为这些输出可能进一步被用于决策过程。
错误信息与虚假信息
如果用于 LLM 训练的数据存在样本不具代表性或偏见,也会引发数据是否准确的问题。通过 LLM 传播错误信息或虚假信息会带来严重后果。
例如,在医疗领域,使用含有偏见信息的 LLM 可能导致危险的健康决策。再如,LLM 若包含政治偏见数据并推动相关叙事,可能导致政治虚假信息的传播。
信任
围绕 LLM 的伦理担忧并非社会上有人不愿意在日常生活中引入 AI 系统的唯一原因。部分人对 AI 系统的使用及其对社会的影响存在顾虑,例如失业与经济不稳定。
社会对 AI 系统本就存在信任缺口。因此,LLM 产生的偏见可能彻底削弱社会对整体 AI 系统的信任与信心。要让社会自信地接纳 LLM 技术,首先需要建立信任。
缓解 LLM 偏见的策略
缓解 LLM 偏见的策略
数据策划
先从源头——数据——入手。企业必须对输入模型的数据类型负起高度责任。
确保用于 LLM 的训练数据来自多元的数据来源。来自不同人口统计、语言与文化的文本数据集将平衡对人类语言的呈现。这可确保训练数据不含不具代表性的样本,并为有针对性的模型微调提供指引,从而在更广泛的使用场景中降低偏见的影响。
模型微调
当收集并输入多样化的数据来源后,组织可以通过模型微调持续提升准确性并降低偏见。常见的微调方法包括:
您可以通过我们的 LLaMA 2 微调教程进一步了解微调过程,其中提供了调整预训练模型的分步指南。
多种评估方法与指标
为持续发展能够安全融入当今社会的 AI 系统,组织需要在评估过程中采用多种方法与指标。在 LLM 等 AI 系统向更广泛社区开放之前,必须实施正确的方法与指标,以确保捕捉到 LLM 输出中不同维度的偏见。
方法示例包括人工评估、自动化评估或混合评估。这些方法用于检测、估计或过滤 LLM 的偏见。指标示例包括准确率、情感、公平性等。这些指标可以为 LLM 输出中的偏见提供反馈,并帮助持续改进对偏见的检测与缓解。
若您想进一步了解用于提升 LLM 质量的不同评估方式,请观看我们的代码演练:评估 LLM 响应。
以逻辑应对 LLM 偏见
麻省理工学院计算机科学与人工智能实验室(CSAIL)的一项研究通过融入逻辑推理,在 LLM 方面取得重要进展:大型语言模型存在偏见。逻辑能否帮助挽救它们?
在 LLM 中引入逻辑与结构化思维,使模型能够在生成输出时应用逻辑推理与批判性思维,从而基于推理过程提供更为准确的回答。
这一过程包括构建一个中性语言模型,其中 token 之间的关系被视为“中性”,因为没有逻辑表明二者存在关系。CSAIL 将该方法用于训练语言模型,结果发现新训练的模型在无需更多数据与额外算法训练的情况下,表现出更低的偏见。
具备逻辑感知的语言模型将能够避免产生有害的刻板印象。
案例研究与真实应用
Google BERT 模型的多样化训练数据
Google Research 持续改进其 LLM BERT,通过扩展训练数据来确保更具包容性与多样性。在预训练阶段使用包含未标注文本的大型数据集,使模型后续能够微调以适配特定任务。目标是打造偏见更小、输出更健壮的 LLM。Google Research 指出,该方法已显示出模型生成刻板印象输出的减少,并持续提升其对不同方言与文化语境的理解表现。
公平性指标
Google Research 团队构建了多种名为“Fairness Indicators”的工具,旨在检测机器学习模型中的偏见并进行缓解。这些指标使用诸如假阳性和假阴性等度量来评估性能,并识别可能被总体指标掩盖的差距。
OpenAI 的预训练缓解措施
OpenAI 向更广泛的社区保证,安全、隐私与伦理问题是其目标的重中之重。他们针对 DALL-E 2 的预训练缓解措施包括从训练数据集中过滤暴力与色情图像、移除彼此在视觉上相似的图像,并训练模型以缓解数据集过滤带来的影响。
在降低偏见的同时保持性能
想要兼顾二者有时并不容易。这同样适用于在降低 LLM 偏见与维持甚至提升模型性能之间寻求平衡。对模型去偏以实现公平至关重要,但不应以牺牲模型性能与准确性为代价。
需要实施审慎的策略,以确保用于降低偏见的缓解方法(如数据策划、模型微调与多方法评估)不影响模型对语言的理解与生成能力。改进固然重要,但不应以性能为交换。
这是一场不断试错、监测与调优、去偏与改进的过程。
结论
本文我们讨论了:
LLM 偏见是一个复杂且多维的挑战,必须被优先解决,才能让社会对其更为信任,并自由地将其融入日常任务。组织需要理解刻板印象对个人与社会的长期负面影响,并以此为鉴,通过数据策划、模型微调与逻辑建模来确立缓解 LLM 偏见的路径。
想进一步了解 LLM,请查看我们的 大语言模型概念课程,了解这些强大工具如何重塑 AI 版图。