
Kursus
Rekayasa Fitur untuk NLP di Python
4 jam
29.7K
Natural language understanding (NLU) adalah subbidang natural language processing (NLP) yang berfokus pada memungkinkan mesin memahami dan menafsirkan bahasa manusia.
Berbeda dengan tugas NLP lain yang mungkin melibatkan pembuatan atau penerjemahan teks, NLU secara khusus berkenaan dengan pemahaman makna, konteks, dan intent di balik kata dan frasa yang digunakan orang.
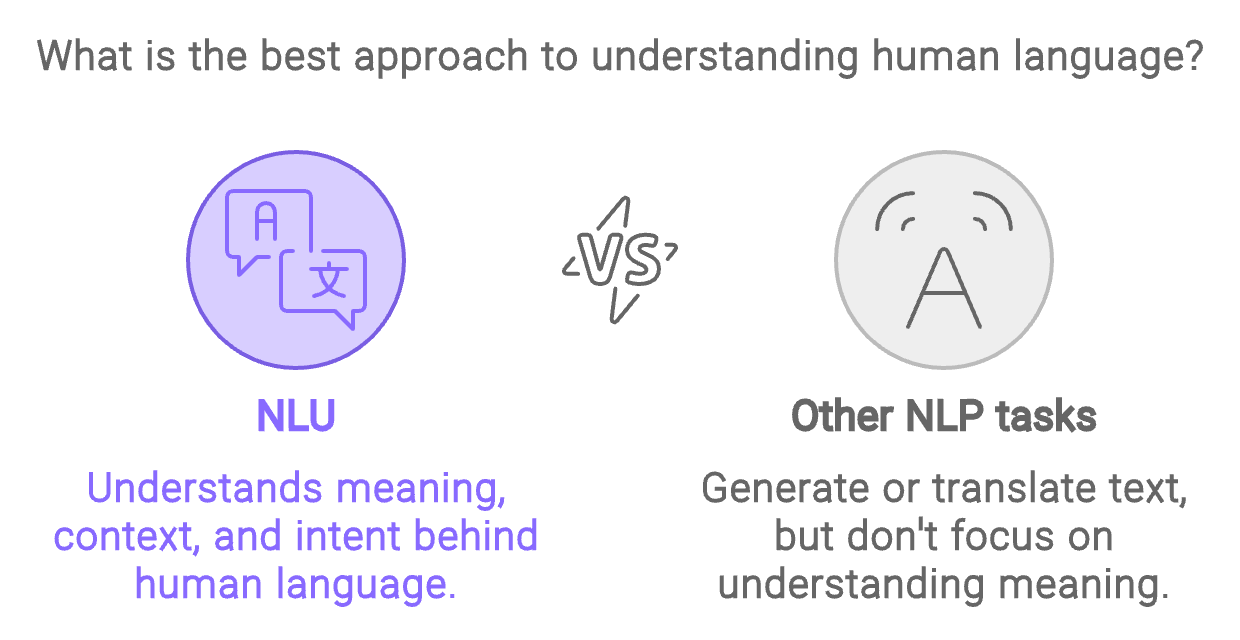
Dibuat dengan Napkin.ai
Pada intinya, NLU bertujuan mengubah data bahasa tak terstruktur menjadi informasi terstruktur yang dapat digunakan mesin. Ini melibatkan tugas seperti mengidentifikasi entitas dalam sebuah kalimat, menentukan sentimen sebuah pernyataan, atau mengklasifikasikan intent di balik kueri pengguna.
Sebagai contoh, ketika seseorang berkata, "Book a flight to New York," sistem NLU harus mengenali "book" sebagai tindakan, "flight" sebagai objek, dan "New York" sebagai tujuan.
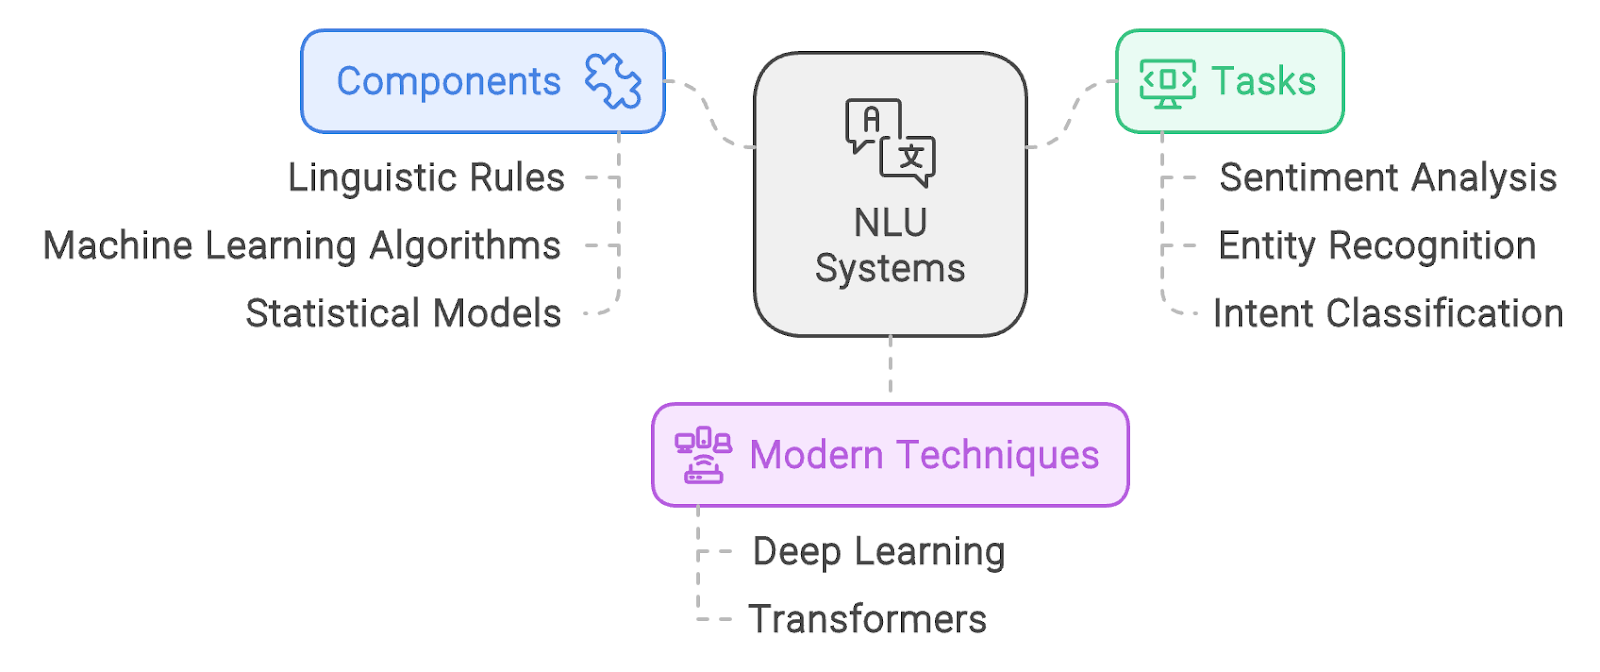
Natural language understanding (NLU) bergantung pada kombinasi kaidah linguistik, algoritme machine learning, dan model statistik untuk menafsirkan bahasa manusia secara akurat.
Sistem NLU mengubah data bahasa tak terstruktur menjadi informasi terstruktur yang dapat digunakan mesin untuk menjalankan tugas seperti analisis sentimen, pengenalan entitas, dan klasifikasi intent.
NLU modern sebagian besar mengandalkan deep learning, khususnya model seperti transformer. Misalnya, bahkan model serbaguna seperti ChatGPT mampu mengurai kalimat bahasa Inggris apa pun untuk mengekstrak maknanya.
Dibuat dengan Napkin.ai
Penting untuk memperjelas bahwa natural language understanding (NLU) bukan terpisah dari natural language processing (NLP), melainkan komponen penting di dalamnya. Meski orang sering menggunakan istilah "NLU vs. NLP," kerangka ini menyesatkan karena NLU adalah subset dari NLP.
Satu-satunya perbandingan yang bermakna di antara keduanya akan melibatkan pembahasan tugas NLP yang tidak termasuk dalam NLU. Namun, itu akan mengalihkan fokus dari NLU, jadi kami tidak akan menempuh jalur perbandingan ini.
NLP mencakup berbagai tugas terkait pemrosesan dan analisis teks, sementara NLU secara khusus berfokus pada pemahaman. Misalnya, sementara NLP mungkin melibatkan tugas seperti pengenalan ucapan atau pembuatan teks, NLU berkaitan dengan memahami makna teks masukan—apa yang ingin dikatakan pengguna dan mengapa.
Tabel di bawah menyoroti beberapa perbedaan utama antara keduanya:
|
Aspek |
NLP |
NLU |
|
Cakupan |
Luas (mencakup semua aspek pemrosesan dan pembuatan bahasa manusia) |
Sempit (berfokus khusus pada pemahaman makna, intent, dan konteks) |
|
Contoh Tugas |
Pengenalan ucapan, pembuatan teks, penerjemahan mesin |
Pengenalan entitas, klasifikasi intent, analisis sentimen |
|
Fokus |
Baik pemahaman maupun pembuatan bahasa |
Pemahaman makna dan intent bahasa |
Tabel ini menunjukkan bahwa sementara NLP mencakup beragam tugas yang melibatkan pemahaman dan pembuatan bahasa manusia, NLU secara khusus berfokus pada pemahaman.
Natural language understanding (NLU) berada di inti banyak aplikasi berbasis AI. NLU memungkinkan mesin (misalnya, chatbot) berinteraksi dengan manusia secara intuitif dan alami. Berikut beberapa area utama di mana NLU memberikan dampak signifikan, beserta contoh perangkat modern untuk masing-masingnya.
Salah satu aplikasi utama NLU adalah pada chatbot dan asisten virtual. Sistem ini bergantung pada NLU untuk menafsirkan dan merespons permintaan pengguna secara akurat.
Misalnya, ketika pengguna bertanya, "Can you find me a nearby coffee shop?" komponen NLU membantu sistem memahami bahwa pengguna mencari kedai kopi dekat lokasi saat ini, sehingga chatbot atau asisten dapat memberikan respons yang relevan.
Selain sekadar memahami kueri individual, NLU penting untuk menjaga alur percakapan. NLU memungkinkan chatbot dan asisten virtual melacak konteks, sehingga interaksi bolak-balik terasa lebih alami dan koheren. Misalnya, jika pengguna marah kepada chatbot, sistem akan memahami itu dan merespons sebagaimana mestinya.
Alat populer untuk membangun chatbot dengan kemampuan NLU tingkat lanjut adalah kerangka kerja Rasa. Ini adalah pustaka open-source untuk membangun chatbot dengan kemampuan NLU tingkat lanjut.
Analisis sentimen adalah aplikasi penting lainnya dari NLU, dan banyak digunakan untuk mengukur opini publik dan umpan balik pelanggan.
Bisnis menggunakan NLU untuk menganalisis sentimen yang diekspresikan dalam ulasan pelanggan, posting media sosial, dan bentuk umpan balik lainnya guna menentukan apakah sentimen umum bersifat positif atau negatif.
Salah satu alat analisis sentimen yang umum digunakan dan ingin saya sebutkan adalah VADER (Valence Aware Dictionary and sEntiment Reasoner). Ini adalah alat berbasis aturan open-source yang dirancang khusus untuk memahami sentimen di media sosial.
NLU berperan penting dalam tugas klasifikasi teks, seperti penyaringan spam. Dengan menganalisis konten dan intent di balik email atau pesan, sistem NLU dapat membedakan ham dan spam secara efektif.
Dua alat populer untuk klasifikasi teks adalah SpaCy dan NLTK (Natural Language Toolkit).
SpaCy adalah pustaka open-source yang dirancang untuk NLP yang efisien dan cepat di Python, menawarkan model pra-latih yang dapat di-fine-tune untuk berbagai tugas klasifikasi teks.
NLTK adalah pustaka Python kuat lainnya yang menyediakan alat mudah digunakan untuk tugas seperti tokenisasi, penandaan kelas kata, dan klasifikasi teks. Kedua pustaka ini dapat digunakan untuk membangun pipeline klasifikasi teks.
NLU sering disebut sebagai masalah yang sulit bagi AI (AI-hard), artinya ini adalah salah satu area paling kompleks dan menantang dalam AI. Kesulitannya terletak pada nuansa bahasa manusia—ambiguitas, idiom, konteks, dan perbedaan budaya semuanya berkontribusi pada kompleksitas tersebut.
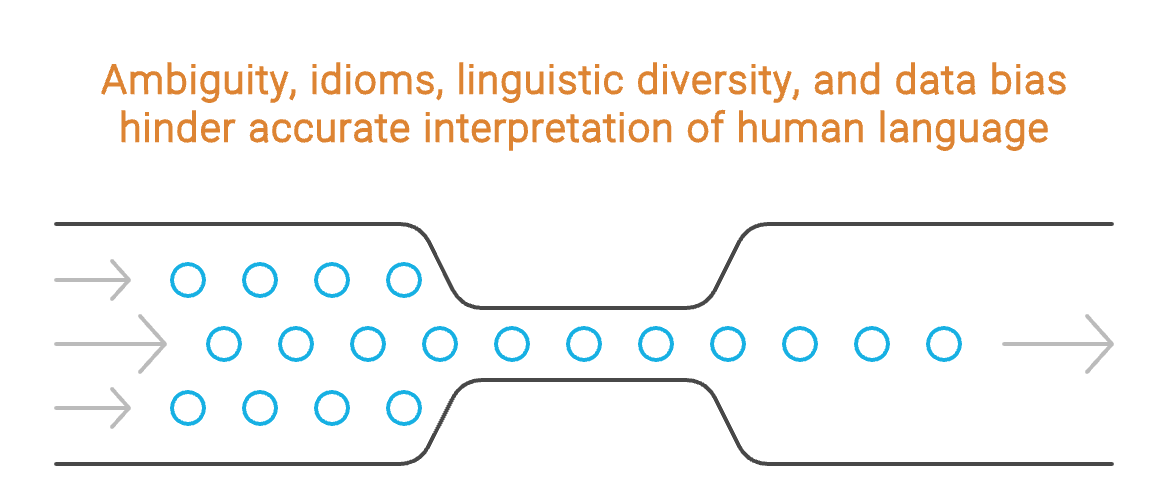
Dibuat dengan Napkin.ai
Salah satu tantangan paling signifikan dalam NLU adalah menangani ambiguitas yang melekat pada bahasa manusia.
Satu kalimat sering kali dapat ditafsirkan dengan beberapa cara. Misalnya, pertimbangkan kalimat berikut: “I saw a man with binoculars.” Kalimat ini bisa berarti kami melihat pria itu menggunakan teropong atau pria yang kami lihat membawa teropong.
Menghilangkan ambiguitas pada kalimat seperti ini memerlukan pemahaman konteks—sesuatu yang relatif mudah bagi manusia tetapi tetap menjadi tantangan besar bagi mesin.
Ungkapan idiomatik dan bahasa kiasan menambah lapisan kompleksitas lain pada NLU. Frasa seperti "kick the bucket" atau "spill the beans" memiliki makna yang tidak terkait langsung dengan tafsir literal kata-katanya.
Agar sistem NLU dapat menafsirkan ungkapan semacam itu secara akurat, sistem harus dilatih pada banyak data yang mencakup nuansa budaya dan linguistik ini, yang dapat sangat bervariasi di berbagai bahasa dan wilayah.
Bahasa tidak seragam. Bahasa sangat bervariasi di berbagai budaya, wilayah, bahkan kelompok sosial. Sistem NLU yang bekerja dengan baik dalam satu bahasa atau konteks budaya bisa gagal dalam konteks lain.
Misalnya, slang, dialek, dan ungkapan regional bisa menjadi tantangan untuk ditafsirkan dengan benar oleh sistem NLU. Membangun sistem yang dapat menangani keberagaman ini memerlukan data pelatihan yang luas dan beragam, yang sering kali sulit diperoleh.
Bias dalam data pelatihan menimbulkan tantangan signifikan lainnya bagi sistem NLU. Jika data yang digunakan untuk melatih model NLU bias, prediksi dan penafsirannya akan mencerminkan bias tersebut.
Sebagai contoh, jika model dilatih pada teks dari demografi tertentu, model tersebut mungkin tidak berkinerja baik saat menafsirkan bahasa dari demografi lain.
Natural language understanding (NLU) adalah subbidang penting dari AI dan NLP yang berfokus pada memungkinkan mesin memahami dan menafsirkan bahasa manusia secara akurat.
Dengan memahami prinsip dan tantangan NLU, termasuk perannya dalam konteks NLP yang lebih luas, Anda dapat menghargai kompleksitas dan signifikansi pemahaman bahasa alami.
Pelajari NLP dengan kursus-kursus ini!
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




