

什么是情感分析
情感分析是一种用于判断文本中所表达情绪或情感倾向的技术。它通过分析文本中使用的词汇与短语,识别其潜在的情感是正面、负面还是中性。
情感分析的应用范围很广,包括社交媒体监测、客户反馈分析和市场研究等。
情感分析的一大挑战在于人类语言本身的复杂性。文本数据常常包含讽刺、反语以及其他修辞手法,使用传统方法很难准确解读。
不过,自然语言处理(NLP)与机器学习的最新进展,使我们能够以较高准确率对海量文本数据进行情感分析。
三种情感分析方法
对文本数据进行情感分析有多种方式,复杂度与准确度各不相同。最常见的方法包括基于词典的方法、基于机器学习(ML)的方法,以及基于预训练 Transformer 的深度学习方法。下面逐一介绍:
基于词典的分析
这种分析方式(如 NLTK 的 Vader 情感分析器)使用一组预定义规则与启发式方法来判断文本的情感。这些规则通常基于文本的词汇和句法特征,例如是否包含正面或负面的词语与短语。
尽管基于词典的分析实现与解释相对简单,但在处理复杂或含糊的文本数据时,其准确性可能不及基于机器学习或基于 Transformer 的方法。
机器学习(ML)
该方法通过在带标注的训练数据上训练模型,使其学会识别文本的情感。可使用多种机器学习算法进行训练,包括决策树、支持向量机(SVM)和神经网络。
基于 ML 的方法在处理复杂文本数据时往往比基于规则的方法更准确,但需要大量标注训练数据,且计算成本更高。
基于预训练 Transformer 的深度学习
这类方法(如 BERT 和 GPT-4)使用在海量文本数据上预训练的模型。模型借助复杂的神经网络来编码文本的上下文与语义,从而在包括情感分析在内的多种 NLP 任务上达到最先进的准确率。然而,这些模型需要大量计算资源,并非所有场景都适用。
- 基于词典的分析是实现情感分析的简便方法,但准确性可能不如更复杂的方法。
- 基于机器学习的方法通常更准确,但需要带标注的训练数据,且计算成本更高。
- 基于预训练 Transformer 的深度学习方法可以达到最先进的准确率,但需要大量计算资源,未必适用于所有用例。
选择何种方法取决于项目的具体需求与约束。
安装 NLTK 并设置 Python 环境
要使用 NLTK 库,您需要在计算机上安装 Python 环境。最简单的方式是下载并安装 Anaconda 发行版。该发行版自带 Python 3 基础环境和包括 Jupyter Notebook 在内的多种实用工具。您也无需单独安装 NLTK,因为其中已预装 NLTK 及许多其他有用的库。
如果您选择不使用发行版安装 Python,可直接从 python.org 下载并安装。在这种情况下,待 Python 环境就绪后,您需要再安装 NLTK。
要安装 NLTK 库,打开命令行终端并输入:
pip install nltk需要注意的是,NLTK 在有效使用前还需要下载一些额外数据,包括预训练模型、语料库及 NLTK 执行各类 NLP 任务所需的其他资源。要下载这些数据,请在终端或您的 Python 脚本中运行以下命令:
import nltk
nltk.download('all')文本预处理
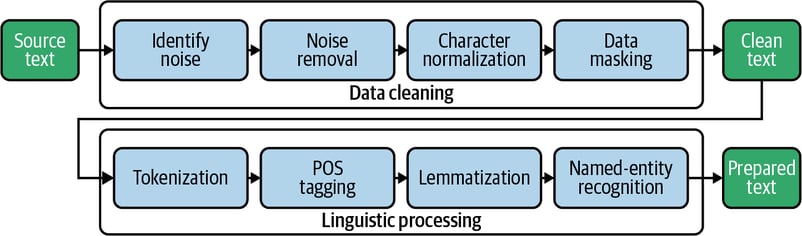
文本预处理是进行情感分析的关键步骤,它有助于清洗和规范化文本数据,从而更易于分析。预处理包含一系列技术,可将原始文本数据转换为可用于分析的形式。常见的文本预处理技术包括分词、停用词去除、词干提取与词形还原。
分词
分词是在情感分析中将文本拆分为独立词语或标记(token)的预处理步骤。这是分析文本数据的基础步骤,能够把原始文本中的词语分离开来,便于分析与理解。分词通常使用 NLTK 内置的 word_tokenize 函数来执行,该函数可以将文本拆分为词语和标点。
停用词
停用词去除是情感分析中至关重要的预处理步骤,即移除那些常见而不太携带情感信息的无关词。停用词是在一种语言中非常常见但不承载太多语义的词,如 “and”“the”“of”“it” 等。如果不去除,这些词会引入噪声并扭曲分析结果。
通过去除停用词,文本中剩余的词更可能指示所表达的情感,从而帮助提升情感分析的准确性。NLTK 为多种语言提供了内置的停用词列表,可用于从文本数据中过滤这些词。
词干提取与词形还原
词干提取和词形还原用于将词语还原为其词根形式。词干提取通过去掉词语的后缀(如 “ing”“ed”)将其还原为基础形式。例如,单词 “jumping” 会被提取为 “jump”。
词形还原则根据词性将词语还原为其基本形式。例如,单词 “jumped” 会被还原为 “jump”,但 “jumping” 作为现在分词,可能被还原为 “jumping”。
要进一步了解词干提取与词形还原,请参阅我们的 Python 中的词干提取与词形还原 教程。
词袋(BoW)模型
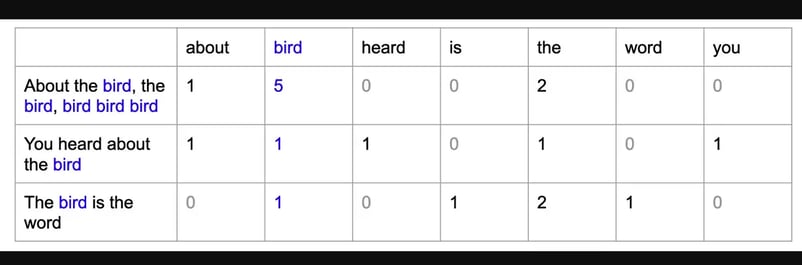
词袋模型是自然语言处理(NLP)中用于将文本数据表示为一组数值特征的技术。在该模型中,每个文档或文本被表示为一个由词语组成的“袋子”,文本中的每个词语在得到的向量中对应一个单独的特征或维度。每个特征的取值由相应词语在文本中出现的次数决定。
词袋模型在 NLP 中很有用,因为它让我们可以使用通常要求数值输入的机器学习算法来分析文本数据。通过将文本表示为数值特征,我们可以训练机器学习模型来对文本进行分类或进行情感分析。
下一节的示例将使用 NLTK 的 Vader 模型对 Amazon 客户数据集进行情感分析。在这个特定示例中,我们无需执行该步骤,因为 NLTK Vader 的 API 接受文本作为输入而非数值向量。但如果您要构建一个有监督的机器学习模型来预测情感(假设您有带标注的数据),那么在训练模型之前,您需要将处理后的文本转换为词袋模型。
Python 端到端情感分析示例
要在 Python 中使用 NLTK 进行情感分析,首先需要通过分词、停用词去除以及词干提取或词形还原等技术对文本数据进行预处理。完成预处理后,我们将把文本传递给 Vader 情感分析器,用于判断文本的情感(正面或负面)。
步骤 1 - 导入库并加载数据集
首先,我们将导入文本分析与情感分析所需的库,例如用于数据处理的 pandas、用于自然语言处理的 nltk,以及用于情感分析的 SentimentIntensityAnalyzer。
随后,我们将使用 nltk.download() 下载全部 NLTK 语料(语言学数据集合)。
环境准备就绪后,我们将使用 pd.read_csv() 加载 Amazon 评论数据集。这会在 Python 中创建一个 DataFrame 对象,方便我们分析数据。接着使用 df 显示该 DataFrame 的内容。
# import libraries
import pandas as pd
import nltk
from nltk.sentiment.vader import SentimentIntensityAnalyzer
from nltk.corpus import stopwords
from nltk.tokenize import word_tokenize
from nltk.stem import WordNetLemmatizer
# download nltk corpus (first time only)
import nltk
nltk.download('all')
# Load the amazon review dataset
df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')
df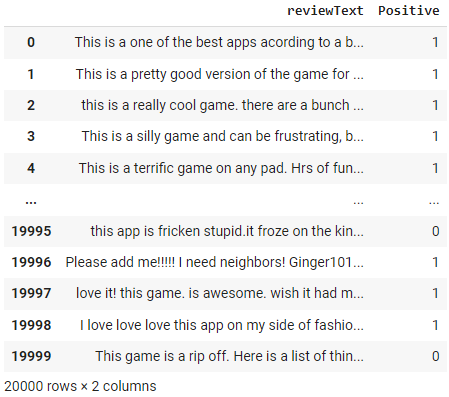
步骤 2 - 预处理文本
我们来创建一个 preprocess_text 函数:首先使用 NLTK 的 word_tokenize 对文档进行分词,然后使用 NLTK 的 stepwords 模块移除停用词,最后使用 NLTK 的 WordNetLemmatizer 对 filtered_tokens 进行词形还原。
# create preprocess_text function
def preprocess_text(text):
# Tokenize the text
tokens = word_tokenize(text.lower())
# Remove stop words
filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]
# Lemmatize the tokens
lemmatizer = WordNetLemmatizer()
lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]
# Join the tokens back into a string
processed_text = ' '.join(lemmatized_tokens)
return processed_text
# apply the function df
df['reviewText'] = df['reviewText'].apply(preprocess_text)
df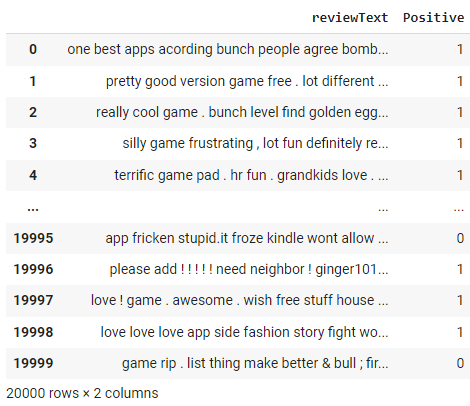
请注意,由于我们在上一步应用了 preprocess_text 函数,“review text” 列已发生变化。
步骤 3 - NLTK 情感分析器
首先,我们将从 nltk.sentiment.vader 库中初始化一个情感强度分析器对象。
接着,我们定义一个名为 get_sentiment 的函数,传入文本字符串作为输入。该函数调用分析器对象的 polarity_scores 方法获取文本的情感分数字典,其中包括正面、负面和中性情感的分数。
随后,函数会检测正面分数是否大于 0;若大于 0 则返回情感分数 1,否则返回 0。这意味着任何正面分数大于 0 的文本将被判定为正面情感,而非正面的文本将被判定为负面情感。
最后,我们将把 get_sentiment 函数应用于 df DataFrame 的 reviewText 列,创建一个名为 sentiment 的新列,用于存储每条评论的情感分数。随后使用 df 显示更新后的 DataFrame。
# initialize NLTK sentiment analyzer
analyzer = SentimentIntensityAnalyzer()
# create get_sentiment function
def get_sentiment(text):
scores = analyzer.polarity_scores(text)
sentiment = 1 if scores['pos'] > 0 else 0
return sentiment
# apply get_sentiment function
df['sentiment'] = df['reviewText'].apply(get_sentiment)
df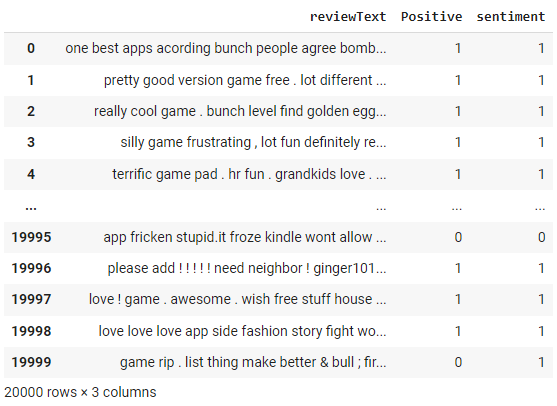
NLTK 情感分析器返回介于 -1 与 +1 之间的分数。我们在上述 get_sentiment 函数中使用了 0 作为阈值。高于 0 的被分类为 1(表示正面)。由于我们拥有真实标签,可以通过构建混淆矩阵来评估该方法的性能。
from sklearn.metrics import confusion_matrix
print(confusion_matrix(df['Positive'], df['sentiment']))输出:
[[ 1131 3636]
[ 576 14657]]我们还可以查看分类报告:
from sklearn.metrics import classification_report
print(classification_report(df['Positive'], df['sentiment']))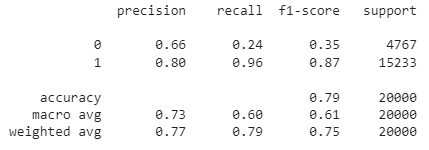
如您所见,这个基于规则的情感分析模型总体准确率为 79%。由于这是带标签的数据,您也可以尝试构建一个 ML 模型,评估基于 ML 的方法是否能获得更高的准确率。
在 Datacamp workspace 查看完整笔记本。
结语
NLTK 是一个功能强大且灵活的库,可用于在 Python 中执行情感分析及其他自然语言处理任务。借助 NLTK,我们可以预处理文本数据、将其转换为词袋模型,并使用 Vader 情感分析器进行情感分析。
通过本教程,我们介绍了 NLTK 情感分析的基础,包括预处理文本数据、构建词袋模型,以及使用 NLTK Vader 进行情感分析。我们还讨论了 NLTK 情感分析的优缺点,并提供了进一步阅读与探索的建议。
总体而言,NLTK 是在 Python 中执行情感分析与其他 NLP 任务的强大且广泛使用的工具。掌握本教程介绍的技术与工具,您将能够洞察文本数据的情感,并在广泛的应用场景中据此做出数据驱动的决策。
如果您想学习如何将 NLP 应用于真实世界数据(包括 TED 演讲、文章和电影评论),并使用包括 NLTK、scikit-learn、spaCy 与 SpeechRecognition 在内的 Python 库与框架,请查看以下资源:
它为您使用 Python 处理与分析文本数据奠定了坚实基础。无论您是 NLP 新手还是希望扩展技能,本课程都将帮助您将非结构化数据转化为有价值的洞见。
在当今数字时代,文本分析与文本挖掘已成为各行各业不可或缺的一部分。文本分析是指对非结构化文本数据进行分析并提取有意义洞见的过程。文本分析中最重要的子领域之一是情感分析,即判断文本所表达的情绪倾向。
情感分析拥有广泛的实际应用场景,从品牌舆情监测到客户反馈分析不等。Python 是进行文本分析与挖掘的流行编程语言,而自然语言工具包(NLTK)则是 Python 中最常用的自然语言处理库之一。
本教程将提供使用 Python 中的 NLTK 库进行情感分析的分步指南。完成本教程后,您将扎实掌握如何在 Python 中使用 NLTK 进行情感分析,并获得一个可直接用于您自己项目的完整示例。现在,就让我们开始吧!
自然语言工具包(NLTK)库
自然语言工具包(NLTK)是一个流行的开源 Python 自然语言处理(NLP)库。它为广泛的任务提供了易用的接口,包括分词、词干提取、词形还原、句法解析以及情感分析。
NLTK 被全球的研究人员、开发者和数据科学家广泛使用,用于构建 NLP 应用并分析文本数据。
使用 NLTK 的一大优势在于其丰富的语料库集合,涵盖来自书籍、新闻文章和社交媒体平台等多种来源的文本数据。这些语料库为训练与测试 NLP 模型提供了充足的数据来源。