Cours
Feature Engineering pour le NLP en Python
4 h
29.7K
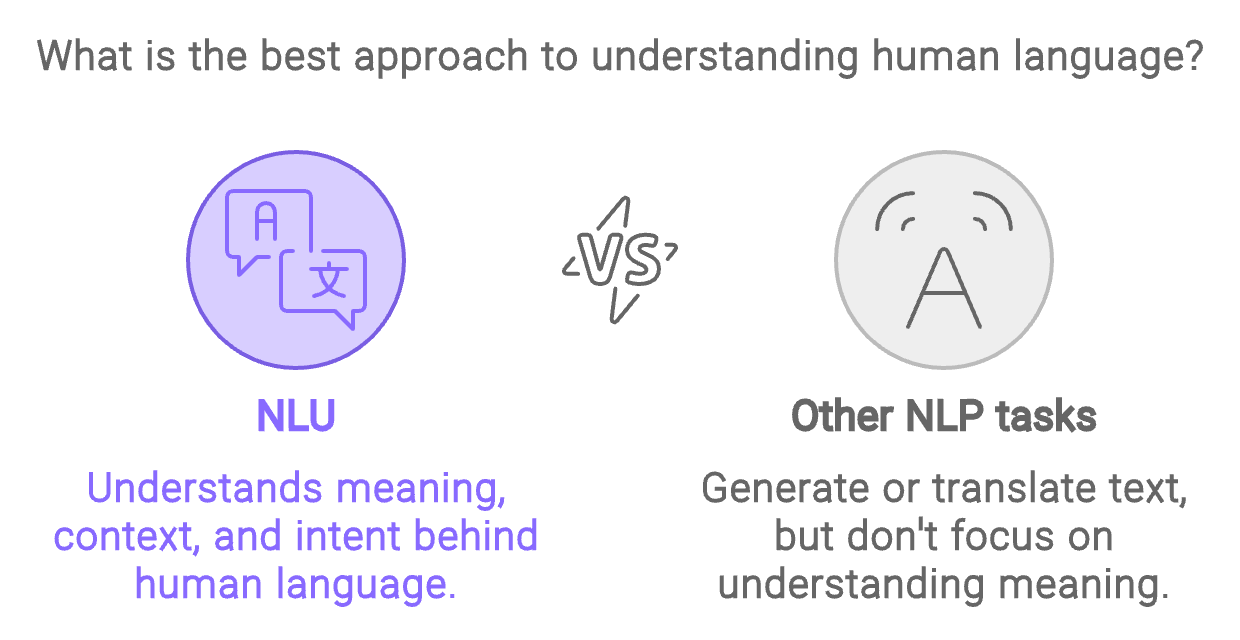
Le natural language understanding (NLU) est une sous-discipline du traitement du langage naturel (NLP) qui vise à permettre aux machines de comprendre et d’interpréter le langage humain.
À la différence d’autres tâches NLP qui peuvent consister à générer ou traduire du texte, le NLU s’intéresse spécifiquement à la compréhension du sens, du contexte et de l’intention qui sous-tendent les mots et expressions utilisés par les personnes.
Créé avec Napkin.ai
Au fond, le NLU consiste à transformer des données linguistiques non structurées en informations structurées exploitables par les machines. Cela implique des tâches comme l’identification d’entités dans une phrase, la détection du sentiment d’une affirmation ou la classification de l’intention derrière la requête d’un utilisateur.
Par exemple, lorsqu’une personne dit « Réservez un vol pour New York », un système NLU doit reconnaître « réservez » comme une action, « vol » comme l’objet et « New York » comme la destination.
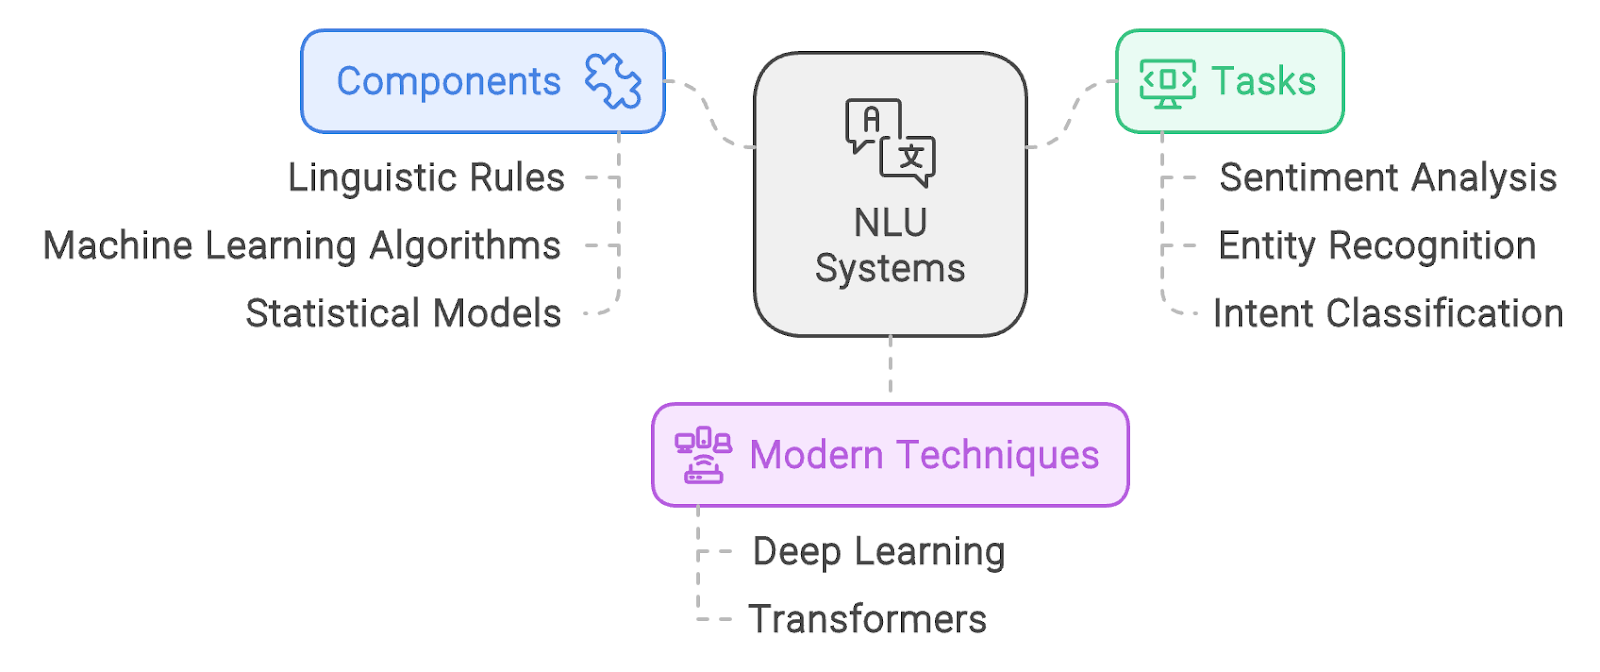
Le natural language understanding (NLU) s’appuie sur une combinaison de règles linguistiques, d’algorithmes d’apprentissage automatique et de modèles statistiques pour interpréter le langage humain avec précision.
Les systèmes NLU transforment des données linguistiques non structurées en informations structurées que les machines peuvent utiliser pour réaliser des tâches comme l’analyse de sentiments, la reconnaissance d’entités et la classification d’intentions.
Le NLU moderne repose principalement sur l’apprentissage profond, en particulier des modèles comme les transformers. Par exemple, des modèles polyvalents comme ChatGPT sont capables d’analyser n’importe quelle phrase en anglais pour en extraire le sens.
Créé avec Napkin.ai
Il est important de préciser que le natural language understanding (NLU) n’est pas distinct du traitement du langage naturel (NLP), mais en est un composant essentiel. Bien que l’on parle souvent de « NLU vs NLP », cette opposition est trompeuse, car le NLU est un sous-ensemble du NLP.
La seule comparaison pertinente consisterait à évoquer les tâches NLP qui ne relèvent pas du NLU. Cela nous éloignerait toutefois de notre sujet, nous n’approfondirons donc pas cette piste.
Le NLP couvre un large éventail de tâches liées au traitement et à l’analyse du texte, tandis que le NLU se concentre spécifiquement sur la compréhension. Par exemple, le NLP peut englober la reconnaissance vocale ou la génération de texte, alors que le NLU vise à comprendre le sens du texte d’entrée — ce que l’utilisateur cherche à dire et pourquoi.
Le tableau ci-dessous met en évidence quelques différences clés entre les deux :
|
Aspect |
NLP |
NLU |
|
Périmètre |
Large (englobe tous les aspects de traitement et de génération du langage humain) |
Restreint (axé spécifiquement sur la compréhension du sens, de l’intention et du contexte) |
|
Exemples de tâches |
Reconnaissance vocale, génération de texte, traduction automatique |
Reconnaissance d’entités, classification d’intentions, analyse de sentiments |
|
Focalisation |
Compréhension et génération du langage |
Compréhension du sens et de l’intention |
Ce tableau montre que, tandis que le NLP couvre un champ large incluant compréhension et génération du langage, le NLU se concentre exclusivement sur la compréhension.
Le natural language understanding (NLU) est au cœur de nombreuses applications d’IA. Il permet aux machines (par exemple, les chatbots) d’interagir avec les humains de manière intuitive et naturelle. Voici quelques domaines clés où le NLU a un impact majeur, ainsi que des exemples d’outils modernes pour chacun.
L’une des principales applications du NLU concerne les chatbots et assistants virtuels. Ces systèmes s’appuient sur le NLU pour interpréter et répondre avec précision aux requêtes des utilisateurs.
Par exemple, lorsqu’un utilisateur demande « Pouvez-vous me trouver un café à proximité ? », le composant NLU aide le système à comprendre que l’utilisateur recherche un café proche de sa position actuelle, ce qui permet au chatbot ou à l’assistant de fournir une réponse pertinente.
Au-delà de la compréhension de chaque requête, le NLU est essentiel pour maintenir le fil de la conversation. Il permet aux chatbots et assistants virtuels de garder le contexte, pour des échanges plus naturels et cohérents. Par exemple, si un utilisateur se fâche contre le chatbot, celui-ci le comprend et adapte sa réponse.
Un outil prisé pour créer des chatbots avec des capacités NLU avancées est le framework Rasa. C’est une bibliothèque open source utilisée pour construire des chatbots dotés de capacités NLU avancées.
L’analyse de sentiments est une autre application clé du NLU, largement utilisée pour mesurer l’opinion publique et les retours clients.
Les entreprises exploitent le NLU pour analyser le ton exprimé dans les avis clients, les publications sur les réseaux sociaux et d’autres retours, afin de déterminer si le sentiment général est positif ou négatif.
Un outil d’analyse de sentiments fréquemment utilisé est VADER (Valence Aware Dictionary and sEntiment Reasoner). C’est un outil open source, fondé sur des règles, spécialement conçu pour comprendre le sentiment sur les réseaux sociaux.
Le NLU joue un rôle central dans les tâches de classification de texte, comme le filtrage anti-spam. En analysant le contenu et l’intention des e-mails ou messages, les systèmes NLU distinguent efficacement les messages légitimes des spams.
Deux outils populaires pour la classification de texte sont SpaCy et NLTK (Natural Language Toolkit).
SpaCy est une bibliothèque open source pensée pour un NLP efficace et rapide en Python, avec des modèles pré-entraînés ajustables pour diverses tâches de classification de texte.
NLTK est une autre bibliothèque Python puissante, qui propose des outils simples d’utilisation pour la tokenisation, l’étiquetage morpho-syntaxique et la classification de texte. Les deux peuvent servir à construire des pipelines de classification.
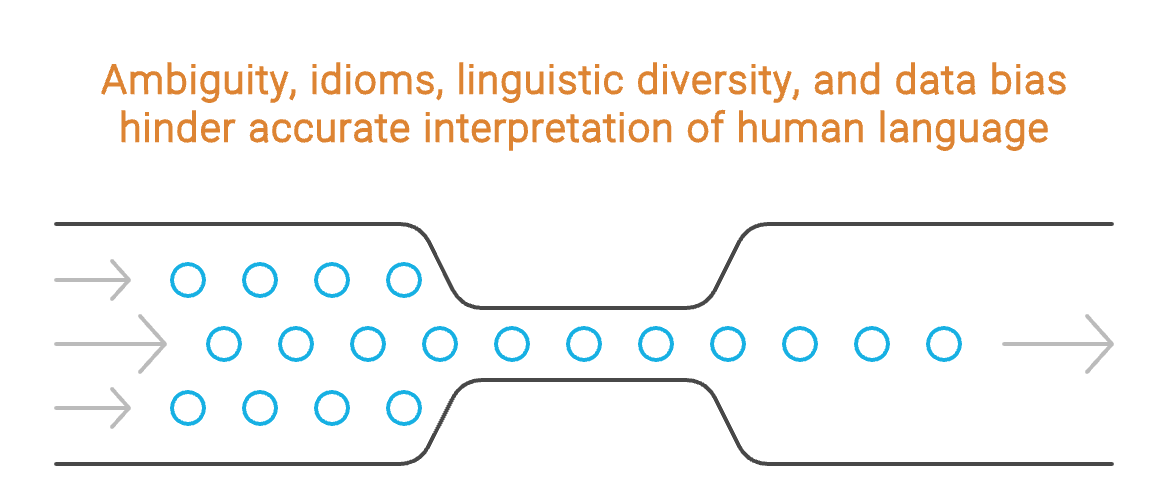
Le NLU est souvent qualifié de problème « IA-difficile », c’est-à-dire l’un des domaines les plus complexes et exigeants de l’IA. La difficulté réside dans les subtilités du langage humain : ambiguïtés, idiomatismes, contexte et différences culturelles accroissent la complexité.
Créé avec Napkin.ai
L’un des défis majeurs du NLU est de gérer l’ambiguïté intrinsèque des langues naturelles.
Une seule phrase peut souvent être interprétée de multiples façons. Par exemple : « J’ai vu un homme avec des jumelles. » Cela peut signifier que nous avons utilisé des jumelles pour voir l’homme, ou que l’homme que nous avons vu avait des jumelles.
Désambiguïser de telles phrases suppose une compréhension fine du contexte, chose relativement aisée pour l’humain mais encore très difficile pour les machines.
Les expressions idiomatiques et le langage figuré ajoutent un niveau de complexité supplémentaire. Des tournures comme « casser sa pipe » ou « vendre la mèche » ont des sens qui ne découlent pas de l’interprétation littérale des mots.
Pour interpréter correctement ces expressions, les systèmes NLU doivent être entraînés sur de grandes quantités de données intégrant ces nuances culturelles et linguistiques, très variables selon les langues et régions.
La langue n’est pas uniforme. Elle varie fortement selon les cultures, les régions et même les groupes sociaux. Un système NLU performant dans une langue ou un contexte culturel peut échouer dans un autre.
L’argot, les dialectes et les expressions régionales posent un vrai défi d’interprétation. Concevoir des systèmes capables de gérer cette diversité suppose des données d’entraînement vastes et variées, souvent difficiles à obtenir.
Le biais dans les données d’entraînement constitue un autre défi majeur pour les systèmes NLU. Si les données utilisées pour entraîner un modèle sont biaisées, ses prédictions et interprétations le seront également.
Par exemple, si un modèle est entraîné sur des textes provenant d’un groupe démographique particulier, il peut mal performer lorsqu’il interprète le langage d’autres groupes.
Le natural language understanding (NLU) est une sous-discipline clé de l’IA et du NLP, axée sur la capacité des machines à comprendre et interpréter fidèlement le langage humain.
En comprenant les principes et défis du NLU, ainsi que son rôle dans le cadre plus large du NLP, vous mesurez toute la complexité et l’importance de la compréhension du langage naturel.
Formez-vous au NLP avec ces cours !
Cours