
Khóa học
Khai thác đặc trưng cho NLP bằng Python
4 giờ
29.7K
Hiểu ngôn ngữ tự nhiên (NLU) là một phân nhánh của xử lý ngôn ngữ tự nhiên (NLP) tập trung vào việc giúp máy móc hiểu và diễn giải ngôn ngữ con người.
Không giống các tác vụ NLP khác có thể liên quan đến tạo sinh hoặc dịch văn bản, NLU tập trung cụ thể vào việc hiểu ý nghĩa, ngữ cảnh và mục đích đằng sau những từ ngữ và cụm từ mà con người sử dụng.
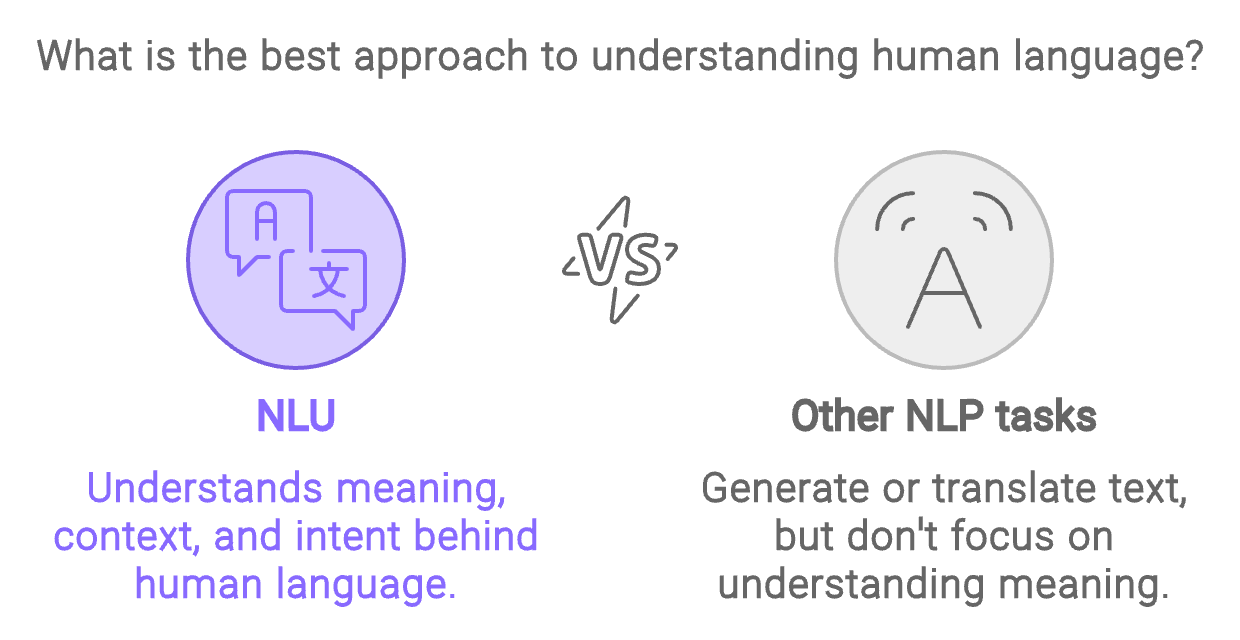
Tạo bằng Napkin.ai
Cốt lõi của NLU là chuyển đổi dữ liệu ngôn ngữ phi cấu trúc thành thông tin có cấu trúc để máy có thể xử lý. Điều này bao gồm các tác vụ như nhận diện thực thể trong câu, xác định cảm xúc của một phát biểu hoặc phân loại mục đích đằng sau truy vấn của người dùng.
Ví dụ, khi ai đó nói: "Đặt một chuyến bay đến New York", hệ thống NLU phải nhận biết "đặt" là hành động, "chuyến bay" là đối tượng và "New York" là điểm đến.
Hiểu ngôn ngữ tự nhiên (NLU) dựa trên sự kết hợp giữa các quy tắc ngôn ngữ học, thuật toán máy học và mô hình thống kê để diễn giải chính xác ngôn ngữ con người.
Các hệ thống NLU chuyển đổi dữ liệu ngôn ngữ phi cấu trúc thành thông tin có cấu trúc để máy có thể sử dụng nhằm thực hiện các tác vụ như phân tích cảm xúc, nhận diện thực thể và phân loại ý định.
NLU hiện đại chủ yếu dựa vào học sâu, đặc biệt là các mô hình như transformer. Chẳng hạn, ngay cả các mô hình đa năng như ChatGPT cũng có khả năng phân tích bất kỳ câu tiếng Anh nào để rút trích ý nghĩa.
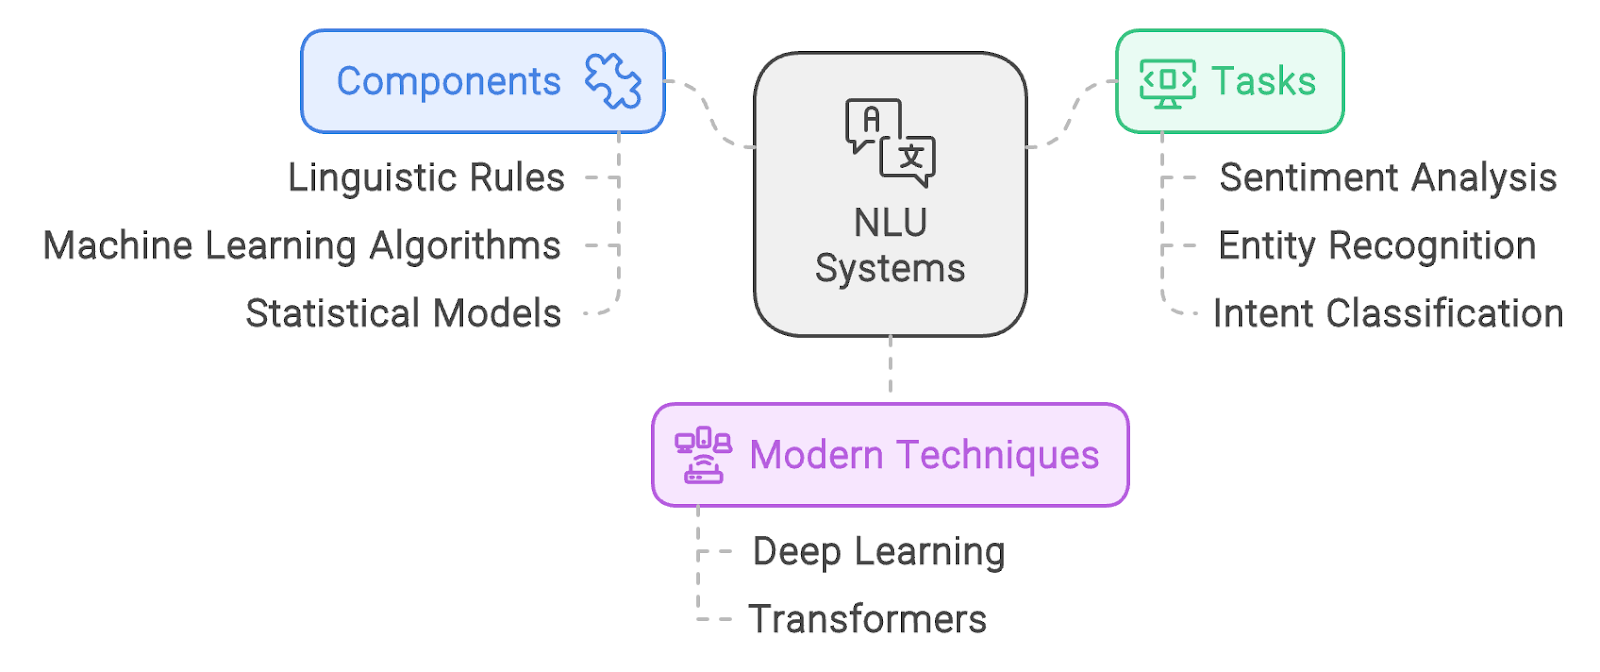
Tạo bằng Napkin.ai
Cần làm rõ rằng hiểu ngôn ngữ tự nhiên (NLU) không tách biệt với xử lý ngôn ngữ tự nhiên (NLP) mà là một thành phần then chốt trong đó. Dù mọi người thường dùng cụm "NLU vs. NLP", cách diễn đạt này gây hiểu nhầm vì NLU là một tập con của NLP.
Sự so sánh có ý nghĩa duy nhất giữa hai khái niệm này sẽ là thảo luận về các tác vụ NLP không thuộc NLU. Tuy nhiên, điều đó sẽ làm lệch trọng tâm khỏi NLU, nên chúng tôi sẽ không theo hướng so sánh này.
NLP bao quát nhiều tác vụ liên quan đến xử lý và phân tích văn bản, trong khi NLU tập trung cụ thể vào sự thấu hiểu. Ví dụ, NLP có thể bao gồm các tác vụ như nhận dạng giọng nói hoặc tạo sinh văn bản, còn NLU là về việc hiểu ý nghĩa của văn bản đầu vào—người dùng muốn nói gì và vì sao.
Bảng dưới đây nêu bật một số khác biệt chính giữa hai lĩnh vực:
|
Khía cạnh |
NLP |
NLU |
|
Phạm vi |
Rộng (bao gồm mọi khía cạnh xử lý và tạo sinh ngôn ngữ con người) |
Hẹp (tập trung cụ thể vào hiểu ý nghĩa, mục đích và ngữ cảnh) |
|
Ví dụ tác vụ |
Nhận dạng giọng nói, tạo sinh văn bản, dịch máy |
Nhận diện thực thể, phân loại ý định, phân tích cảm xúc |
|
Trọng tâm |
Cả hiểu và tạo sinh ngôn ngữ |
Hiểu ý nghĩa và mục đích của ngôn ngữ |
Bảng này cho thấy trong khi NLP bao trùm nhiều tác vụ liên quan đến cả hiểu và tạo sinh ngôn ngữ con người, NLU tập trung cụ thể vào việc thấu hiểu.
Hiểu ngôn ngữ tự nhiên (NLU) là cốt lõi của nhiều ứng dụng vận hành bằng AI. Nó giúp máy móc (ví dụ, chatbot) tương tác với con người theo cách trực quan và tự nhiên. Dưới đây là một số lĩnh vực chính nơi NLU tạo ra tác động đáng kể, kèm theo ví dụ về các công cụ hiện đại cho từng lĩnh vực.
Một trong những ứng dụng chủ đạo của NLU là trong chatbot và trợ lý ảo. Các hệ thống này dựa vào NLU để diễn giải và phản hồi chính xác yêu cầu của người dùng.
Ví dụ, khi người dùng hỏi: "Bạn có thể tìm cho tôi một quán cà phê gần đây không?" thành phần NLU giúp hệ thống hiểu rằng người dùng đang tìm một quán cà phê gần vị trí hiện tại của họ, cho phép chatbot hoặc trợ lý đưa ra phản hồi phù hợp.
Vượt ra ngoài việc hiểu các câu hỏi đơn lẻ, NLU rất quan trọng để duy trì dòng chảy hội thoại. Nó giúp chatbot và trợ lý ảo theo dõi ngữ cảnh, cho phép tương tác qua lại tự nhiên và mạch lạc hơn. Ví dụ, nếu người dùng tức giận với chatbot, hệ thống sẽ hiểu điều đó và phản hồi tương ứng.
Một công cụ phổ biến để xây dựng chatbot với khả năng NLU nâng cao là khung Rasa. Đây là một thư viện mã nguồn mở dùng để xây dựng chatbot với năng lực NLU tiên tiến.
Phân tích cảm xúc là một ứng dụng quan trọng khác của NLU, được sử dụng rộng rãi để đo lường dư luận và phản hồi của khách hàng.
Doanh nghiệp dùng NLU để phân tích cảm xúc thể hiện trong các bài đánh giá, bài đăng trên mạng xã hội và các hình thức phản hồi khác để xác định cảm xúc chung là tích cực hay tiêu cực.
Một công cụ phân tích cảm xúc thường được sử dụng mà tôi muốn nhắc đến là VADER (Valence Aware Dictionary and sEntiment Reasoner). Đây là một công cụ mã nguồn mở dựa trên quy tắc, được thiết kế đặc biệt để hiểu cảm xúc trên mạng xã hội.
NLU đóng vai trò thiết yếu trong các tác vụ phân loại văn bản, như lọc thư rác. Bằng cách phân tích nội dung và mục đích đằng sau email hoặc tin nhắn, các hệ thống NLU có thể phân biệt hiệu quả giữa thư thường và thư rác.
Hai công cụ phổ biến cho phân loại văn bản là SpaCy và NLTK (Natural Language Toolkit).
SpaCy là một thư viện mã nguồn mở được thiết kế cho NLP hiệu quả và nhanh trong Python, cung cấp các mô hình huấn luyện sẵn có thể tinh chỉnh cho nhiều tác vụ phân loại văn bản.
NLTK là một thư viện Python mạnh mẽ khác cung cấp công cụ dễ dùng cho các tác vụ như tách từ, gán nhãn từ loại và phân loại văn bản. Cả hai thư viện đều có thể dùng để xây dựng các pipeline phân loại văn bản.
NLU thường được coi là một bài toán khó trong AI, nghĩa là một trong những lĩnh vực phức tạp và thách thức nhất. Khó khăn nằm ở những sắc thái của ngôn ngữ con người—tính mơ hồ, thành ngữ, ngữ cảnh và khác biệt văn hóa đều góp phần tạo nên độ phức tạp.
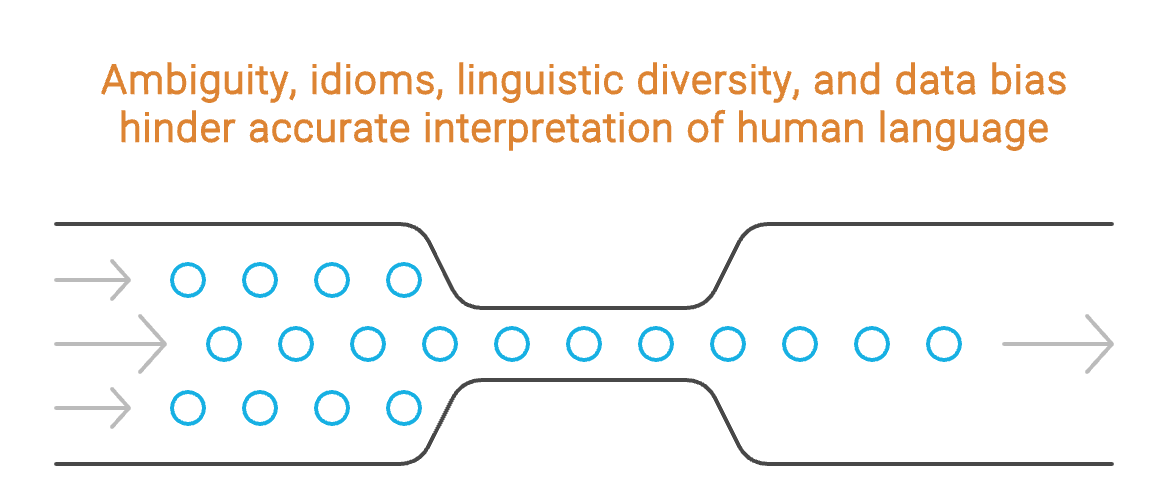
Tạo bằng Napkin.ai
Một trong những thách thức lớn nhất trong NLU là xử lý sự mơ hồ vốn có của các ngôn ngữ tự nhiên.
Một câu đơn lẻ thường có thể được diễn giải theo nhiều cách. Chẳng hạn, hãy xét câu: “Tôi thấy một người đàn ông với ống nhòm.” Câu này có thể nghĩa là chúng tôi dùng ống nhòm để nhìn người đàn ông, hoặc người đàn ông mà chúng tôi nhìn thấy có ống nhòm.
Việc khử nhập nhằng cho những câu như vậy đòi hỏi hiểu được ngữ cảnh—điều tương đối đơn giản với con người nhưng vẫn là thách thức đáng kể đối với máy tính.
Các thành ngữ và lối nói ẩn dụ làm tăng một tầng phức tạp khác cho NLU. Những cụm như "kick the bucket" hay "spill the beans" có ý nghĩa không liên quan trực tiếp tới nghĩa đen của các từ.
Để hệ thống NLU diễn giải chính xác các cách nói này, chúng phải được huấn luyện trên lượng dữ liệu lớn bao gồm những sắc thái văn hóa và ngôn ngữ này, vốn có thể khác biệt rất nhiều giữa các ngôn ngữ và vùng miền.
Ngôn ngữ không đồng nhất. Nó thay đổi đáng kể giữa các nền văn hóa, vùng miền, thậm chí các nhóm xã hội. Một hệ thống NLU hoạt động tốt trong một ngôn ngữ hoặc bối cảnh văn hóa này có thể thất bại ở bối cảnh khác.
Ví dụ, tiếng lóng, phương ngữ và cách diễn đạt vùng miền có thể là thách thức để các hệ thống NLU diễn giải chính xác. Xây dựng hệ thống có thể xử lý sự đa dạng này đòi hỏi dữ liệu huấn luyện phong phú và đa dạng, điều vốn khó thu thập.
Thiên lệch trong dữ liệu huấn luyện là một thách thức lớn khác đối với các hệ thống NLU. Nếu dữ liệu dùng để huấn luyện mô hình NLU bị thiên lệch, dự đoán và diễn giải của mô hình sẽ phản ánh thiên lệch đó.
Ví dụ, nếu một mô hình được huấn luyện trên văn bản từ một nhóm nhân khẩu học nhất định, nó có thể không hoạt động tốt khi diễn giải ngôn ngữ từ các nhóm nhân khẩu học khác.
Hiểu ngôn ngữ tự nhiên (NLU) là một phân nhánh quan trọng của AI và NLP, tập trung vào việc giúp máy móc hiểu và diễn giải chính xác ngôn ngữ con người.
Bằng cách hiểu các nguyên tắc và thách thức của NLU, bao gồm vai trò của nó trong bối cảnh rộng hơn của NLP, bạn có thể trân trọng mức độ phức tạp và tầm quan trọng của hiểu ngôn ngữ tự nhiên.
Học NLP với các khóa học này!
blog
Matt Crabtree
10 phút
