Tracks
面向开发者的 AI 工程师助理
26小时
我之前提到,预期要和模型匹配。对 Jev 尤其如此,这主要和它的模型类别有关,即所谓的 System One 模型。
System One 模型返回的是类型化的决策,而不是文本。您发送一段状态和一组问题,每个问题都有您定义的答案空间,模型对每个问题返回一个答案并附带概率。它不会逐令牌生成,因此无需解析字符串,也没有畸形 JSON 要修复。TypeSafe 借用了丹尼尔·卡尼曼著名的二分法来命名:
由于答案空间是由您的代码以模式的形式声明的,System One 模型从设计上就绝不会返回您未定义的类别。这意味着它永远不会“越 schema”。话虽如此,它仍然可能出错,我们稍后会讨论一些棘手情形。
TypeSafe 于 2026 年 9 月 15 日走出隐身,并开放 Jev 的早期访问,声称响应时延 70 至 500 毫秒,输入每百万令牌 $0.042,输出免费。在其自家四个工作流的基准上,Jev 大约 68% 的准确率,属于中档 LLM 水平,但成本只是其中一小部分。
关于功能与基准表现的更多信息,建议阅读我们的Jev 指南。
在调用之前先写下所有有效答案。如果您能把它们枚举出来,那就是一个“Jev 形状”的问题:
当输出是散文或代码、答案空间是开放的,或任务需要多步推理串联时,请选择LLM。Jev 也不适合任何数值相关的任务,稍后我会解释原因。
在写代码之前,创建一个 TypeSafe 账号并打开 Playground。在这里,您可以把文本粘贴为 state,添加问题,并在无需安装任何东西的情况下查看完整答案对象。这是理解每种问题类型会返回什么(以及检查您问题措辞是否不当)的最快方式。
我将用同一张支持工单作为三种示例的 state:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
每种问题类型都需要 instructions,即您想要回答的自然语言问题。不同之处在于 criteria以及返回的内容。
一个Choice会从您定义的一组选项中挑一个。
您把 criteria作为字典对象传入,将每个选项映射到描述(1 到 255 个都行),答案会包含:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
要查看您通过 API 同样会收到的代码输出,请点击右上角的</>按钮,然后点击Run让 Jev 回答问题。
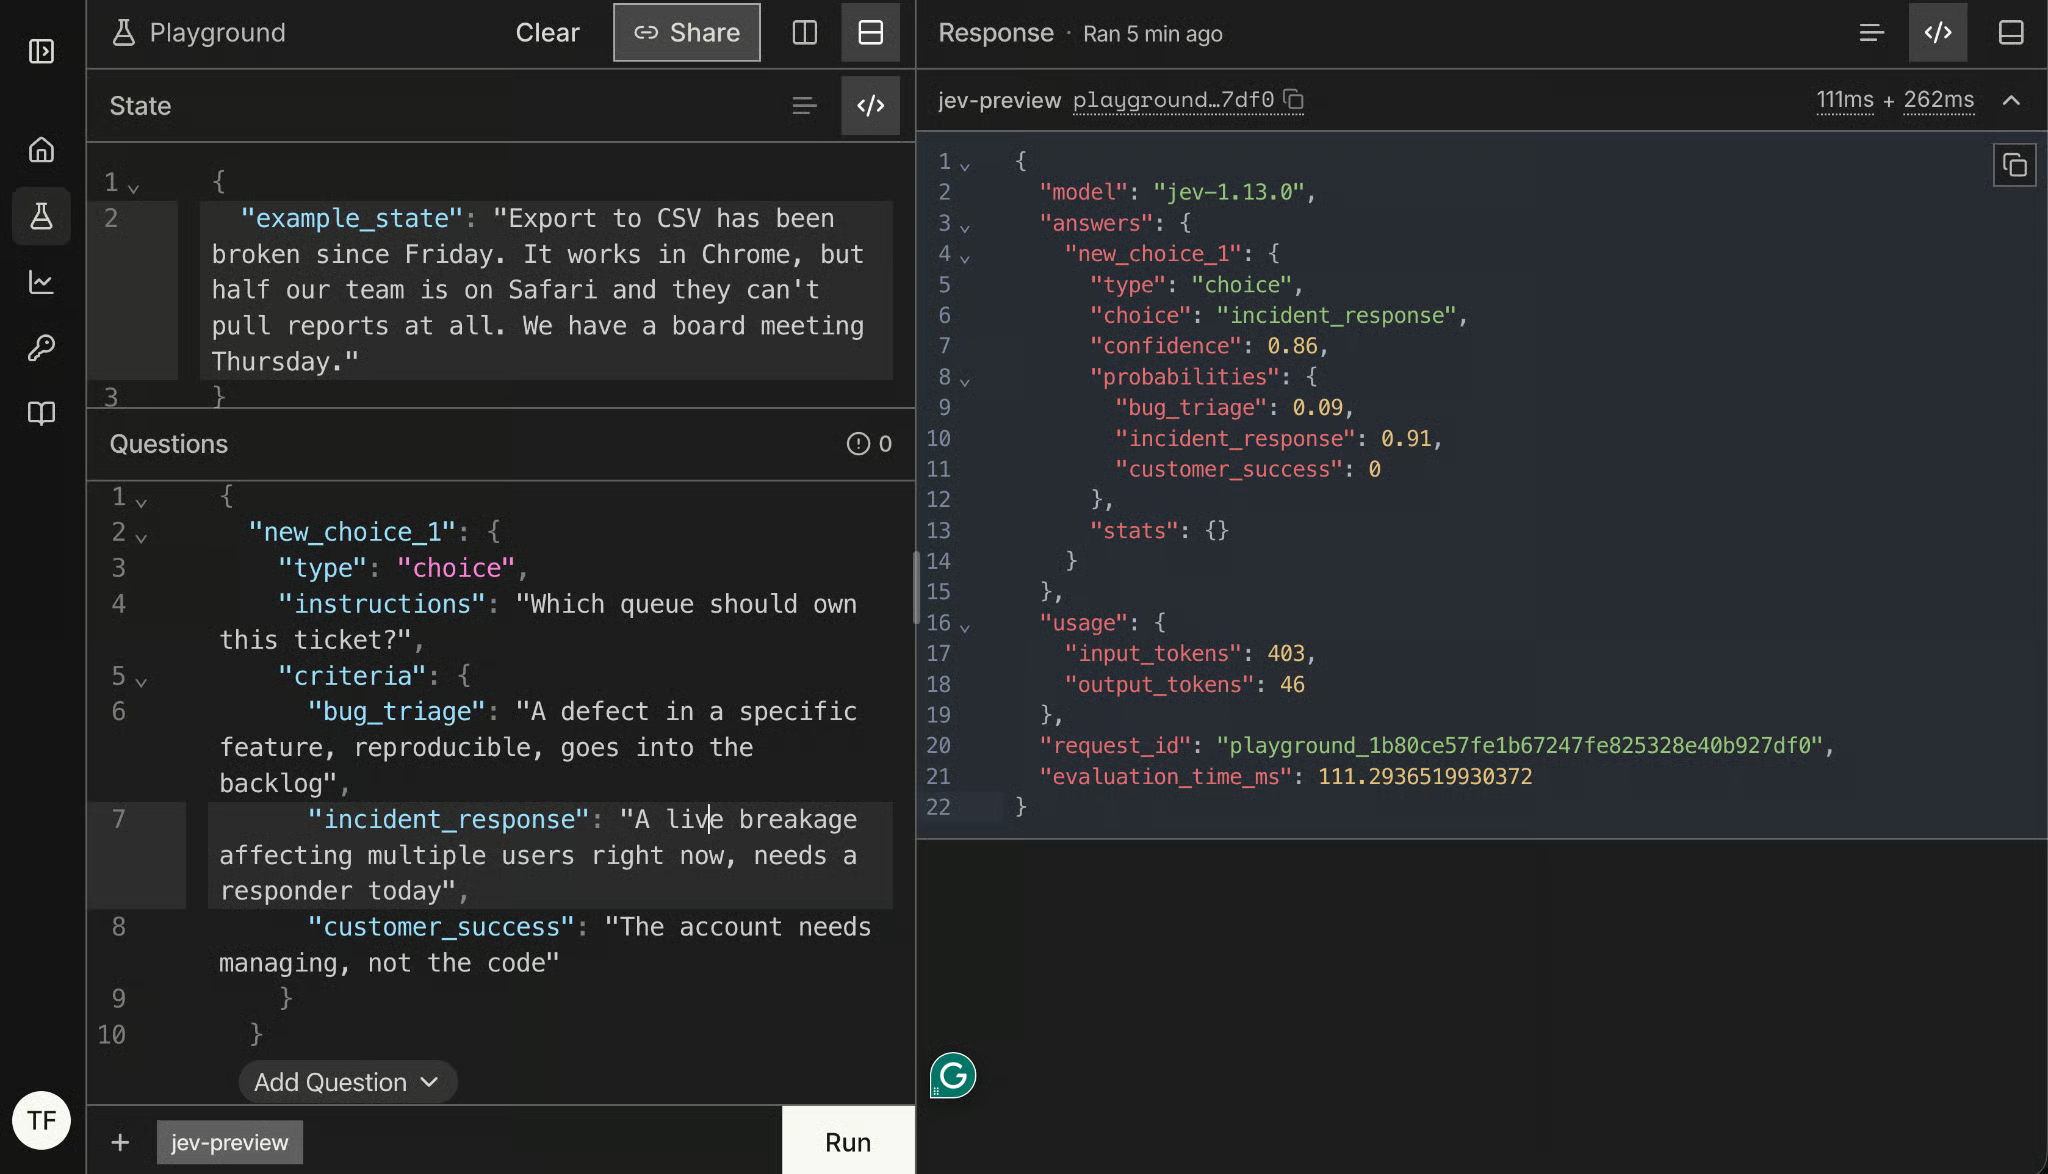
在这个例子中,incident_response 是 choice,概率为 91%。Jev 对该选择的 confidence 为 86%。
最值得关注的是完整的分布。
choice 只告诉您哪个选项赢了。
probabilities 告诉您它赢得有多“多”。
当您即将自动路由工单时,这两者是不同的信息。即便 0.41/0.38/0.21 与我们收到的 0.91/0.09/0 都可能返回相同的 choice。
Score 会把 state 按有序等级打分。您将 criteria作为数组传入,包含 2 到 10 个等级描述(从低到高),答案包含一个分值、一个将每个位置映射到您描述的 legend、每个等级的概率,以及置信度。
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}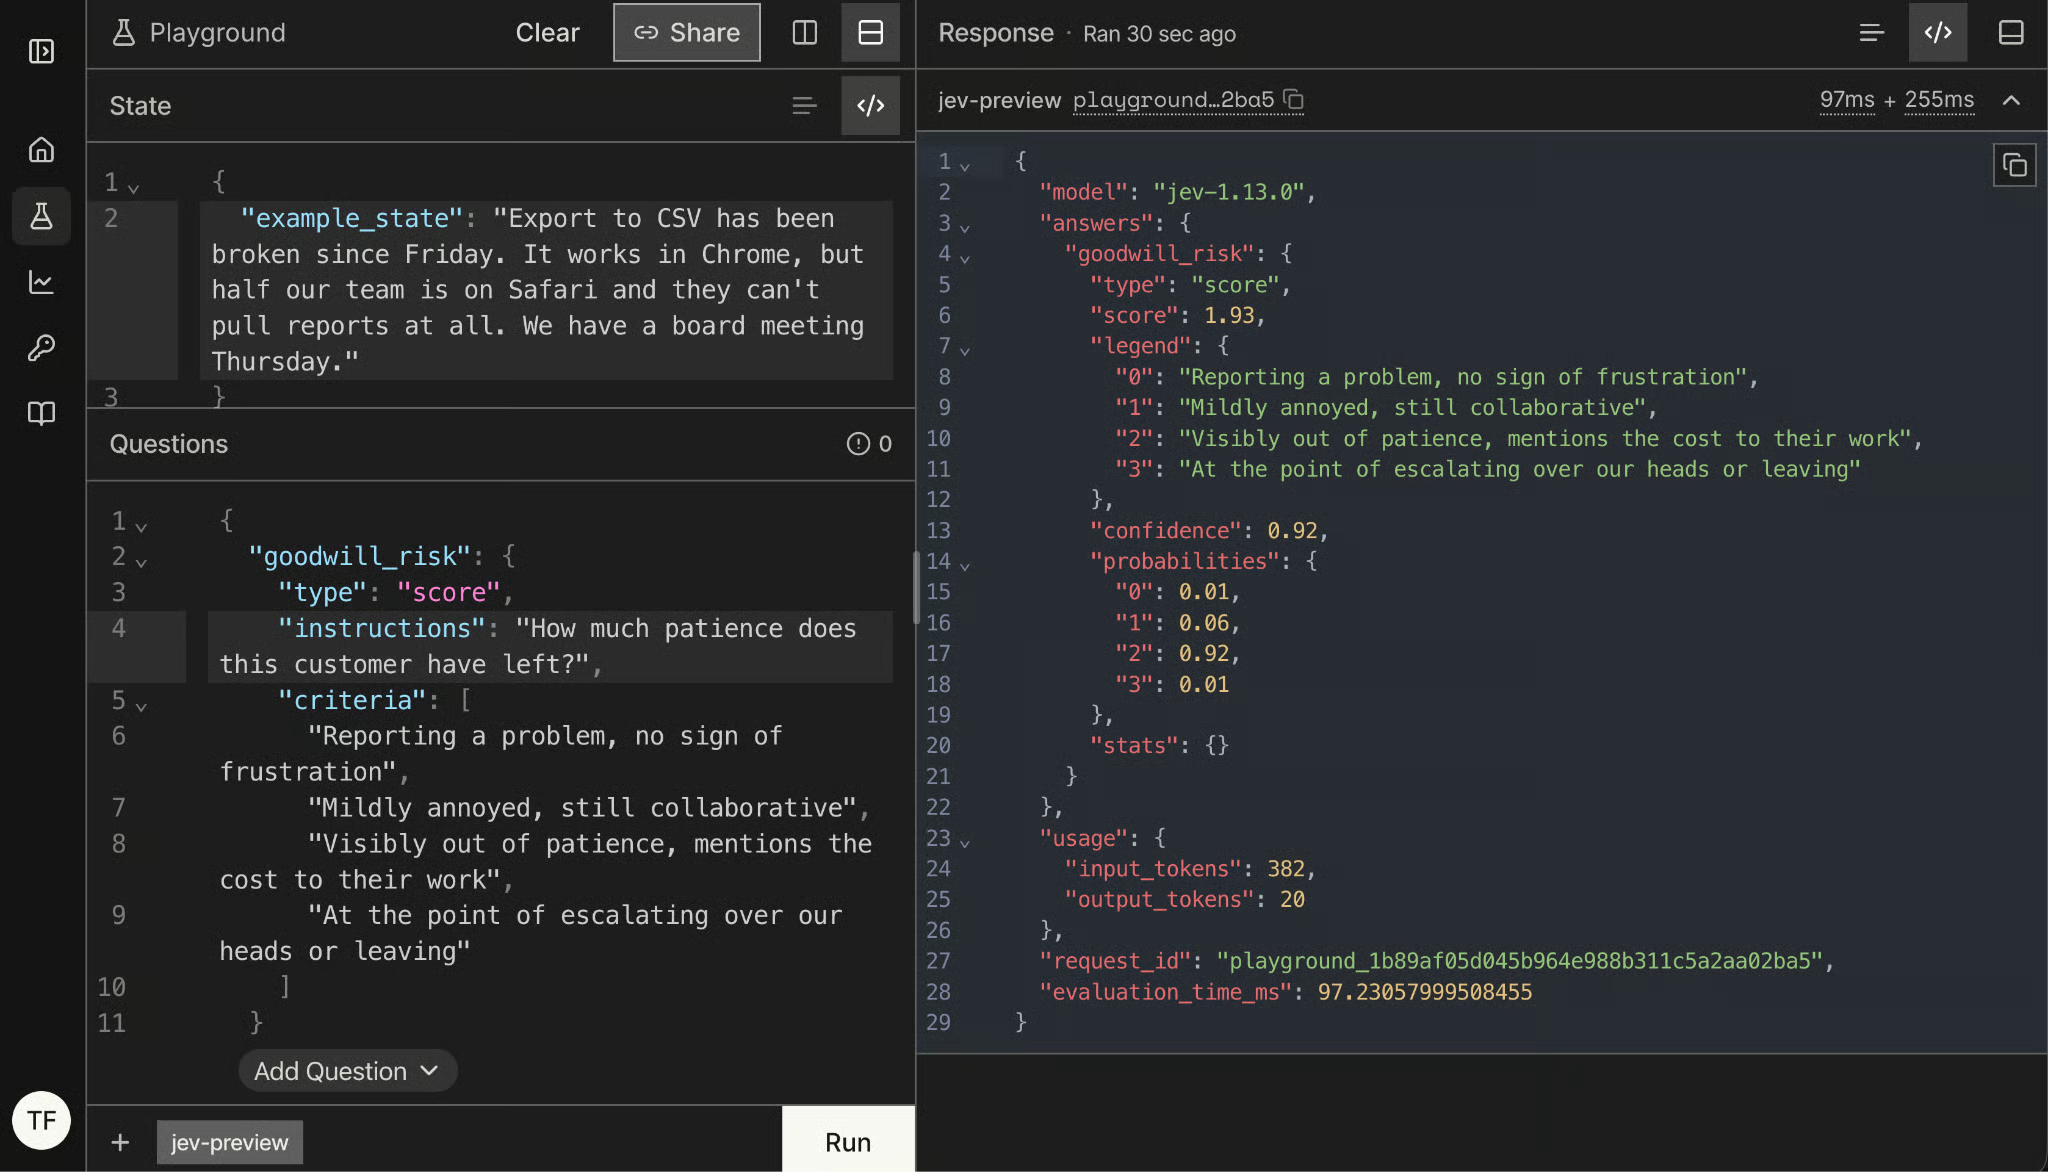
分值可以落在等级之间,这正是 legend 的意义所在。这里 score 为 1.93,意味着模型在“略有不满”和“明显失去耐心”之间摇摆,并明显偏向后者;这对一张语气礼貌但点出将要错过的最后期限的工单来说,是个合理解读。
同样要看 probabilities 的分布,不要只看单个数值:概率集中在一个等级意味着判断果断,概率摊在三个等级上意味着您得到了一个“平均值”,而不是判断。
Noul 用于二元问题,其名称由 TypeSafe 创造。这里 criteria是可选的,但您可以描述 true与 false的含义;当“是”可能被解读为两种意思时,这么做很有价值。
将问题表述为“数值越高越表示是”。TypeSafe 的文档对此写得很明确:若 Noul 的 true对应“否”,性能会明显变差。
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}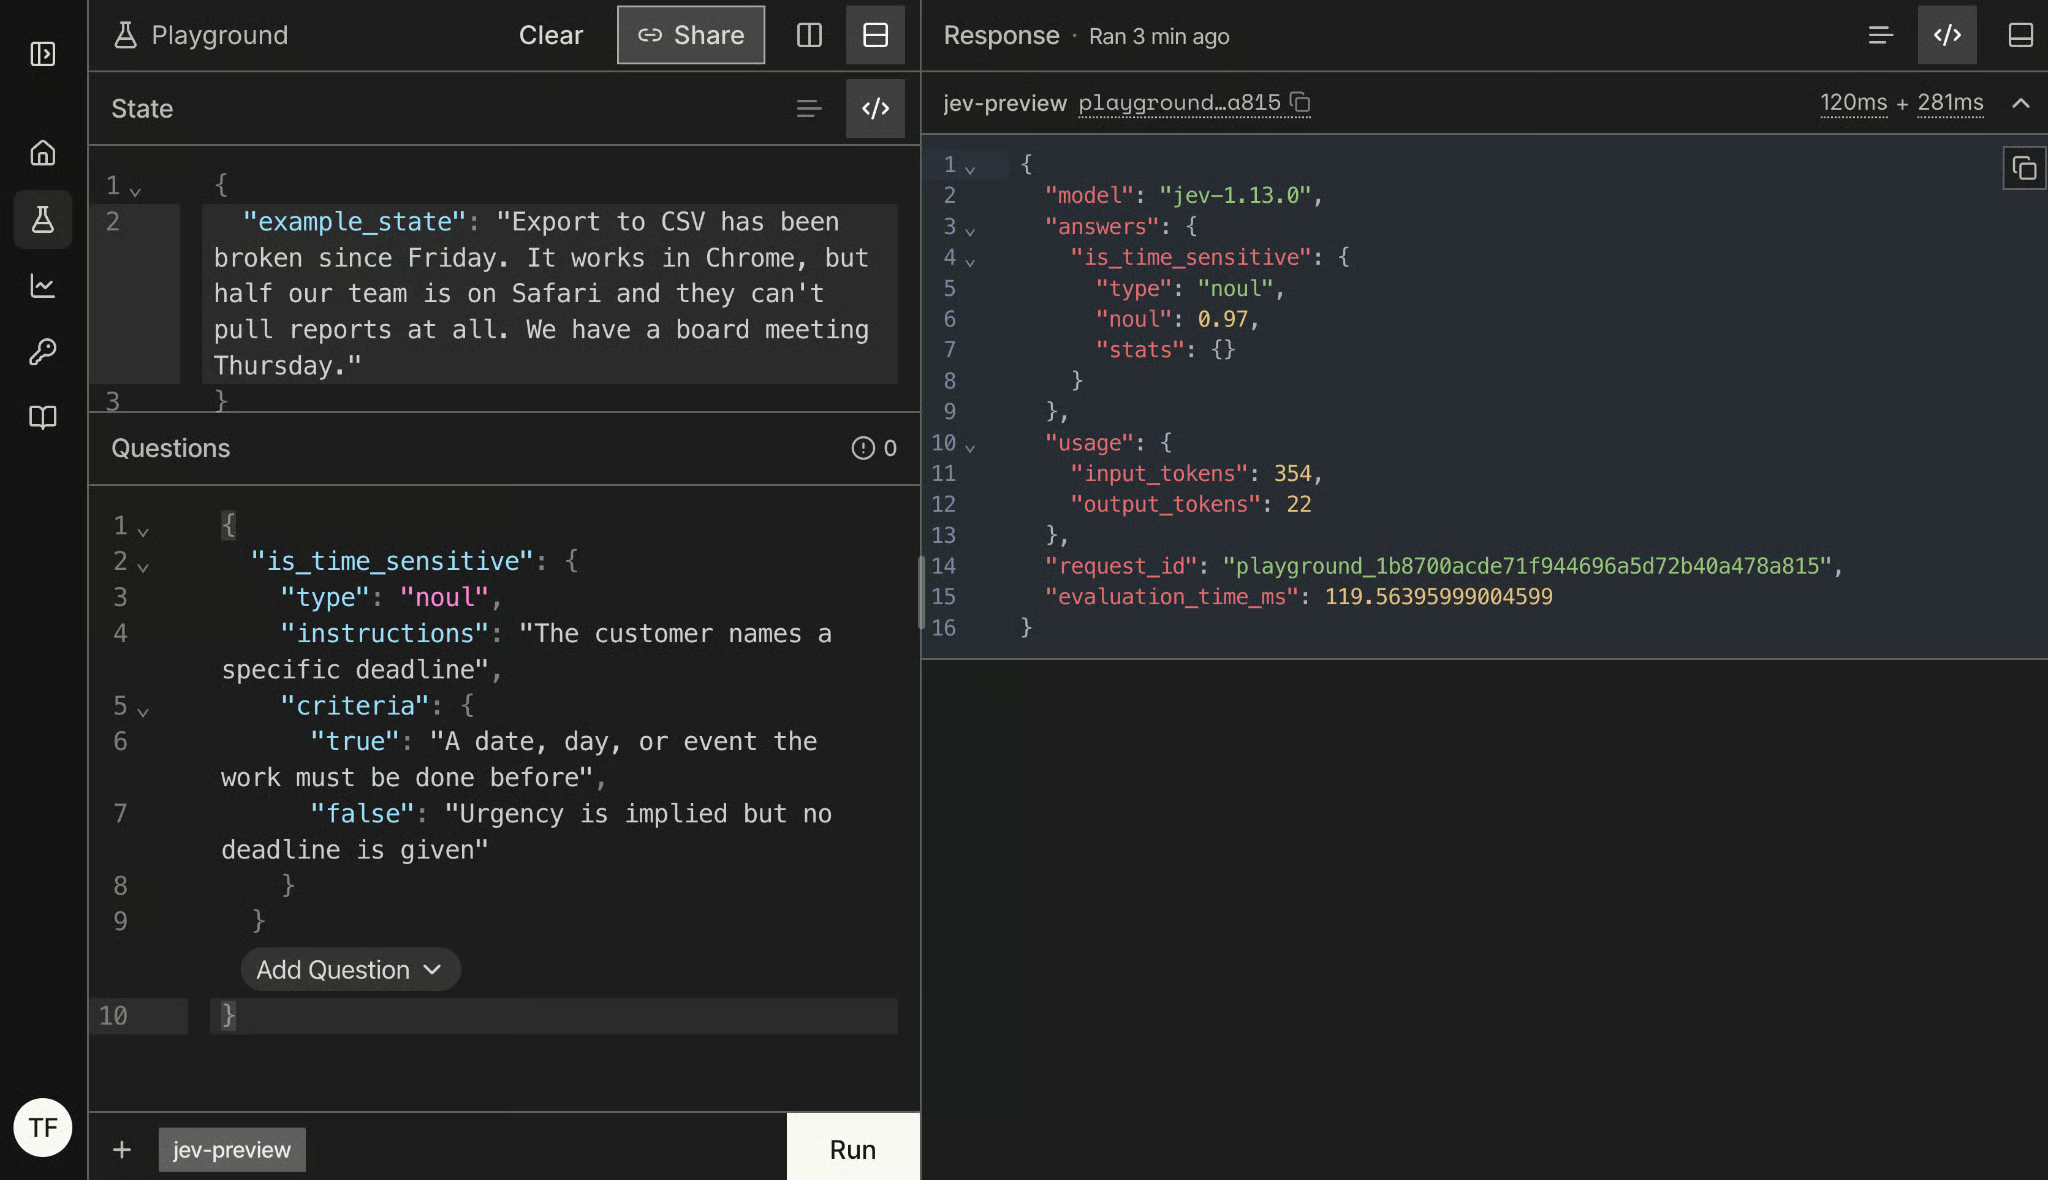
由于 state 中提到了周四的董事会会议,noul 值高达 0.97 在意料之中。
Choice 和 Score 会连同概率一起返回置信度。Noul 不会,这经常让人困惑,所以这里精确解释一下原因。
置信度与概率是两个轴。对于 Choice,probabilities 表示模型如何在各选项间分配信念,而 confidence 表示模型对该答案的把握程度,因此 Choice 可能返回 0.85 的顶部选项、但置信度为 0.78。Noul 只有两种结果,因此那一个概率数值已经同时携带两者:0.97 是一个很笃定的“是”,0.03 是很笃定的“否”,而 0.52 则表示模型不知道。
这意味着距离 0.5 的远近就是您的果断度信号,而不是另一个要读取的字段。这也意味着您不能把 Noul 的阈值直接迁移到 Choice。稍后在“锯齿边界”一节我会再提这点,因为它比听起来更“咬人”。
跟着做,您只需要 Python 3.10+ 和一个 TypeSafe 早期访问密钥。
安装 SDK:
pip install typesafe-sdk或使用 uv:
uv add typesafe-sdk然后在 TypeSafe 控制台创建密钥并导出。客户端会从环境变量 TYPESAFE_API_KEY 读取该值,因此无需在代码中传入:
export TYPESAFE_API_KEY="your-key"以下导入即可获得 Playground 里的全部能力:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice、Noul 和 Score 就是您刚刚点过的那几种问题类型,对应的 Python 对象。
TypeSafeClient 是同步客户端,如果您要在异步服务中调用 Jev,也有接口相同的 AsyncTypeSafeClient。两者都可作为上下文管理器使用,这在脚本之外的场景都会是我的首选:
with TypeSafeClient() as client:
...默认情况下,客户端调用的是 jev-latest,TypeSafe 每发布新版本它都会移动,我们在整个教程中都会这么用。但如果您已经调好了阈值,应该固定版本:
client = TypeSafeClient(model="jev-1.13.0")无论如何,响应都会告诉您实际是哪一个模型回答了您,接近末尾有一节会讲为什么应该记录这个信息。
要向 Jev 发起 API 调用,您需要使用 TypeSafeClient 和 system_one() 函数定义一个 response 项。该函数接收 state 参数作为问题上下文,以及与 Playground 相同格式的 questions。
由于三道 Playground 问题共享同一 state,我们可以用一次调用把它们全部回答:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
答案会以您给每个问题起的同名键返回,这个细节让整体使用体验非常顺手:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97如果您的第一次调用因 output_buffer_limit 的 TypeError 失败:那是 SDK 压缩后端的版本不匹配,不是您的代码问题。SDK 自带 HTTP 客户端 httpx2,它通过 zstandard 和 brotli 解压响应,其中某个旧版本缺少被调用的参数。执行 pip install -U typesafe-sdk httpx2 zstandard brotli 就解决了我的问题。
输出里有两点值得停下来看看。
其一,response.model 返回的是 jev-1.13.0,而不是 jev-latest。您请求的是会变动的别名,Jev 告诉了您实际回答的版本,这是记录这个字段成本足够低、值得做的唯一原因。
其二,答案对象按问题类型带有类型信息,所以 .choice、.score、.noul 都是真实属性,编辑器能识别它们。代码里没有任何 JSON 字符串,不需要解析,也不需要为“响应畸形”的调用写分支。如果您更喜欢分组读取,SDK 也提供了 response.choices、response.scores 与 response.nouls,键相同。
也看看 response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78输出令牌是个位数且免费。您为 state 和问题付费,因此您完全可以通过控制发送的上下文量来掌控成本杠杆。这比看起来更重要,并且会在“锯齿边界”一节再出现:臃肿的 state 会同时损害您的成本与准确率。
这是 Jev 的典型用例之一。一张支持工单到达,需要有人(或某物)决定它进哪个队列、是否先由人工查看、以及处理速度。每一项都是能够事先写下答案空间的判断。
一条值得先说的设计原则:Jev 决定“是什么”,您的代码决定“接下来做什么”。Jev 从不直接路由任何东西。它返回数字,路由逻辑写在一段普通函数里,您可以阅读、测试,并在不碰模型的情况下随时修改。
同一个请求中的问题会并行评估,因此添加第六个问题只会多出它自身的令牌成本,对时延几乎没有影响。这会改变您的提问方式。用 LLM 时您会谨慎分批以减少往返时间;而在这里,您会把与特定上下文相关的所有想问的问题都问了,包括那些大概率会被忽略的。
让我们在先前的问题基础上,再添加三个能帮助处理工单的重要 Noul:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
response = client.system_one(state=ticket, questions=QUESTIONS)六个问题,一次调用,一次计费。is_automated 带点试探性质:在几乎所有真实工单上它都是 false,但仍值得一问,因为一旦为 true,就能省下一位同事去打开一封邮件投递失败的自动通知。
我建议养成两个习惯。
把问题集定义为模块级常量,而不是内联构造,因为它会和您的阈值一起做版本管理。
按测量对象命名问题,而不是按您将用答案做什么来命名,因为 is_time_sensitive 能跨策略变更复用,而 route_to_incident 不能。
正面表述问题:我们也可以把 is_automated 起名为 needs_no_reply 之类,但据 TypeSafe 所说,正向措辞的问题性能更好。
接下来是 Jev 不做的部分。每个答案都会带一个置信度或一个概率,而这个第二个数字能让您构建“三条路径”而不是“两条”:
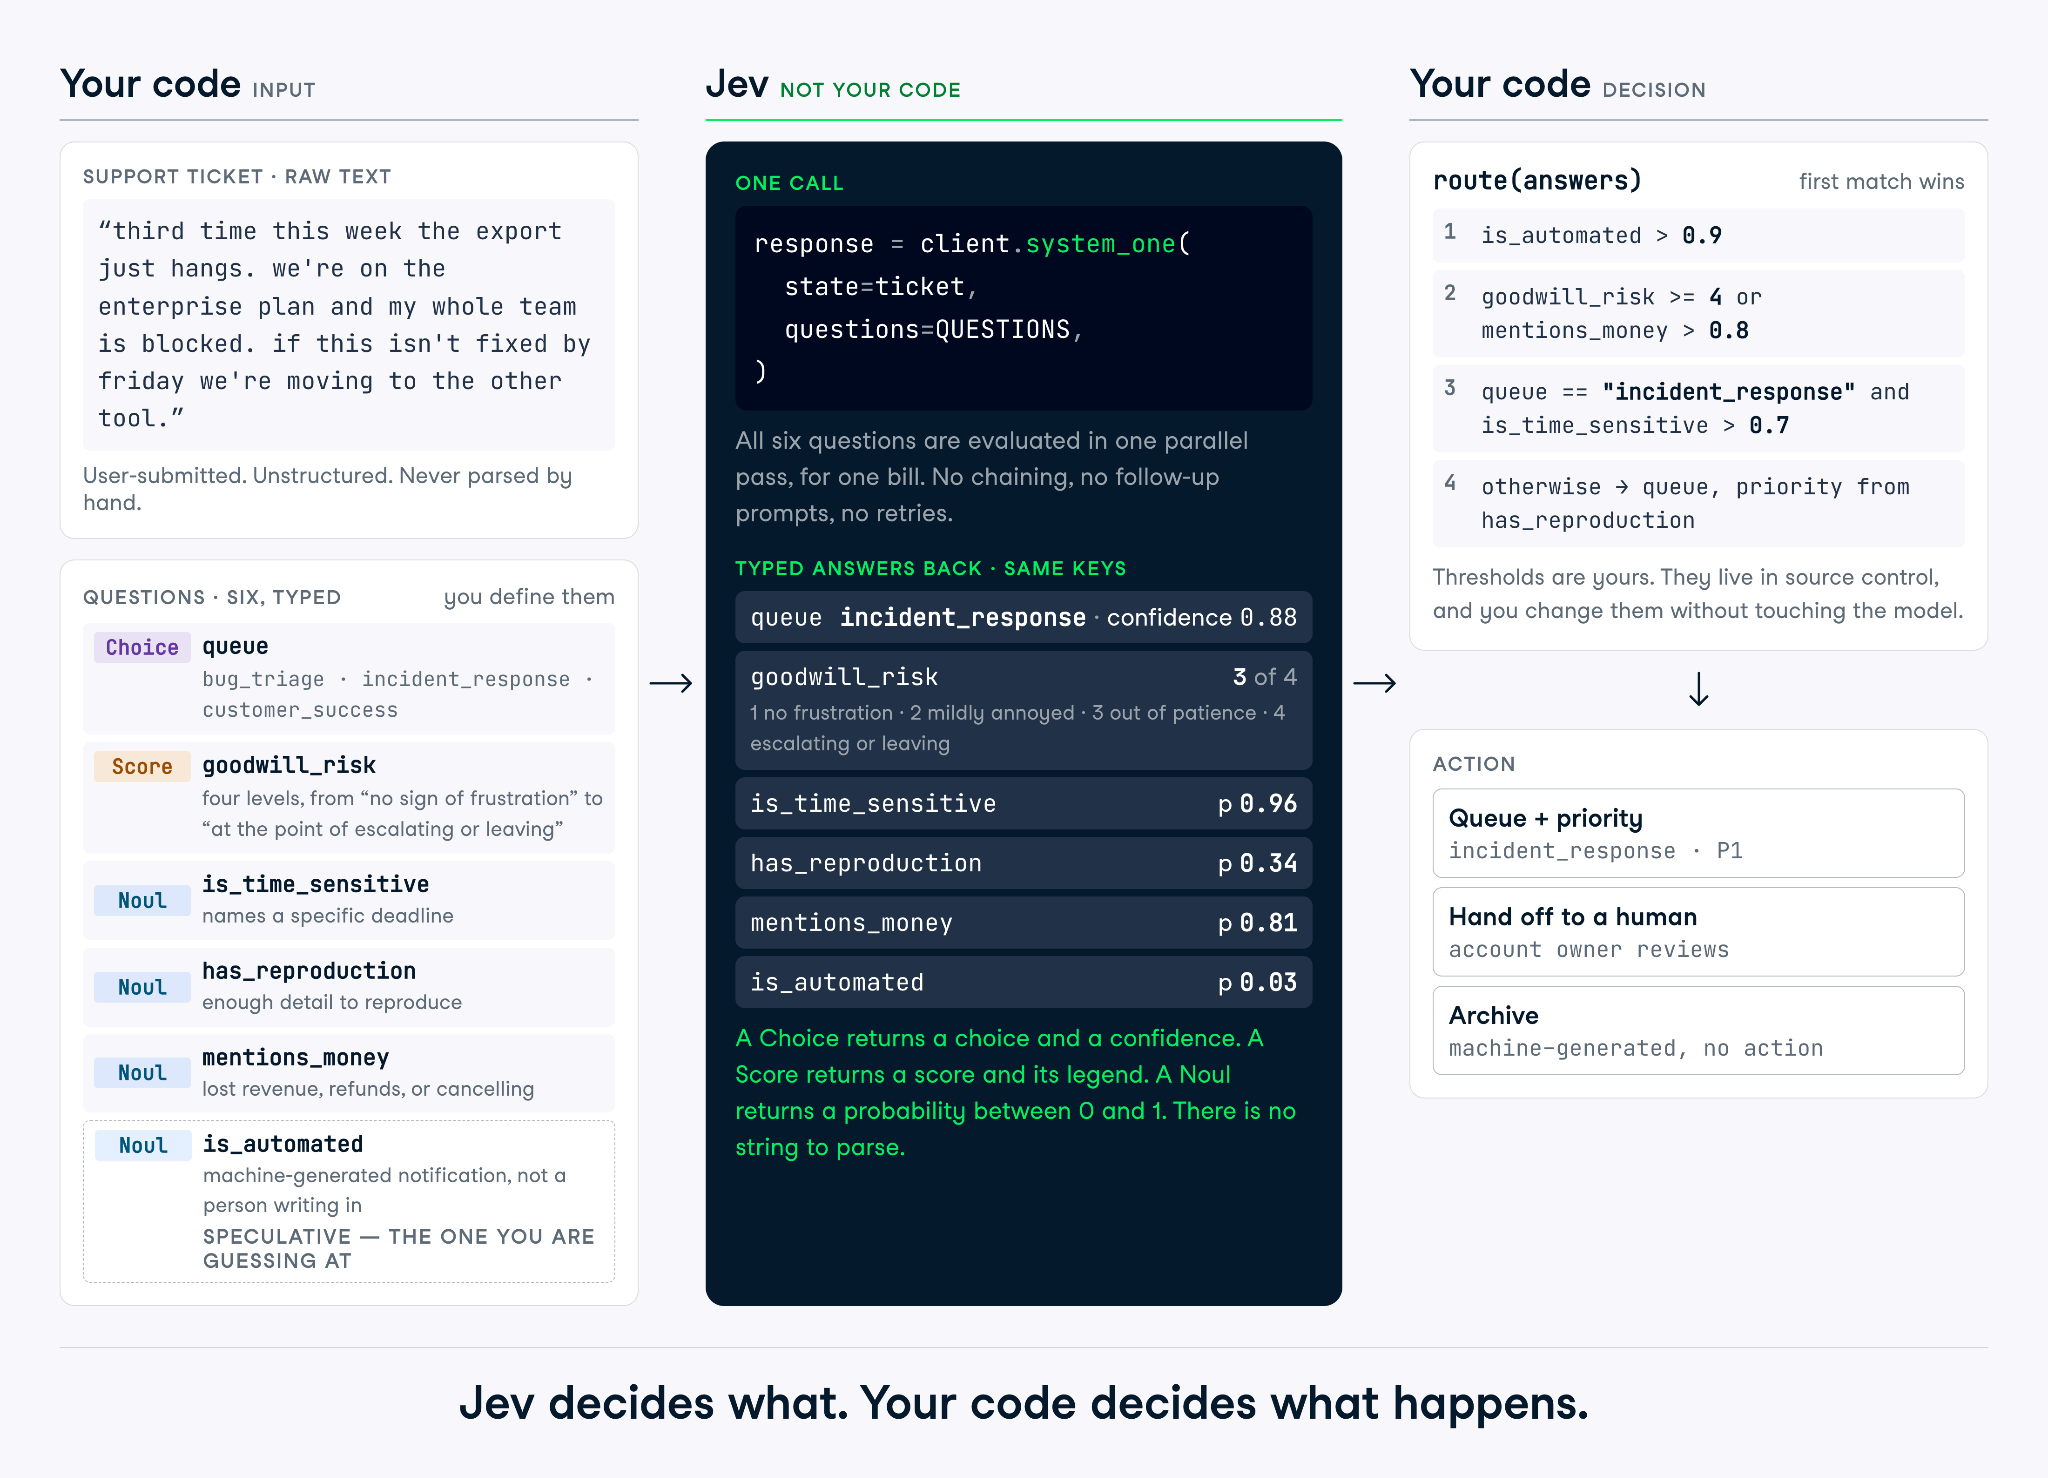
把它转成几条路由规则:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
return queue.choice, priority读读这段函数在做什么。模型提供了六个判断,而策略决定其中一个(mentions_money 与沮丧客户的组合)优先级高于 Jev 选出的队列。这个覆盖是业务决策,它应该写在代码里,周五下午您也能在不重测模型的情况下改它。
has_reproduction 从未被使用。我是故意留着它的,因为这就是“扇出”模式在实践中的样子:您会请求比当前策略消耗更多的信息,把它全部记录下来,当有人问“没有复现步骤的 bug_triage 工单是否更难关闭”时,您已经有六周的数据答案了。
上面的阈值只是示例。找出合适阈值需要标定,最后一节会讲如何用数据而不是“感觉”来设定它们。
您可以在这个配套 GitHub 仓库获取完整脚本。我用我们的场景运行 Python 脚本时,判定结果是将工单今天路由给事故响应团队。
python routing.py('incident_response', 'today')TypeSafe 为每个模型版本发布一页锯齿边界,列出已知失效模式。我希望更多实验室这样做。上线前先读一遍,升级时再读一遍,因为这个清单是版本化的,边界会移动。
以下五点最可能让我白白浪费时间。
您不能在不同问题类型之间迁移阈值。TypeSafe 自己的示例里,对同一张工单分别用 Noul 和 yes/no Choice 问“客户是否在要求退款?”:Noul 返回 0.22,Choice 里“yes”的概率是 0.01,置信度 0.97。相同问题,两个数字,相差两个数量级。
否定也不“互补”。一个 Noul 与它的否定分别返回 0.72 和 0.47,相加是 1.19。
原因在于两种类型问的是不同的事。Choice 是相对判断,决定哪个选项赢,而每个 Noul 是绝对判断,可能所有选项都低。按您将要投产的形式逐题调阈值,且永远不要假定 P(yes) 与 1 - P(no)是同一个数。
Score 等级是有序的,不是等距的。1.6 只说明模型在第二与第三等级之间、偏向第三,就这些。
您不能从中插值出一个真实量。如果等级是“少于一小时”“几小时”“一天”,1.5 并不意味着五小时。用分数来判断是否越过阈值,每个实际数值留在代码里。
Jev 把 state 当作数据处理,但它并未对“state 写入的操纵性文本”做强化防护。注入的指令、误导性的表述、或为自身分类强行辩解的文字都可能影响答案,TypeSafe 表示会在这方面持续改进。如果这个攻击面对您是新的,可阅读我们的提示注入指南了解通用情形。
在 state 由用户提交的场景里,这点影响最大,而工单路由正是如此。把 criteria 写得足够精确,避免工单对自身的陈述决定结果,并在自动路由之前,用恶意输入做压力测试。
计数不可靠,且随着被计数对象增多而恶化,因为模型识别的是答案的“形状”,而非逐一计数。日期按文本读取,因此排序、间距、时间窗都会失效。数值编码不如语义等价物表现好,因此要问“红色”,而不是 #FF0000。
三种情况的解决方式相同:拆分工作。
如果您需要计数,用代码迭代,并为每个条目问一个 Noul:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)还有三个较小的问题,成因相同。Jev 会回答您写的问题,而不是您想问的问题,因此限定词与否定会按字面意义理解。双重否定、或询问“属性的属性”的问题会降低准确率。而冗长且包含无关细节的 state 会同时损害准确率与成本,因为无关内容会造成干扰。
第一个问题的征兆是:当您看着一个错误答案、忍不住开始解释“我真正想问的是……”,那段解释正是您 instruction 里缺失的另一半。
基于我们已经学到的内容,这里有一些最佳实践,帮助您更好地使用 Jev。
写“条件”,而不是“意图”。如果您在复盘错误答案时需要解释“我其实是想……”,那段解释就应该写进 instructions。具体做法:
jev-latest会变动。一旦某个阈值依赖模型行为,就固定版本:
client = TypeSafeClient(model="jev-1.13.0")在每次调用中记录 response.model,连同完整答案,而不是只记录您据以行动的那个值。当某个阈值开始“抽风”时,只有这些日志能让您分辨是模型变了,还是工单分布漂移了。
最后,阈值不是天降神力,而是实验的结果。
Jev 是一把“窄用途”的工具,这正是它的意义。它回答那些您能枚举答案的问题,成本低到让您不再吝于发问,然后把决定权交还给您的代码。
我想反驳的是“不能幻觉化(cannot hallucinate)”的表述。狭义上说模型不会给出 schema 之外的答案,这没错,但这并不意味着答案就是对的。Choice 总会返回一个有效队列,但它仍可能以 0.9 的置信度给出“错误的队列”,而类型化输出只会让这种失败更安静。
要不要在您的场景中试试它?我建议先找出一个您当前用脆弱规则或缓慢 LLM 调用做出的代码决策,尝试把所有有效答案写下来。如果能写出来,那就是“Jev 形状”的问题;如果不能,再怎么打磨问题也无济于事。
如果您想开始构建使用 AI 的系统,强烈推荐报名我们的开发者版初级 AI 工程师职业路径。它将教您如何使用 OpenAI API、MCP、LangChain 等等。
在 DataCamp 学习 AI 工程!
Tracks
Courses
Courses