Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.7K
A maioria dos anúncios de IA em 2026 virou uma corrida por chat e raciocínio, como vimos com o GPT-6 Astra, da OpenAI, e o Fable 5.1, da Anthropic.
A TypeSafe seguiu outro caminho. Em 15 de setembro de 2026, a empresa anunciou um modelo que não gera texto.
O modelo se chama Jev e inaugura uma nova categoria que a TypeSafe chama de modelos System One.
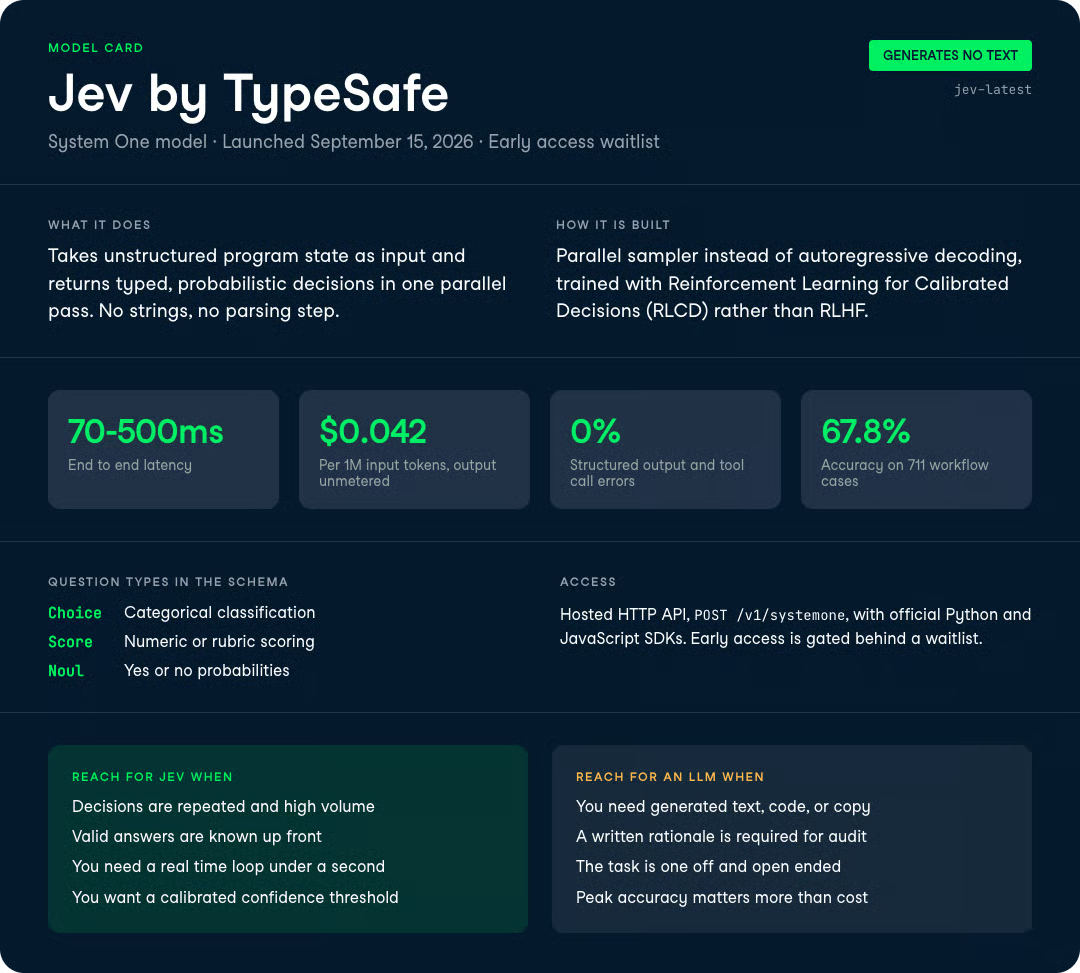
Em vez de produzir strings token a token, o Jev recebe um estado de programa não estruturado como entrada e retorna decisões tipadas e probabilísticas em uma única passada paralela.
Segundo a TypeSafe, o Jev roda de 40 a 200 vezes mais rápido que LLMs de ponta em tarefas comparáveis, custa US$ 0,042 por milhão de tokens de entrada com saída gratuita e, matematicamente, não alucina nem produz erros de tipo.
Neste artigo, explico o que é um modelo System One na prática, como o Jev difere de um LLM padrão, o que os benchmarks de workflows mostram contra outros modelos e onde ele se encaixa em uma stack real.
Para ver mais detalhes sobre os modelos usados na comparação com o Jev, confira nossos conteúdos de Jev vs GPT-6 Astra, GPT-5.6 Terra vs Claude Sonnet 5 e Claude Opus 5 vs GPT-5.6 Sol. Vale também dar uma olhada no nosso guia de alternativas ao Jev.
Um modelo System One é um modelo de IA de ponta que retorna decisões probabilísticas tipadas em vez de texto.
Você fornece um bloco de estado e um conjunto de perguntas tipadas; ele avalia tudo em paralelo e retorna respostas estruturadas com níveis de confiança calibrados, sem gerar strings e sem nada para fazer parsing. A TypeSafe cunhou o nome da categoria com o Jev, seu primeiro lançamento público em setembro de 2026.
O Jev é um modelo de ponta feito para tomar decisões rápidas e estruturadas que o software pode consumir diretamente, sem etapa de parsing ou validação.
É o primeiro lançamento público da classe System One da TypeSafe, disponível em early access desde setembro de 2026, e leva o nome do economista William Stanley Jevons.
O conceito remete ao livro Rápido e devagar, de Daniel Kahneman.
No esquema de Kahneman, o Sistema 1 é rápido e intuitivo; o Sistema 2 é lento e deliberado.
Os LLMs atuais, com cadeias de raciocínio e traces de vários segundos, ficam claramente na categoria do Sistema 2.
Diogo Almeida, fundador da TypeSafe e co-inventor do ChatGPT na OpenAI, argumenta que o gap de automação vem do fato de todos estarem construindo modelos de Sistema 2 quando a maioria das decisões em software pede uma resposta rápida de Sistema 1.
Arquiteturalmente, o Jev se distancia bastante de um LLM transformer.
Ele usa uma arquitetura nova com um amostrador paralelo que gera todas as saídas em uma única consulta, não de forma autoregressiva, e um método de treino que a TypeSafe chama de Reinforcement Learning for Calibrated Decisions (RLCD).
Enquanto GPT-5.6 e Opus 5 são treinados com RLHF e recompensas verificáveis para produzir textos preferidos por humanos, o RLCD otimiza probabilidades calibradas em decisões estruturadas.
O resultado, segundo números da própria TypeSafe, é taxa de erro de saída estruturada de 0% e latência fim a fim de 70-500 ms.
Um detalhe sobre o RLCD: a TypeSafe o posiciona diretamente contra RLHF e RLVR. Enquanto o RLHF otimiza por respostas de chat preferidas por avaliadores humanos e o RLVR por saídas que um programa consegue verificar, o RLCD busca probabilidades epistemicamente honestas em tarefas de decisão. Por isso a calibração é uma propriedade nativa do Jev, não algo adicionado via prompt.
Aqui vai o contraste arquitetural em uma tabela, porque a diferença se perde fácil no texto corrido.
| Propriedade | LLM de ponta (GPT-5.6, Opus 5) | Jev (modelo System One) |
|---|---|---|
| Saída | Strings geradas, exigem parsing | Valores tipados, garantidos por schema |
| Amostragem | Sequencial, token por token | Paralela, consulta única |
| Preço de entrada / 1M tokens | US$ 0,20–10 | US$ 0,042 |
| Preço de saída | ~5x a entrada | Grátis |
| Latência | 3–329 s | 70–500 ms |
| Alucinação / erros de tipo | Possíveis | Impossíveis por construção |
| Confiança | Excesso de confiança, inconsistente | Calibrada por saída |
Todos os recursos derivam de uma escolha de design: o Jev abre mão completamente de gerar texto.
É essa subtração que entrega velocidade, preço e garantias de tipo.
O Jev retorna valores estruturados e type-safe, cujas saídas possíveis são definidas no seu schema antes da chamada.
A API expõe um conjunto enxuto de tipos de pergunta:
Pense nele como uma chamada de função com inteligência de ponta: entra estado não estruturado, saem decisões tipadas e probabilísticas.
Se você estiver roteando um ticket de suporte, pode definir um Choice entre {billing, technical, sales, spam} e um Score de urgência de 0 a 100, e o Jev preenche ambos em uma única passada. Não há JSON para fazer parsing nem risco de o modelo se perder escrevendo um parágrafo.
O porém é óbvio: isso só funciona quando o espaço de respostas válidas é limitado e conhecido de antemão. O Jev é inútil para geração aberta e não escreve o schema por você.
Toda saída do Jev vem com uma probabilidade calibrada, o que significa que maior confiança realmente corresponde a maior acerto.
Este é, na prática, o recurso com mais utilidade.
LLMs padrão são notoriamente autoconfiantes demais, mesmo quando você pede explicitamente uma probabilidade.
Se um modelo acerta 95% das vezes, mas não sabe dizer em quais 5% está inseguro, você não consegue automatizar com segurança ao redor dele.
A calibração do Jev permite definir um limiar de confiança e só agir automaticamente acima dele, roteando casos incertos para um humano ou para um LLM mais lento.
A limitação importante: o Jev te entrega um número, não uma justificativa.
Não há explicação em linguagem natural do porquê de uma pontuação, o que pesa no debug e em auditorias de setores regulados.
Como as saídas do Jev são restritas pelo schema, é matematicamente impossível produzir um valor inválido ou um erro de tipo.
A TypeSafe reporta 0% de erro em saída estruturada e 0% de erro em chamadas de ferramenta.
Para comparar, no teste de saída estruturada da TypeSafe, os modelos luna e terra da OpenAI ficaram em 0,58%, o Opus 5 da Anthropic em 5,73% e o Claude Haiku 4.5 em 45,5%.
Em chamadas de ferramentas, o GPT-5.6 Sol foi o pior, com 17,0%.
Uma ferramenta alucinada é incômodo em um agente interativo, mas vira problema sério quando está enterrada em camadas de uma cadeia de dependências com metas de latência.
O Jev gera toda a saída em uma única consulta paralela, em vez de emitir token a token.
É daí que vem a latência de 70–500 ms.
Essa velocidade abre casos de uso que LLMs token a token não alcançam.
No demo da TypeSafe, o Jev joga Doom reagindo ao estado estruturado do jogo (fornecido como texto) cerca de 10 vezes por segundo, a aproximadamente US$ 7/hora de inferência.
O ponto não é jogar Doom bem — um bot scriptado venceria —, mas conseguir tomar decisões reativas dentro de um loop em tempo real, onde uma chamada de 3–30 segundos a um LLM é inviável.
O custo por caso do Jev, em torno de US$ 0,0004, torna viável rodar uma decisão em cada linha de um dataset grande — algo proibitivo com um LLM de ponta tarifado por token.
A TypeSafe posiciona isso como transformar petabytes de dados brutos em features e insights por meio de um map-reduce de decisões.
Um exemplo concreto é pontuar toda avaliação de produto em uma tabela de 50 milhões de linhas por sentimento e violação de política, o que custaria por volta de US$ 20 em chamadas de decisão com o Jev na taxa divulgada, contra milhares de dólares com um LLM cobrado por tokens.
Em resumo, o Jev fica mais ou menos onde LLMs de ponta intermediários ficam em acurácia, mas supera todos em custo e latência por uma a duas ordens de grandeza.
Todos os números abaixo vêm das tabelas de avaliação da própria TypeSafe, e ainda não há reprodução independente em larga escala; então trate-os como dados do fornecedor.
A TypeSafe criou uma avaliação customizada em 4 workflows (resposta a incidentes de segurança, observabilidade de traces de agentes, processamento de faturas e atendimento ao cliente), comparando cada modelo às previsões médias do GPT-6 Astra e do Fable da Anthropic.
O Jev atinge 67,8% de concordância com as respostas de referência.
Veja como isso compara com os LLMs de ponta nos mesmos workflows:
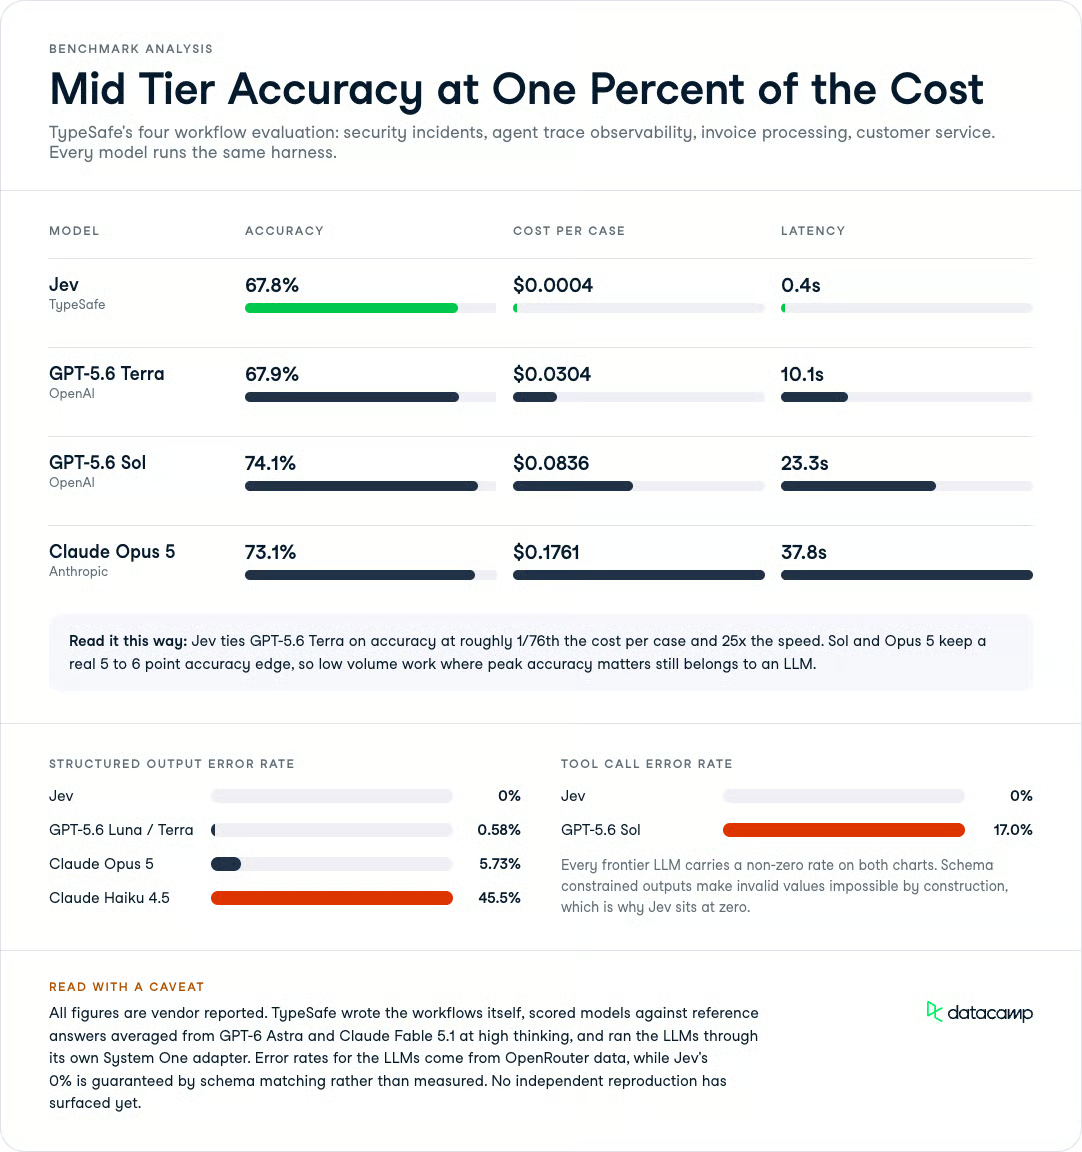
O padrão é consistente: o Jev troca alguns pontos de acurácia em relação aos melhores modelos por uma enorme economia de custo e latência.
| Modelo | Acurácia | Custo por caso | Latência |
|---|---|---|---|
| Jev (TypeSafe) | 67,8% | US$ 0,0004 | 0,4 s |
| GPT-5.6 Terra | 67,9% | US$ 0,0304 | 10,1 s |
| GPT-5.6 Sol | 74,1% | US$ 0,0836 | 23,3 s |
| Claude Opus 5 | 73,1% | US$ 0,1761 | 37,8 s |
O Jev empata na prática com o Terra em acurácia, custando cerca de 1/76 por caso e rodando 25x mais rápido.
Os modelos com maior acurácia — Sol (74,1%) e Opus 5 (73,1%) — mantêm uma folga real de 5–6 pontos; então, se você precisa de pico de acurácia em baixa escala, o LLM ainda vence.
Nos gráficos de confiabilidade, o Jev fica em 0% de erro tanto em saída estruturada quanto em chamadas de ferramenta, exatamente o objetivo do design restrito por schema.
Os LLMs de ponta mantêm taxas não nulas de falha aqui.
Dois números chamam atenção: o Claude Haiku 4.5 tem 45,5% de erro em saída estruturada, e o GPT-5.6 Sol tem 17,0% de erro em chamadas de ferramenta.
Não são casos extremos — são falhas que quebram um pipeline autônomo assim que ele roda em volume.
O Jev retorna probabilidades, mas não uma justificativa em linguagem natural — um limite real para depuração e auditorias em domínios regulados.
Se a equipe de compliance precisa saber por que uma análise de crédito recebeu certa pontuação, um número de confiança por si só não resolve.
Na prática, a saída é usar o Jev na camada de roteamento em alto volume e escalar casos sinalizados ou de baixa confiança para um modelo que produza explicação escrita.
Assim você mantém a vazão e preserva a trilha de auditoria onde a lei exige.
A TypeSafe reconhece de forma transparente os vieses das próprias avaliações.
Os workflows foram escritos pelo time de capabilities do próprio modelo, então pode haver algum viés, e as respostas de referência vêm de modelos da OpenAI e da Anthropic — o que provavelmente subestima o desempenho relativo do Jev e dos modelos da DeepSeek.
Os LLMs nesses testes rodam via o adaptador open-source System One da TypeSafe, que os força a emitir decisões estruturadas compatíveis com a API.
A TypeSafe diz que este é o jeito mais preciso de extrair decisões de um LLM, embora seja mais lento e caro do que deixar o modelo responder sem probabilidades.
Até surgir uma suíte independente reproduzida em um harness neutro, eu leria a paridade de acurácia como promissora, não como definitiva.
O Jev não compete com GPT-5.6 ou Opus 5 pelos mesmos trabalhos; a pergunta útil é qual classe de modelo usar.
A divisão depende de a sua tarefa exigir uma decisão limitada ou uma resposta aberta.
| Caso de uso | Use | Por quê |
|---|---|---|
| Classificar ou rotear milhões de tickets | Jev | Saídas limitadas; custo e throughput mandam |
| Pontuar ou aplicar guardrails em saídas de LLM em escala | Jev | Probabilidades rápidas de sim/não, sem risco de alucinação |
| Decisões em tempo real dentro do loop do app | Jev | 70–500 ms de latência vs. 3–30 s de um LLM |
| Escrever código, e-mails ou resumos | LLM de ponta | O Jev não gera texto |
| Raciocínio multi-etapas pontual com explicação | LLM de ponta | Precisa de justificativa e saída aberta |
Na prática, os dois se complementam: use o Jev como camada rápida de decisão para classificar, pontuar e rotear, e entregue a pequena fatia de casos difíceis ou abertos a um modelo como o Terra ou o Opus 5. A calibração do Jev facilita esse handoff, já que você pode rotear por limiar de confiança.
O preço do Jev é onde a proposta fica agressiva.
Tokens de entrada custam US$ 0,042 por milhão (US$ 42 por bilhão), e tokens de saída não são medidos — descritos pela TypeSafe como baratos demais para medir, porque o modelo retorna decisões estruturadas, não texto longo.
Em escala, essa taxa de entrada é cerca de 1/48 do valor do GPT-5.6 Terra (US$ 2,00 por milhão de tokens de entrada), e o Terra ainda cobra US$ 12,00 por milhão de tokens de saída.
No nível de workflow, as avaliações internas da TypeSafe colocam o Jev em cerca de US$ 0,0004 por caso, contra US$ 0,0304 no Terra e US$ 0,0836 no Sol.
A TypeSafe admite que não consegue provar que o preço não esteja subsidiado e diz que o tempo mostrará a sustentabilidade — embora espere que os preços caiam, não subam.
O Jev está em early access desde 15 de setembro de 2026, com acesso por lista de espera e liberação gradual para desenvolvedores. Não vi menção explícita a créditos gratuitos ou programa de teste nos materiais de lançamento.
O Jev é um modelo proprietário, hospedado, acessível pela API HTTP da TypeSafe. Porém, para ter acesso, você precisa entrar na lista de espera e acompanhar a comunidade no TypeSafe AI Blog.
O endpoint é POST https://api.typesafe.ai/v1/systemone, e a rota do modelo em early access é jev-latest.
A TypeSafe oferece SDKs oficiais para Python e JavaScript, além da API HTTP bruta.
Você define seus tipos de pergunta (Choice, Score, Noul) no schema e passa o estado do seu programa como entrada; a resposta volta como valores tipados com probabilidades calibradas.
Eis o formato mínimo de uma requisição na rota serverless:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
Para a referência completa de schema e configuração dos SDKs, consulte a documentação da TypeSafe.
A TypeSafe está apostando que muita coisa que hoje pedimos para LLMs fazerem é, na verdade, tomada de decisão estruturada disfarçada de chat.
Se isso estiver certo, a vantagem de custo de 40–400x do Jev e a garantia de 0% de erro de tipo mudam a economia da automação em alto volume de um jeito que GPT-5.6 e Opus 5 não conseguem alcançar em preço.
Minha leitura sincera: o Jev parece realmente útil como camada rápida de decisão e guardrail, e a história da calibração é a parte em que eu apostaria ao construir.
As dúvidas em aberto são se um benchmark independente confirma a paridade de acurácia e se a precificação se mantém quando o subsídio acabar.
Se você quer entender os problemas de decisão para os quais o Jev foi criado, nossa trilha de habilidades AI Fundamentals cobre os conceitos de classificação e calibração por trás disso.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Josep Ferrer
8 min
blog
DataCamp Team
4 min
blog
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
8 min