前沿模型位于当今人工智能能力的最前沿。它们正在重塑我们的工作方式、软件构建方式、决策方式,甚至影响政府对监管的思考方式。
在本文中,您将了解前沿模型的真正含义、其定义如何演变、2026 年哪些模型处于领先地位,以及在实践中如何在开源与闭源路径之间做出选择。
如果您刚接触 AI,或希望打下使用这些模型的实用基础,建议从 AI 原生的 Introduction to AI for Work 课程开始。
什么是前沿模型?
我们来谈谈前沿模型如何定义,以及它们与常见 AI 模型的差异。
基于性能的定义
“前沿模型”一词起源于政策与研究圈,而非营销领域。
根据 Frontier Model Forum 的定义,前沿模型通常被理解为使用极其庞大的计算预算(约 10^26 浮点运算每秒,FLOPS)训练的通用 AI 模型,且能够在多个领域超越当前的 SOTA(最先进水平)。
而 欧盟《AI 法案》 对具备“高影响力能力”的模型分类则采用了 10^25 FLOPS 的阈值。这是充分而非必要条件:低于该阈值的模型也可基于其展示的能力被归类为前沿模型。
若想进一步了解该法案,建议学习 Understanding the EU AI Act 课程。
涌现行为
前沿模型的一个关键特征是涌现行为。这些能力并非通过显式训练获得,而是随着数据、参数与算力规模的扩大而自然出现。示例包括:
- 多步逻辑推理
- 工具使用与规划
- 跨领域的抽象问题求解
这些行为在 Large Language Models (LLMs) Concepts 与 Generative AI Concepts 等课程中有深入探讨,解释了规模为何会带来质的能力飞跃。
“通用性”标准
同样重要的是,前沿模型在设计上并非专用化。
不同于任务特定系统,它们可以“开箱即用”地执行广泛而不同的任务,如写作、推理、编程、数据分析、音频摘要或图像理解。这种通用性使其成为基础设施,而非狭窄的工具。
“前沿”定义的分化
前沿模型领域发展迅速,但关于如何界定前沿模型及其挑战,已出现一些新趋势。
到 2026 年,“单一前沿”的概念已裂变为多个相互重叠的前沿:
- 监管前沿:跨越正式阈值(如 10²⁶ FLOPs)的模型,会在新兴法规下触发报告或合规义务。
- 效率前沿:以更精简的架构实现旗舰级推理与自主性,证明“更大不一定更智能”。
- 成本前沿:优先考虑性价比,将推理成本降至足以支撑高规模部署的经济水平。
- 多模态前沿:原生同时感知并推理视频、音频与文本,使其像理解语言一样流畅地理解物理世界。
理解这些差异对构建者与业务领导者都至关重要。若想更深入地探讨如何将前沿能力引入商业实践,请查看 AI Business Fundamentals 技能路径。
效率前沿:帕累托最优
最重要的趋势之一是效率前沿。诸如 Mistral 等公司的模型表明,通过更优的架构、数据策划与训练策略,可用更少的参数与更低的算力实现前沿级推理。
这挑战了长期以来“越大越好”的假设,并在 Mistral 3 和 其他顶级开源 LLM 等模型上反复出现。
成本前沿:可及性
另一条前沿并非以原始能力定义,而是以性价比界定。像 DeepSeek-V3.2 这样的模型以显著更低的推理成本推动旗舰级智能,使高级推理在大规模场景中更易获得。
若想了解这些模型的表现,可试用 DeepSeek-V3.2-Speciale 教程。在该案例中,它通过专注于深度推理来提高效率,这降低了模型的灵活性,但带来了更高的成本效益。
多模态前沿:视觉与音频支持
仅基于文本的基准已不再足够。现代前沿要求原生多模态能力,包括:
- 图像与视频理解
- 音频处理与语音
- 物理推理与世界建模
灵活性是评估前沿模型的关键要素。它们必须能够对各类任务进行泛化。
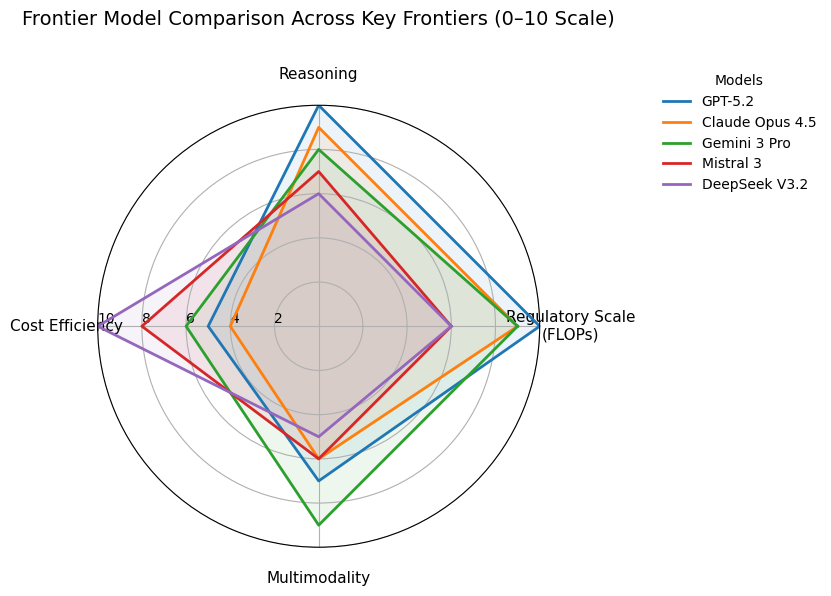
例如,Qwen3 等模型在通识、编程与现实世界推理等方面表现出色,并能使用文本与图像等多种模态。下图比较了各类前沿模型在关键前沿维度上的优势。
2026 年顶级前沿模型
我们来看看不同类别中的顶级前沿模型。有的在闭源专有领域的推理方面领先,有的则是开放权重的有力竞争者,自定义模型构建也在兴起。
专有模型
闭源模型继续设定推理与通用智能的上限:
开放权重模型
开源或开放权重模型正日益挑战专有模型的主导地位:
|
模型
|
开发者
|
访问类型
|
关键差异点
|
|
GPT-5.2
|
OpenAI
|
闭源
|
最高推理上限
|
|
Claude Opus 4.5
|
Anthropic
|
闭源
|
安全性与长上下文优势
|
|
Gemini 3 Pro
|
Google
|
闭源
|
原生多模态
|
|
Grok 4.1
|
xAI
|
闭源
|
实时与社交数据
|
|
Llama 4
|
Meta
|
开放权重
|
技术主权与生态系统
|
|
Mistral Large 3
|
Mistral
|
开放权重
|
效率领跑者
|
|
Qwen3
|
Alibaba
|
开放权重
|
多语言 + 多模态
|
|
DeepSeek-V3.2
|
DeepSeek
|
开放权重
|
性价比领跑者
|
自定义模型
除预训练模型外,新平台还允许组织在内部构建或微调前沿级系统。诸如 Amazon Nova Forge 等工具,配合微软 Azure 与谷歌 Vertex 的产品,为企业按专有数据、性能或合规需求调整基础模型提供了可能。
这是一种明智的中间路径,让您获得比封闭 API 更强的掌控力,同时又免去纯开源方案所需的沉重基础设施投入s.
开源 vs 闭源前沿模型
随着前沿模型的成熟,最重要的战略决策之一并非选择“最大”或“最好”的模型,而是选择最契合当前问题的开发与访问模式。开源(或开放权重)与闭源前沿模型在性能、成本与控制方面存在根本性取舍。
性能与成本
OpenAI 的 GPT-5.2 等闭源前沿模型仍定义了原始推理与通用智能的上限。它们受益于海量的专有数据集、极端的训练规模以及持续的训练后强化,而这些往往是小型或开源团队难以复制的。
然而,这种性能是有代价的。专有模型通常:
- 推理时更为昂贵
- 受使用上限与价格变动的影响
- 在训练数据与内部架构方面不透明
相比之下,开放权重的前沿模型如 Meta 的 Llama 4、Mistral 3 与 DeepSeek V3.2,常以极低成本提供 80–95% 的旗舰性能,特别适用于高吞吐或低延迟工作负载。对于许多实际应用,如客户服务与内部文档分析,这一性能差距与在成本与基础设施可控性上的收益相比可忽略不计。
在实践中,前沿不再只是“最大智能”,而是“单位成本智能”。
隐私、控制与技术主权
数据治理已成为推动前沿模型采纳的关键因素。闭源模型通常通过公共 API 访问,这会引发以下担忧:
- 敏感数据暴露
- 跨境数据传输
- 医疗、金融与政府等行业的合规要求
因此,许多组织更青睐可:
- 在本地部署
- 在私有云或 VPC(虚拟私有云)中托管
- 在数据不出组织边界的情况下进行微调
这对 AI 主权尤为重要:政府与受监管企业希望对其所依赖的模型保持完全控制。开放模型使团队能够审计行为、施加自定义安全约束,并让输出符合本地法律或文化要求。
透明性、适应性与创新
开放权重前沿模型在透明性与适应性方面也具有优势。尽管“开源”并不总意味着训练数据完全开放,但通常允许:
- 检查模型权重
- 更深入地理解失效模式
- 进行自定义微调与蒸馏
这种灵活性让研究、初创公司与构建领域专用 AI 系统的企业能更快地实验与创新。参数高效微调、检索增强生成与自定义对齐等技术,在可访问模型权重的情况下更易实施。
相较之下,闭源模型更强调稳定性与安全保障而非定制化。这使其非常适合通用场景与快速原型,但不太适合深度专用化。
两全其美
越来越多的组织选择在前沿模型上采用混合策略,而非二选一。常见模式如下:
闭源前沿模型用于:
开放权重前沿模型用于:
- 高规模生产工作负载
- 成本敏感型应用
- 对隐私要求严格或受监管的环境
在这种架构下,专有模型作为能力基准与加速器,而开放模型负责规模、效率与可控性。该方法在保持接触 AI 尖端能力的同时,降低了供应商锁定风险。
选择合适的模型
归根结底,选择开源还是闭源前沿模型,与其说是意识形态,不如说取决于场景:
- 若您需要当下最强的推理能力,闭源模型仍占优势。
- 若您需要成本效率、可控性与定制化,开放权重模型日益占优。
- 若您两者都要,混合方案往往是更具韧性的长期策略。
随着前沿模型不断演进,开源与闭源之间的界限很可能进一步模糊,但理解这些取舍仍是 2026 年及以后做出明智 AI 决策的关键。
挑战与伦理考量
当前沿模型不断突破 AI 系统的能力边界时,也带来一系列新的技术、社会与伦理挑战。这些风险会随着能力扩张而同步放大,使治理与负责任落地与原始性能同等重要。
对齐与公平
前沿模型的核心挑战之一是对齐。我们必须确保日益强大的系统能以可靠、可预期且符合人类意图的方式行事。
随着模型获得更强的推理能力,它们也更容易生成“似是而非但不正确”的输出,通常被称为幻觉。在低风险应用中,这些错误或可容忍;但在医疗、金融、法律分析或公共政策等高风险领域,则可能带来实质性危害。
不完美的训练数据也可能引入隐性偏见。我们必须认识到,这些模型的训练数据来源多样,可能强化刻板印象或边缘化代表性不足群体。我们需要负责任地进行管理,并定期检查这些模型的表现,以尽量降低偏见的影响。
安全
前沿模型本质上是双重用途技术:支持生产力与创新的同一能力,也可能被重新利用为伤害工具。高级推理、代码生成与多模态理解会降低以下行为的门槛:
- 可规模化的虚假信息与深度伪造
- 自动化社会工程与网络钓鱼
- 恶意软件生成或漏洞发现
尽管大多数提供方都实施了安全防护与使用政策,但没有任何系统绝对安全。尤其是开放权重模型,发布权重后对下游使用的控制有限,如何在开放与责任之间平衡,问题更为突出。
应对这些问题不仅需要技术手段,还需要持续的人类监督与关于模型局限性的透明披露。
财务成本与可持续性
前沿模型在财务与环境层面都代价高昂。前沿级训练需要:
- 庞大的 GPU 或加速器集群
- 巨大的能源消耗
- 大量用于数据中心冷却的用水
即便是大规模推理,其碳足迹也不可小觑。随着这些模型嵌入日常产品,累积的环境影响会迅速增长。
这重新激发了对效率导向研究的关注,包括 小型语言模型(SML)、蒸馏、稀疏化与更优的硬件利用率。Mistral 与 DeepSeek 等模型的崛起表明,在不同比例增加算力的前提下提升能力,正成为伦理与财务双重优先事项。
将“前沿”当作护城河
最后,关于“前沿模型”这一概念究竟纯属技术范畴,还是兼具战略考量的争论愈发引人注目。
批评者认为,强调极端算力阈值与监管分类,可能充当护城河,有利于资金雄厚的既有玩家,同时抬高开源与小型研究团队的进入门槛。
支持者则反驳称,前沿级能力确实带来系统性风险,理应加强监督。
真相或许介于两者之间:一定的护栏必不可少,但过于僵化的定义可能将“规模”等同于“安全”。随着开放与高效模型继续缩小性能差距,这一争论只会愈演愈烈。
结语
前沿模型代表着人工智能的刀尖:前所未有的能力、广泛的通用性与切实的经济影响。但与之相伴而来的是技术、伦理与战略层面的复杂性。
随着 2026 年的推进,开源与闭源前沿模型之间的差距很可能继续缩小,尤其是在效率与成本前沿方面。最佳选择将更少受炒作影响,而更多取决于用例、约束与策略。
建立直觉的最快方式是动手实践。通过我们的课程亲手体验专有与开放的前沿模型:Working with the OpenAI API 或 Working with Llama 3。如果您有兴趣自己构建模型,欢迎查看我们的 Developing Large Language Models 技能路径。


前沿模型位于当今人工智能能力的最前沿。它们正在重塑我们的工作方式、软件构建方式、决策方式,甚至影响政府对监管的思考方式。
在本文中,您将了解前沿模型的真正含义、其定义如何演变、2026 年哪些模型处于领先地位,以及在实践中如何在开源与闭源路径之间做出选择。
如果您刚接触 AI,或希望打下使用这些模型的实用基础,建议从 AI 原生的 Introduction to AI for Work 课程开始。
什么是前沿模型?
我们来谈谈前沿模型如何定义,以及它们与常见 AI 模型的差异。
基于性能的定义
“前沿模型”一词起源于政策与研究圈,而非营销领域。
根据 Frontier Model Forum 的定义,前沿模型通常被理解为使用极其庞大的计算预算(约 10^26 浮点运算每秒,FLOPS)训练的通用 AI 模型,且能够在多个领域超越当前的 SOTA(最先进水平)。
而 欧盟《AI 法案》 对具备“高影响力能力”的模型分类则采用了 10^25 FLOPS 的阈值。这是充分而非必要条件:低于该阈值的模型也可基于其展示的能力被归类为前沿模型。
若想进一步了解该法案,建议学习 Understanding the EU AI Act 课程。
涌现行为
前沿模型的一个关键特征是涌现行为。这些能力并非通过显式训练获得,而是随着数据、参数与算力规模的扩大而自然出现。示例包括:
这些行为在 Large Language Models (LLMs) Concepts 与 Generative AI Concepts 等课程中有深入探讨,解释了规模为何会带来质的能力飞跃。
“通用性”标准
同样重要的是,前沿模型在设计上并非专用化。
不同于任务特定系统,它们可以“开箱即用”地执行广泛而不同的任务,如写作、推理、编程、数据分析、音频摘要或图像理解。这种通用性使其成为基础设施,而非狭窄的工具。
“前沿”定义的分化
前沿模型领域发展迅速,但关于如何界定前沿模型及其挑战,已出现一些新趋势。
到 2026 年,“单一前沿”的概念已裂变为多个相互重叠的前沿:
理解这些差异对构建者与业务领导者都至关重要。若想更深入地探讨如何将前沿能力引入商业实践,请查看 AI Business Fundamentals 技能路径。
效率前沿:帕累托最优
最重要的趋势之一是效率前沿。诸如 Mistral 等公司的模型表明,通过更优的架构、数据策划与训练策略,可用更少的参数与更低的算力实现前沿级推理。
这挑战了长期以来“越大越好”的假设,并在 Mistral 3 和 其他顶级开源 LLM 等模型上反复出现。
成本前沿:可及性
另一条前沿并非以原始能力定义,而是以性价比界定。像 DeepSeek-V3.2 这样的模型以显著更低的推理成本推动旗舰级智能,使高级推理在大规模场景中更易获得。
若想了解这些模型的表现,可试用 DeepSeek-V3.2-Speciale 教程。在该案例中,它通过专注于深度推理来提高效率,这降低了模型的灵活性,但带来了更高的成本效益。
多模态前沿:视觉与音频支持
仅基于文本的基准已不再足够。现代前沿要求原生多模态能力,包括:
灵活性是评估前沿模型的关键要素。它们必须能够对各类任务进行泛化。
例如,Qwen3 等模型在通识、编程与现实世界推理等方面表现出色,并能使用文本与图像等多种模态。下图比较了各类前沿模型在关键前沿维度上的优势。
2026 年顶级前沿模型
我们来看看不同类别中的顶级前沿模型。有的在闭源专有领域的推理方面领先,有的则是开放权重的有力竞争者,自定义模型构建也在兴起。
专有模型
闭源模型继续设定推理与通用智能的上限:
开放权重模型
开源或开放权重模型正日益挑战专有模型的主导地位:
模型
开发者
访问类型
关键差异点
GPT-5.2
OpenAI
闭源
最高推理上限
Claude Opus 4.5
Anthropic
闭源
安全性与长上下文优势
Gemini 3 Pro
Google
闭源
原生多模态
Grok 4.1
xAI
闭源
实时与社交数据
Llama 4
Meta
开放权重
技术主权与生态系统
Mistral Large 3
Mistral
开放权重
效率领跑者
Qwen3
Alibaba
开放权重
多语言 + 多模态
DeepSeek-V3.2
DeepSeek
开放权重
性价比领跑者
自定义模型
除预训练模型外,新平台还允许组织在内部构建或微调前沿级系统。诸如 Amazon Nova Forge 等工具,配合微软 Azure 与谷歌 Vertex 的产品,为企业按专有数据、性能或合规需求调整基础模型提供了可能。
这是一种明智的中间路径,让您获得比封闭 API 更强的掌控力,同时又免去纯开源方案所需的沉重基础设施投入s.
开源 vs 闭源前沿模型
随着前沿模型的成熟,最重要的战略决策之一并非选择“最大”或“最好”的模型,而是选择最契合当前问题的开发与访问模式。开源(或开放权重)与闭源前沿模型在性能、成本与控制方面存在根本性取舍。
性能与成本
OpenAI 的 GPT-5.2 等闭源前沿模型仍定义了原始推理与通用智能的上限。它们受益于海量的专有数据集、极端的训练规模以及持续的训练后强化,而这些往往是小型或开源团队难以复制的。
然而,这种性能是有代价的。专有模型通常:
相比之下,开放权重的前沿模型如 Meta 的 Llama 4、Mistral 3 与 DeepSeek V3.2,常以极低成本提供 80–95% 的旗舰性能,特别适用于高吞吐或低延迟工作负载。对于许多实际应用,如客户服务与内部文档分析,这一性能差距与在成本与基础设施可控性上的收益相比可忽略不计。
在实践中,前沿不再只是“最大智能”,而是“单位成本智能”。
隐私、控制与技术主权
数据治理已成为推动前沿模型采纳的关键因素。闭源模型通常通过公共 API 访问,这会引发以下担忧:
因此,许多组织更青睐可:
这对 AI 主权尤为重要:政府与受监管企业希望对其所依赖的模型保持完全控制。开放模型使团队能够审计行为、施加自定义安全约束,并让输出符合本地法律或文化要求。
透明性、适应性与创新
开放权重前沿模型在透明性与适应性方面也具有优势。尽管“开源”并不总意味着训练数据完全开放,但通常允许:
这种灵活性让研究、初创公司与构建领域专用 AI 系统的企业能更快地实验与创新。参数高效微调、检索增强生成与自定义对齐等技术,在可访问模型权重的情况下更易实施。
相较之下,闭源模型更强调稳定性与安全保障而非定制化。这使其非常适合通用场景与快速原型,但不太适合深度专用化。
两全其美
越来越多的组织选择在前沿模型上采用混合策略,而非二选一。常见模式如下:
闭源前沿模型用于:
开放权重前沿模型用于:
在这种架构下,专有模型作为能力基准与加速器,而开放模型负责规模、效率与可控性。该方法在保持接触 AI 尖端能力的同时,降低了供应商锁定风险。
选择合适的模型
归根结底,选择开源还是闭源前沿模型,与其说是意识形态,不如说取决于场景:
随着前沿模型不断演进,开源与闭源之间的界限很可能进一步模糊,但理解这些取舍仍是 2026 年及以后做出明智 AI 决策的关键。
挑战与伦理考量
当前沿模型不断突破 AI 系统的能力边界时,也带来一系列新的技术、社会与伦理挑战。这些风险会随着能力扩张而同步放大,使治理与负责任落地与原始性能同等重要。
对齐与公平
前沿模型的核心挑战之一是对齐。我们必须确保日益强大的系统能以可靠、可预期且符合人类意图的方式行事。
随着模型获得更强的推理能力,它们也更容易生成“似是而非但不正确”的输出,通常被称为幻觉。在低风险应用中,这些错误或可容忍;但在医疗、金融、法律分析或公共政策等高风险领域,则可能带来实质性危害。
不完美的训练数据也可能引入隐性偏见。我们必须认识到,这些模型的训练数据来源多样,可能强化刻板印象或边缘化代表性不足群体。我们需要负责任地进行管理,并定期检查这些模型的表现,以尽量降低偏见的影响。
安全
前沿模型本质上是双重用途技术:支持生产力与创新的同一能力,也可能被重新利用为伤害工具。高级推理、代码生成与多模态理解会降低以下行为的门槛:
尽管大多数提供方都实施了安全防护与使用政策,但没有任何系统绝对安全。尤其是开放权重模型,发布权重后对下游使用的控制有限,如何在开放与责任之间平衡,问题更为突出。
应对这些问题不仅需要技术手段,还需要持续的人类监督与关于模型局限性的透明披露。
财务成本与可持续性
前沿模型在财务与环境层面都代价高昂。前沿级训练需要:
即便是大规模推理,其碳足迹也不可小觑。随着这些模型嵌入日常产品,累积的环境影响会迅速增长。
这重新激发了对效率导向研究的关注,包括 小型语言模型(SML)、蒸馏、稀疏化与更优的硬件利用率。Mistral 与 DeepSeek 等模型的崛起表明,在不同比例增加算力的前提下提升能力,正成为伦理与财务双重优先事项。
将“前沿”当作护城河
最后,关于“前沿模型”这一概念究竟纯属技术范畴,还是兼具战略考量的争论愈发引人注目。
批评者认为,强调极端算力阈值与监管分类,可能充当护城河,有利于资金雄厚的既有玩家,同时抬高开源与小型研究团队的进入门槛。
支持者则反驳称,前沿级能力确实带来系统性风险,理应加强监督。
真相或许介于两者之间:一定的护栏必不可少,但过于僵化的定义可能将“规模”等同于“安全”。随着开放与高效模型继续缩小性能差距,这一争论只会愈演愈烈。
结语
前沿模型代表着人工智能的刀尖:前所未有的能力、广泛的通用性与切实的经济影响。但与之相伴而来的是技术、伦理与战略层面的复杂性。
随着 2026 年的推进,开源与闭源前沿模型之间的差距很可能继续缩小,尤其是在效率与成本前沿方面。最佳选择将更少受炒作影响,而更多取决于用例、约束与策略。
建立直觉的最快方式是动手实践。通过我们的课程亲手体验专有与开放的前沿模型:Working with the OpenAI API 或 Working with Llama 3。如果您有兴趣自己构建模型,欢迎查看我们的 Developing Large Language Models 技能路径。